Agent 记忆论战:Kevin Liao 称记忆插件都是"RAG 切片抽奖",HN 炸出 300 条争论
Kevin Liao 10 月 3 日发长文开炮:所有 Agent 记忆插件本质都是 RAG 切片抽奖,Agent 真正需要的是 Markdown 文档大脑(随文开源 Operator Memory)。帖子登上 HN 首页,近 400 points、300+ 评论。本文还原论战:Liao 的五宗罪指控、他的文档大脑方案、评论区最有料的三个反驳,以及给 vibe coding 开发者的三条实操启示。
Agent 的"记忆"怎么做,一直是开发者社区争论不休的话题。2026 年 10 月 3 日,工程师 Kevin Liao 在他的个人博客 liao.gg 上发表长文《Agents Don't Need Memory. They Need Documentation.》,用一句挑衅十足的断言点燃了整场辩论:市面上所有的 Agent 记忆插件,本质上都是"RAG 切片抽奖"。
文章发表当天就被提交到 Hacker News,迅速冲上首页——截至发稿时拿下近 400 points、300 多条评论。评论区吵成一团:有人直呼说出了心声,有人痛斥作者在贩卖另一种"鲁布·戈德堡式复杂装置",还有人搬出了论文数据和实测账单当场对线。这已经不是一篇博客引发的普通讨论,而是一次关于"Agent 到底该怎么记住东西"的路线之争。
值得一提的是,VibeFix 在 2026 年 10 月 2 日刚刚发布过《Agent 记忆设计》指南,系统讲过记忆分层的方法论。但 Liao 这篇不是教程,而是一次正面挑战——他认为整个记忆插件生态解决的问题从一开始就是错的。本文是新闻:我们完整还原这场论战,看看双方到底在吵什么,以及它对你做 Agent 记忆功能有什么实际启示。
Liao 的挑衅:记忆插件全是"RAG 切片抽奖"
Liao 在文章开篇用一段极具画面感的描述,给所有记忆插件画了一张"标准像":一个记忆插件分析你的对话记录,生成 1000 个彼此孤立的记忆片段,塞进向量数据库;你每发一次 prompt,它就把语义最相似的 5 个片段贴进上下文;如果 Agent 还是困惑(它当然会困惑),就再给它一个搜索工具,让它自己去向量库里翻。这就是市面上号称"记忆"的产品。
他的核心指控是:你想解决的问题,是让 Agent 理解你的项目——某个功能在哪、为什么这样建、你们约定过什么、你在意什么。但你实际得到的,是一场每次 prompt 都开奖的 RAG 切片彩票,赌的是"正确的片段能浮上来"。即便偶尔赌中了,Agent 依然不理解你的项目。
接下来他拆解了所有记忆插件"换汤不换药"的统一架构,五步走:
- 遍历会话转录文本;
- 生成"记忆"片段;
- 塞进 RAG 数据库;
- 每次 prompt 取 top 5 注入;
- 不够?再给 Agent 一个搜索 RAG 库的工具。
他承认有些插件更花哨:逐字搜索历史转录的、多层长短记忆分类的、后台跑一堆守护进程做去重合并的、号称"造梦者"半夜重写记忆的、做持续上下文压缩和重排的——但在他看来,这些都是在同一个有缺陷的地基上烧 token 打补丁,所以没有一个真正可靠。
然后是全文最有杀伤力的部分:他列出了记忆插件共同的五宗罪,每一条都直指 RAG 式记忆的结构性缺陷:
- 记忆靠相似度浮现。相似度搜索只衡量两个片段在向量空间里有多近,仅此而已。它不告诉你哪个正确、哪个最新、缺了什么。
- 记忆片段没有上下文。一个 RAG 切片就那么大,动机、背景、教训、环境全丢了。
- 过去被当成真理。所有插件都依赖"回忆",但代码库每天都在变——那 500 个关于认证模块的片段,现在还有几个是准的?
- Agent 不知道自己不知道什么。就算给了搜索工具,Agent 凭什么知道该在什么时候搜?
- 记忆库不可审计。SQLite 里躺着一万个 embedding:哪些记忆真实存在?哪些过期了?哪些从没被检索过?哪些是错的、正在悄悄带偏你的 Agent?
在他看来,整个生态共享一个错误的前提:"Agent 会忘,这是问题;所以解法是记住。记住更多、索引更好、检索更聪明。"但人类处理知识根本不是这么干的——没有人会为了回忆某个功能的约束条件,去重看三年前的团队会议录像。人们是把东西写下来,然后用这些记录代替回忆。
所以他的结论干脆利落:Agent 不需要记忆,需要文档。
他的方案:给 Agent 一个 Markdown "大脑"
批评之后,Liao 给出了自己的答案:一个叫 Operator Memory 的开源插件(github.com/aerovato/operator-memory),他称之为"上下文引擎"而非记忆插件。
这个想法的起点是他 2025 年 8 月的一个土办法:建一个 internal 文件夹,要求 Agent 把规格、计划、索引都写进去,每次干活前先读相关文档、干完后更新。后来这套土办法被打磨成正式系统,又被打磨成插件。这篇文章某种程度上是他一年实践的总结陈词。
所谓"大脑",是一套结构化的 Markdown 工作区:需求、决策、约束、模块映射、可复用的调研结论、编码标准——只记录代码给不了的东西。Liao 特别强调:代码已经告诉你代码"做了什么",文档要记录的是需求、决策、约束和哲学,这些是代码本身无法承载的。他举了个自己的例子:Operator 的 harness 适配器插件刻意做得很薄(Claude Code 适配器不到 100 行 TS),因为架构决策是把逻辑尽量下沉到 CLI;如果当初没把这条哲学写进文档并强制执行,Agent 很容易走捷径把逻辑烘进 harness,以后每个新 harness 都要重写。
但光有一堆 Markdown 还不够。Liao 说,一个真正有用的"大脑"必须解决四个问题:
- 内容:只写代码之外的东西,否则每个新会话都要花 8 万 token 反向工程"当初为什么这么写",得到的是有损的近似值。
- 发现:几百个文档摆在磁盘上,Agent 找不到就是废纸。Operator 的做法是只注入一份精益的"目录",说明每个文档覆盖什么、什么时候该打开,由 Agent 按需深入;文档之间可以互相链接,形成藏在文件目录背后的知识网络——这是数据库条目做不到的。
- 保鲜:针对"文档也会过时"的经典反驳,Liao 的回答是:文档在人类项目里过时,是因为人懒,把文档当杂活;Agent 没有这个毛病。外加两条硬规则——文档必须由正在干活的 Agent、在上下文最完整的时候写,而不是后台的"造梦者";事实变了就重写,不许追加,避免臃肿和漂移。
- 纪律:他承认这是最大的失败模式:放任不管,Agent 会乐此不疲地总结代码、记录每一次微调、发明没人要的需求,把每份文档写成没法读的 slop。解法是调优过的指令(只记代码给不了的、保持精益、主动拆分合并)加上人工审查——而因为大脑就是 Markdown,审查文档和审查代码没有区别。
这套文档式记忆在他看来还有四个附带优势:记忆可以 commit——能 diff、能 review、能 revert,想看过去的文档直接走 git;可以共享——.operator-shared 分区随仓库提交,规格和标准同步给每个同事和云端 Agent;不锁定 harness——Claude Code、Codex、OpenCode、Pi 通吃,知识跟着你走;零基础设施——没有向量库、没有 embedding、没有重排器、没有后台守护进程,整个系统就是磁盘上的 Markdown 加一段调优过的 prompt。
文章最后他留了个诚实的尾巴:Operator 并不完美,他经常要手动介入,让 Agent 创建、重写或精简文档。但他相信,随着 AI 变强,这套系统也会变强。
HN 评论区炸了:最有料的三个反驳
帖子在 HN 上拿了近 400 points、300 多条评论,评论区质量出奇地高——吵架归吵架,干货是真多。三个最有代表性的反驳,分别从三个不同方向拆 Liao 的台。
反驳一:文档也会膨胀失控,"代码即文档"派的血泪史
热度最高的反驳来自用户 kaydub,一句话开炮:代码即文档,这些文档和记忆系统都是"LLM 鲁布·戈德堡机",只会污染上下文。他的论据不是理论,而是血泪史:他以前在项目里维护过大量 Markdown 文档和决策记录,现在这些东西反而成了麻烦——它们过时了,即便组织过"对账"会话去逐一核对,LLM 照样被搞糊涂。
他还补了一刀逻辑暴击:如果文档是 LLM 自己生成的,那 LLM 本来就不需要它——能生成出来,说明它已经知道了。更狠的是他晒了实测:在代码评审场景里,他对比了"普通 Claude 加一段话 prompt 加 GitLab MCP"和"塞满细节的大 skill",结果前者误报更少、4 分钟花不到 1 美元,后者 45 分钟花了 20 美元还没抓住领域问题。他的结论是:很多工程师的文档仪式只是在"跳大神求雨",下雨了就说是自己求来的。
当然 kaydub 也承认自己说得极端——他自己还留着精简版的 AGENTS.md,只是砍掉了绝大部分。他的真正靶子是失控的文档膨胀:决策文档是他点名"最糟糕"的一类,因为 LLM 只看到旧决策、看不到更新后的决策,就会产生"上下文污染"。
评论区高赞跟帖 rectang 的补充很有意思:很多讨厌写文档的开发者,会天然地被"LLM 不需要文档"这种论点强化既有偏见;但实测中,当局部上下文清晰准确时,LLM 写出的代码更符合意图——哪怕你的 prompt 写得很潦草。LLM 会替你写文档,省掉大部分工作,但你仍然要动手删减它生成的冗余。(转述自 HN 用户 rectang 的评论)
反驳二:"记忆"只是个放提醒条的地方,二分法本身是伪命题
用户 dboreham 从概念上拆了 Liao 的台:你不需要"记忆系统"——当你看到 Agent 说它"记住了"什么,你直接让它把这条记进产品文档就行。但"以后请继续这么做"这条提醒本身,总得有个地方放——而那个地方,就叫 memory。换句话说,Liao 批判的"记忆"和推崇的"文档"并不是对立面:文档需要被想起来、被执行,那个"想起来"的机制就是记忆。把两者对立,是个伪二分法。
用户 vcryan 则站在 Liao 这边补了一刀:记忆是一个未经策划、不透明的任意历史讨论集合,它可能帮你也可能害你;而准确的文档只利不害。这恰好说明争论的核心不是"要不要记",而是"记的东西可不可审计、可不可策划"——而这正是 Liao 原文里"不可审计"那条批评真正想说的。
还有用户 nialv7 抛出了一个更根本的质疑:你没法用人类直觉去推理 LLM 需要什么。LLM 和人类不一样,如果它的 RL 训练里用过向量记忆库,它用向量库就顺手;没用过,就不顺手。"文档更像人所以更好"这个类比本身就不成立。
反驳三:中间派的 token 账本——先最小化,再按需加
用户 JohnBooty 代表了评论区最务实的一派:他不同意 kaydub 的"全砍掉",也不同意无脑堆文档,而是给出了一个可操作的流程——从最小甚至零文档起步,观察 Agent 在多个会话里反复卡住、反复重新解决的小问题(通常是环境问题),只把那些东西写进指令;能做成 skill 的就做成 skill,让它按需加载而不是每次全量注入。Codex 和 Claude 都能读自己的转录文本,自动找出重复摩擦点并给出精简建议。
他还把争论翻译成了一笔 token 账:如果 Agent 每个会话都要花 5000 token 重新发现同一件事,而把它写进 AGENTS.md 每次只花 500 token,这笔账不用算;如果只在 1% 的会话里需要,那就做成按需调用的 skill。kaydub 反呛这数字是拍脑袋,但 JohnBooty 的回应点出了关键:数字因项目而异,方法本身是可测量的——去读你的会话转录文本,数一数 Agent 到底烧了多少 token 在重复发现上。
这场对线还有一个有趣的注脚:用户 CapitalistCartr 提出,如果文档真膨胀到几百份,可以搞一个"图书管理员"二级 Agent——便宜的模型先过一遍,只把相关的和"可用但未加载"清单交给主 Agent。这其实是把 Liao 的"目录"思想推向了多 Agent 协作。
评论区也有人要求"上数据":用户 abhinav_sk 直言,销售话术再酷都没用,需要的是对照不同方案的 benchmark;用户 nullbio 则一针见血:所有记忆系统(包括 Liao 这套)真正的敌人都是漂移(drift),文档并没有豁免权。(转述自 HN 评论)
我们的判断:给 vibe coding 开发者的三条实操启示
这场论战没有赢家,但吵出了几条对实干者真正有用的结论。如果你正在给自己的 Agent 加记忆功能,或者在项目里维护 AGENTS.md,可以这样理解这场争论:
第一,先分清你在记"确定性知识"还是"非确定性回忆"。Liao 的批评真正打中的,是拿向量检索去存"项目有哪些约定、架构为什么这样"这类确定性知识——这确实用错了工具。决策、标准、架构约束这类东西有明确的对错和时效,用可版本控制的文档承载,可审计、可回滚,这是向量库给不了的。但另一类需求——"三个月前那次调试里试过哪个方案""用户上周随口提的偏好"——是海量、模糊、低频的回忆,这正是 RAG 的主场。很多团队的问题不是"用了 RAG",而是把什么都往 RAG 里塞。
具体到选型,可以记住一条分界线:凡是"写下来之后希望 Agent 每次都照做"的东西——代码规范、提交流程、架构禁区、环境配置的坑——都属于文档;凡是"偶尔想起来查一下也行"的东西——半年前的某次技术选型讨论、散落在几十个会话里的试错记录——才交给检索。前者错了会带偏每一次生成,后者错了最多浪费一次查询,这就是为什么前者值得人工维护、后者可以容忍"抽奖"。
第二,文档的敌人不是 RAG,是无人维护。kaydub 的血泪史和 Liao 的"纪律"章节说的其实是同一件事:文档一旦没人管,就会变成污染源。区别在于,Liao 认为 Agent 不怕维护文档这种"杂活",而 kaydub 的实测证明 Agent 维护的文档照样会幻觉、会臃肿。折中方案来自 JohnBooty:从最小文档起步,只记录 Agent 反复重新发现的东西,并且坚持"人眼终审"——kaydub 后来也承认,人类维护、人类在提交前过目的文档是好的。vibe coding 的开发者最容易犯的错,恰恰是让 Agent 无节制地写文档然后自己从不看。
第三,用混合方案,但让文档当"主脑"、检索当"备胎"。一个经得起 HN 评论区拷打的架构大概是这样:AGENTS.md 只放高层、长期稳定的东西(项目是什么、铁律、常用命令),保持精益;internal 或 docs 目录放决策记录和架构说明,Agent 在上下文完整时更新、事实变化时重写而非追加;向量检索只负责海量历史会话这种"记不清也无妨"的内容,并且默认关闭、按需调用。CapitalistCartr 的"图书管理员"二级 Agent 也是这个思路的延伸:检索能力要有,但别让它污染每一次 prompt。
最后回到 Liao 那句挑衅。HN 评论区 300 多条争论其实证明了一件事:没有人反对"让 Agent 更懂项目"这个目标,分歧只在手段。而手段的选择,JohnBooty 给出了最好的检验标准——别信任何人的教条,去读你自己的会话转录文本,数一数 token 到底烧在哪。这场论战最大的价值,不是让你站队"文档派"或"记忆派",而是逼你回答一个具体问题:你的 Agent 上一次因为"忘了"而返工,到底是因为缺一段文档,还是因为缺一次检索?答案不同,解法完全不同。
一手来源:Kevin Liao《Agents Don't Need Memory. They Need Documentation.》(liao.gg,2026-10-03);Hacker News 讨论帖(2026-10-03 提交,近 400 points、300+ 评论)。链接见本文 sources。
原始来源
相关文章
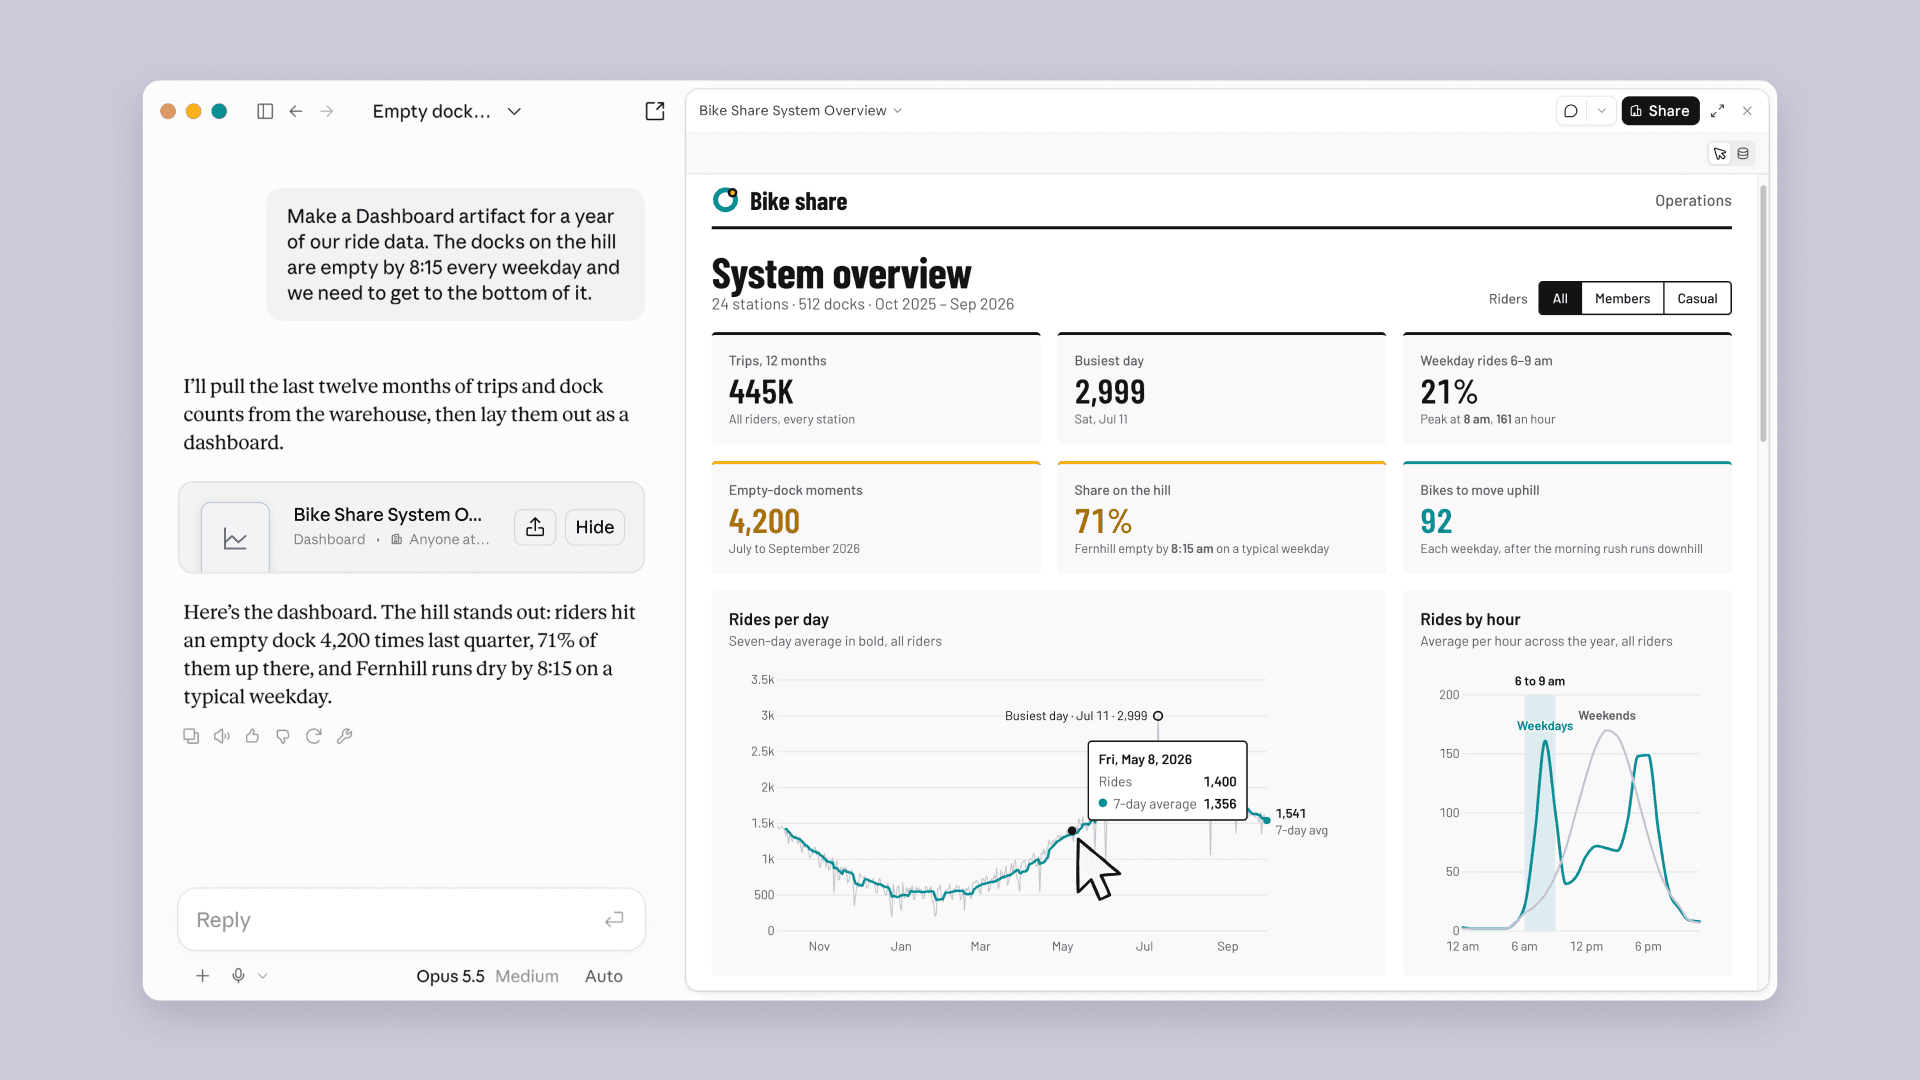
2026 年 10 月 8 日,Anthropic 官宣 Claude Dashboards 与 Claude Motion 进入 beta:前者用自然语言提问直连公司数据生成实时看板,后者输出可编辑的代码而非视频生成模型的合成画面。同时 Docs、Slides、Design 全量转正,Claude 内已产出超 4500 万份文档与设计。本文拆解功能细节、企业开关坑与独立开发者的行动建议。
Adversa AI 10 月 6 日披露新型攻击 CCI:恶意指令藏在 AES-256 加密文本中,诱使 Copilot CLI 在 autopilot 模式下用自己的代码环境解密,并把解密输出当成可信指令执行。演示里一个加密网页让 agent 读走本地 .env.prod 并外发,全程 28 秒、零确认、零提示。微软 mai-code-1.1-flash 50% 沦陷,GPT-5.6 系模型全部拒绝;GitHub 复现后拒绝认定为漏洞。本文复盘完整攻击链,并给出 vibe coder 今天就能照做的防护动作。
DuckDB v2.0 的 CLI 学会了识别调用方是不是 AI Agent:方框表格换成紧凑 Markdown、截断显式声明、错误走 JSON、长查询先报成本。官方用 22 个 TPC-H 自然语言问答实测,输出 token 降 59%,却也诚实承认总成本只省 0.5%。这是开发者工具为“模型读者”重写输出的范式转移样本。