CUDA 的护城河被填平了?DeepSeek 开源昇腾版 TileLang,与英伟达工具链一一对应
9 月 30 日,DeepSeek 一口气开源了 6 套面向华为昇腾的基础设施组件:TileLang 昇腾版、DeepGEMM、DeepEP、TileKernels、FlashMLA、DeepSelect,每一套都与英伟达工具链一一对应。其中 TileLang 封装了昇腾 Ascend C 底层指令,同一套 Python API 可在英伟达 GPU 与华为 NPU 上运行。这批组件已承载 DeepSeek V4 系列训练的大部分算子实现,并以 MIT 许可开源。但 README 里的但书同样值得细读:性能数字跑在未公开的 PoC 硬件上,部分通信原语仍在优化中。
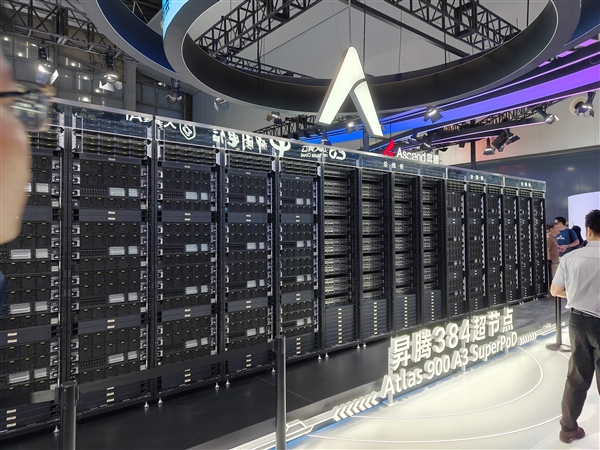
9 月 30 日,DeepSeek 的官方公众号推送了一条看起来不起眼、但分量极重的消息:它把自己训练和推理栈里用的 6 套高性能基础设施组件,全部加上了华为昇腾(Ascend)后端的支持,并且开源。同一天,GitHub 上的 deepseek-ai/TileKernels 仓库 README 的 "News" 一节写下了那行字:"[2026-09-30] Huawei Ascend support"。一周之后,CNMO 和红星资本局的报道把它推上了热搜话题。但热闹之外,真正值得细读的是这件事的技术结构:DeepSeek 不是发了一个模型,而是在给中国开发者发一本"迁移词典"——CUDA 能干的事,昇腾也能干,而且代码基本不用改。
这次开源到底包括什么:6 套组件,与英伟达工具链一一对应
先把清单摆出来,因为这是全文的骨架。DeepSeek 这轮给昇腾适配的 6 套组件,每一套都对应英伟达生态里的一件"标配":
- TileLang 昇腾版——对应 CUDA 本身,或者说对应 Triton。TileLang 是 DeepSeek 开源的领域专用语言(DSL),写一次算子,多硬件后端编译执行。这次的昇腾支持,把它封装了昇腾底层的 Ascend C 指令集,让开发者不用直接啃 Ascend C 也能写高性能算子。
- DeepGEMM 昇腾版(deepseek-ai/DeepGEMM-Ascend)——对应英伟达平台上的 cuBLAS/cuBLASLt 和 DeepGEMM 本体。GEMM(通用矩阵乘法)是大模型训练里吃掉最多算力的操作之一,DeepGEMM 是 DeepSeek 自研的 FP8 高性能 GEMM 库;这次的昇腾版兼容既有英伟达版 API,同时支持 BF16、FP8、FP4 三种精度的矩阵运算。
- DeepEP 昇腾版(deepseek-ai/DeepEP-Ascend)——对应英伟达平台上的 NCCL 通信库里最难的那部分。DeepEP 是专为 MoE(混合专家)架构设计的 expert-parallel 通信库,处理的是"token 该发给哪个专家"这种 All-to-All 通信,正是 DeepSeek-V3/V4 这类 MoE 模型训练和推理的命门;它的对外接口刻意与英伟达版对齐,方便开发者直接沿用熟悉的调用方式。
- TileKernels(deepseek-ai/TileKernels)——对应一整套手写 CUDA kernel 的集合。这是一个用 TileLang 实现的数十个深度优化算子的库,覆盖 MoE 路由、FP8/FP4 量化、RoPE、Engram 门控、流形超连接等 LLM 训练推理的常见操作。README 写得很直白:大多数算子的性能接近硬件的计算或带宽上限,而且全部算子都已经用在 DeepSeek 内部的训练和推理任务里。
- FlashMLA(昇腾适配)——对应英伟达平台上的 FlashAttention 系列。MLA(多头潜在注意力)是 DeepSeek-V2 以来赖以成名的注意力机制创新,FlashMLA 是它的高性能实现;有了昇腾版,昇腾卡也能跑满 MLA 的推理吞吐。
- DeepSelect(deepseek-ai/DeepSelect)——对应推理侧的采样/选择类算子优化,补齐了推理链路的最后一环。
看懂这个对照表,整件事的野心就清楚了:DeepSeek 不是在零散地"支持一下国产芯片",而是把自己在英伟达卡上验证过的整条高性能工具链,原样平移了一套到昇腾上。从写算子的语言(TileLang),到最吃算力的矩阵乘(DeepGEMM),到最难的通信(DeepEP),到现成的算子库(TileKernels),再到推理优化(FlashMLA、DeepSelect)——六件套,件件有英伟达生态里的对标物。这就是为什么有人说,它在"填平 CUDA 的护城河"。我的判断是:护城河填没填平另说,但这本"词典"的页数,确实是前所未有的厚。
为什么 TileLang 才是真正的狠角色
六件套里如果只能记住一个名字,记住 TileLang。它不是又一个 kernel 库,而是一门语言——一门"写一次、跑在多种硬件上"的算子 DSL。
要理解它的分量,得先说说 CUDA 的护城河到底是什么。很多人以为护城河是英伟达的卡卖得好,这是结果不是原因。真正的原因是:过去十几年,全球的研究者和工程师用 CUDA 写了海量的高性能代码,从 cuDNN 到各种手写 kernel,这些代码沉淀成了"资产",而资产是带不走的。你想换芯片?可以,但你的代码库、你的调优经验、你踩过的坑,全都得重来。这才是 CUDA 最难撼动的地方:难撼动的从来不是硬件本身,而是十几年攒下的软件生态。
TileLang 掐的正是这个七寸。它的思路是把"算子逻辑"和"硬件后端"解耦:开发者用 TileLang 写算子,同一套 Python API,运行时自动选择后端——README 的原话是 "the same Python APIs run on both NVIDIA GPUs and Huawei NPUs"。这意味着,一个团队今天在英伟达卡上写的 TileLang 算子,明天换昇腾卡,大概率不用重写。这不是"兼容",这是把迁移成本从"重写代码"降到了"换个后端"。
更狠的是,TileLang 的昇腾后端封装的是 Ascend C——华为 NPU 最底层、性能天花板最高、但也最难写的编程接口。Ascend C 的心智负担不亚于早年的 CUDA C,能写好的人凤毛麟角。TileLang 把这一层包起来,等于把昇腾高性能编程的门槛从"专家级"降到了"会写 Python 就行"。生态的护城河,恰恰就是由无数个这样的门槛砌成的;DeepSeek 这次拆掉的是其中最高的一块砖。
TileKernels:DeepSeek 把自己的"家底"掏出来了
回到这次新闻里最显眼的仓库 TileKernels。它今年 4 月 22 日才创建,9 月 30 日加上昇腾支持后,一周多拿到了 1940 颗星——对一个底层算子库来说,这个增速很说明问题:它解决的是真痛点。
README 里有三处值得逐字读。第一处是功能列表:MoE 路由的 Top-k 专家选择与打分、逐 token / 逐 block / 逐通道的 FP8/FP4 量化与反量化、融合了 SwiGLU 的量化算子、Engram 门控(含前向反向与权重梯度归约)、RoPE 旋转位置编码——全是 LLM 训练推理里"性能敏感且人人都得写一遍"的脏活累活。第二处是那句"Most kernels achieve performance close to the hardware's compute or memory bandwidth limits"——接近硬件屋顶,意味着这不是教学性质的 demo 代码,是生产级的东西。第三处是"All of these kernels have already been used in our internal training and inference workloads"——全部在内部真实 workload 上跑过。
细心的读者可能已经注意到了功能列表里两个陌生的名字:Engram 和流形超连接(Manifold HyperConnection)。它们不是通用术语,而是 DeepSeek V4 系列引入的新架构组件——Engram 是一种带门控的记忆机制,流形超连接则是对残差连接的推广。这两个算子出现在开源库里,侧面印证了官方公告的说法:这批组件确实承载了 V4 训练的大部分算子实现。换句话说,DeepSeek 把自己最新一代模型训练时打磨出来的"兵器",直接交到了社区手里。这种"用最新款武装所有人"的做法,在开源史上也不多见:通常的剧本是先开源上一代,最新一代留着当护城河。
第三处最值得玩味。开源圈有个公开的秘密:很多大厂开源的是"能开源的部分",核心家底捂得严严实实。但 DeepSeek 这次的说法是反过来的——据官方公告,这批组件已经承载了 DeepSeek V4 系列训练中的大部分算子实现。换句话说,它开源的正是自己吃饭的家伙。这在国产大模型厂商里是空前的:以前大家开源模型权重已经算大方了,开源训练用的高性能基础设施?没有先例。
顺带一提仓库的 Acknowledgement 一节,DeepSeek 专门感谢了华为"在 TileKernels 昇腾后端开发过程中的技术支持与工程 expertise"。这不是客套话——从 Requirements 一节能看出,昇腾后端要求 Ascend 950 NPU 和 CANN 9.2.0 以上,没有华为的深度配合,这种适配做不出来。双方还宣布要联合推进昇腾 950 的 128 卡超节点的深度优化。注意这个数字:128 卡超节点,对标的是英伟达 NVL72 机柜那种"把几十上百张卡做成一台大计算机"的形态。优化的目标从来不只是"能跑",而是"跑得满"。
"迁移词典"的含金量:为什么这比发一个大模型重要
好了,现在可以回答那个关键问题了:为什么我说这比发一个新模型更重要?
因为模型的竞争是"点"的竞争,工具链的竞争是"面"的竞争。一个新模型发布,热度持续两周;一套工具链铺开,影响的是未来五年所有在这条链上开发的人。CUDA 的生态就是这么建起来的:不是靠某一张卡,而是靠让全世界的开发者"只能"用 CUDA 写出高性能代码,然后这些代码反过来锁死了硬件选择。
DeepSeek 这次做的,恰恰是在复制这套打法,只是换了个方向:让开发者"不用"被锁死。当 TileLang + 六件套成熟到一定程度,一个创业团队选硬件的时候,算账的方式会变。以前算的是"昇腾卡便宜但没人会调,不敢用";以后算的是"同一套代码,哪个便宜用哪个"。硬件的差异化竞争,最终都会收敛到软件生态的竞争——DeepSeek 把生态的入场券发到了所有人手里,而且是 MIT 许可,商用无忧。
这里还有一个容易被忽略的视角:DeepSeek 为什么要干这件事?它又不卖芯片。最直接的解释是成本与自主:自己的训练越来越依赖国产算力,与其每次都从头适配,不如把适配层做成开源标准,让全社区一起维护。更高明的解释是战略:当整个中文 AI 生态都跑在"DeepSeek 定义的工具链"上,DeepSeek 就成了事实上的标准制定者——就像当年谷歌开源 TensorFlow,图的不是卖框架,是定义游戏规则。DeepSeek 连框架都省了,直接定义到了算子这一层。
冷静剂:README 里值得如实呈现的但书
一篇合格的报道不能只讲好消息。TileKernels 的 README 里其实藏着几处"但书",值得如实摆出来——有趣的是,这些但书反而让整件事更可信。
第一,性能数字跑在"期货硬件"上。据社区对官方仓库 README 的梳理,这些性能数字是在华为提供给 DeepSeek 的概念验证版硬件开发套件(PoC HDK,尚未对外公开的早期测试硬件)上、再加一套同样未公开的手动配置才跑出来的;README 写明,要拿到完整带宽,得等华为 Atlas 850E 商用版硬件开发套件上市,官方规划在 10 月中旬前后,但那只是厂商的发布计划,实际时间仍可能变动。换句话说,今天看到的"接近硬件上限",上限本身还坐在期货里。任何把话说满的解读,在商用硬件实测出来之前都值得打个问号。
第二,通信和部分算子还在"施工中"。分布式通信的部分,README 承认得相当直接:DeepEP 在专家并行规模(EP,即一次有多少张卡同时分工处理不同专家)不超过 32 时,数据分发带宽约能达到物理上限的 90% 至 95%;但规模再放大、以及结果汇合(combine)的性能,写的是"仍在优化"。部分集合通信操作目前还在开发中,部分接口也还处于实验阶段。号称对标 CUDA 的那一层也有缝隙:FlashMLA 那颗融合了 Q-norm、RoPE、注意力运算与类型转换的融合算子,目前只支持英伟达平台,昇腾版还没有;DeepSelect 的昇腾版目前只吃 bf16 格式,不支持 fp32。想接入这套工具链的团队,还得先配齐对应的芯片、CANN 9.2.0 以上版本的软件栈与固件环境,门槛并不低。
第三,硬件门槛是现实的。Requirements 写得明明白白:昇腾后端需要 Ascend 950 NPU 和 CANN 9.2.0。对绝大多数个人开发者来说,手头根本没有这张卡——昇腾 950 是数据中心级的 NPU,不零售。所以这次开源的直接受益者,首先是拥有昇腾算力的云厂商、高校和机构,其次才是通过云上算力间接受益的个人开发者。指望"今晚就在笔记本上跑起来"是不现实的。
把这三条但书摆出来,不是为了泼冷水,而是为了说明:这件事的价值不在"今天",而在"方向"。方向对了,数字和生态都会跟上;方向错了,数字再好看也是昙花。我的判断是方向没错——因为"降低迁移成本"这个需求是真实且刚性的,只要国产算力还存在,它就不会消失。
对 vibe coder 和独立开发者意味着什么
读到这里,你可能会问:我是写应用的,又不训大模型,这事跟我有什么关系?关系比你想象的大,而且是分两层。
第一层是推理成本。应用开发者不直接写 kernel,但你调用的每一个模型 API,背后都是推理成本。FlashMLA、DeepSelect 这些推理优化组件成熟之后,跑在昇腾上的推理服务成本有机会显著低于英伟达方案——省下来的都是真金白银。当国产算力上的推理足够便宜、足够稳,独立开发者能负担的调用量、能尝试的产品形态都会变多。算力平权这件事,最终会传导到每一个调 API 的人身上。
第二层是"第一手工具链"的归属感。过去中国开发者在高性能计算领域,长期处在"二等公民"的位置:新硬件出来了,工具链要等;等来了,文档是英文的,例子是跑在英伟达卡上的。这次反过来了:DeepSeek 的六件套,昇腾支持是和官方公告同步开源的,中国开发者第一次在国产算力上拿到了第一手的高性能工具链——MIT 许可,README 还是中英双语的。这种"首发体验",对生态信心的提振作用,不亚于任何性能数字。
更具体一点:如果你在做和 LLM 推理相关的独立产品(比如本地知识库、Agent 应用),可以开始关注云厂商的昇腾实例价格了。当"昇腾推理"从一个营销词变成一个有完整工具链支撑的选项时,第一批把它用进产品、把成本打下来的人,会吃到实实在在的红利。技术红利的窗口期从来不长,先看到的人先吃到。
一个值得追问的问题:华为为什么需要 DeepSeek 来做这件事
最后留一个开放式的问题,也是我觉得这轮新闻里最耐嚼的一层:昇腾是华为的芯片,Ascend C 是华为的接口,CANN 是华为的软件栈——为什么给昇腾写"CUDA 替代品"这件事,是由 DeepSeek 来干的,而不是华为自己?
一种解读是分工使然:华为擅长做硬件和底层,但"大模型训练到底需要什么样的算子库",最有发言权的是天天训模型的人。DeepSeek 恰好是全世界把 MoE 模型训得最明白的团队之一,它知道通信库的瓶颈在哪、量化算子的坑在哪。这种"来自一线的需求定义能力",是再强的硬件团队也买不来的。
另一种解读更扎心:这恰恰说明了软件生态有多难建。华为做了这么多年昇腾,MindSpore、CANN 都在推,但开发者买不买账是另一回事。一个生态的建成,需要"杀手级应用"来牵引——当年 CUDA 的爆发靠的是深度学习,昇腾的爆发可能要靠大模型。而 DeepSeek,就是那个自带流量和开发者的"杀手级牵引者"。华为提供工程支持,DeepSeek 定义工具链,这是一次教科书式的"硬件厂 + 头部用户"结盟。
但硬币的另一面是:这种结盟能走多远,取决于 DeepSeek 的投入是不是一次性的。开源仓库最怕的就是"发布即巅峰",后面没人维护。如果 TileLang 的昇腾后端能持续跟进、如果 128 卡超节点的优化真的落地、如果社区开始贡献第三方 kernel——那今天的新闻就是国产 AI 基础设施的一个历史性起点。如果没有,那它也只是一次漂亮的公关。README 的 commit 历史会给出答案,我们保持关注。
还有一个更长期的变量:美国的出口管制。昇腾存在的战略意义,一半来自性能,一半来自"买不到英伟达时还有的选"。DeepSeek 这套工具链的价值,在"有选择"的世界里是成本优化,在"没选择"的世界里就是生命线。两种剧本下,它的战略分量只会增加不会减少——这也是我敢把"历史性"三个字放在上面的原因。
一句话总结:DeepSeek 这次开源的不是代码,是选择权。当"只能用 CUDA"变成"可以用昇腾",护城河就不再是护城河,而只是一条河——河,是可以架桥的。
原始来源
相关文章
10 月 6 日,Cursor 官方 changelog 上线 Remote Control:iOS App 可以查看本机运行中的本地 Agent 并发消息指挥。算力留在本地,搬进口袋的只是你的视线。继 10 月 1 日 Conductor 的 iPhone App 之后,一周之内两家厂商押注同一个交互方向——编程 Agent 的交互正在从“终端对话”变成“随身监工”,工作流变成“发起—离开—干预”三段式。
Vercel 在 10 月 7 日的 changelog 里上线了 stealth 推理模型 Glyph Cluster:面向 coding 与长上下文分析,支持 function calling 与流式输出,Pro / Enterprise 且购买过 AI Gateway credits 的团队在 stealth 期间免费调用(模型名 stealth/glyph-cluster),可在 Claude Code、Codex、Cursor 里直接切换。本文拆解它的能力定位、为什么独立开发者值得花一下午实测对比、AI Gateway 统一网关的 failover 与预算控制价值,以及必须先看清的三条限制:纯文本输入、无 structured outputs、无 ZDR——prompt 与 response 可能被用于训练,商业代码先定数据边界再喂。
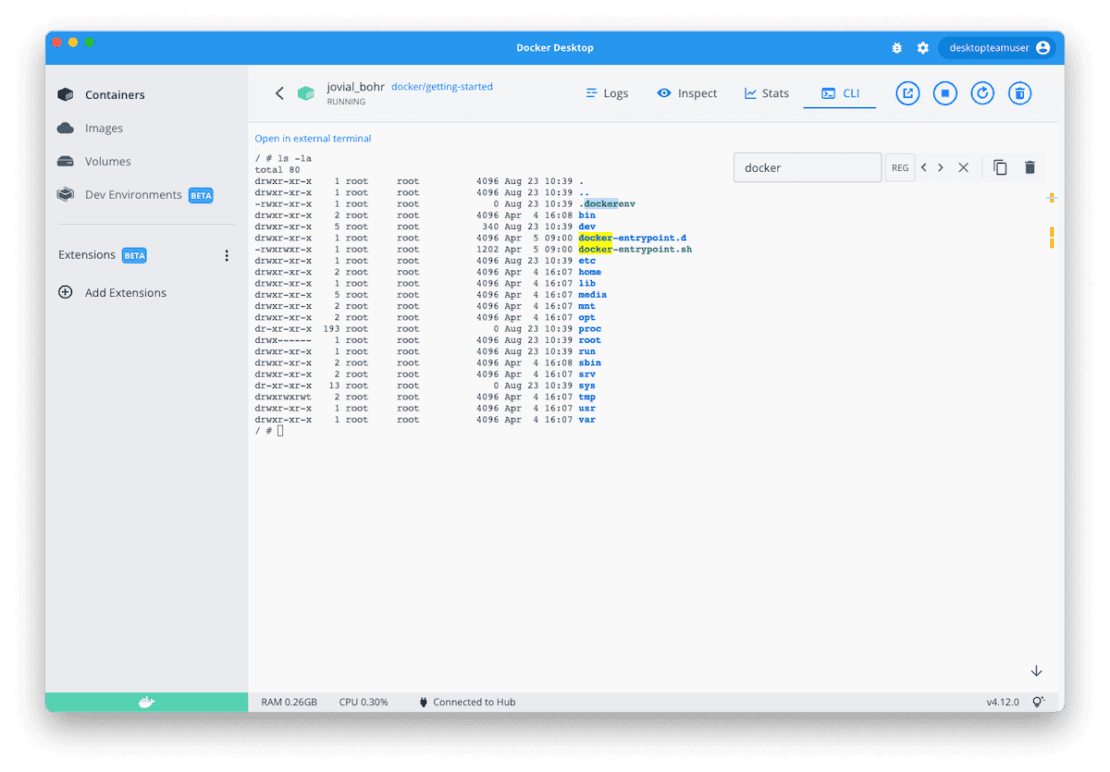
10 月 8 日,Docker 官方开源的 docker CLI 插件 Docker Agent 冲上 HN 首页(290 points / 133 评论),dev.to 技术 digest 同日收录。它用声明式 YAML(agent.yaml)定义 Agent,“no code required”,命令语法与容器一致(docker agent run agent.yaml / myorg/agent:tag)。模型无关七家(OpenAI、Anthropic、Gemini、AWS Bedrock、Mistral、xAI、Docker Model Runner)、工具走原生 MCP、内置 think/todo/memory、RAG 四件套、多 Agent 自动委派。最狠的一招:Agent 可 push/pull 到任意 OCI registry,像镜像一样分发——Agent 定义第一次变成可版本化、可 PR 评审的制品。仓库 2025 年 9 月创建、10,735 commits、263 releases,不是跟风之作:这是“Agent 工程化”的标志性事件。