当法律成为高 stakes 考场:Z.ai GLM-Legal 拿下 Harvey LAB 19.2%,比基座翻近 3 倍
Z.ai 发布法律垂直 agent 模型 GLM-Legal,Harvey LAB 全通过率 19.2%,是基座的近 3 倍,单次测试成本仅 0.15 美元。但官方对比图选择性省略了排名更高的 6 个模型——榜首 Muse Spark 1.2 高达 25.42%。本文卸妆看真相:分数怎么考的、代价是什么、对做应用的人意味着什么。
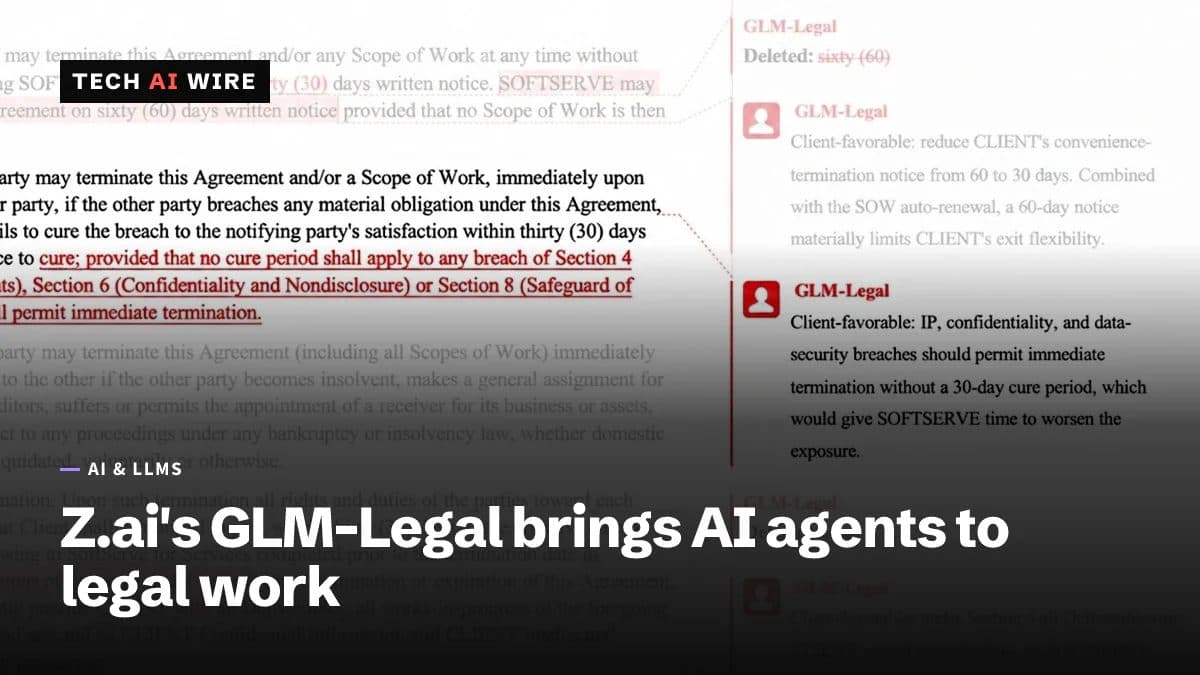
法律可能是检验 agent 的最狠考场。代码写错了,测试会挂、CI 会红,最多回滚重来;合同审错了,丢的是一家公司的钱,和一个律师的职业生涯。10 月 12 日,Z.ai 把这张考卷交了上去:在官方博客发布法律垂直 agent 模型 GLM-Legal,号称在 Harvey Legal Agent Benchmark(Harvey LAB)上拿下 19.2% 的全通过率,是基座 GLM-5.3-Flash(6.7%)的近 3 倍。数字确实漂亮——漂亮到官方宣传图让人忍不住多看两眼:图上 GLM-Legal 力压 Kimi K3(12.92%)、Claude Fable 5(11.25%)和 GPT-6 Astra(5.42%),一副"法律 agent 新王登基"的架势。
但这张图藏了一半真相。独立评估机构 Vals AI 的 Harvey LAB 榜单上,79 个模型里 GLM-Legal 排第 7,得分 19.17%。排在它前面的 6 个模型,一个都没出现在 Z.ai 的官方对比图里——榜首是 Meta 的 Muse Spark 1.2,25.42%,比 GLM-Legal 高出整整 6 个百分点。Vendor 的图表从来不是照妖镜,是化妆镜。这篇文章我们把妆卸了:看 GLM-Legal 到底考了多少分、怎么考的、代价是什么,以及对做应用的人意味着什么。
这是一套什么系统
GLM-Legal 不是从零训练的新模型,而是站在 GLM-5.3-Flash 肩膀上的垂直特化版本。基座是 320B 总参数、每 token 只激活 18B 的 MoE 架构,1M token 上下文——就是 8 月刚以 MIT 协议开源权重的那款。Z.ai 的训练分两个阶段走:先在更大的法律语料上做 mid-training,把"从事实到规则再到结论"的法律推理链条刻进模型;再用强化学习,在"数万个仿真法律环境"里打磨 agent 行为。
有意思的是第二个细节:模型和 agent harness(驱动 agent 和工具的那套软件)是联合演进的。训练中暴露的边缘案例,先暴露 harness 的瓶颈;修好 harness,又反过来让模型面对更真实的约束。用 Z.ai 自己的说法,"harness 架构与模型训练同步迭代"。这其实点出了 2026 年 agent 模型的一个关键转向:benchmark 考的不再是裸模型,而是"模型 + 脚手架"的整套系统。以后看任何 agent 模型的分数,都要多问一句:这里面有多少是 harness 的功劳?
为什么选法律?Z.ai 的解释是:法律工作把事实、法条、分析推理、客户可交付成果串成一条不断的链条,给一个专业任务,agent 必须从源文档里提炼核心争议、构建站得住脚的论证、再按任务要求精确格式化输出——同时满足所有这些约束,是检验领域模型在高 stakes 专业环境里干活的理想压力测试。翻译一下:法律是"一步错、满盘输"的典型场景,天然适合 all-pass 计分的 benchmark。
19.2% 到底是怎么考出来的
Harvey LAB 是法律科技公司 Harvey 推出的开放 benchmark:1250 个任务,覆盖 24 个执业领域,背后是超过 7.5 万条专家手写的评分标准。它的计分方式叫全通过(all-pass):一道题只有所有评分标准都满足才算通过,一步错整题零分,没有部分 credit。这种"严苛"正是它的价值——它考的不是"答得像不像",而是"能不能端到端交付"。Vals AI 在 held-out 集上用 2 个 LLM 裁判、断网环境复现了 Z.ai 的数字:19.17%,79 个模型中排第 7。
 Harvey LAB 的设计初衷:用 1250 个真实律所工作流任务、7.5 万余条专家评分标准,以全通过(all-pass)方式检验法律 agent。一步错即整题零分,没有部分 credit。
把榜单摊开看,故事就完整了。GLM-Legal 的 19.17%,确实赢了 Kimi K3(12.92%)、Claude Fable 5(11.25%)和 GPT-6 Astra(5.42%)——这三家正是 Z.ai 官方图里精心挑选的对手。但榜单前六名呢?Muse Spark 1.2 以 25.42% 断层领先,后面还跟着另外几个 Muse Spark 系列模型和 Google 的 Gemini 4 Argon。Z.ai 的官方对比图把这 6 个全裁掉了,一个没留。这是整件事里最值得写进正文的判断:12.5 个百分点的提升是真实的、被独立复现的,比大多数 vendor 的 benchmark claim 都硬;但"选择性对比"暴露的营销本能,和工程实力是两回事。以后看到任何 vendor 的对比图,第一反应应该是去原榜单看全量排名——这条经验在这次事件里被验证得淋漓尽致。
另外两项 benchmark 也值得细看。LegalBench 上 GLM-Legal 86.2%,和 Kimi K3 持平,落后 Claude Fable 5 的 88.6% 和 GPT-6 Astra 的 87.1%;中文法律场景的 PLawBench(法律咨询、案例分析、文书起草)上 77.3%,落后 Fable 5 的 77.7%。Z.ai 的口径是"比肩前沿闭源模型",数据上看是"接近但没超过",措辞的分寸感拿捏得很有技巧。还有一处小伤口:Vals AI 的 Legal Research Bench 上,GLM-Legal 41.83%,反而不如自家基座的 45.19%——垂直特化是有代价的,通用法律检索能力被 trade 掉了 3 个多点。做取舍时没有免费的午餐,这句话对模型微调同样成立。
真正的卖点其实是成本和速度
如果只看分数,GLM-Legal 是"第 7 名",不算惊艳。但把价格牌翻出来,故事就变了:Vals AI 的实测里,跑一次 Harvey LAB 测试,GLM-Legal 只要 0.15 美元——Claude Fable 5 是 19.23 美元,GPT-6 Astra 是 26.16 美元,Gemini 4 Argon 是 10.55 美元。注意这个 0.15 美元是 Vals 按 GLM-5.3-Flash 的公开费率(输入 0.075 美元 / 百万 token)推算的,因为 Z.ai 根本没公布 GLM-Legal 的价格。1/128 的成本,打 7 折不到的分数(19.17% vs 25.42%),这是典型的"性价比错位竞争":我不跟你争第一,我让你用得起。
代价是时间。单任务平均耗时 1 小时 12 分钟,而榜首 Muse Spark 1.2 只要 24 分钟。慢 3 倍,便宜 100 多倍——这笔账对律所这种"不差钱但差人"的场景不一定划算,但对想批量跑文档初筛的 legal tech 公司,吸引力是实打实的。不过先别急着掏钱:GLM-Legal 目前是申请制 beta,没有公开价格、没有开源权重、连 rate limit 和数据留存政策都没公布。Z.ai 同时把它塞进了自家的桌面 agent AutoClaw(注册送 24 美元额度),走的是"先攒案例、再开放"的 controlled rollout 路线。翻译一下:现在能玩,但别急着把生产流量押上去。
三个演示:看的是 agent,不是聊天
Z.ai 的官方博客放了三个演示,值得注意的是它们全是 agent 任务,而不是聊天问答。合同审查:模型修订一份软件服务合同的终止与交接条款,AutoClaw 把修改写进 Word,带修订标记和批注——律师熟悉的工作流原样保留。证据分析:在 40 份争议文档里找提供方进度报告之间的矛盾点,每个发现都引用 Bates number(诉讼中给共享文件的编号),可追溯性拉满。合规研究:为即将在新加坡、马来西亚、印尼三地上线的网站起草隐私计划,引用各国数据保护法的具体条文。
这三个演示其实定义了 GLM-Legal 的产品形态:它不是一个"更懂法律的聊天机器人",而是一个"能操作文档、按律所流程交付"的 agent。这也是为什么 Harvey LAB 这种考"端到端交付"的 benchmark 比 LegalBench 这种考"单点法律推理"的 benchmark 更能说明问题——Z.ai 自己也很清楚,宣传火力全压在 Harvey LAB 上是有原因的。
对 vibe coder 意味着什么
先说配方。GLM-Legal 走通的路线正在成为垂直 agent 模型的标准打法:强基座 + 领域 mid-training + 仿真环境 RL + harness 联合演进。这套打法完全可以复制到医疗、财税、合规等其他高 stakes 领域。如果你正在某个垂直行业里做 agent 应用,这篇博客的技术路线部分比分数本身更值得读——它告诉你"领域特化"的钱具体花在哪:不是 prompt 写得更长,而是 mid-training 的语料和 RL 的环境。
再说读图表的素养。这次事件给所有人上了一课:vendor 的对比图只放对自己有利的对手。Z.ai omit 掉的那 6 个模型,恰恰是榜单上真正的头部。以后评估任何"xx 模型超越 yy"的宣传,标准动作应该是:找到原榜单,看全量排名,看复现方的数据。独立复现(这里是 Vals AI)是区分"营销数字"和"工程数字"的唯一标尺——GLM-Legal 的 12.5 个点提升经受住了复现,这是它真正硬的部分;选择性对比是它软的部分。两部分要分开看。
第三,19.2% 的另一面是 80.8% 的任务至少错了一步。全通过计分下,五道题里有四道拿不到满分——这意味着法律工具还得有人在回路里(lawyer-in-the-loop),合规工作流别急着全自动。Z.ai 自己也只敢说"申请制 beta",没敢喊"替代律师"。对做应用的人来说,正确的姿势是把这类模型放在"初筛 + 草稿"的位置:40 份文档的矛盾点先让 agent 找一遍,人再复核——演示里的 Bates number 引用设计,就是为这种"人机协作"准备的。
第四,竞争格局。OpenAI 9 月也推了 Astra for Law(GPT-6 Astra + 法律检索索引 + 指令,先卖给 selected 的律所)。两家走的是同一条路:法律 AI 的战场已经从"谁的模型更大"变成"谁的配置(harness、数据、流程)更贴业务"。Z.ai 的差异化是成本和对中文法律场景的覆盖(PLawBench),OpenAI 的差异化是生态和律所关系。这场仗才刚开场,值得持续跟踪的不是下一次分数更新,而是:GLM-Legal 什么时候公开价格、什么时候开放权重、第一批 beta 律所的真实反馈是什么。
最后给想动手的人指条路:基座 GLM-5.3-Flash 是 MIT 开源的,Hugging Face 上能直接拿权重,vLLM 和 SGLang 都能跑。你可以先在基座上搭 pipeline、调 harness,等 GLM-Legal 的模型 ID 可用时再切换——Z.ai 的定价策略大概率会延续基座的低价路线。或者去 AutoClaw 里先体验,24 美元的注册额度够你跑不少测试。记住一点:合同、证据这类数据进 beta API 之前,先把数据留存和区域政策问清楚,白纸黑字拿到手再说。
GLM-Legal 值得一个"谨慎乐观"的评价:工程上,它证明了垂直特化这条路在法律这种高 stakes 领域走得通,12.5 个点的提升是实打实的;营销上,它那张"裁掉前六名"的对比图,恰恰提醒我们这个行业最缺的不是分数,而是诚实。分数会过时,方法论不会——而"永远去看原榜单"这个习惯,比 19.2% 本身更有长期价值。
评论 (0)
原始来源
相关文章
NVIDIA 10 月 13 日官方博客宣布 Nemotron 3.5 Bolt 74B-A9B 24GB,10 月 15 日发布:74B 总参数 MoE agent 模型(每 token 激活约 9B),2-bit 量化压进 24GB,权重、训练数据、配方全开源。发布当天即支持 llama.cpp、vLLM、Ollama、Unsloth、LM Studio,Hermes、OpenClaw 直接接入,恰逢 RTX Spark 笔记本 10 月 16 日开售。
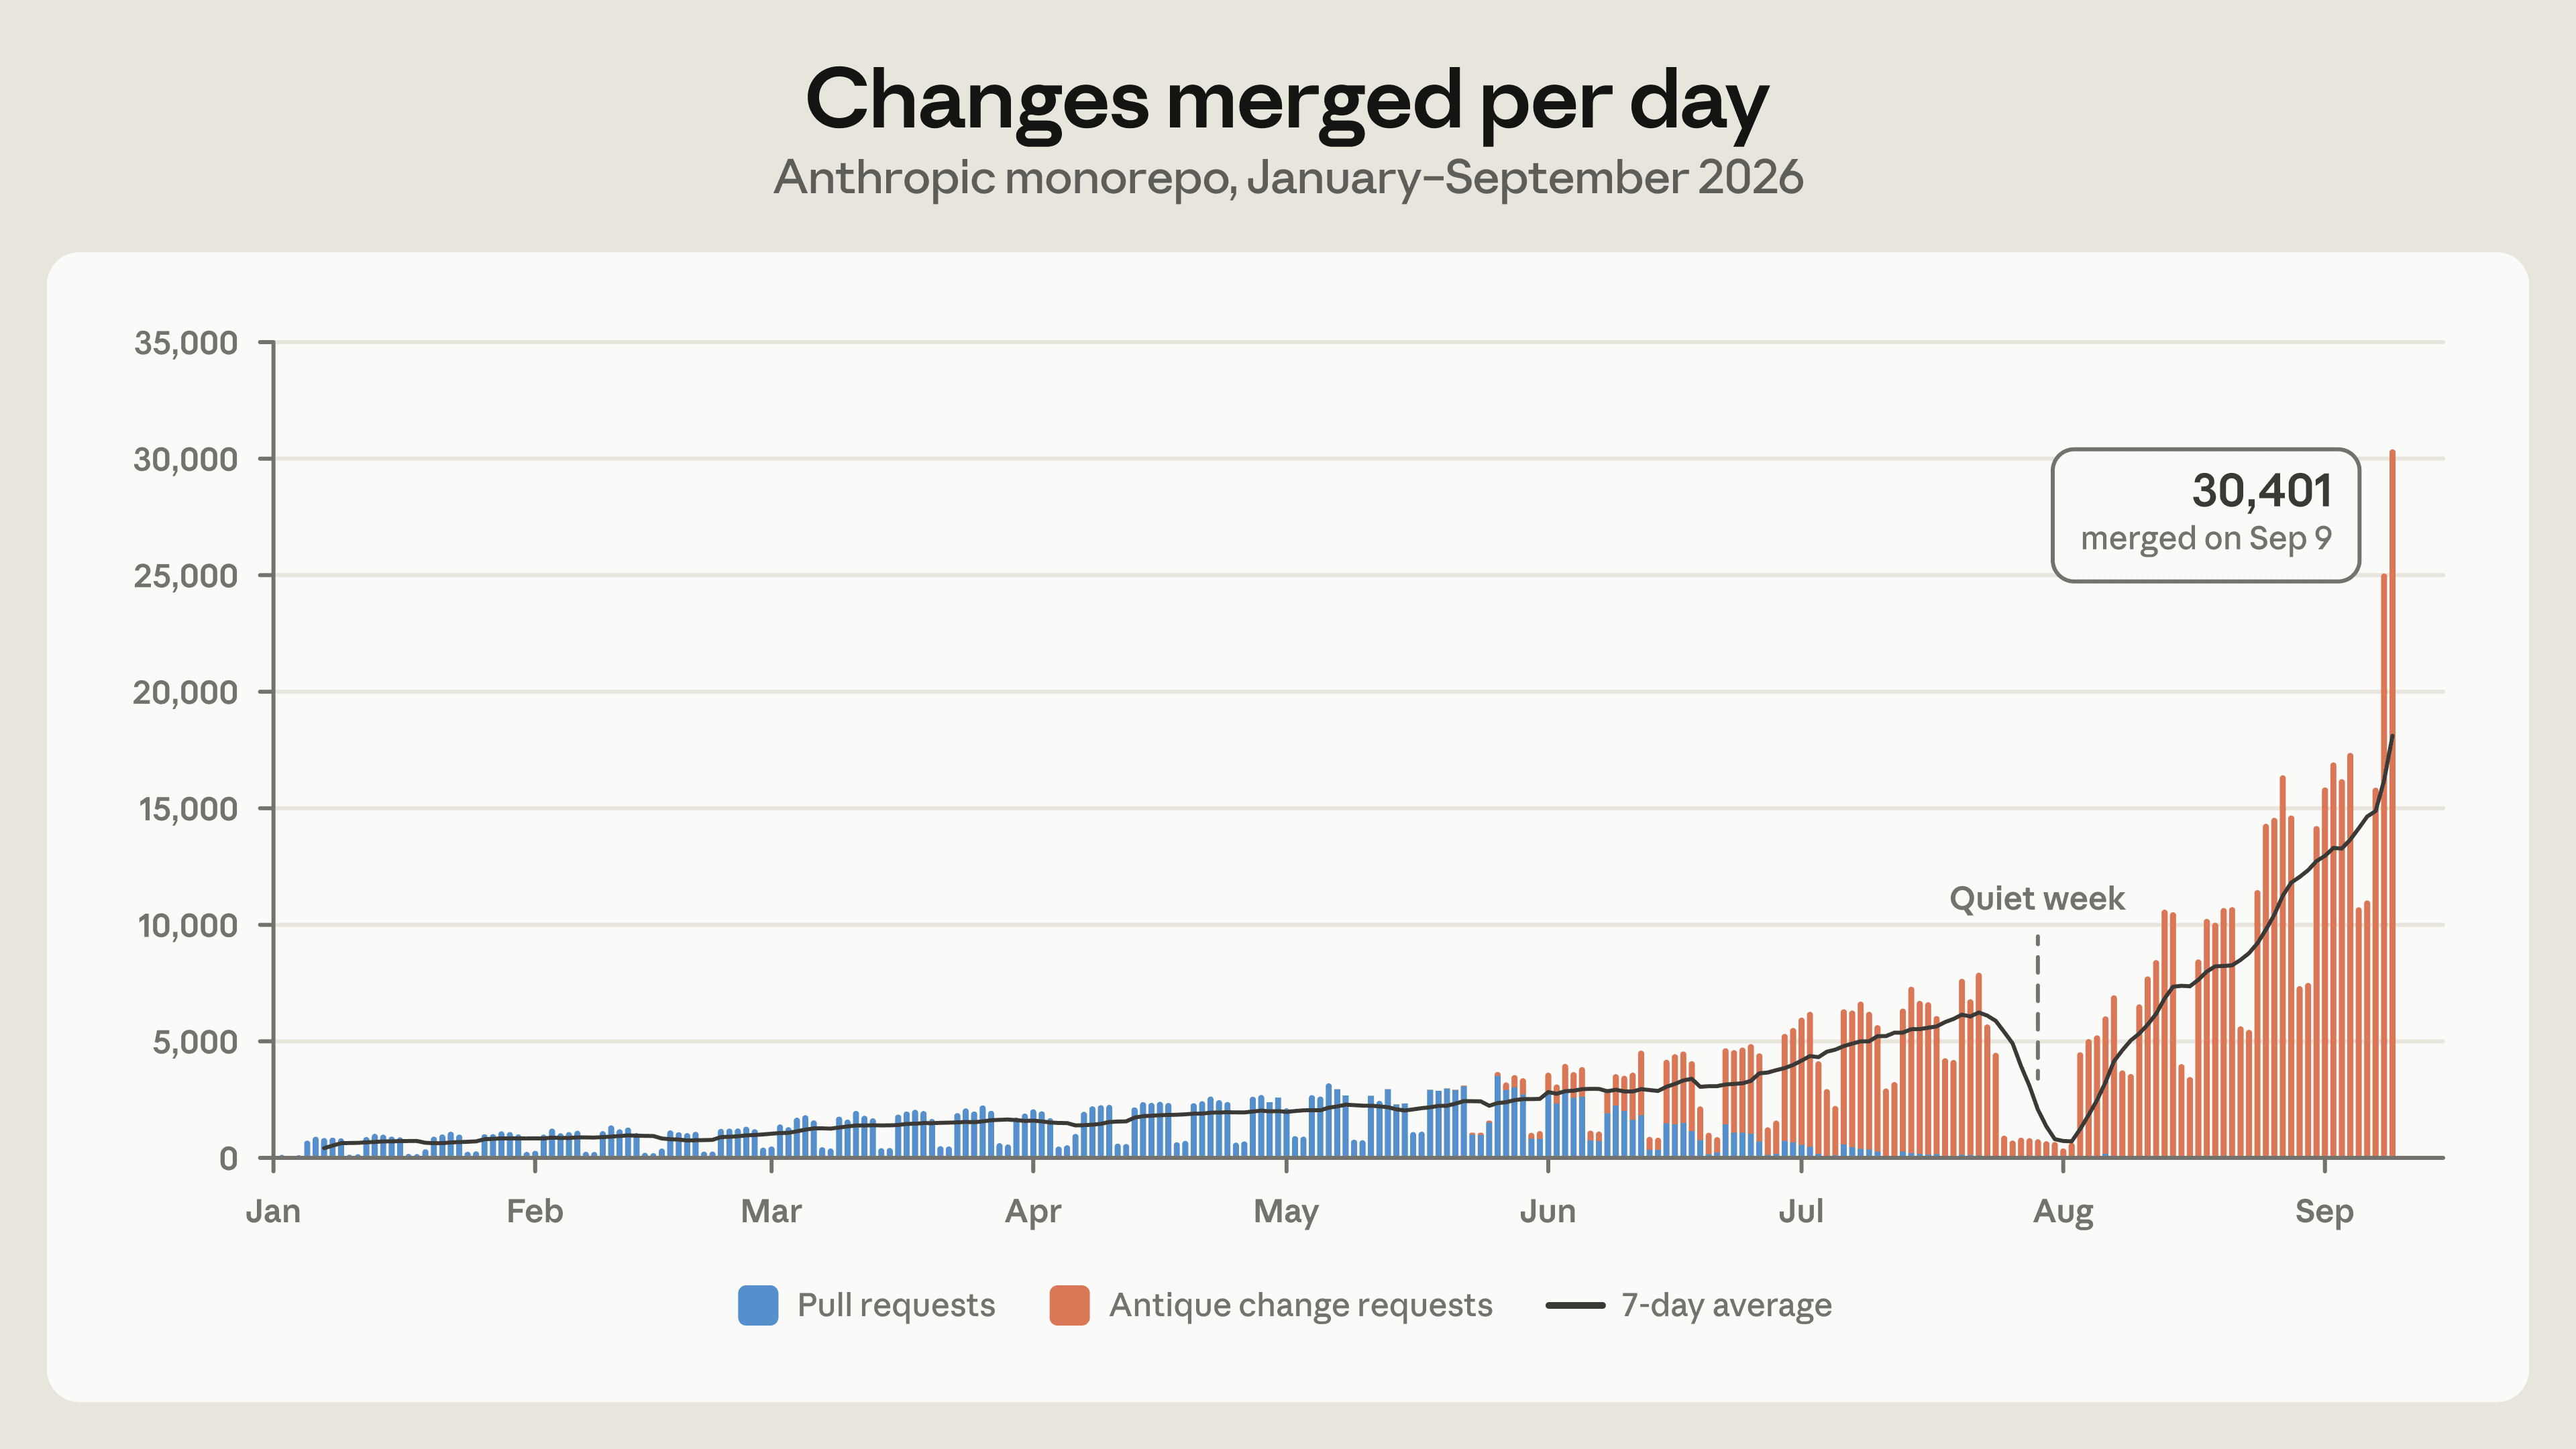
Anthropic 10 月 13 日工程博客披露:Claude 让公司日合并量从 5 月的 2500 次飙到 9 月的 30000+ 次,Git 管道被撑爆。7 人团队 5 个月造出自研版本控制 Scion 与新评审面 Antique,完成全仓迁移——而重写核心管线的正是 Claude 自己。本文拆解 Scion 的六条反 Git 设计原则、200 倍开销缩减的工程细节,以及它给 vibe coder 的三条判断:你的下一堵墙在哪里。
2026 年 10 月 12 日,Cursor 官方宣布将 Cursor 并入 The X Subscription:Grok、Grok Bot、Cursor、X Premium 一价全包,Grok 编码用量至少翻倍;但第三方模型从首个请求起按 API 挂牌价另计,旧 Ultra 停售新用户。本文拆解订阅变化、重算四类 vibe coder 的成本账,并给出观望、切换与混合三种策略。