AI 写代码多 30%,交付却原地踏步:哈佛 718 家公司研究揭示 AI 编程的新瓶颈
哈佛经济学家分析 718 家公司、3 亿个工作事件后发现:AI coding agent 让代码量涨 30%、PR 涨 23%,完工软件却纹丝不动,评审耗时反涨 49%。瓶颈已从写代码转移到审代码。
过去两年,AI 编程工具的营销话术几乎全是同一个句式:「我们的模型又快了 X%,代码生成量又涨了 Y%。」但上周(2026 年 10 月 11–12 日)传开的一项研究,用 718 家公司的真实数据给这个句式泼了一盆冷水:AI coding agent 让代码量涨了 30%,可实际交付的软件——几乎一行动弹不得。
这不是某家厂商的内部试点,也不是几十人的问卷调查。哈佛大学经济学家 Fiona Chen 和 James Stratton 拿到工程效能平台 Jellyfish 的全量遥测数据,覆盖 718 家软件公司、72.5 万名工程师、约 3 亿个工作事件,时间跨度从 2021 年 1 月到 2026 年 3 月。他们用经济学里标准的交错双重差分(staggered difference-in-differences)方法,把「引入 AI 工具前后」的同一批公司拿来对比——结论是:瓶颈已经从「写代码」转移到了「审代码」。
这篇工作论文题为《Artificial Intelligence in the Firm: Bottlenecks in Software Production》(《企业中的人工智能:软件生产的瓶颈》)。它可能是迄今为止关于 AI 编程工具企业级效果最大规模的一次实证研究,值得每个每天和 AI 一起写代码的人认真读完。
一、这项研究到底做了什么
先说说为什么这份研究的分量不一样。过去关于「AI 编程到底有没有用」的讨论,证据基本来自三类:厂商自己发布的生产力报告(样本是自家用户,天然偏向乐观)、几十到几百人的开发者问卷(主观感受多,硬数据少)、个别大公司的内部试点(比如之前流传的某些「AI 让任务快 55%」的说法,样本小、场景窄)。
Chen 和 Stratton 换了一条路。他们拿到的 Jellyfish 数据是工程遥测——GitHub 的提交、PR、Jira 的 issue 状态——都是机器记录的行为数据,不是问卷里的自我感觉。718 家公司在不同时间点陆续引入 AI 工具,这种「有的早、有的晚」的 adoption 时间差,正好让研究者可以用交错双重差分剥离掉「本来就在变好的团队」这类干扰因素。3 亿个工作事件的样本量,也让统计结论的底气完全不一样。
研究还做了一个关键区分:补全式助手(autocomplete-style)和完全 agentic 的工具,效果完全不同。补全式工具只让代码行数涨了约 12%,而且只有「提交数」这一个指标达到统计显著;真正的 agent 型工具(能自己写代码、自己提 PR 的那种)则带来了代码量 +30%、提交数 +20%、PR 数 +23%,三项全部统计显著。换句话说,越「自主」的工具,产出膨胀得越厉害。
二、核心发现:代码多了 30%,软件没多一行
把研究的核心数字摆在一起看,故事就很清楚了:
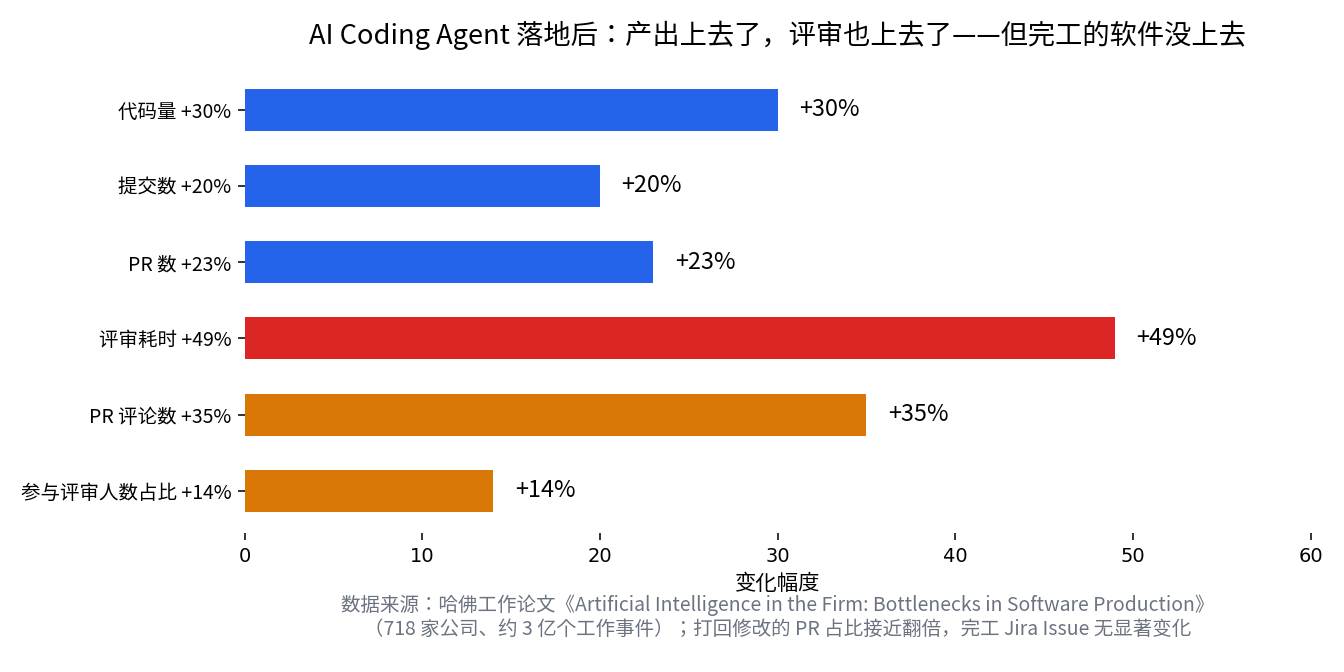
上图:AI coding agent 落地后,产出侧指标全部上扬,评审侧负担同步加重——但完工的软件没有跟上。数据来源:哈佛工作论文。
| 指标 | 变化 | 说明 |
|---|---|---|
| 代码行数 | +30% | agent 型工具,统计显著 |
| 提交数(commits) | +20% | 统计显著 |
| PR 数量 | +23% | 统计显著 |
| 完工的 Jira issue / epic | 无显著变化 | 研究明确排除了高于 12% 的产出增长 |
| 单个 PR 平均评审耗时 | +49% | 评审阶段的直接证据 |
| 被打回修改的 PR 占比 | 接近翻倍 | 质量摩擦在上升 |
| 每个 PR 的评论数 | +35% | 评审者在花更多力气挑毛病 |
| 参与评审的员工占比 | +14% | 公司被迫把更多人调去审代码 |
前三行和第四行的反差就是整篇论文的全部故事:更多的代码进了管道,更多的提交和 PR 在流转,但被标记为「完成」的工作项,原地踏步。研究者的措辞很克制——「little evidence that firms increase software output」(几乎没有证据表明公司增加了软件产出)。但数据本身很不克制:评审耗时涨 49%、打回率翻倍,这不是「AI 写的代码质量差」能简单概括的,这是一个系统性的容量错配。
这里有个细节值得玩味:研究连「12% 以上的产出增长」都统计排除了。也就是说,不是「可能涨了一点但没测出来」,而是「涨也不可能涨多少」。对于天天听厂商讲「10 倍工程师」的从业者来说,这个结论相当刺耳。
三、瓶颈的解剖:评审为什么变慢了
代码评审从来不是为 AI 时代设计的。评审一个同事的 PR,你可以默认对方理解了需求、测过明显的边界情况、写的东西大体符合团队习惯。你审的是「这个人有没有犯糊涂」。但评审 AI 生成的代码,问题清单完全不同:它真的解决了需求描述的问题吗?有没有引入 subtle 的安全漏洞?有没有和代码库里已有的逻辑重复造轮子?六个月后维护这段代码的人会不会骂娘?
AI 生成的代码把评审从「检查同事有没有犯糊涂」变成了「验证机器到底干了什么」——这是两种完全不同的认知负担。
这种审查更费脑子,而且不像生成那样可以规模化。一个 agent 写十个 PR 的时间,人类评审者可能只够认真看完一个。当 PR 量涨 23%,评审队列必然变长——即使每次评审本身不比以前慢。论文的数据印证了这个机制:评审耗时 +49%,而且公司已经在加人了(参与评审的员工占比 +14%),队列还是消化不掉。
最有说服力的是论文里的 21 场访谈。一位资深工程师的原话大意是:Claude Code 这类工具写常规代码「两秒钟就能出一个 90% 正确的草稿」,但复杂任务「频繁出错」,结果是「你花在评审上的时间反而更多了」。这句话戳破了一个幻觉:AI 省掉的是打字时间,欠下的是信任债务,而信任债务的利息是在评审环节支付的。
还有一个容易被忽略的发现:这个瓶颈在「已经用了 AI 评审工具」的公司依然存在,因为最终拍板签字的人还是人类。AI 可以帮你 triage、帮你总结 PR,但「这段代码能不能进主分支」的责任,目前没有任何一家公司的流程敢完全交给机器。这意味着评审瓶颈不是「工具没跟上」的暂时现象,而是「责任归属」这个组织问题的硬约束。
四、一个反直觉的结论:没有裁员潮
论文还有一个值得单独拎出来的发现:引入 AI coding agent 的公司,在总雇佣人数和工程团队规模上都没有显著变化。
这和过去两年「AI 要干掉初级程序员」的恐慌叙事直接相悖。数据呈现的画面是:公司没有因为 AI 能写代码就裁人,而是把省下来(或者说,多出来)的人力重新配置到了评审、测试和返工上。员工总数不变,但「写代码的人」和「审代码的人」的比例变了。
我的解读是:AI 没有消灭软件工程的工作,只是把工作从「生产」环节挤到了「验证」环节。短期看,这对就业是好消息;长期看,这提出了一个更尖锐的问题——如果验证环节的成本迟迟降不下来,AI 带来的到底是生产力革命,还是一场昂贵的「代码通胀」?代码通胀这个词我想认真用一次:货币超发时,每单位货币的购买力下降;代码超发时,每行代码的信任度也在下降,而评审就是为信任重新定价的过程。
五、同一周,厂商们已经在用脚投票
有意思的是,论文传开的同一周,大厂们的产品动作几乎是在给这篇论文写注脚:
- 微软改版 Copilot(Home / Code / Autopilot 三个界面):新的 Code 标签页让 agent 在沙盒里把应用「造完、测完」再交出来,Autopilot 则给 agent 独立的身份和 Outlook 账号——都是在回答「怎么让 agent 的产出更可信、更可审计」。
- 微软把计费改成「按席位 + 按用量」:以前按人头收费,agent 随便生成多少代码成本都一样;现在每次生成都有边际成本。这等于用价格机制逼团队「想清楚再生成」,直接对冲代码通胀。
- GitHub Copilot CLI 的 computer-use 进入公开预览(10 月 1 日):agent 能操作桌面应用了,自主权更大——按论文的逻辑,这会让评审 choke 点更紧,除非 triage 工具同步跟上。
- Google 的 CodeMender 这类「只做安全 finding 分诊」的工具开始被单独拿出来讲:不碰生成,专啃评审前那一层。
- Anthropic 给 Claude Code 加 Mods(可定制的 TypeScript 小函数):思路是让 agent 的行为更可预测、更贴团队习惯,从源头减少评审时的返工,而不是在评审后堆工具。
厂商的十月发布日历几乎都在围攻同一个点:生成已经够快了,下一步拼的是评审吞吐和交付确定性。
你看,2024–2025 年的竞争关键词是「生成速度」「benchmark 分数」;2026 年 10 月的关键词变成了「沙盒」「审计」「triage」「用量计费」。论文只是把厂商们已经心知肚明的东西,用 718 家公司的数据公开说了出来。
六、给 vibe 开发者的五个建议
如果你是一个人 + AI 的独立开发者,或者带一个小团队,这篇论文不是坏消息——它是一份行动指南。瓶颈从生成移到评审,意味着竞争优势也从「谁写得快」移到了「谁交付得稳」。具体可以做五件事:
1. 把 PR 切小,小到评审者一眼能看完。论文里评审耗时涨 49%,很大程度上是因为 AI 一次吐出来的 diff 太大。一个 800 行的 AI 生成 PR,评审者只能走马观花;四个 200 行的 PR,每个都能被认真看。让 agent 按小步提交,是成本最低的信任建设。
2. 给 agent 配一个「评审 agent」做预检。人类评审保留最终签字权,但在那之前,让第二个模型先做 triage:总结改了什么、标出风险点、跑一遍安全扫描。论文发现即使有 AI 评审工具、瓶颈依然存在——但那说的是「最终签字」,没说「预检没用」。预检解决的是评审者的认知负荷,签字解决的是责任归属,两回事。
3. 测试前置,而不是后置。AI 写代码便宜了,验证就必须变便宜,否则 pipeline 永远堵在评审。Meticulous 这类「自动生成上千条用户流、像素级对比」的工具(巧的是它上周刚拿了 1500 万美元 A 轮)卖的正是这个:让 agent 在提交给人类之前,先自己把测试跑完。测试越确定,评审越敢快。
4. 给生成加上成本意识。微软改用量计费是个信号:以后每一次 agent 调用都有价。对小团队来说,现在就可以自己先算账——给 agent 设 token 预算、要求它一次生成多个方案时先说明取舍。免费的生成养不出好的工程习惯。
5. 记录「返工率」,而不是「生成量」。别再统计你的 agent 一天写了多少行代码了,统计它的 PR 一次通过率、被打回次数、从提交到合并的时长。这些才是论文里真正和「交付」相关的指标,也是你个人工作流的北极星。
七、我的判断
这篇论文真正的冲击力不在于「30%」这个数字,而在于它终结了一个叙事:「生成更快 = 交付更快」这个等式,正式失效了。过去四年,整个行业都在优化生成速度;未来几年的竞争,会发生在评审吞吐、验证成本和交付确定性上。
对 vibe coding 社区来说,这是个好消息。独立开发者的优势从来不是「写代码比大厂快」——AI 把这点拉平了。真正的优势是「端到端负责」:需求、生成、测试、评审、发布全在一个人手里,评审瓶颈天然就小。当大公司在为 49% 的评审耗时发愁时,一个对自己代码 100% 负责的独立开发者,反而站在了一个意想不到的有利位置。
代码通胀时代,稀缺的不再是代码,而是信任。而信任,恰恰是小团队最擅长生产的东西。
评论 (0)
原始来源
相关文章
Cognitum One 发布开源 agent 编排平台 Ruflo:把一个任务变成 100+ 专用 agent 的端到端工作流,7.4 万 star、MIT 协议。竞争正从模型层下沉到脚手架层。
2026 年 10 月 12 日,Cursor 官方宣布将 Cursor 并入 The X Subscription:Grok、Grok Bot、Cursor、X Premium 一价全包,Grok 编码用量至少翻倍;但第三方模型从首个请求起按 API 挂牌价另计,旧 Ultra 停售新用户。本文拆解订阅变化、重算四类 vibe coder 的成本账,并给出观望、切换与混合三种策略。
自主测试公司 Meticulous 完成 1500 万美元 A 轮,客户包括 Notion、Dropbox、Wiz。它用确定性浏览器与像素级差异检测,把测试从上线前最后一道检查变成合并 PR 的准入条件。