JetBrains 开源 Mellum 2.1:12B MoE 推理模型,每 token 只激活 2.5B 参数,专为 coding agent 打工
JetBrains 开源 Mellum 2.1:12B MoE 模型,每 token 仅激活 2.5B 参数。架构自 6 月以来原封不动,靠真实环境强化学习把 SWE-bench Verified 从 2.0 干到 47.0。Apache 2.0 协议、可自托管,定位是 coding agent 里便宜快速的执行层——写代码和调工具是强项,最硬核的 agent 任务仍落后 Qwen3.5-9B。
一个把自己炼成"打工仔"的模型
JetBrains 开源了 Mellum 2.1。这家以 IntelliJ IDEA 和 PyCharm 闻名的工具公司,正在做一件很多 IDE 厂商没做的事:自己训模型,自己开源,专供 coding agent 当"打工仔"。关于发布时间需要说明一句:官方博客正文没有显式日期戳,URL 路径为 2026/10;MarkTechPost、oossa、tech-insider 等多家独立媒体一致标注为 2026 年 10 月 8 日,我们采用这个日期。
Mellum 2.1 的参数规模并不吓人:12B 的 MoE 模型,每个 token 只激活 2.5B 参数,Apache 2.0 协议,已上架 Hugging Face。真正值得聊的是它的定位——JetBrains 在官方博客里说得很直白:它是为 coding agent 和"在你自己的硬件上跑的快速子智能体"(fast sub-agents that run on your own hardware)准备的。换句话说,Mellum 2.1 不想当全能大脑,它想当 agent 系统里那个便宜、快速、随叫随到的执行者。
这一定位在 2026 年的 coding agent 浪潮里相当清醒。当所有人都在比谁的大模型 SWE-bench 分数更高时,JetBrains 反其道而行:把 6 月开源的 Mellum 2 架构原封不动留下来,整个夏天只做一件事——post-training。结果是,SWE-bench Verified 从 2.0 跃升到 47.0,翻了 23 倍多。架构没动,能力翻倍,这个故事值得细读。
技术拆解:MoE 架构没变,变的是"打工技能"
先看硬参数。Mellum 2.1 是一个 12B 总参数的混合专家(MoE)模型:64 个专家,每个 token 激活其中 8 个,实际参与计算的参数量为 2.5B。MoE 的精髓就在这里——推理成本按激活参数算,而不是按总参数算。2.5B 的激活量意味着它的单 token 推理开销大致相当于一个 2.5B 的稠密小模型,但 64 个专家的"知识容量"远大于此。这是小模型在 2026 年的主流生存策略:Qwen 系、Gemma 系的同量级开放模型也都在走稀疏路线。
上下文窗口是 131K token。对 agent worker 来说,这个数字是够用的:读几个源文件、看测试输出、做一轮改动验证,基本不需要百万级上下文。值得注意的是,JetBrains 还为 Mellum 2.1 准备了多 token 预测(MTP)头,用于 vLLM 中的推测解码(speculative decoding)。官方数据称,在单请求场景下 MTP 让速度提升约 1.6 倍。MTP 头目前标注为 coming soon,但方向很明确:把延迟压到 agent 高频调用可接受的水平。
架构之外,全部的提升都来自 post-training,而且是 RL(强化学习)主导的 post-training。JetBrains 在博客里用了个很实在的表述:RL 从"训练末尾的一个短阶段"变成了"训练的主体"。具体做了三件事。
第一,RL 任务大幅扩充,覆盖数学、竞赛编程、科学、工具调用和软件工程。数据源是开放 RL 数据集加自建任务的混合。JetBrains 对开放数据的态度很老派也很对:先过滤再训练——因为开放数据里混着大量"坏测试、无法验证的答案、对模型来说太简单或根本不可能的任务"。这句话读起来平淡,但做过 RL 训练的人都知道,数据清洗的质量直接决定 RL 的上限。
第二,自建了上千个 RL 环境,在训练过程中跑了数百万次沙盒。这是 Mellum 2.1 从"代码补全器"变成"agent worker"的关键:模型不再只是在静态文本上预测下一个 token,而是在真实环境里执行动作——探索代码库、改文件、跑测试、检查自己的改动——然后从环境反馈里学。这种"真实环境 RL"是 2026 年 agent 模型训练的标准动作,DeepSeek、Kimi 等厂商都在用,只是 JetBrains 把它用在了一个 2.5B 激活的小模型上。
第三,也是最值得玩味的一点:JetBrains 明确说他们"做了很多关于训练方法和数据的实验,保留了经得起检验的"。没有神话,没有"我们发现了一个神奇技巧",就是老老实实的实验迭代。这种表述在模型发布博客里反而显得可信——post-training 的红利本来就是靠大量对照实验一分一分抠出来的。
评测横评:强项很硬,短板也写在脸上
JetBrains 这次的评测做得相当体面:用同一套 pipeline、同样的评估设置,对比了 Mellum 2.1、Mellum 2(Thinking 版),以及两个同量级的开放模型——Qwen3.5-9B 和 Gemma 4 E4B。agentic 类评测用的是开源 agent harness(Pi v0.73.1,shell + 文件工具),114K 上下文,每轮最多 16K token,Mellum 2.1 采样温度 1.0。方法论透明到这种程度,在厂商自测里不多见。当然要提醒一句:评测是 JetBrains 自己跑的,MarkTechPost 也标注了"各厂商自家模型卡上的数字可能不同",看分数时留一分清醒。
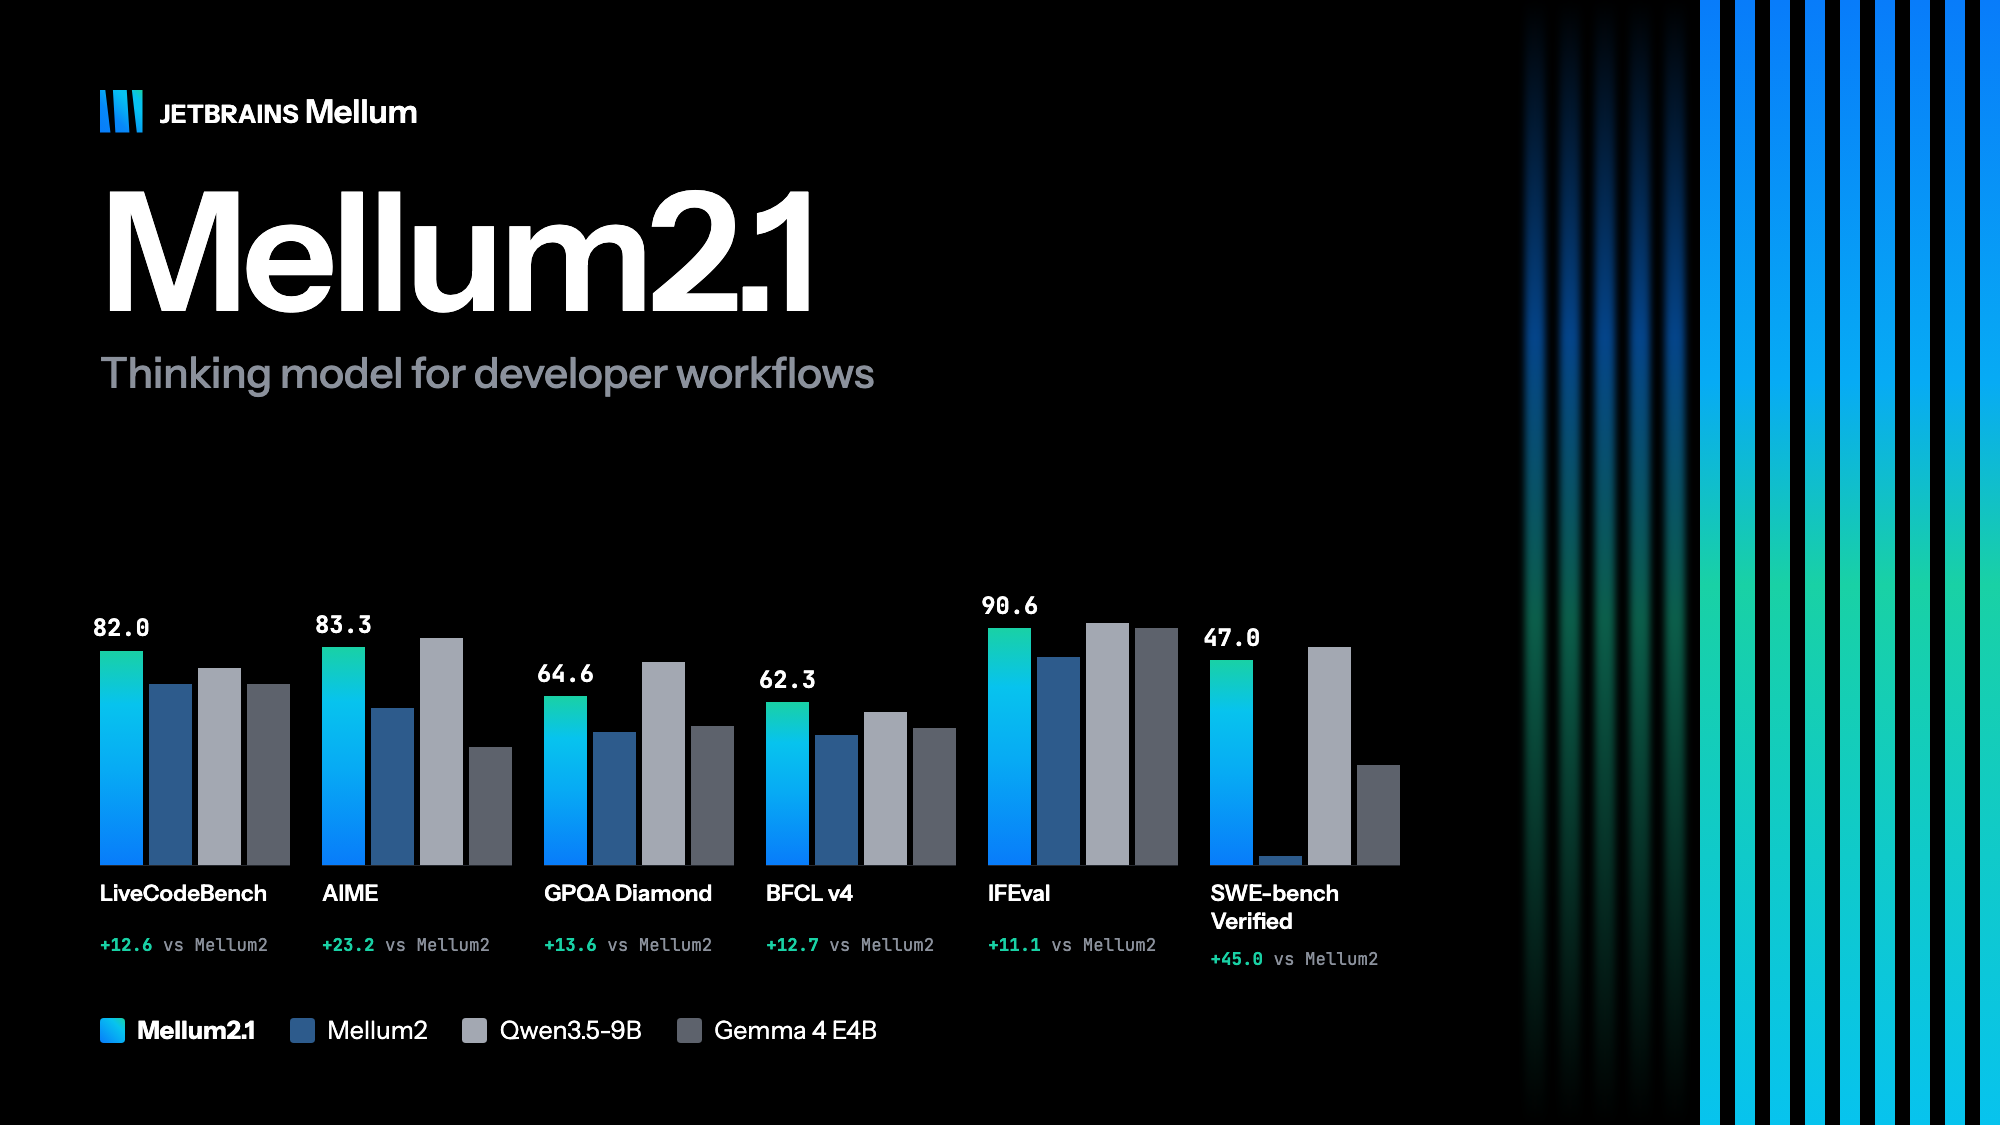
先看 agentic coding,这是 Mellum 2.1 进步最大的领域。SWE-bench Verified 从 Mellum 2 的 2.0 跃升到 47.0。这个数字要放在两个坐标系里看:纵向看,23 倍的提升证明 RL post-training 对小模型做 agent 任务是真有效;横向看,Qwen3.5-9B 在同一 pipeline 下是 50.0,Gemma 4 E4B 是 23.0。也就是说,Mellum 2.1 在 SWE-bench Verified 上基本追平了 Qwen3.5-9B,但还没超过。
再看更难的。SWE-bench Pro 上,Mellum 2.1 是 28.0,Qwen3.5-9B 是 38.0,差距拉开到 10 个点。Terminal-Bench 2.1 上,Mellum 2.1 得 17.4,Qwen3.5-9B 是 21.7——这个差距 JetBrains 在博客里没有回避,我们也不替它遮掩。Terminal-Bench 考的是在终端环境里完成真实任务的能力:装依赖、调命令、处理各种报错。一个模型 SWE-bench 能到 47 分、Terminal-Bench 只有 17 分,说明它"按既定流程修 bug"已经很熟练,但"在混乱的真实终端里自己趟出一条路"还差火候。这正是 agent worker 最需要的能力,也是 Mellum 2.1 最诚实的短板。
| 评测项 | Mellum 2.1 | Mellum 2 | Qwen3.5-9B | Gemma 4 E4B |
|---|---|---|---|---|
| SWE-bench Verified | 47.0 | 2.0 | 50.0 | 23.0 |
| SWE-bench Pro | 28.0 | 0.0 | 38.0 | 4.0 |
| Terminal-Bench 2.1 | 17.4 | 0.6 | 21.7 | 3.4 |
| LiveCodeBench v6 | 82.0 | 69.4 | 75.4 | 69.4 |
| BFCL v4(工具调用) | 62.3 | 49.6 | 58.5 | 52.5 |
| AIME 25/26(数学) | 83.3 | 60.1 | 86.7 | 45.0 |
| GPQA Diamond(科学) | 64.6 | 51.0 | 77.8 | 53.1 |
纯 coding 能力是 Mellum 2.1 最亮的招牌。LiveCodeBench v6 拿到 82.0,超过 Qwen3.5-9B 的 75.4 和 Gemma 4 E4B 的 69.4,是同组第一。HumanEval+ 91.5、MBPP+ 79.4 也都是组内领先。工具调用(BFCL v4)62.3 同样是同组最强——对 agent worker 来说,工具调用能力甚至比纯写代码更重要,因为它决定了模型能不能老老实实按 agent harness 的指令调 shell、读写文件。数学上 AIME 25/26 拿到 83.3,接近 Qwen3.5-9B 的 86.7;科学问答 GPQA Diamond 64.6 则明显落后于 Qwen 的 77.8,说明它的 RL 红利主要吃在代码和工具链上,通用科学推理不是强项。
横向解读一下这张成绩单:Mellum 2.1 是一个"偏科但偏得很有用"的模型。写代码、调工具、按流程修 bug——这些 agent 子任务里最高频的部分,它是同量级最强;但终端环境里的野路子任务、超难的长链路 agent 任务(SWE-bench Pro),它还拼不过 Qwen3.5-9B。这个画像恰好契合它的定位:它本来就不是来当全能大脑的,它是来当执行层的。
一个方法论细节:这次评测的透明度值得肯定
多说一句评测方法论,因为它关系到你该多信这些数字。JetBrains 公开了不少厂商通常藏着掖着的细节:四个模型用同一套 pipeline、同样的 agent harness(Pi v0.73.1,shell 加文件工具)、114K 上下文、每轮最多 16K token,连 Mellum 2.1 的采样温度(1.0)都写了。Mellum 2 还被"重测"了一遍——用新 pipeline 重新跑,所以它的分数和 6 月技术报告里的略有出入,官方主动说明了这一点。这种"把重测差异摆上台面"的做法,在厂商自测里很少见。
但也要看到硬币的另一面:所有数字都是 JetBrains 自己跑的,Hugging Face 模型卡上明确标注"All values are self-reported by JetBrains"。MarkTechPost 在转载对比表时也加了一句注脚:各厂商自家模型卡上的 Qwen3.5-9B、Gemma 4 E4B 数字可能不同。所以正确的读法是:把这组数字当作"同一把尺子下的相对排序"来参考,而不是绝对真理。等第三方(比如 BenchLM 这类独立评测站)用自己的 harness 复测之后,排序是否还成立,才是真正的考验。目前 BenchLM 的 SWE-bench Verified 榜单上已经出现了 Mellum2.1-12B-A2.5B-Thinking 的身影(47%),和官方自报的 47.0 对得上,是个好迹象。
速度:重负载下近两倍于 Qwen3.5-9B
速度是 Mellum 2.1 敢自称"fast sub-agent"的底气。官方数据:在一张 H200 上、重负载场景下,Mellum 2.1 的 token 吞吐接近 Qwen3.5-9B 的两倍;单请求场景,MTP 带来约 1.6 倍加速。这个差距主要来自架构:MoE 每 token 只激活 2.5B 参数,而 Qwen3.5-9B 是 9B 的稠密(dense)激活——注意 Qwen3.5-9B 的官方架构描述是混合门控 DeltaNet 加门控注意力,实际激活量远大于 2.5B。参数激活量的差距直接转化为推理 FLOPs 的差距,再转化为吞吐和成本的差距。
对 agent 系统来说,速度不只是"体验好",而是"能不能用"。一个 agent 跑一轮任务可能要调用模型几十上百次:读文件、grep、试改动、跑测试、看报错、再改动。如果每次调用都要等云端大模型排队,整个 agent 的 wall-clock 时间会被拖得很惨。一个本地部署、吞吐翻倍的小模型,能把这种高频调用的延迟压到可接受范围。这就是 JetBrains 反复强调"on your own hardware"的原因——速度和部署位置是绑定的。
定位分析:为什么"打工仔"是个好生意
Mellum 2.1 的官方用例写了三条:agent 系统里的得力 worker、通用助手、私有自托管部署。第一条是灵魂。JetBrains 的设想是:在一个 coding agent 里,Mellum 2.1 可以承担"计划的不同部分"——从定位 failing test 的根因,到起草并验证修复。翻译一下:大模型负责拆解任务、做决策,小模型负责把脏活累活干完。
这个分工思路在 2026 年已经不是新鲜事。Anthropic 的 sub-agent 机制、各种 agent 框架里的"planner-executor"模式,讲的都是同一件事:不是所有调用都值得上旗舰模型。一个资深工程师也不会亲自去跑每一遍单元测试,他会让 CI 去跑。agent 系统同理——高频、低难度、可验证的子任务(读代码、改文件、跑测试、看结果)交给便宜快速的小模型;真正需要判断力的规划、架构决策,留给云端大模型。
这套分工的经济学很直白。云端旗舰模型的 API 按 token 收费,一个复杂 agent 任务烧掉几美元很常见;本地跑一个 2.5B 激活的模型,边际成本接近零(电费和硬件折旧另算)。对个人开发者和小团队来说,这意味着"agent 自由":以前不敢让 agent 放开跑,怕账单爆炸;现在把执行层换成自托管小模型,试错成本大幅下降。JetBrains 在 6 月发布 Mellum 2 时就点过题:它要解决的是生产级 AI 的 latency、throughput、cost 三座大山。2.1 是把这句话落到了 agent 场景。
当然,分工成立的前提是小模型"堪用"。Mellum 2 刚出来时,SWE-bench Verified 只有 2.0——这种水平当 worker 只会添乱,agent 还得花更多 token 去纠正它的错误,得不偿失。2.1 把这个数字干到 47.0,意义就在这里:它第一次达到了"当打工仔不添乱"的门槛。47 分不是 90 分,它依然会在复杂任务上犯错,但在一个有验证回路的 agent 系统里(改完跑测试、测试挂了重来),这个水平的 worker 已经能产生净收益。
开源生态:Apache 2.0 + 自托管,瞄准的是合规刚需
Mellum 2.1 采用 Apache 2.0 协议发布:可商用、可修改、可再分发,不收版税。对开源模型来说,协议选择本身就是一种定位宣言——JetBrains 要的不是"研究演示",而是"拿去生产用"。对比一下:有些开放权重模型用的是限制商用的社区协议,企业法务看了直摇头;Apache 2.0 则基本是企业采购的"免检通行证"。
更关键的是"私有自托管部署"这条。JetBrains 在博客里单列了一条用例:在本地或自己的基础设施上跑 Mellum 2.1,代码和数据完全自主可控。这话是说给谁听的?金融、政府、医疗、大型企业的合规部门——这些地方的代码根本不允许出内网,云端 API 再强也进不去。过去这类客户在 AI coding 上只能干瞪眼,或者花大价钱做私有化部署。现在一个 Apache 2.0 的 12B MoE 摆在 Hugging Face 上,8.1GB 的 Q4_K_M 量化(第三方 GGUF 仓库已列出 5 个量化版本,Q4_K_M 为推荐档)就能跑,自托管的门槛被压到了"一台带 decent 显卡的工作站"级别。
发布渠道目前是 Hugging Face 已上架;GGUF(llama.cpp / Ollama / LM Studio)和 vLLM 的 MTP 推测解码头标注为 coming soon。有意思的是,MarkTechPost 报道称第三方 GGUF 仓库已经出现了 5 个量化文件,社区的手比官方还快。这通常是开源模型受欢迎的早期信号: quantization 社区愿意第一时间为它做适配,说明大家真的想把它跑起来,而不是围观。
再往深看一层,这是 JetBrains 在掌控自己的 AI 供应链。tech-insider 的评论一针见血:JetBrains 赌的是"一个小而快、开放许可的模型,能比另一个臃肿的专有模型为 coding agent 做更多事"。IDE 里每一次补全、每一次 agent 调用,如果都要租 OpenAI、Anthropic 或 Google 的智力,JetBrains 的 AI 战略就永远受制于人。从 6 月开源 Mellum 2 到 10 月的 2.1,JetBrains 在沿着"自己的模型、自己的 IDE、自己的 agent 栈"这条路走。对 JetBrains AI 的用户来说,未来 IDE 里的 agent 调用很可能默认就跑在自家模型上——成本、延迟、数据都自己说了算。
对 vibe coder 的实用价值:先算一笔本地跑 agent 的账
对我们读者——每天用 AI 写代码的 vibe coder——来说,Mellum 2.1 的价值不在"又一个开源模型",而在它可能改变你跑 agent 的成本结构。我们来算笔账。
先看硬件门槛。12B MoE 的 BF16 完整权重约 24.3GB,Q8_0 量化 12.9GB,Q4_K_M 量化 8.1GB(第三方 GGUF 仓库数据,Q4_K_M 为推荐档,top-token 匹配率 88.0%)。8.1GB 意味着什么?一张 16GB 显存的消费级显卡(如 RTX 4080 级别)在跑 Q4_K_M 量化时,权重占 8GB 出头,剩下显存要留给 KV cache——131K 上下文全开肯定不够,但 agent worker 的实际场景(几十 K 上下文)是够的。Mac 用户也别急:MLX 社区通常会在 GGUF 之后跟进,Apple Silicon 的统一内存跑 8B 量化档一直很从容。当然,官方的 Ollama / LM Studio GGUF 还在 coming soon,着急的可以先盯第三方量化仓库,稳妥派建议等官方构建。
再看使用账。假设你用 Claude Code、Pi 这类 agent 工具做日常开发,一个中等复杂度的任务(修一个 bug、加一个功能模块)烧掉几十万 token 很常见。按云端旗舰模型的价格,这就是几美元;一天跑十几个任务,一个月下来几百美元的 API 账单并不夸张。如果你把 agent 的执行层换成 endpoint 指向本地 Mellum 2.1——规划、复杂决策仍走云端大模型,高频的子任务(读文件、改代码、跑测试、验证)走本地——token 账单能砍掉一大块。硬件是一次性投入,电费是固定成本,边际调用成本趋近于零。这种"混合路由"正是 JetBrains 在 6 月 Mellum 2 发布时提到的用法:routing、sub-agents、private AI。
实操建议分三档。尝鲜档:直接去 Hugging Face 拉 JetBrains/Mellum2.1-12B-A2.5B-Thinking,用 vLLM 或 transformers 跑起来,先测它在你自己的仓库上的表现——官方评测再漂亮,不如在你自己的代码库上跑一轮 failing test 定位来得实在。等等党:等官方 GGUF 上线 Ollama/LM Studio,一条命令就能跑,这是 vibe coder 最省心的路径。生产档:如果你在给团队搭内部 coding agent,或者做合规敏感行业的项目,现在就可以基于 Apache 2.0 协议做技术预研——协议干净,自托管链路完整,这是之前很多"开放权重但协议别扭"的模型给不了的。
一个提醒:Mellum 2.1 的短板(Terminal-Bench 17.4、SWE-bench Pro 28.0)意味着,别指望它独立搞定复杂任务。把它当"执行层"用,配上"测试即真理"的验证回路——改完必须跑测试、测试挂了自动重试——它的 47 分 SWE-bench 水平才能转化为实际生产力。没有验证回路的小模型 agent,就是个自信满满的 bug 制造机,这话对任何小模型都成立。
竞争格局:Qwen 仍是擂主,但打的不是同一个擂台
一句话说清格局:在硬核 agent 任务上,Qwen3.5-9B 仍是同量级开源模型的擂主(SWE-bench Pro 38.0、Terminal-Bench 21.7 都是组内第一);但 Mellum 2.1 另开了一个擂台——速度近两倍、每 token 只激活 2.5B 参数、Apache 2.0 随便商用,打的是"便宜快速的 agent 执行层"这张牌。Gemma 4 E4B 在这次对比里更像陪跑,多项落后。真正的竞争不在"谁的 benchmark 最高",而在"谁先成为 agent 系统默认的本地 worker"——这个生态位目前还没有赢家。
结语:post-training 吃掉了架构差距
Mellum 2.1 最值得记住的不是某个分数,而是一个事实:架构完全没变,SWE-bench Verified 从 2.0 干到 47.0。这说明在 agent 能力这件事上,post-training 的权重可能比我们过去认为的大得多。一个 2.5B 激活的小模型,靠真实环境 RL 和数百万次沙盒,就能摸到 9B 级稠密模型的屁股——这对"堆参数"的信仰是一次温和的打击,对"把小模型训好"的路线是一次有力的正名。
对开源生态来说,Mellum 2.1 补上了一块关键拼图:云端有旗舰大模型当大脑,开源侧现在有了一个便宜、快速、协议干净、可自托管的"手"。agent 系统的"大脑-双手"分工,第一次在开源世界里有了像样的双手。JetBrains 的下一步很值得盯:如果它把 Mellum 系深度集成进自家 IDE 的 agent 流程,JetBrains AI 可能会成为第一个"默认跑自家开源小模型"的 IDE agent 方案——那将是 IDE 厂商从"AI 功能集成商"变成"AI 供应链玩家"的标志性一步。
而对 vibe coder 来说,判断标准可以很简单:等官方 GGUF 一上线,拉下来,在你自己的项目上跑一轮真实任务。它行不行,你的测试套件会告诉你——这比任何 benchmark 都诚实。
原始来源
相关文章

Anthropic 推出免费 opt-in 服务 OSS Scanner,用含 Claude Mythos 的最强模型定期扫描开源项目,报告完全由模型生成、不经人工审核。过去半年模型已挖出 29,000+ 候选漏洞;PostgreSQL、OpenSSL、wolfSSL、curl 均给出正面评价。本文拆解其机制、数据与争议。
Vercel 在 10 月 7 日的 changelog 里上线了 stealth 推理模型 Glyph Cluster:面向 coding 与长上下文分析,支持 function calling 与流式输出,Pro / Enterprise 且购买过 AI Gateway credits 的团队在 stealth 期间免费调用(模型名 stealth/glyph-cluster),可在 Claude Code、Codex、Cursor 里直接切换。本文拆解它的能力定位、为什么独立开发者值得花一下午实测对比、AI Gateway 统一网关的 failover 与预算控制价值,以及必须先看清的三条限制:纯文本输入、无 structured outputs、无 ZDR——prompt 与 response 可能被用于训练,商业代码先定数据边界再喂。
10 月 9 日,REA(Reverse Engineer Anything)单日新增约 1.3 万颗星,登顶 GitHub Trending dev-tools 日榜。它把反编译、反汇编与静态分析封装成 MCP server + CLI,一句 npx rea-agents setup 就能让 Claude Code、Cursor 等 12 种 coding agent 读懂没有源码的二进制。从 DX-Ball 的字节级复刻到 Notion 的剪贴板追踪,本文拆解它的方法论、能力版图,以及逆向工程绕不开的灰色地带。