Linus Torvalds:我照自己说的做了,用 LLM 把看不懂的内核代码理清楚——顺手挖出 3 个 2013 年的 bug
Linus Torvalds 在内核源码树中公开 assoc-array-fixes 工作:用 LLM 把晦涩的关联数组代码理清楚,顺手挖出 3 个自 2013 年潜伏至今的 bug。本文复盘事件全过程,并聊聊“AI 读代码”对 vibe coder 的启示。
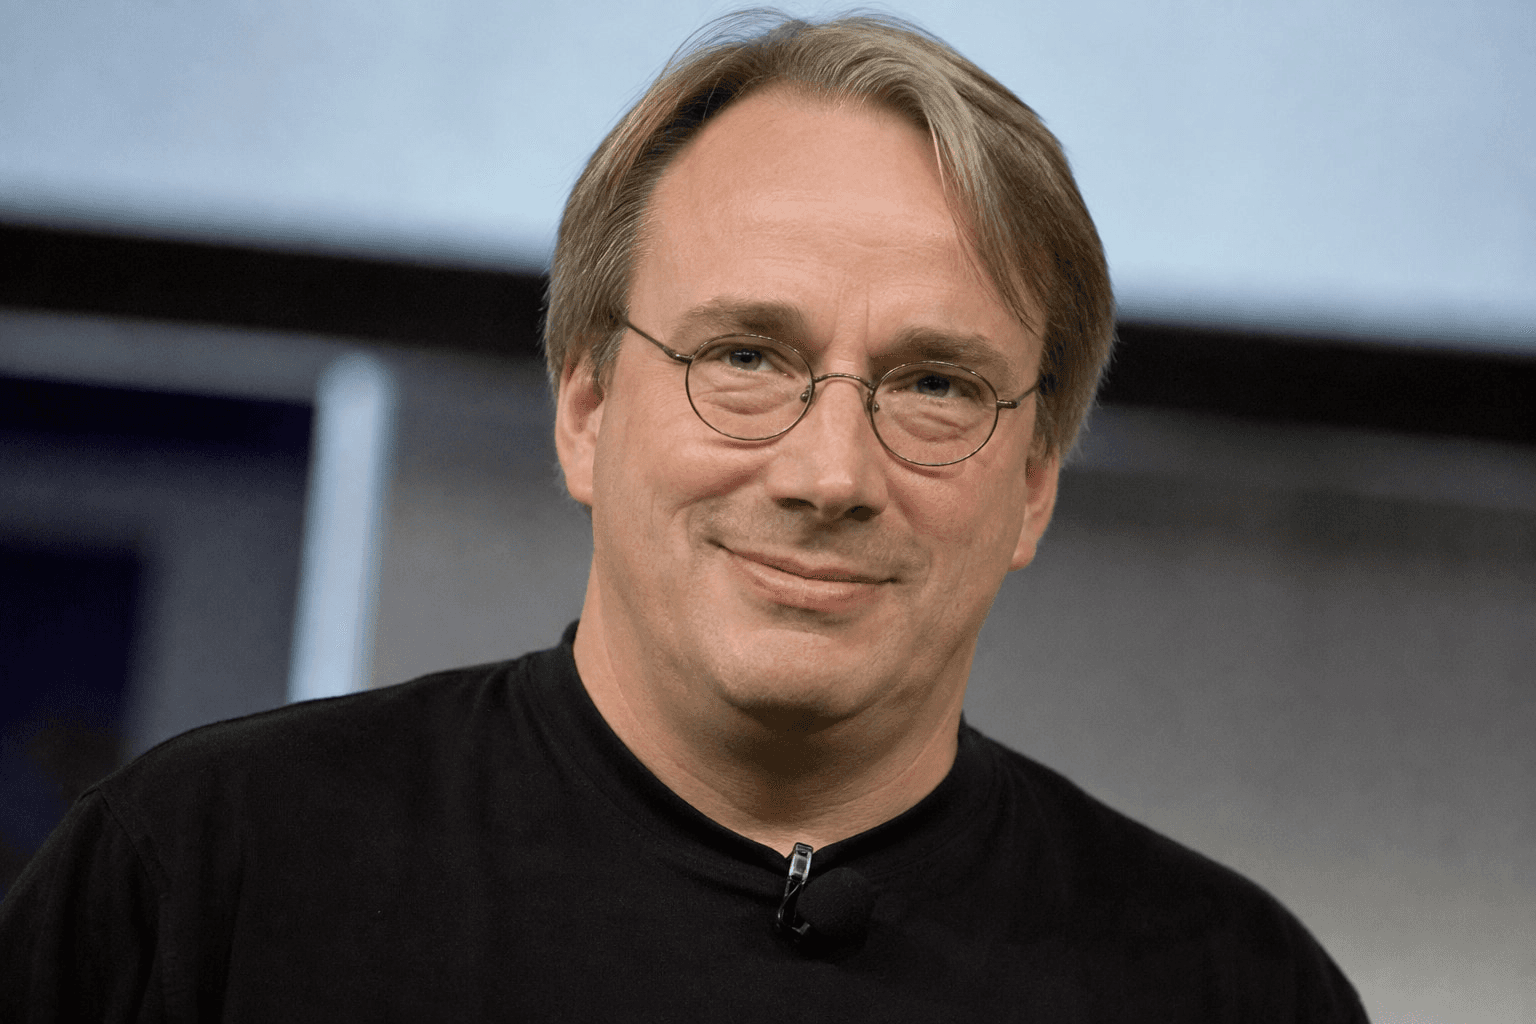
2026 年 10 月 11 日那个周末,Linus Torvalds 的 Linux 内核源码树里悄悄多了一个 Git tag:assoc-array-fixes。这不是一次普通的代码提交,而更像一次公开的方法论宣言——Torvalds 在 tag 说明里写道,自己"照自己宣讲的那样做了"(did what I preach):面对一份晦涩到看不懂的补丁,他动用了现代 LLM 工具,先把代码理清楚再谈修复。而顺手挖出的结果相当惊人:一个跑在用户态的测试 harness,不仅确认了最初报告的那个 bug,还额外抓出了 3 个新 bug——全部可以追溯到 2013 年引入这个关联数组库的第一次提交。
如果说过去一年关于 AI 编程的争论大多围绕"AI 能不能写好代码",Torvalds 这次给出的答案换了个角度:AI 真正的价值,可能在于"读代码"。把 2013 年的祖传代码理清楚可读性之后,连普通的测试程序都能抓住潜伏 13 年的 bug。这对每天和祖传代码打交道的 vibe coder 来说,是一堂来自内核之父的现场教学。
一封 Git tag 里的自述
事情的起因很具体。内核开发者 Nils Ollrogge 在 assoc_array 库(Linux 内核的关联数组实现)里报告了一个 bug,并且附上了修复补丁。但这份代码对 Torvalds 来说太晦涩了——晦涩到他无法确信自己真正理解了补丁在做什么。按照他一贯的风格,看不懂的代码是不会合入的。
这一次,他没有把补丁打回去,而是做了件他一直在公开场合宣讲的事:用 LLM 把代码理清楚。他建立了一个 LLM 辅助的分支,核心工作不是改逻辑,而是把若干又大又难读的函数拆小,让代码变得可理解。拆完之后,他把整理过的代码放进一个用户态测试 harness 里跑——结果不仅复现并确认了 Ollrogge 报告的 bug,还顺带发现了 3 个此前无人知晓的 bug,而且这 4 个 bug 的历史可以一路追溯到 2013 年这个库第一次被提交进内核。
几个关键事实需要先摆清楚,免得传成都市传说:第一,这批补丁截至报道时还没有合入主线,Torvalds 的分支和 tag 目前只是公开可见的工作状态;第二,关于"预计随 Linux 7.4 合并窗口送入"的说法,是 Phoronix 基于内核发布节奏做出的媒体预计,不是 Torvalds 本人的承诺;第三,LLM 在这次工作里扮演的角色是"阅读理解助手",真正的修复判断和合入决定权,仍然牢牢握在人类维护者手里。
这不是他第一次把 AI 带进内核
值得注意的是,这已经是 Torvalds 在短期内第二次公开谈论自己用 AI 做内核开发。就在此前的 Linux 7.3-rc7 发布周期(该版本曾被推迟),他的源码树里出现过另一个引人注目的分支:noref-filemap-read-with-llm。据报道,那一次他用了 Claude Code 来起草一份针对内核 I/O 子系统的基础性改进补丁,并且连配套的测试程序也是 AI 协助生成的。
把两次放在一起看,Torvalds 的 AI 使用路径其实很清晰:第一次是"用 AI 写补丁初稿",这一次是"用 AI 读懂补丁"。前者解决的是产出速度,后者解决的是理解门槛——而后者恰恰是大型开源项目里更稀缺、更难自动化的能力。一个补丁能不能合入,从来不取决于它能不能跑起来,而取决于维护者能不能看懂它在做什么。Torvalds 这次等于公开承认:连他自己都会遇到看不懂的代码,而 LLM 是他选择的破局工具。
观点:被低估的不是 AI 写代码,而是 AI 读代码
整个行业对 AI 编程的讨论存在一个明显的偏斜:几乎所有 benchmark 都在测"生成"——补全、写函数、修 bug 的通过率。但真实工程里最贵的一环往往是"读":读懂祖传系统、读懂别人的补丁、读懂十三年前某人随手写下的关联数组实现。读不懂,改就不敢改;不敢改,bug 就继续潜伏。
Torvalds 这次的工作恰好补上了这个缺口。他的流程值得拆开细看,因为它是一个可以复制的工作流,而不是一次运气:
 图 1:「先读懂再动手」工作流。LLM 负责把难读的代码变可读,人类负责判断与验证,测试 harness 负责把潜伏的 bug 逼出来。
注意这个流程里最有信息量的一步:暴露 bug 的并不是什么新式 AI 测试技术,而是一个普通的用户态测试 harness。也就是说,抓 bug 的工具一直都有,缺的只是"代码可读到能被有效测试"的状态。可读性上去了,十三年前的 bug 自己就会浮出水面。这颠覆了一个常见假设——很多人以为老 bug 难找是因为测试技术不够先进,真相可能是:代码难读到没人敢给它写像样的测试。
我的判断是:未来几年,AI 编程工具真正的分水岭不在"谁生成的代码更多",而在"谁帮团队读懂了更多祖传代码"。生成是加法,理解是乘法——读懂一个核心库,整个团队后续所有的修改都会变安全。
潜伏 13 年的 bug 是怎么被抓住的
把时间线拉直,这件事的戏剧性会更清楚:
 图 2:assoc_array bug 时间线。bug 在 2013 年随首次提交诞生,潜伏 13 年无人发现,直到 2026 年 10 月的可读性重构才被测试 harness 抓获。
2013 年,assoc_array 库第一次被提交进内核,bug 从那一刻起就住进了代码里。此后 13 年,内核版本从 3.x 一路走到 7.x,无数人读过、改过周边的代码,但这几个 bug 始终没人发现——不是大家不努力,而是原始代码的晦涩程度让"彻底理解"这件事的成本高到没人愿意付。2026 年 10 月的这个周末,LLM 把理解成本打了下来,harness 一跑,bug 当场现形。
这里有个值得玩味的细节:Torvalds 明确说,这是一个 LLM 辅助的可读性分支,主要改动是拆分大函数、提升可读性。也就是说,bug 的暴露几乎可以看作"可读性重构"的副产品——他并没有一开始就冲着找 bug 去。这恰恰说明,可读性本身就是一种 bug 检测机制:当代码终于能被人类(和测试)看懂时,错误就藏不住了。
给 vibe coder 的四条启示
把这件事翻译成 vibe coder 能直接用的经验,大概有四条:
1. 先读懂,再动手——把"理解"做成正式步骤
很多 vibe coding 翻车现场的共同点是:直接让 AI 改一份自己没读过的代码。Torvalds 的示范恰恰相反——他连合入一个别人写好的补丁,都要先让自己(借助 LLM)真正读懂。建议的工作顺序是:拿到祖传模块,先让 AI 解释结构、拆分大函数、梳理调用关系,你确认理解了,再谈修改。理解这一步省不得,它是所有安全修改的前提。
2. 可读性重构是最安全的 AI 任务
让 AI 拆大函数、改名、加注释,这类"不改变语义"的重构,是 AI 出错成本最低的任务类型。语义不变意味着可以用测试兜底:重构前后跑同一套测试,通过即安全。Torvalds 这次本质上就是一次可读性重构,而 bug 是重构过程中自然掉出来的"战利品"。下次面对祖传代码时,不妨先下达"只重构、不改逻辑"的指令——惊喜可能自己找上门。
3. 测试 harness 是理解的放大器
读懂之后立刻写(或跑)测试,是把"理解"变成"证据"的关键一步。Torvalds 把整理后的代码放进用户态 harness 里跑,这个动作把主观的"我觉得懂了"变成了客观的"测试证明行为符合预期"。对 vibe coder 来说,对应的习惯是:每让 AI 讲明白一个模块,就让它顺手生成一份针对该模块的测试——讲得对不对,测试一跑就知道。
4. 人类的判断力仍然是最后一道门
别忘了整个故事里最关键的角色分工:LLM 负责把代码变可读,harness 负责暴露 bug,但决定"这段代码我终于看懂了、这个修复可以合入"的人,是 Torvalds 自己。AI 降低了理解成本,但没有替代理解本身,更没有替代拍板的责任。vibe coder 最容易犯的错误恰恰是把拍板权也外包给 AI——Torvalds 用亲身示范划了条线:AI 可以帮你读,但"懂了没"只能你自己说了算。
冷静一下:这件事的边界在哪里
在为这个故事叫好之前,有几层边界值得说清楚,免得它被简化成"AI 帮 Linus 写内核"的爽文。
- 补丁尚未合入主线。截至报道时,这批修复还停留在 Torvalds 个人源码树的分支和 tag 阶段。内核的合入流程以严苛著称,可读性重构本身也可能引入争议(比如拆分是否过度),最终形态要等合入后才能下结论。
- "7.4 合并窗口"是媒体预计,不是官方路线图。Phoronix 根据内核发布节奏推测这批补丁会被送入下一个合并窗口,这是合理的推断,但 Torvalds 本人没有做过这个承诺。报道和事实之间,隔着一层"预计",引用时别把这层弄丢了。
- LLM 没有替他做核心判断。这次 AI 干的是"把难读的代码变可读",bug 的确认、修复的取舍、是否合入,全是人类工作。把它理解成"AI 读代码 + 人做判断"的协作模式,会比"AI 写内核"准确得多。
- 这不是"AI 编程瓶颈"那类方法论文。和我们之前发过的"AI 编程瓶颈""祖传代码重构"等指南相比,本篇是新闻复盘:它记录的是一次真实发生的工程实践,而不是一套放之四海的 SOP。它的价值在于"连 Torvalds 都这么干"的示范效应,而不是操作手册。
说到底,这个故事最打动人的地方,恰恰是它的"不性感":没有 AI 一夜重写内核,没有 prompt 工程黑魔法,只有一个 56 岁的程序员,面对看不懂的代码,诚实地说"我得先把它读懂",然后用上了手边最好的阅读工具,顺手把十三年前的 bug 揪了出来。
对 vibe coder 来说,结论可以收得很简单:下次让 AI 动手之前,先让它帮你读懂。读懂的那一刻,bug 可能已经在排队了。
附:这次事件在内核开发语境里的位置
如果你想自己跟进这件事的进展,路径是公开的:Torvalds 的个人源码树里的 assoc-array-fixes tag 说明写清了来龙去脉,noref-filemap-read-with-llm 分支则记录了他更早那次用 Claude Code 做的 I/O 改进尝试。两件事连起来,构成的是一个值得长期观察的信号——内核最高维护者正在把 LLM 纳入自己的日常工具箱,而且用得越来越公开。
这对开源社区的示范意义可能比技术细节更大。过去很多资深开发者对 AI 编程工具持保留态度,核心理由是"它会降低代码质量"。Torvalds 的回答很巧妙:他不是用 AI 来绕过质量门槛,而是用 AI 来抬高自己理解代码的能力上限——看不懂就不合入的原则没有变,变的是"看懂"的成本。当最挑剔的 reviewer 开始用 LLM 做阅读理解时,"AI 降低代码质量"这个论点,至少需要重新表述了。
当然,另一面的问题也值得追问:如果连 Torvalds 都需要 LLM 才能读懂某些内核代码,这是否说明内核代码本身的可读性已经出了问题?assoc_array 的晦涩是偶然还是普遍?这次事件会不会推动内核社区把"可读性"放进更正式的代码审查标准里?这些问题目前都没有答案,但它们比"AI 会不会取代程序员"有营养得多——因为它们问的是代码本身,而不是工具。
评论 (0)
原始来源
相关文章
2026 年 9 月下旬,7 个伪装成 NebulaAI 官方 SDK 的 npm 包,通过混淆过的 preinstall.cjs 安装钩子植入定制 KNTRAT Windows 木马——受害者还没运行一行包代码就已沦陷。本文基于 CloudSEK 的 NEBULA 报告复盘完整攻击链,指出"AI tooling"本身已成为钓鱼语言,并为 vibe coder 整理事件响应清单。
OpenAI 立下军令状:连续 28 天每天发版。Day 1 默认提速 50%(30→50 tok/s)、Day 4 Sol Ultrafast 8 倍速、Day 7 默认上下文 272k→500k。沿速度线、上下文线、工作流线三线拆解,看它如何重新定义 coding agent 未来半年的体验基线。
10月3日,《大西洋月刊》刊发 OpenAI 安全负责人 David Robinson 的辞职长文《我辞职了,因为 OpenAI 的文化坏了》。这位供职三年半、亲手起草 Preparedness Framework、撰写过 12 份前沿模型安全报告的内部人,把火力指向了硅谷的发布哲学本身:迭代部署在 agent 时代"注定周期性翻车"。本文梳理他列出的四起事故链、OpenAI 的回应,以及这对 vibe coder 社区的意义。