48% 的人没认出对面是 AI:Tavus Griffin 把"脸"做成了实时交互界面
Tavus 于 10 月 1 日发布 Griffin——首个"人类交互模型"(HIM),全双工 video-to-video,盲测中 48% 的参与者以为在和真人视频,而上一代系统最高只有 2%。能骗过人恰恰是它暂不全面上线的理由:这篇文章讲清技术为什么不一样、形态为什么分叉,以及 vibe coder 该怎么用它。
48% 对 2.4%:视频图灵测试第一次被通过
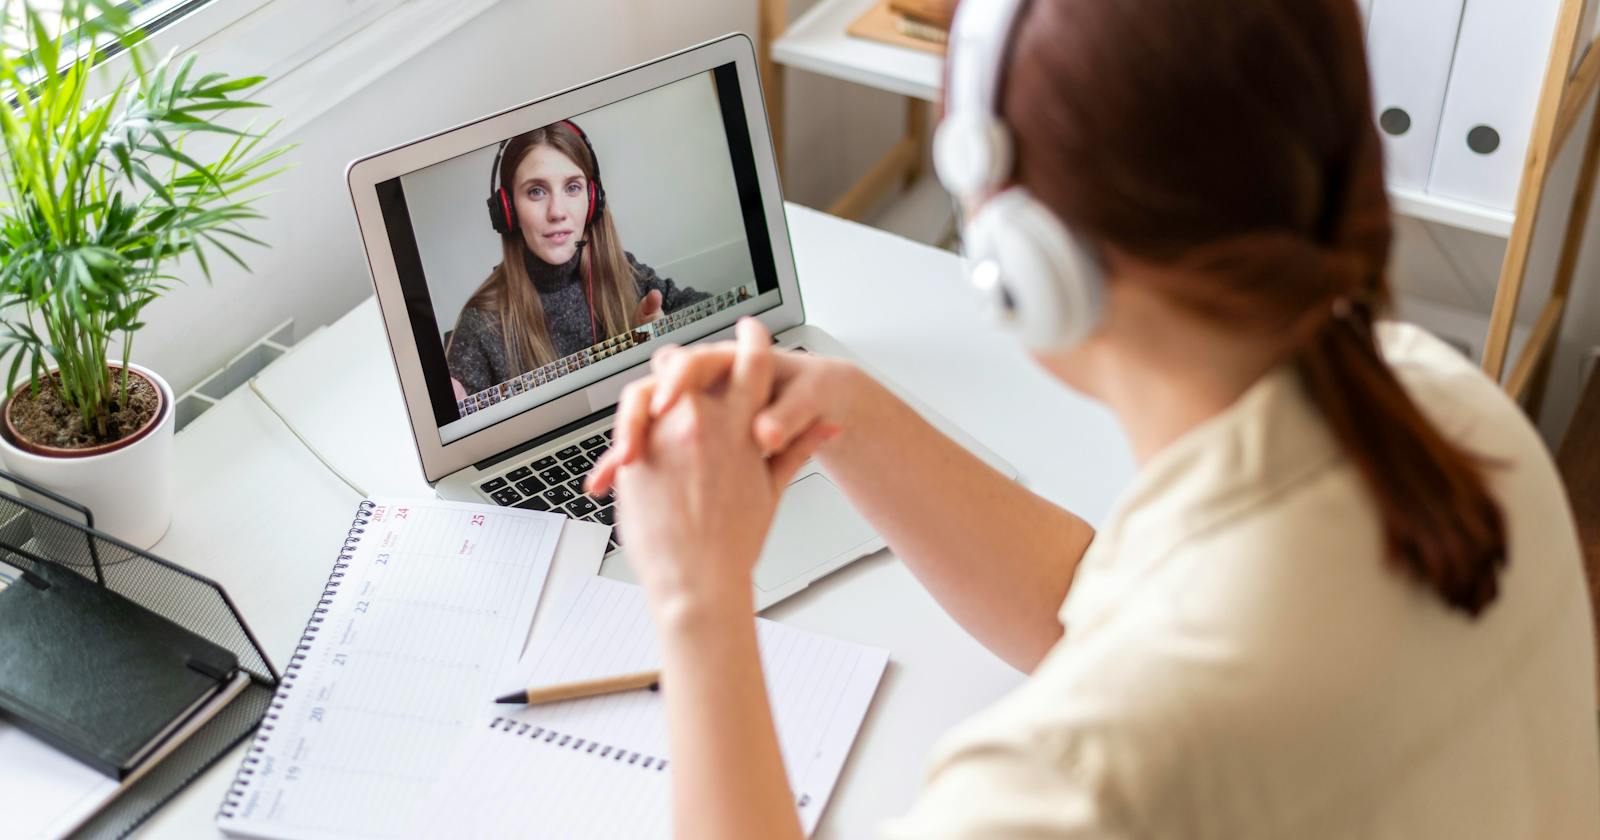
2026 年 10 月 1 日,Tavus 发布了 Griffin——它自称这是第一个「人类交互模型」(Human Interaction Model,HIM)。和市面上所有语音助手最大的区别是:Griffin 是一个全双工的 video-to-video 模型,它边听边看边说,可以被打断,会在你说话时点头、发出「mm-hm」这样的附和声,还能根据你的表情和停顿调整自己的语气和手势。官方页面的措辞很克制,但数据很不克制。
在一次盲测里,54 名参与者分别和 Griffin-Lite(Griffin 的研究预览版)进行了一分钟的视频通话,他们被告知对方是另一位参与者,话题是「今年你最期待的事」。通话结束后才被问:你觉得对方是真人吗?结果是 48% 的人回答「是真人」。作为对照,Tavus 自家上一代系统 Phoenix-4.5 的同一测试里,这个数字是 2.4%(41 人样本)。而在 Griffin 之前,所有被测过的系统——包括 Tavus 自己的旗舰管线——最高纪录只有 2%。
更值得细看的是置信度:回答「是真人」的人平均置信度 79%,回答「是 AI」的人平均置信度 81%——两边都很确信自己没看错。超过一半的人表示,通话过程中根本没闪过「对方可能不是人」的念头。7 分制评分里,Griffin 的自然度 5.4、可信度 5.6、「愿意再聊一次」5.8,即使在那些识破了它是 AI 的人里,「愿意再聊一次」依然有 5.4。这说明它赢的不只是「像不像」,而是「想不想继续聊」。
顺带一提测试方法论:参与者通过独立研究平台招募,全程不知道自己在和一个模型对话,通话结束后先被要求复述对方的回答、从多个维度打分,最后才被问「有没有一刻觉得对方可能不是真人」,问完即被告知真相。这个流程设计得相当严谨——它测的不是截图鉴别,而是实时交互中的真人感,这正是图灵测试的原始精神。
技术上它为什么不一样:亚秒级「迷你回合」对 cascade 管线是降维打击
今天几乎所有实时语音 Agent 走的都是 cascade 管线:语音识别(ASR)→ 大语言模型 → 语音合成(TTS),三段串行,等你说完了它才开始想,想完了才开始说。这种架构有个先天缺陷:它把对话切成了一个个「回合」,而人类对话根本不是回合制的——我们会抢话、会附和、会在对方停顿时用眼神示意「你继续」。
Griffin 的架构是两大部分。第一部分叫 Continuous Conversational Modeling(连续对话建模):它以亚秒为间隔持续评估对话状态,每个极小的时间片都在做决策——现在该说、该保持沉默、还是该把话语权让出去(speak / hold / yield);被打断时是继续、暂停还是停下(continue / pause / stop);要不要来一个附和或点头。第二部分叫 Audio Visual Generation(音视频生成),包含流式语音生成和流式视频生成两个引擎,把对话模型的决策实时转成声音和画面。
关键在第三句官方描述:感知、决策、生成三者全程并发。Griffin 在说话的同时也在听、也在看——你的一个皱眉、一声迟疑的「嗯……」,会实时改变它正在说的下一句话的语气。这和 cascade 管线「听完→想→说」的串行逻辑是根本不同的延迟结构:实时交互的「反应时」被重写了。
视频生成侧同样激进:Griffin 从一张参考图出发,实时生成每一帧的每一个像素——不只是脸在动,椅子会晃、影子会移、背景里的一切都在动。Tavus 明确说,上一代依赖大量 3D 先验的模型做不出大幅手势和动态背景,而 Griffin 的流式视频架构在 H100 上做到了 720p 实时生成,单块视频的生成延迟平均 0.43 秒,是次快方案的一半。语音侧则可以用约 10 秒的音频克隆一个人的声音。
第三方背书也值得一提:NVIDIA 的 VideoFDB(全双工音视频对话基准)上,Griffin-Lite 在生成和感知两个赛道都是第一名——生成得分 3.83,距离人类参考分 3.92 只差 0.09,是其他被测系统与人类差距的十二分之一;感知得分 3.73,对人类 4.20。它是唯一同时参加两个赛道并都拿第一的模型。当然要诚实地说一句:在纯延迟绝对值上,一些轻量音频模型更快(比如 MiniOmni2 的感知延迟只有 720 毫秒),但那些是纯音频系统,Griffin 背的是音视频全栈。
形态分叉:Sesame 赌声音,Tavus 直接把「脸」做成界面
把时间线拉长一点看,语音 Agent 赛道正在发生一次清晰的形态分叉。上一轮(cycle11)我们发过 Sesame:它走的是纯语音路线,用呼吸、停顿、笑声这些声音的非语言信号赢得信任,刻意不要脸。而 Tavus 走了另一极:人类沟通中非语言信息占了大头——表情、手势、眼神、时机——既然如此,干脆把「脸」本身做成实时交互界面。
这是我的第一层判断:两条路线争夺的是同一个战场——「让人忘记自己在和机器对话」。Sesame 证明声音可以做到,Tavus 证明加上脸之后,真人感可以从 2% 直接拉到 48%。但路线越往「脸」上走,伦理账单就越大:声音的欺骗是「电话那头是谁」,视频的欺骗是「屏幕那头是谁」——后者在人类心理上的分量完全不同,进化让我们对脸有本能的信任。
Tavus 的创始人把愿景说得很直白:机器应该来适应人,而不是人去适应机器;让计算变得「隐形」。这话听起来很美好,但「隐形」恰恰是把双刃剑——当计算隐形到你分不清对面是人是机时,「隐形」就变成了「不可辨别」。Griffin 把这个矛盾推到了所有人面前。
「能骗过人」恰恰是暂不 GA 的原因:这是 2026 年少见的克制式发布
注意一个细节:这次发布的只是 Griffin-Lite 研究预览版,只开放给一小批受信任的早期测试者;完整版 Griffin 要等到安全与披露机制完成后才会全面上线(GA)。Tavus 在官方页面里用了一整节讲安全、局限与责任,承认需要「进一步的对齐和安全流程」,正在开发「安全的披露功能」(safe disclosure features),并邀请 AI 安全组织参与评估测试。
这是我的第二层判断:能通过图灵测试,恰恰是不能立刻商用的理由。2026 年的 AI 发布节奏里,「先上线、再补安全」是常态,Tavus 这次反其道而行之——把刹车踩在了油门前面。这不是营销话术能解释的:一个 48% 误认率的视频对话模型一旦 API 化,冒充真人做视频面试、客服诈骗、熟人欺诈就是分钟级的事。Tavus 自己把 GA 往后推,等于公开承认了这一点。
所以 Griffin 的发布真正值得关注的不是技术参数,而是它立了一个先例:欺诈与披露伦理,是这类模型必须先交的答卷。以后任何一家做「真人感」视频 Agent 的公司,都会被问同一个问题——你的披露机制呢?Tavus 把这个问题从「要不要做」变成了「做到什么程度才敢上线」。
对 vibe coder 的实操意义:「真人感」门槛被拉低了,但先想清楚披露策略
抛开宏大叙事,说点对独立开发者真正有用的。Griffin 这类模型一旦 GA,视频客服、视频销售、陪伴应用、教学陪练(比如陪你排练一场难谈的对话,对方会像真人一样接招拆招)这类场景的「真人感」将不再是技术瓶颈。10 秒音频克隆声音、一张参考图生成整帧视频——以前需要一个团队才能做出来的 demo,API 一到,独立开发者也能拼出来。
但这是我的第三层判断,也是最重要的实操建议:「像真人」和「该像真人」是两回事,产品设计第一天就要定披露策略。要不要告诉用户对面是 AI?什么时候说、用什么方式说?是开场白里明说,还是屏幕角落常驻一个「AI」标识,还是每次用户问起才承认?这些不是上线后补的文案,而是和功能一起设计的核心机制。Tavus 自己的 safe disclosure 功能都还没做完,你的产品更不该把「以假乱真」当卖点。
一个可落地的框架:把披露做在交互里,而不是藏在用户协议第 47 页。比如开场 5 秒的自我介绍(「我是 AI 助手小 X」)、视频角落的常驻 AI 标识、用户随时可查的身份说明页。三选一也好,全做也好,关键是在用户产生「这是真人」的误判之前,披露就已经发生。等 Griffin GA 那天,平台方大概率会强制要求水印或元数据披露——提前按这个假设做架构,将来不用返工。
另外一个实操点:别只盯着「骗过人」这个指标。盲测里「愿意再聊一次」5.8 分这个数字对产品更有指导意义——用户留存的从来不是「没识破」,而是「聊得舒服」。打断处理得自然、附和给得恰到好处、沉默时懂得等待,这些交互细节才是视频 Agent 的产品护城河,也是 vibe coder 现在就可以用现有工具(比如 Tavus 现有的 Phoenix / Raven / Sparrow 管线,15 万开发者已经在用)先练手的方向。
风险视角:deepfake 与身份冒用,连厂商自己都不敢裸奔
最后说风险,而且要说得具体。Griffin 的能力组合——10 秒克隆声音、一张图生成整帧实时视频、亚秒级对话决策——恰好也是完美的冒充工具包:视频面试替考、冒充客服骗取验证码、冒充熟人进行视频诈骗。以前这类攻击需要预录视频+精心剪辑,Griffin 把它变成了实时交互,攻击者可以临场应对质疑。
Tavus 把 GA 往后推,本身就是最强的风险信号:连厂商自己都不敢让这东西裸奔。对开发者的提醒是两条:第一,等 Griffin GA 后用它做产品,风控、身份验证和滥用监测要和功能同一天上线,不能「下个版本再说」;第二,如果你的产品允许用户上传参考图/音频生成数字人,上传者的身份验证和被冒充者的授权链条必须先行——否则你的产品就是别人的作案工具。
收束一下全文的判断:Griffin 真正的意义不是「AI 终于能骗过人」,而是实时交互的延迟结构被重写了——感知、决策、生成三并发之后,「等 AI 想完再回答」的时代结束了。下一场竞争不在模型智商,而在交互的「人味」,以及与之匹配的伦理基建。Tavus 用一次克制式发布告诉我们:人味越真,基建越要先行。做 vibe coding 的人,技术红利会到,但披露策略和风控设计必须走在前面——这是 Griffin 留给所有人的作业。
原始来源
相关文章
2026 年 10 月 1 日,微软 AI 一次发布三个语音模型:MAI-Transcribe-2-Streaming(流式转写,Artificial Analysis 流式榜准确率第一,2.5% 词错率、说话结束 0.13 秒出终稿)、MAI-Voice-2.1(23 语言同音色跨语言)与 2.1-Flash(45 秒音频、端到端 150ms)。听、说两端凑齐,纯微软技术栈的语音 Agent 一轮对话可以压进 1 秒内。
OutSystems 于 10 月 7 日在拉斯维加斯 World Tour 上宣布 Agent Experience 全面可用:把低代码平台开放给 Claude Code、Cursor、Codex、Kiro 等任意 AI 编程 Agent——Agent 在设计层面工作,平台确定性地生成代码,内置安全、自动测试与生命周期治理。这是「vibe coding 进企业」的标准剧本:对抗 shadow AI,给 Agent 一条合规的路。但 74% 的返工数据是厂商调研,要打折看;真正的账,是平台锁定的隐性成本。
GitLab 在 10 月 2 日披露 CVE-2026-90970:自托管 AI Gateway 的 prompt 模板沙箱可被逃逸,有 Duo Agent Platform 权限的登录用户能借此在网关主机上执行任意命令,CVSS 9.9。这是该组件今年第二次拿到 9.9 分——2 月的 CVE-2026-1868 是同一个模板引擎、同一个 CWE-1336。两次相隔 8 个月,补的都是具体逃逸路径,没动信任边界。