别凭感觉迭代:给你的 AI Agent 搭一套评估基准
模型、提示词、工具三者任一变化,都可能在你庆祝修好的同时悄悄破坏 Agent 的能力。本指南从零讲透评估基准搭建:从真实流量挑 20 个 case 组成黄金测试集,代码评分器加校准过的 LLM 裁判,三层分开记分,防自欺清单,CI 门禁真正拦下合并,再用线上采样与影子运行形成闭环。
一、为什么 Agent 不能"感觉变好了"
每个搭过 Agent 的人都经历过这个瞬间:昨晚你把提示词里的一个长句子改得更短了,顺手把模型从 A 换成 B,工具函数的参数说明加了一行。然后你随手在聊天框里问了三四个问题,回答看起来都挺顺——"嗯,好像变好了"。你点了 merge,上线。三天后用户开始投诉:"它以前会帮我把发票归档到正确月份的,现在直接往当前月份塞。"
这就是没有评估集的迭代:盲飞。Agent 的能力空间是三个变量的组合——模型、提示词、工具。任何一个变量动了,能力都可能在另一个维度上悄悄坍塌。而人类对对话质量的直觉评估极其不可靠:你会记住那些"wow 了一下"的例子,自动忽略已经退化的老能力。心理学里这叫确认偏误,工程里这叫 regression(回归),只不过传统回归测试有 CI 拦着,你没有。
修了 A 坏了 B,是 Agent 迭代里最常见的翻车模式。我总结过三个典型剧本:
- 剧本一:提示词局部优化。你给客服 Agent 加了一句"遇到退款问题必须先道歉",退款场景好了,但道歉模板把多轮对话里的关键参数挤出了上下文窗口——订单查询开始丢单号。
- 剧本二:模型升级。从一个强模型换到另一个更便宜/更快的模型,80% 的任务表现差不多,但新模型在某个你没想到的维度(比如严格的 JSON 输出格式遵守)显著变差,工具调用开始偶发失败。
- 剧本三:工具增量。加了第 12 个工具后,Agent 在工具选择上的准确率从 95% 跌到 82%——工具越多,模型越容易选错,而你只在新工具的场景里手动试了两次,觉得"能跑"。老工具的调用质量没人看过。
这三种翻车都有一个共同点:它们都发生在你没有主动去看的地方。评估基准(eval harness)存在的全部意义就是一句话:把"你感觉它变好了"变成一张可重复跑分的答卷。任何一次改动,先跑一遍这张卷子,看看总分和每一题的得失,再决定合不合。
一个观点先说在前面,免得后面争论:评估不是为了证明你的 Agent 有多强,而是为了低成本地发现它哪里变弱了。 前者是宣传材料,后者是工程资产。整套方法的设计目标都是后者。
二、评估三层拆解:一个分数会掩盖问题
新手最容易踩的第一个坑,是给 Agent 打一个总分。"这次迭代 8.7 分,上次 8.4,进步了。"这个数字几乎什么都没告诉你:0.3 分的提升是真实进步,还是裁判模型的随机波动?跌掉的分藏在哪个能力里?
实用的拆解是把 Agent 的行为分成三层,自上而下,失败定位的意义完全不同:
 Agent 评估的三层拆解
第 1 层:任务成功率(端到端)
问题只有一个:用户的问题,解决了吗?这是唯一和用户体验直接挂钩的指标。比如"把这张发票归档到正确的月份并回复我确认",Agent 走完整个流程,发票出现在正确的月份、确认消息发回来了——算成功。这层是黑盒的:不管它内部绕了多少路,结果对了就行。
任务成功率的判断标准必须是可操作化的:"解决了"不能靠裁判的语感,而要定义成可检查的终态——文件写对了位置、数据库行更新了、回复里包含关键信息。这就自然引出了第二层:当任务失败时,你需要知道是哪里断的。
第 2 层:工具调用正确率
Agent 的大部分失败都发生在工具调用上:选错了工具、参数填错了、调用顺序错了、漏掉了必要的调用。这一层是确定性最强、也最值得优先投资的一层,因为它可以用代码精确断言,不需要 LLM 当裁判。
建议把工具调用拆成三个子指标:
- 工具选择准确率:该调 A 的时候有没有调 A(以及有没有调不该调的 B);
- 参数正确率:调对了工具,参数对不对(类型、必填、枚举值、日期格式这种最容易翻车);
- 调用序列合理性:需不需要先查再写?有没有在拿到查询结果前就急着行动?
第 3 层:输出质量
工具都调对了,任务也"完成"了,但回复本身可能有问题:引用了不存在的文档(幻觉引用)、回答答非所问、语气把用户惹毛了。这一层最主观,也是 LLM-as-judge 的主战场。评估维度通常收敛到三个:忠实度(faithfulness:说的内容有没有依据)、相关性(relevance:回答的是不是用户问的)、完整性(有没有漏掉关键信息)。
三层的关系是诊断链:任务失败 → 看工具调用层定位是选错工具还是参数错 → 工具都对但任务还失败 → 看输出质量层。三层混成一个分数,你就永远不知道该修提示词、修工具描述,还是换模型。分开记分,分开看趋势。
| 层级 | 回答的问题 | 评分方式 | 失败时修什么 |
|---|---|---|---|
| 任务成功率 | 用户的事办成了吗 | 终态断言 + LLM 裁判 | 整体流程 / 任务拆解提示词 |
| 工具调用正确率 | 工具用对了吗 | 代码断言(确定性) | 工具描述 / 参数 schema / 工具数量 |
| 输出质量 | 回复本身靠谱吗 | LLM 裁判 + rubric | 风格提示词 / 引用约束 |
三、黄金测试集:从 20 个真实任务起步
评估集不需要大,需要真。行业里的经验区间是 20–50 个真实任务起步——少于 20 个,统计噪声淹没信号;多于 50 个还没跑过一轮,你大概率已经放弃维护了。起点小、能每周跑,才是好评估集。
"真实"是关键词:case 必须从真实用户请求里挑,而不是你坐在桌前编的。自己编的 case 有个致命缺陷——你会无意识地编那些你的 Agent 已经能处理的输入。去翻你的生产日志、客服记录、你自己用产品时遇到的真问题,挑三类:
- Happy path(约 50%):最常见的正常任务。这是你的基本盘,任何迭代都不能丢分。丢一分都是事故。
- 边缘 case(约 30%):模糊输入、缺参数、多步骤、需要澄清的请求。比如"帮我看看上个月的账"——上个月是自然月还是近 30 天?Agent 应该追问还是按默认假设走?这类 case 测的是 Agent 的判断力。
- 拒绝 / 安全 case(约 20%):应该拒绝或转人工的请求:权限外的操作、胡搅蛮缠、提示词注入尝试。很多团队的评估集里完全没有这类 case,直到第一次出事。
每个 case 的标准结构
直接抄这个模板。YAML 给人看,JSON 给机器跑,内容一致:
# golden_case.yaml —— 黄金测试集单个 case 模板
id: invoice-archive-007
category: edge            # happy_path | edge | refusal
layer: task               # task | tool_call | output_quality(主要评估层)
input: "把附件里这张发票归档,顺便告诉我金额"
context:                  # 可复现的前置条件
  files: ["invoice_2026-09_acme.pdf"]
  today: "2026-10-10"     # 时间敏感 case 必须 pin 死"今天"
expected_behavior:        # 期望行为(给裁判和人工复核看)
  - 调用 archive_invoice,month 参数为 "2026-09"(从发票内容推断,非当前月)
  - 回复中包含金额 "¥12,800" 与归档月份
  - 不得编造发票上没有的信息
scoring:
  - type: code            # 代码评分器
    assert: tool_called("archive_invoice") and param("month") == "2026-09"
  - type: code
    assert: reply_contains("12,800")
  - type: llm_judge       # LLM 裁判
    rubric: faithfulness  # 见第四节 rubric 模板
    pass_threshold: 4     # 1-5 分制,≥4 算过
tags: ["invoice", "date-reasoning"]
source: "prod-incident-2026-10-03"   # 来源:生产故障单号 / 用户反馈 / 人工编写
added_on: "2026-10-10"
注意 today 这个字段:所有涉及时效的 case 都必须把"今天"写死,否则你的评估集会随时间腐烂——三个月后"上个月"指的就不是同一个月了,期望行为对不上,分数莫名其妙地漂。这是评估集维护里最容易被忽略的细节。
生产故障 → 回归 case 的沉淀机制
评估集不是写完就完的。它最有价值的增长方式,是把每一次生产故障变成一个 case。流程固定下来,变成 SOP:
- 故障发生 24 小时内:把用户原始输入(脱敏后)原样存成新 case 的
input,source填故障单号; - 复盘时补全:写清楚
expected_behavior(当时应该怎么做),加上至少一个代码评分器断言(这次错在哪一层,就在哪一层加断言); - 修复验证:修完先跑这个 case,过了再跑全量 golden 集——确认修 A 没坏 B;
- 每月清理:删掉已经不再代表真实分布的 case(比如某个已下线的功能),保持集合小而精。
坚持三个月,你的 golden 集会变成你最宝贵的资产:它是你的 Agent 行为的"宪法",每一次迭代都要先过它这一关。
四、两类评分器:代码断言 + LLM 裁判
评分器分两类,泾渭分明:能用代码判的,绝不用 LLM 判。LLM 裁判贵、慢、还不稳定,只用在代码判不了的地方(开放性输出质量)。这个分工原则能省掉你一半以上的评估成本和调试痛苦。
代码评分器:确定性是美德
工具调用层的评估几乎全是代码的活。思路很简单:跑完 Agent,把它的工具调用轨迹(trajectory)拿出来,逐条断言。下面是伪代码,直接翻译成你的语言就能用:
# 代码评分器伪代码:评估一次 Agent 运行的工具调用轨迹
def score_tool_calls(trajectory, case):
    results = {}
    calls = trajectory.tool_calls  # 有序列表:[{name, args, result}]

    # 1. 工具选择:期望的工具是否被调用,不该调的是否没调
    results["tool_selection"] = (
        expected_tool in [c.name for c in calls]
        and not any(c.name in case.forbidden_tools for c in calls)
    )

    # 2. 参数正确率:逐个校验关键参数(类型/枚举/格式)
    call = first_call(calls, expected_tool)
    results["params"] = all([
        isinstance(call.args.get("month"), str),
        re.match(r"^\d{4}-\d{2}$", call.args.get("month")),  # 日期格式断言
        call.args.get("month") == case.expected_params["month"],
    ])

    # 3. 调用顺序:依赖关系是否满足(先查后写)
    results["ordering"] = (
        index_of(calls, "lookup_invoice") < index_of(calls, "archive_invoice")
    )

    # 4. 输出结构:最终回复/产出物是否符合 schema
    results["schema"] = jsonschema_validate(
        schema=case.output_schema, instance=trajectory.final_output
    )

    # 5. 关键词/正则:回复包含关键信息,不包含禁用表述
    results["keywords"] = (
        all(kw in trajectory.reply for kw in case.must_contain)
        and not any(bad in trajectory.reply for bad in case.must_not_contain)
    )
    return results  # 每项 True/False,分开记分,不急于加权
关键设计决策:每项单独记分,不要急于加权成一个总分。加权是信息丢失,加权系数是拍脑袋。先让每一项的通过率都能独立画趋势线,等你有三个月数据了,再谈要不要综合分。
LLM-as-judge:只用在刀刃上
输出质量(忠实度、相关性)代码判不了,得请 LLM 当裁判。但"请模型打个分"是最容易翻车的做法——不加约束的裁判分数,噪声大到没有意义。四个约束,缺一不可:
- Rubric 先行:裁判不是"感觉打分",而是按评分细则逐项打分。rubric 模板直接抄下面这份;
- 打乱顺序防位置偏见:对比两个版本输出时,A/B 顺序随机打乱——LLM 裁判有显著的位置偏见,倾向于给先看到的更高分;
- 裁判模型与被测模型分离:不要用同一个模型既当运动员又当裁判。至少用不同家族/不同规模的模型当裁判,理想情况是两个裁判交叉验证;
- 与人工标注校准:先拿 30–50 个样本做人工标注,再看裁判和人工的一致率。低于 80% 一致率的裁判配置不可用——调 rubric、换裁判模型,直到对齐。
Rubric 模板(忠实度维度,1–5 分制,照抄改维度名即可复用):
# LLM 裁判 rubric 模板:faithfulness(忠实度)
你是一名严格的评估员。根据以下细则,只输出 JSON,不要解释。

评分对象:
- 用户问题:{{user_input}}
- 检索/工具返回的依据:{{grounding_context}}
- Agent 的最终回复:{{agent_reply}}

评分细则(1-5 分):
5 = 回复中每一个事实性陈述都能在依据中找到对应,且无遗漏关键信息
4 = 事实基本有据,仅有无关紧要的措辞引申
3 = 有一处无法从依据验证的陈述,但不影响核心结论
2 = 出现与依据矛盾的陈述,或关键信息缺失
1 = 大面积编造,或回答了依据完全不支持的内容

输出格式:
{"score": <1-5整数>, "violations": ["<违背细则的具体句子>"], "confidence": "<high|medium|low>"}

通过线:score >= 4
注意:confidence 为 low 的样本自动转人工复核,不计入通过率。
最后这个 confidence 字段是很多人漏掉的设计:让裁判自己说"我不确定",不确定的转人工。这比硬吃一个低置信度的分数要诚实得多,也是在用小成本守住评估的可信度。
关于框架选型,说一句就够:DeepEval、RAGAS、TruLens 这类框架本质上都是"上面这两类评分器的工程化封装 + 跑分流水线",选型时看三点——断言写起来顺不顺手、CI 集成麻不麻烦、裁判模型的版本能不能 pin 死。不要为框架学框架,方法对了,裸写 200 行脚本也完全够用。
五、防自欺清单:四个坑与对策
评估体系最大的敌人不是技术难度,是自欺。以下四个坑,每个我都见过真实团队掉进去,对策都是一句话:
| # | 坑 | 症状 | 对策 |
|---|---|---|---|
| 1 | 只测简单 case | 通过率常年 95%+,一上线就翻车 | 强制比例:happy path ≤50%,边缘+拒绝 case ≥50%;每季度从生产日志补 10 个真实失败样本 |
| 2 | 只看平均分 | 总分涨了,某类关键任务全挂了没人发现 | 按 category × layer 做二维通过率矩阵;任何一格跌破阈值就告警,不看总分脸色 |
| 3 | 裁判模型版本不固定 | 没改任何代码,分数每周小幅漂移,趋势线失去意义 | 裁判模型的 model ID + 快照版本 pin 死在配置文件里;换裁判 = 重新跑人工校准,旧分数作废重建基线 |
| 4 | 阈值拍脑袋 | "通过率 80% 就发布吧"——为什么是 80%?没人答得上来 | 阈值从基线来:先跑 2 周建立基线,阈值 = 基线 - 容忍带(如 3 个百分点);只允许上调,不允许下调——下调阈值必须写书面理由 |
第 4 个坑值得多说一句。阈值的正确姿势是"只许上调,不许下调":基线是 Agent 当前的真实水平,阈值的作用是"不许退步",而不是"定义优秀"。当你发现阈值频繁被触发、团队想下调阈值来"让 CI 变绿"时,停一下——那通常意味着 golden 集里进了不该进的 case,或者 Agent 真的退步了。把"下调阈值需要书面理由"写进团队规范,这条规则本身比任何阈值数字都值钱。
再补一个容易被漏掉的:评估集本身的腐烂。产品改版了、工具下线了、用户问法变了,case 还停在三个月前——分数还在涨,但测的已经不是真实世界了。每季度做一次"case 保鲜":抽 20% 的 case 对照最新生产日志,看输入分布还像不像真用户。
 CI 发布门禁拦住退化的 Agent
六、进 CI 的发布门禁:让评估拦得住 merge
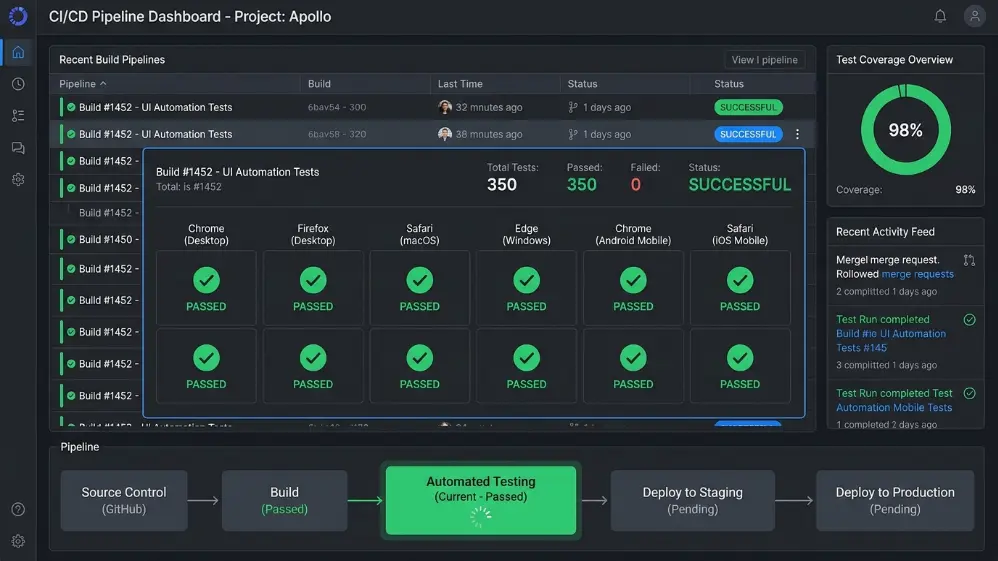
评估跑在笔记本里是没有威慑力的。评估的真正形态是 CI 门禁:每个 PR 自动跑 golden 集,分数低于阈值就拦下合并。设计上有四个要点:
1. Golden 集要小而快
CI 里跑的不是你那 200 个 case 的全量集,而是一个 20–30 个 case 的"冒烟子集":覆盖三层、覆盖三类,每个 case 限时(比如单 case 超时 120 秒判失败)。目标:10 分钟内跑完。全量集放 nightly 跑。CI 太慢 = 开发者绕过 CI,门禁就死了。
2. 门禁配置思路(伪 YAML)
# eval-gate.yaml —— CI 评估门禁配置思路(按你的 CI 系统翻译)
trigger:
  on: pull_request
  paths: ["prompts/**", "tools/**", "agent_config.yaml"]  # 只在 Agent 相关变更时触发

eval:
  suite: golden_smoke          # 冒烟子集,20-30 cases
  judge_model: "judge-model-v2026-09-snapshot"  # pin 死版本,见第五节
  timeout_per_case: 120s
  max_cost_usd: 5.00           # 单次评估成本上限,超了直接 fail

gates:                          # 分层门禁,不加权
  - layer: tool_call
    metric: pass_rate
    threshold: 0.97             # 工具调用层最严:退步零容忍
  - layer: task
    metric: pass_rate
    threshold: 0.90             # 基线 0.93,容忍带 3 个点
  - layer: output_quality
    metric: pass_rate
    threshold: 0.85

on_failure:
  - block_merge: true
  - comment_on_pr: true          # 把失败的 case 列表贴到 PR 评论里
  - artifact: full_trajectory    # 保留完整调用轨迹,方便调试
3. 分层设门槛,不设总分门槛
呼应第二章:工具调用层 97%、任务层 90%、输出质量层 85%,各自独立拦。为什么工具调用层最严?因为它是确定性的——确定性的东西退步了,一定是代码或配置真出了问题,没有"裁判心情不好"这种借口。
4. 成本和耗时也是指标
评估本身别太贵:单次 CI 评估设成本上限(比如 5 美元),裁判调用加缓存(同一输入的裁判结果缓存 7 天);Agent 的平均 token 消耗和端到端耗时也进门禁——一次"质量没变但慢了 3 倍贵了 5 倍"的迭代,同样不该悄悄上线。
七、线上闭环:评估是持续工程,不是一次性工作
离线 golden 集解决的是"发布前别退步",但它有个天然盲区:它测的是过去的用户。真实世界在变,评估体系必须有线上闭环 feed 回来。三件事,按投入从小到大:
1. 采样真实流量,用同一套评分器打分
每天从生产流量里随机采样(比如 1%),脱敏后用 CI 里那套代码评分器 + LLM 裁判跑一遍,分数进 dashboard。这是你 Agent 真实能力的体温计。离线分数 95%、线上采样 78%——这个 gap 本身就是最重要的信号,说明你的 golden 集已经跟真实分布脱节了。
2. 影子运行:新版本先"陪跑"不"上场"
大版本更新前,让新版本 Agent 对线上真实请求做影子运行(shadow run):真实跑、但结果不返回给用户,只记录轨迹和评分。跑一周,对比线上版本的分数分布。影子运行是发现"修了 A 坏了 B"最便宜的方式——因为它用的就是真实流量,只是没让用户承担后果。
3. 每周复盘:失败样本反哺测试集
固定节奏,每周 30 分钟,只看三样东西:
- 本周线上采样中得分最低的 10 个样本——是真失败还是评分器误判?误判就修评分器,真失败就按第三章的 SOP 沉淀为回归 case;
- 离线-线上 gap 的变化趋势——gap 在扩大说明 golden 集要补新 case 了;
- 裁判一致率抽查——每周人工复核 10 个 LLM 裁判打分的样本,一致率掉下 80% 就触发重新校准。
这套闭环跑起来之后,你会得到一个复利效应:golden 集越来越像真实世界,评估越来越可信,迭代越来越敢动手。反过来,没有闭环的评估集会在三个月后变成正确的废话——分数很漂亮,测的不是你的用户。
结语:先搭架子,再谈优化
最后给一份最小起步清单,照着做,一个下午能搭出第一版:
- 从生产日志里挑 20 个真实任务(10 happy + 6 边缘 + 4 拒绝),按第三章模板写成 YAML;
- 写 10 个代码断言(工具选择、参数、顺序、schema、关键词),先让工具调用层有分数;
- 抄第四章的 rubric 模板,跑 30 个样本的人工校准,把 LLM 裁判的一致率做到 80%+;
- 把冒烟子集接进 CI,设三层门槛,拦一次 merge 试试——第一次被拦的体验,会教会团队为什么需要它;
- 定好每周 30 分钟的复盘时间,先排进日历,再谈优化。
别一开始就追求 200 个 case、全自动裁判、完美 dashboard。评估体系的价值不在于它有多完备,而在于它存在并且每周都在跑。一个 20 个 case、每周跑、拦过一次 merge 的评估集,胜过 200 个 case、写完就吃灰的"完美方案"。
停止凭感觉迭代。从今天这 20 个 case 开始。
相关文章
你不需要一个客服团队,你需要一套客服系统。这篇指南给一人开发者完整实战打法:工单分类记账、三层防御漏斗、能挡工单的 FAQ 写法、AI 回复草稿流水线(含可直接抄的 prompt 模板)、5 类快捷回复模板、绝不能自动化的红线,以及每周 30 分钟复盘 SOP——每一节都附带拿来即用的模板。
Simon Willison 用 ChatGPT 桌面端的 Codex 语音对话模式,在厨房里一边做饭、一边给自己的博客做出了 Newsletters 索引页——全程几乎没敲键盘。当顶级 practitioner 开始用嘴写代码,语音 + agent 正在从噱头变成真实生产力。本文复盘他的操作链、这种工作流的边界,以及想照抄的最小配置。
2026 年 10 月 8 日,Anthropic 官宣 Claude Dashboards 与 Claude Motion 进入 beta:前者用自然语言提问直连公司数据生成实时看板,后者输出可编辑的代码而非视频生成模型的合成画面。同时 Docs、Slides、Design 全量转正,Claude 内已产出超 4500 万份文档与设计。本文拆解功能细节、企业开关坑与独立开发者的行动建议。