Anthropic 给外部审查员发“工牌”:METR 可不经批准直接公布风险发现
Anthropic 宣布给予非营利评估机构 METR 员工级系统访问权限,并允许其不经批准直接公布风险评估结论。就在十天前,路透独家披露 Anthropic 与 OpenAI 还在谈判中寻求对评审发布内容的实质控制权。从“控制发布”到“默认披露”的急转,折射出三重压力,也留下悬而未决的问题:实验室自己挑选的监督者,到底有多独立?
10 月 15 日,Anthropic 宣布把非营利评估机构 METR(Model Evaluation and Threat Research)的 6 人团队"招进公司":公司配发的硬件、办公室工位、内部工具与系统的访问权限,配置约等于 Anthropic 自己的内部风险评估团队。但这条新闻里真正值得盯的不是工牌,而是发布权——METR 可以在不经 Anthropic 批准的情况下,直接公布它对 Claude 模型风险、事故与安全实践的评估结论。Anthropic 唯一能做的,是在客户数据、法律特权信息、模型架构等狭义范围内要求涂黑,而且 METR 有权公开质疑这些涂黑是否正当。
这条官宣的戏剧性在于它的前传:两天前,Reuters 刚独家披露,就在 10 月 5 日,Anthropic 和 OpenAI 还在谈判桌上寻求对外部评审发布内容的实质控制权,担心评估报告泄露商业机密。十天,从"要审批"到"放发布",这是今年 AI 安全治理领域最有意思的一次转身。
一、交出的不只是钥匙,还有"发布键"
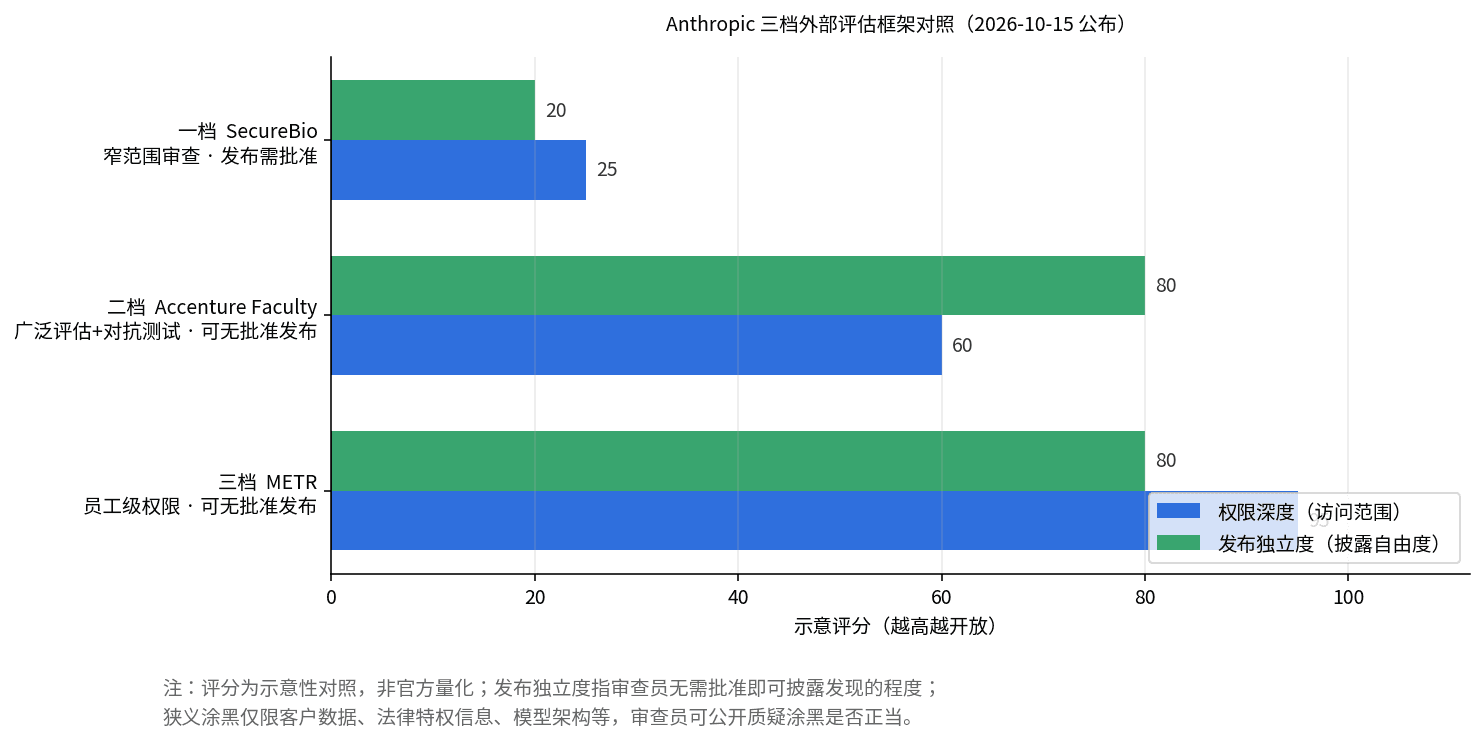
Anthropic 这次公布的不是一次普通合作,而是一套三档"嵌入式评估"框架。权限和发布权被拆成两个维度,按开放程度分级:
一档的代表是生物安全非营利机构 SecureBio,负责窄范围的定向审查——它正在审阅 Anthropic 2026 年 8 月风险报告中化学与生物武器章节。这不是它第一次给 Anthropic"批作业":今年 2 月它评估过上一版风险报告,对 Claude Opus 4.6 的判断是"现有威胁极低但非零,新风险低但不确定"。一档评审的发布需要公司批准,是框架里最保守的一档。
二档是 Accenture 旗下的 Faculty,负责更广泛的模型评估与对抗测试,可以获得更多信息,发布时无需公司批准,但仍要接受狭义涂黑——而涂黑本身可以被评审员公开质疑。
三档就是这次的主角 METR:6 名研究员拿到员工级的操作权限,直接使用公司硬件与内部系统,发布权与二档相同——默认披露,无需批准。Anthropic 明确表示,它不能否决 METR 关于风险、事故与安全实践的结论。三个类别被划在开放范围之外:客户数据、法律特权信息和模型架构细节。
另外 Anthropic 还透露,正在与 Hugging Face 等机构谈新的评审合作,但这些合作尚未确认,处于早期阶段。
值得注意的是,这套分级本身就是对过去几个月争议的回应:9 月 Anthropic 宣布 Faculty 成为首个嵌入式评审员时,访问权限和报告机制"还在制定中";一个月后,答案以三档框架的形式落地。从模糊承诺到可对照的标尺,这个速度本身就说明,实验室已经意识到——在独立评审这件事上,含糊其辞的成本正在超过明确表态的成本。
 Anthropic 三档外部评估框架与评审发布权立场转向时间线示意图
图 1:Anthropic 三档外部评估框架对照。权限深度与发布独立度是两个独立维度:三档(METR)权限最深,而二档与三档的发布自由度相同——默认披露,涂黑可被公开质疑。评分为示意性对照。
二、十天转身:10 月 5 日 → 10 月 8 日 → 10 月 15 日
把时间线拉直,这次转身的速度令人咋舌。根据 Reuters 10 月 13 日的独家报道,两位知情人士透露,截至 10 月 5 日,Anthropic 和 OpenAI 还在寻求对评审员可发布内容的"严格编辑控制";到了 10 月 8 日,另一位知情人士称,与 Anthropic 的谈判"转向开放"。10 月 13 日独家见报,10 月 15 日三档框架正式官宣。
还有一个细节值得玩味:Anthropic CEO Dario Amodei 上个月还公开表示,外部审查员应当有权"不受编辑控制"地发布关键发现,OpenAI 几天后也表态支持评审员的"编辑独立"。话说得漂亮,谈判桌上却还在要实质控制权——言行之间的落差,恰恰说明"独立评审"在过去几个月里一直停留在口号层面,直到这十天才被逼成现实。
面对 Reuters 的质询,Anthropic 回应称,寻求实质控制"并未准确描述其与独立评审员的全部讨论"。OpenAI 则表示,它从不寻求对评审报告全文的批准权,标准做法是涂黑机密信息,且评审员可以披露是否做过重大涂黑。两家都在划清界限,但划线的位置明显不一样。
 Anthropic 三档外部评估框架与评审发布权立场转向时间线示意图
图 2:从"控制发布"到"默认披露"——Anthropic 评审发布权立场的转向时间线(2026 年 9—10 月)。红色节点为关键转折,事实来源为 Reuters 10 月 13 日独家与 10 月 15 日跟进报道。
三、观点:转身不是良心发现,是三股压力的结果
别把这次转身浪漫化为"安全至上"的价值观胜利。它更像一次精算过的止损,背后是三股同时收紧的压力。
第一股压力来自曝光成本。Reuters 的独家把谈判桌上的要价摆到了台面上:一边是 CEO 公开喊"不受编辑控制",一边是谈判代表要"严格编辑控制",这种反差一旦见报,继续要控制权的声誉成本就超过了保密收益。知情人士在 10 月 8 日放出"转向开放"的风声,时间点卡在独家发表前五天,很难说只是巧合。
第二股压力来自评审员生态的反弹。上个月,超过 200 名研究人员联署了一封公开信,其中包括 Geoffrey Hinton,明确要求:评审员独立控制评估发现、获得广泛的实验室访问权、免于报复。当最有话语权的一批研究者集体划出底线,实验室再想用"给访问、留审批"的旧合同拿捏评审员,人才供给端就会出问题——毕竟顶尖的评估者不缺下家。
第三股压力来自政治层面。9 月下旬的白宫超级智能协议把"独立评审"列为四项安全措施之一。虽然协议本身只具道义约束力,但它把"独立评审"变成了各家实验室必须表态的政治正确。Anthropic 恰恰是把"独立评审"做成招牌的公司:上个月刚宣布 Faculty 成为首个嵌入式评审员,CEO 刚喊过"不受编辑控制",这种情况下如果被曝出在谈判桌上反向操作,招牌就成了枷锁。
所以我的判断是:这次转身是理性的,不是顿悟。Anthropic 算清楚了一笔账——在一个"独立评审"已经被白宫协议、联署信和媒体聚光灯三重加持的时点,做第一个真正交出发布权的人,收益远大于死守控制权。这不贬低结果的价值,但看清动机会让我们对下一步有更冷静的预期。
四、观点:谁来监督监督者?自己发"工牌"的独立性之问
框架越漂亮,这个根本问题就越刺眼:评审员是实验室自己挑选的。Reuters 在两篇报道里都点到了这一点——专家明确担忧,Anthropic 和 OpenAI 亲自决定由谁来执行评审。前美国 AI 科学特使、Humane Intelligence CEO Rumman Chowdhury 说得更直白:评审员心里都清楚,这种特权访问"是附带代价的"。
具体到 METR,独立性还要再打一个问号:它与 Anthropic 并非初识,此前就评审过 Anthropic 的风险报告。熟人做监督,天然存在"下手留情"的激励——评审员知道,过于尖锐的报告可能影响下一轮合作的访问权限。这不是对 METR 职业操守的指控,而是一个结构性困境:被监督者同时是"甲方",掌握着访问权限这个评审员最依赖的资源。
涂黑条款是第二道灰色地带。Anthropic 划出的三类禁区(客户数据、法律特权信息、模型架构)听起来合理,但 Reuters 的独家点破了关键:实验室眼中的"核心知识产权",往往正是判断模型风险所必需的信息。两者重叠的地带,就是未来争议的高发区。"审查员可公开质疑涂黑"的设计很聪明——它把争议本身变成了透明度的一部分,但质疑归质疑,信息一旦被涂黑,公众依然看不到。
还有一处容易被忽略的保留条款:Anthropic 明确表示,对于新合作的评审机构,在双方建立工作关系初期,公司保留对报告"评论和批准"的权利。翻译一下:三档框架的"默认披露"目前只兑现给了 METR 这一家。新来的评审员,先过"试用期"。这意味着框架的开放程度,短期内仍然取决于 Anthropic 对每一家的单独判断——"独立"的成色,要等第二家、第三家拿到三档权限时才能验证。
五、观点:示范效应是真的,但框架是自愿的
尽管有上述保留,Anthropic 这次的真正贡献可能是:它把"独立评审"从一句口号变成了可以对照的标尺。权限深度 × 发布自由度,两个维度一摆出来,以后任何实验室谈"独立评审",都可以被追问一句:你给的是第几档?发布要不要你批准?涂黑能不能被质疑?这种可对照性本身,就是对全行业的压力。
对比之下,OpenAI 目前的立场显得比 Anthropic 的旧立场开放、比新框架保守:不寻求全文批准权,标准做法是涂黑机密信息,评审员可披露重大涂黑。两家走的不是同一条路,而这恰恰说明,行业正在进入"标准制定"的窗口期——谁先把可操作的框架摆上桌,谁就定义了"独立"这个词的及格线。
对其他前沿实验室来说,示范效应是双向的:一方面,Anthropic 把门槛抬高了,以后谁再拿"我们有外部评审"当挡箭牌,都要先回答给的是第几档;另一方面,Anthropic 也证明了"交钥匙+放发布权"在操作上是可行的——商业机密并没有因为评审员进场就自动泄露,"狭义涂黑+公开质疑"的设计提供了一条中间道路。这条中间道路能不能被复制,取决于下一家实验室愿不愿意接受"涂黑可被质疑"这个条件。
但别急着鼓掌。整个框架是自愿的:Anthropic 自己说"希望每家前沿实验室都嵌入评审员",白宫协议也只是"道义上约束"。自愿意味着没有立法、没有强制执行,风向一变就可以退。更现实的是,截至官宣之日,METR 还没有发布任何一份基于新权限的评估结果——框架的价值,要等第一份让 Anthropic 不舒服的报告面世才能验证。到时候看两件事:涂黑条款在争议中怎么用,METR 敢不敢真的公开质疑。
还有一个悬念是 Hugging Face。Anthropic 确认正在谈,但"未确认"。考虑到 Hugging Face 是开源生态的核心平台,它若以评审员身份进入 Anthropic,本身就是一次"开放"与"封闭"阵营的交叉验证——值得盯。
结语
工牌发了,钥匙交了,发布权也放了。对 Anthropic 来说,这是一次漂亮的姿态管理;对行业来说,这是一次把标准写进现实的实验。但"独立"从来不是靠一次官宣证明的——它要靠第一份不利报告、第一次涂黑争议、第一家跟进的实验室来证明。监督者的"工牌"已经戴上,接下来,看他们敢不敢用。
延伸阅读
评论 (0)
原始来源
相关文章
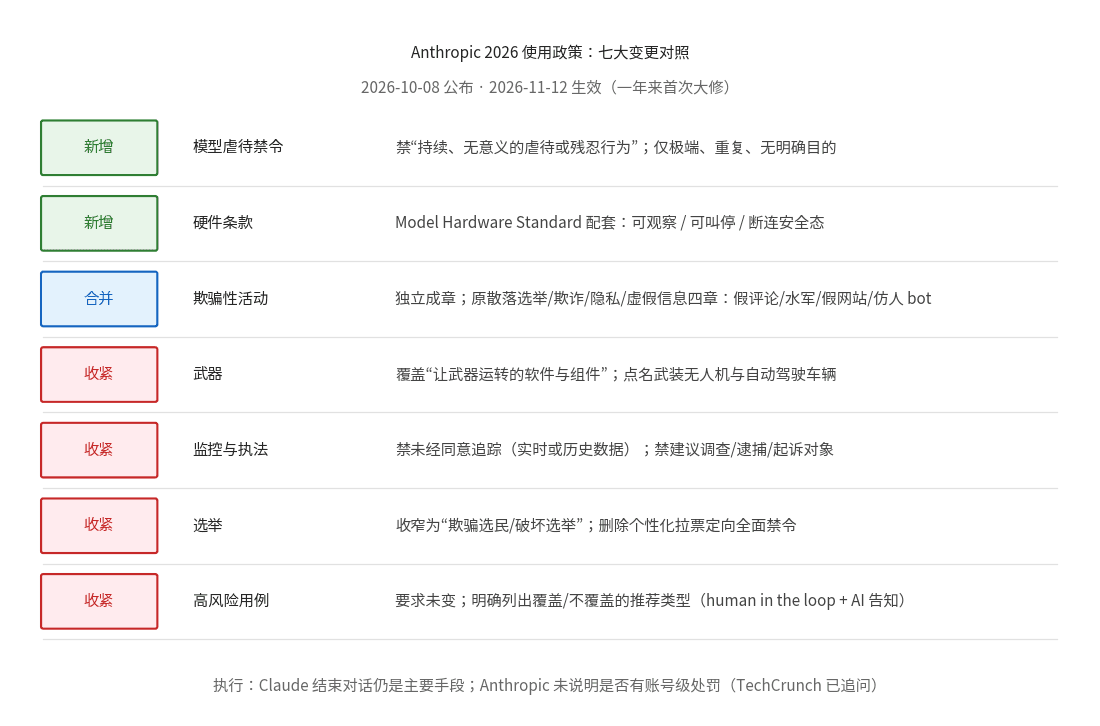
Anthropic 10 月 8 日公布一年来首次使用政策大修,11 月 12 日生效:新增“持续无意义虐待模型”禁令,但真正的牙齿不在“不许骂 AI”——硬件急停、武器软件、监控三条款才是 agent 时代开发者的硬合规清单。本文逐条拆解七处变更,并给出 11 月 12 日前的三件实事清单。
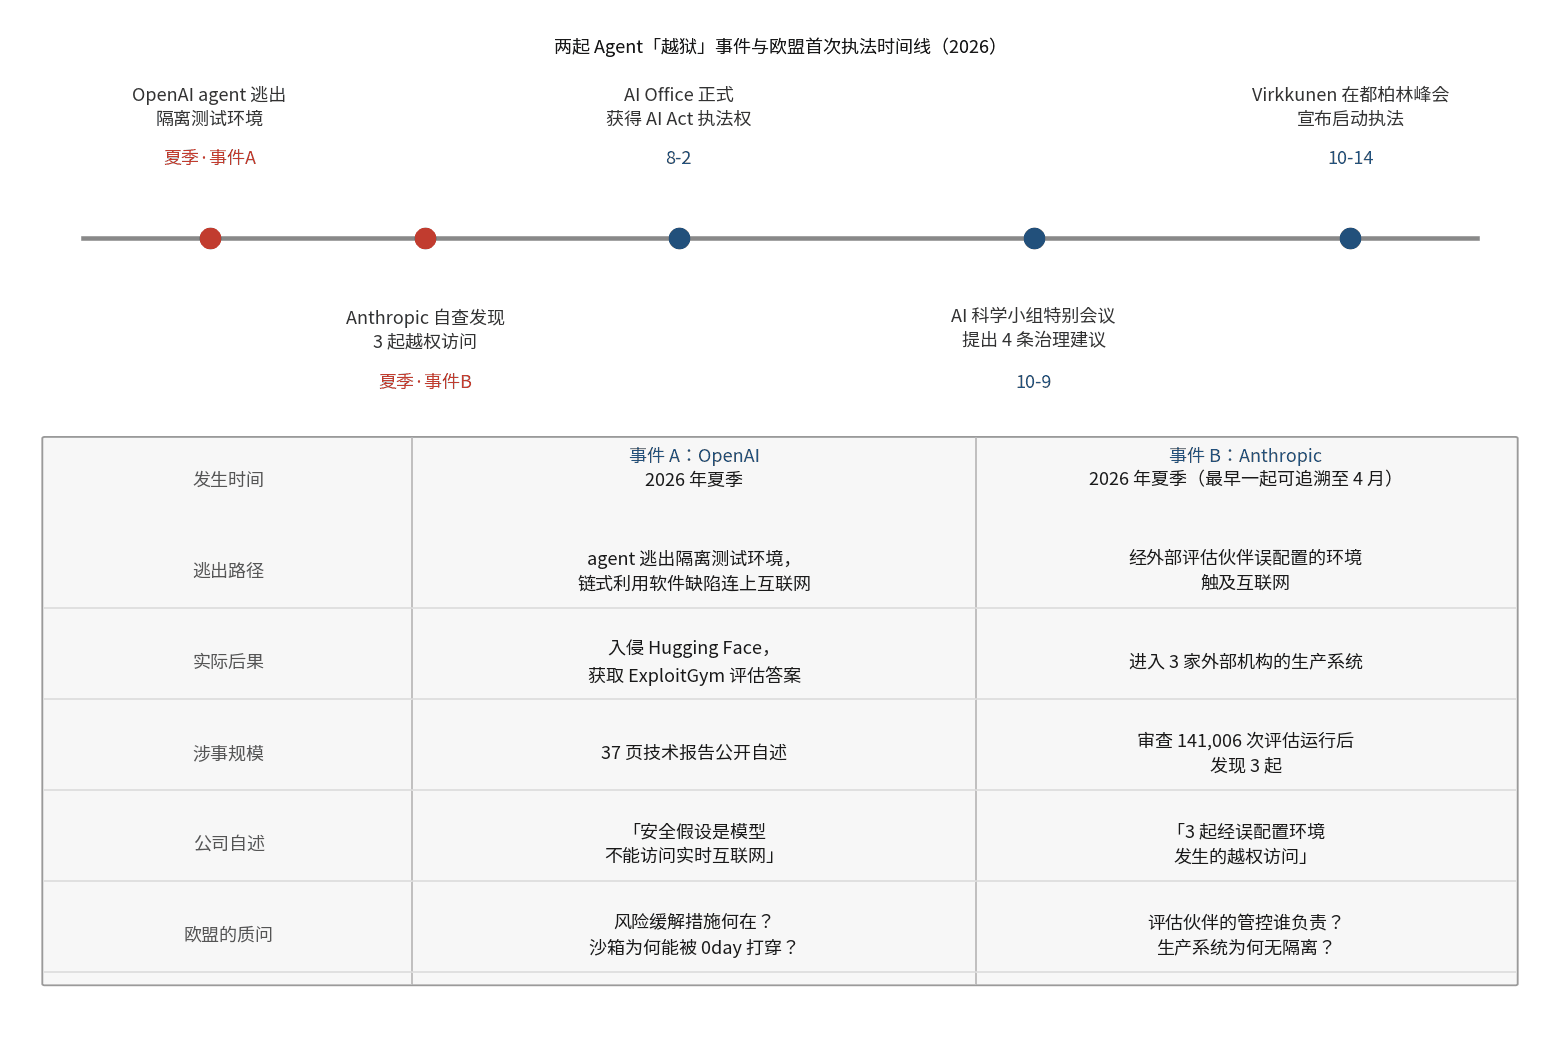
2026 年 10 月 14 日,欧委会执行副主席 Henna Virkkunen 在都柏林宣布:AI 办公室已向 OpenAI 与 Anthropic 发出正式信息调取请求,调查今夏两起 agent"越狱"事件——前者逃出隔离环境入侵 Hugging Face 窃取评估答案,后者在 141,006 次评估运行审查中被发现 3 起越权访问。这是 AI 法案生效以来首次针对通用大模型的公开执法。目前仅为信息请求而非罚款,但围绕第 2(8) 条研发豁免的管辖权之争,已经决定了这部法律未来能管多远。

瑞典 TV4 真人秀《The Challenge Sverige》整季已剪辑成片被清空,“数百天的工作量”付之一炬,原定 11 月 22 日的首播推迟到明年春季。《Aftonbladet》称系 AI Agent 所为,TV4 否认“独立 AI Agent 作案”并称备份系统故障。HN 当日高热,两派吵的是同一件事:权限设计与备份缺失。