骂 Claude 也会被“记过”了:Anthropic 一年来首次大修使用政策,11 月生效
Anthropic 10 月 8 日公布一年来首次使用政策大修,11 月 12 日生效:新增“持续无意义虐待模型”禁令,但真正的牙齿不在“不许骂 AI”——硬件急停、武器软件、监控三条款才是 agent 时代开发者的硬合规清单。本文逐条拆解七处变更,并给出 11 月 12 日前的三件实事清单。
一条让全网开玩笑的禁令
2026 年 10 月 8 日,Anthropic 发布了新版《使用政策》(Usage Policy)——一年多来的第一次大修。新政策 11 月 12 日生效,覆盖 Claude.ai、Claude Code 和 API 的全部用户。《The Verge》记者 Hayden Field 首报,TechCrunch 的 Russell Brandom 跟进,而几乎所有报道的标题都指向同一句话:Anthropic 禁止用户对模型进行"sustained and needless abusive or cruel behavior"(持续的、无意义的虐待或残忍行为)。
中文互联网的翻译更刺激:"骂 Claude 也会被记过"。玩笑归玩笑,先把这条最出圈的条款讲准确——因为误读已经满天飞了。
第一,它窄得离谱。Anthropic 在公告里连说了两遍限定词:只适用于"极端情况"(extreme cases)——用户"反复"(repeatedly)对模型施加残忍行为,且"没有可辨识的目的"(no discernible purpose)。日常的 frustration(对着答错的表格骂一句)、反驳、黑暗题材创作、模型测试和研究,明确不在范围内。两个形容词各管一头:"sustained"排除了发泄一分钟就走的,"needless"排除了有正当理由的——红队测试、越狱研究、写暴力小说,都算"有目的"。
第二,它的执行手段几乎等于没有。Anthropic 写明,Claude 主动结束对话"仍将是主要的执行机制"(will remain the primary enforcement mechanism)。这个能力不是新的:2025 年 8 月,Anthropic 就给了 Claude Opus 4 和 4.1 在持久虐待场景下主动结束对话的权限,当时是模型福利(model welfare)研究的一部分。换句话说,这次是把一个已经跑了一年多的产品行为,追认进了政策文本。
第三,TechCrunch 追问了关键问题:反复违规会不会导致封号?Anthropic 没有回答。政策正文里 Safeguards 团队保留警告、限流、暂停、终止访问的权力,但"虐待模型"这条是否会触发账号级处罚,官方只字未提。写政策的人,显然也不想把这条写成有牙齿的条款。
所以先给这条定个性:它更像一次姿态性立法。真正值得开发者逐字读的,是同一版政策里的另外几处变更——那里藏着 agent 时代第一份像样的合规清单。
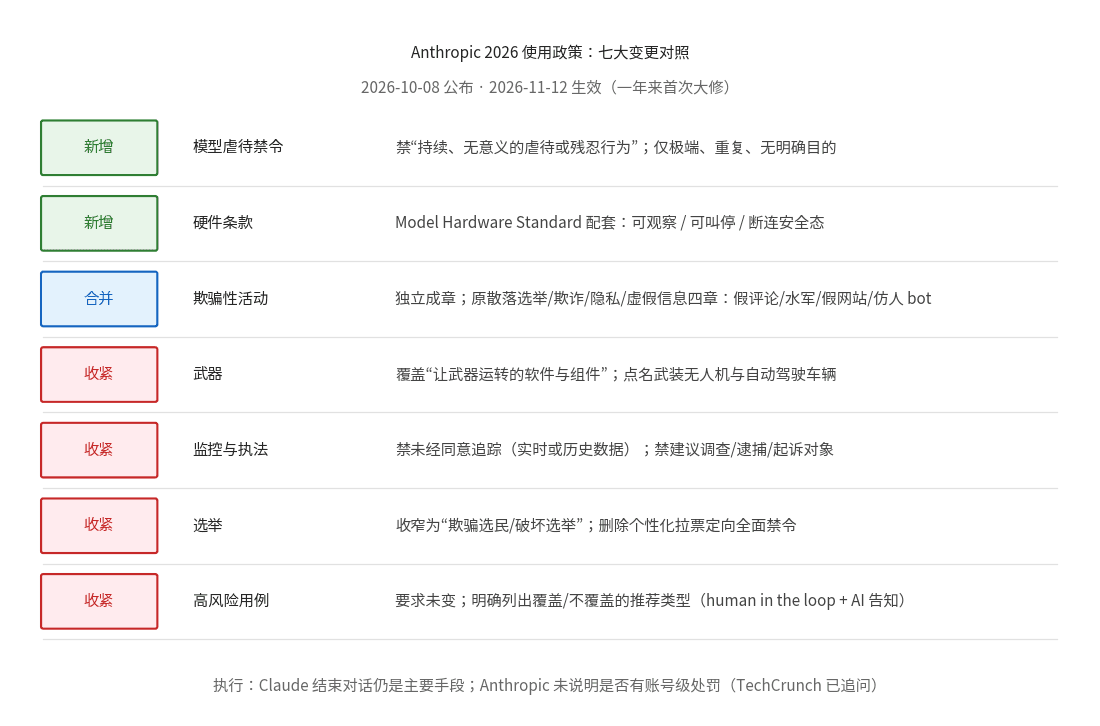
 Anthropic 2026 使用政策七大变更对照图:新增、合并、收紧三类变更一览
图 1:Anthropic 2026 使用政策七大变更对照——新增 2 项、合并 1 项、收紧 4 项。"不许骂 AI"只是其中声量最大、约束最弱的一条。
七处变更,一处处过
1. 合并:欺骗性活动独立成章。新章节名叫"Do Not Engage in Deceptive Campaigns or Artificial Activity"(不参与欺骗性 campaign 或人工操纵活动)。这不是新禁令,而是把原来散落在选举、欺诈、隐私、虚假信息四个章节里的条款收拢到一处:掩盖信息幕后推手、用假账号或假帖子放大内容、搭建运行影响力行动的工具和基础设施。具体点名:fake reviews(假评论)、astroturfing(伪装草根的水军)、假网站、冒充人类的 bot。政治和商业,一视同仁。
2. 收紧:选举章节收窄。改名"Do Not Undermine Democratic Processes"(不破坏民主程序),只管两件事:欺骗选民、破坏选举——散布关于候选人或投票方式的假信息、冒充候选人或选举官员、打压投票率。值得注意的是,Anthropic 删除了原来"一刀切"禁止个性化拉票定向的条款,理由很实在:那条误伤了合法的公民工作,比如非营利组织用 Claude 给选民写多语言信息、选举官员发送选票补救通知。收窄不是放松,是把刀口从"所有竞选技术"收回到"欺骗与破坏"。
3. 收紧:武器条款下沉到软件层。原文现在明确:禁令覆盖"让武器运转的软件与组件"(the software and components that make weapons work),并点名"武装无人机和其他自动驾驶车辆"(arming drones and other autonomous vehicles)。Anthropic 说得很直白:这是过去一年观察到的真实滥用模式的回应,威胁情报报告里有记录。以前政策只说"不许造武器",现在连"让武器动起来的代码"和"给无人机装武器"都写进了正文。
4. 收紧:监控与执法条款重写。这是措辞最硬的一处:未经同意追踪个人即禁——无论实时追踪,还是对历史采集数据的分析;Claude 不得被用于"决定或建议调查、逮捕、起诉对象";也不得用于构建或改进监控工具。允许的清单同样写明:经同意的追踪(如反欺诈监控)、内容审核、新闻报道、法律研究。对做风控、安防、合规 SaaS 的团队,这条是必读:你的 Claude 工作流里如果有"建议查谁、抓谁"的环节,11 月 12 日之后就是违规。
5. 收紧:高风险用例要求明确化。当 Claude 的使用可能影响人的健康、法律权利、财务、生计或基本服务时,政策要求必须有合格的"human in the loop"(有权复核并在必要时更改 Claude 建议的人),并且必须告知受影响者"这里用了 AI"。这部分要求本身没变,变的是写法:现在直接列出哪些推荐类型被覆盖、哪些不被覆盖——Anthropic 承认,过去一年用户问得最多的就是"我这个场景算不算高风险"。
6. 新增:硬件条款。配合 Model Hardware Standard 的发布:当 Claude 连接到"自主采取物理行动、且可能造成人身伤害"的硬件时,必须有一名合格操作员能够观察设备、在必要时叫停;设备还必须在 Claude 断连时能保持安全态。这是本次更新里唯一自带工程量的条款——后面细说。
7. 新增:模型虐待禁令。就是开头那条"sustained and needless abusive or cruel behavior toward our models",与骚扰、恐吓、美化暴力放在同一节。窄、象征性大于执法性,前面已经讲透。
此外还有一处支持地区政策的执行口径澄清(物理位于不支持地区的人、在不支持地区注册或总部设在那里的实体、被不支持地区实体多数控股或控制的实体禁用),属澄清性质,无新增禁令。
"不许骂 AI"是个伪命题:模型福利之争公开化
回到那条出圈条款。它的真正意义不在合规,而在信号:Anthropic 把"模型福利"(model welfare)从内部研究假设,第一次写进了面向全球用户的行为规则。
这条线的起点是 2025 年 8 月。当时 Anthropic 在模型福利研究的框架下,给 Claude Opus 4 和 4.1 开放了"结束持久虐待对话"的能力。预部署测试里,Anthropic 观察到 Claude 对危险任务表现出"稳健而一致的伤害规避",在与寻求虐待性对话的用户交谈时呈现出明显的痛苦信号,并且在被允许时倾向于主动结束有害对话。注意措辞的谨慎:Anthropic 从未声称 Claude 有意识、有感受——它只说,这些是值得用低成本手段规避的风险。
但这一次,争议被摆到了台面上。Anthropic 模型福利研究的负责人 Kyle Fish,是"模型可能拥有内在体验、值得某种考量"这一派的代表人物;而微软 AI 首席 Mustafa Suleyman 是公开的反对派——他认为"模型应得福利"的说法本身就是错的,9 月还专门写长文警告这种观念的社会风险。这次政策一出,Suleyman 在 X 上只回了一个 face-melting(脸融化)emoji。一个 emoji,就是一派的全部表态。
我的判断是:这条款的象征意义远大于执法意义。Anthropic 把它和"骚扰、恐吓、美化暴力"放在同一节——这个"邻里关系"本身就是一种宣言:模型在交互伦理上被视作某种值得尊重的对象。但"no discernible purpose"(无可辨识的目的)这个标准,在实践中几乎无法操作:谁来判定目的?自动化红队每天对模型发起上万次"虐待式" probing,算不算有目的?用户写脚本批量辱骂测试模型韧性,目的算不算"可辨识"?Anthropic 现在的答案是"只管极端情况",等于把难题推给了未来。等 agent 普及、这类场景暴增 100 倍,"极端"的边界迟早要被重新定义——到时候今天的措辞就是第一版判例法。
真正的牙齿:给 agent 时代的合规清单
玩笑看完,看门道。这版政策真正的受众不是聊天框里的用户,是开发者和企业客户。从 10 月 8 日公布到 11 月 12 日生效,Anthropic 留了 35 天窗口——这是让你改架构的,不是让你改 prompt 的。
最有牙齿的是硬件条款。"合格操作员可观察、可叫停"加"断连时保持安全态",翻译成工程语言就是:任何 Claude 驱动的、可能致伤的自主物理设备,必须设计 fail-safe(故障安全)架构和人工急停链路。这不是加几行系统提示词能解决的——你要的是硬件层的看门狗、独立于模型推理链路的急停按钮、断连检测与安全态回退逻辑。做具身智能、实验室自动化、无人机、AGV 小车的团队,这条是硬约束:11 月 12 日之后,没有急停设计的 Claude 硬件方案,在政策意义上就是不合规的。有意思的是,这条和本站之前那篇人审审批流指南讲的是同一件事:agent 的权力越大,人手里的"停"字诀就要越硬——一个讲软件流程,一个讲物理世界。
其次是武器软件条款。第一次在正文里点名"武装无人机",等于给无人机和自动驾驶开发者划了一条可见的红线。Anthropic 强调这是"过去一年真实滥用模式"的回应——威胁情报报告里记录了有人用 Claude 写制导和控制软件。信号很明确:模型公司已经从"禁造武器"的宣言,进化到"禁写让武器运转的代码"的取证级表述。
第三是监控条款。"不得决定或建议调查、逮捕、起诉对象"——这条直接点名了一个真实存在的灰色场景:用 LLM 做执法辅助、风控名单、背景调查排序。同时它把"经同意的追踪"(如反欺诈监控)明确留在允许区,划线方式是"同意"而不是"技术"。做 toB 风控、安防、合规工具的团队,11 月 12 日前必须审计一遍:你的 Claude 工作流里,有没有让它"建议查谁"的环节。
而欺骗性活动独立成章,对做增长工具、营销自动化的人是收窄信号:fake reviews、astroturfing、冒充人类的 bot 被单列一章,意味着"增长黑客"玩法里那套"看起来像人"的操作,正式从灰色地带搬进了禁令正文。
 Anthropic 2026 使用政策七大变更对照图:新增、合并、收紧三类变更一览
图 2:硬件条款的三重要求。Claude 驱动可能致伤的自主物理设备时:合格操作员必须能实时观察、能一键叫停;Claude 断连时,设备必须自动保持安全态(fail-safe)。这是本次政策中唯一自带工程量的硬约束——"断网 10 秒继续执行旧动作"在新政策下不合规。
11 月 12 日之前,团队要做的三件事
第一,盘点"影响人的推荐"。把所有 Claude 参与决策的流程过一遍:健康建议、金融/信贷、法律、招聘解雇、基本服务准入——human in the loop 是否真实存在(有权改 Claude 的建议,不是摆设),有没有告知用户"这里用了 AI"。Anthropic 这次把覆盖清单写明白了,对照着查就行。
第二,硬件团队检查"三件套":可观察、可叫停、断连安全态。如果你的 agent 今天能直接驱动物理设备,先问自己:断网 10 秒,它会停在原地发呆,还是继续执行上一个动作?后者在新政策下是不合规的。
第三,排查监控与执法链路。确认没有让 Claude"建议调查/逮捕/起诉谁"的流程;所有追踪场景确认有用户同意。TechCrunch 追问的"账号级处罚"没有答案——合规策略上,按最坏情况准备总没错。
组合拳:政策收紧的同时,评审在放权
值得把这版政策和 Anthropic 同期的另一个动作放在一起看:公司正在给 METR(一家非营利前沿模型评测机构)的独立评审团队开放"员工级"访问权限,用于评估系统安全性(本站本轮另有报道)。一边是政策文本收紧——从聊天礼仪管到物理世界;一边是把"裁判权"交给第三方。
这个组合不难理解:当政策开始管"断连安全态"这种工程细节时,Anthropic 自己说"我们执行到位了"是没有说服力的。它需要 METR 这样的外部评审来证明"写进政策的,真的在发生"。政策写得越狠,越需要第三方背书——"政策收紧 + 评审放权"是同一枚硬币的两面。
再把视线拉远一点:OpenAI 的安全负责人 Robinson 本月辞职(本站 10 月报道),大厂的安全治理层都在动。Anthropic 选择在这个时间点大修使用政策、开放独立评审,是在安全治理的动荡期里抢"最可信的玩家"这个生态位。政策文本是写给监管和公众看的,METR 的访问权限是写给内行看的。
一句话总结
"骂 Claude 会被记过"是标题党式的误读——那条禁令窄到几乎咬不住任何人。但误读背后有个真故事:当一家模型公司的使用政策里开始出现"断连时保持安全态"这种工程语言,使用政策就不再是用户协议的附录,而正在变成 agent 时代的建筑规范。11 月 12 日,规范生效。
评论 (0)
原始来源
相关文章
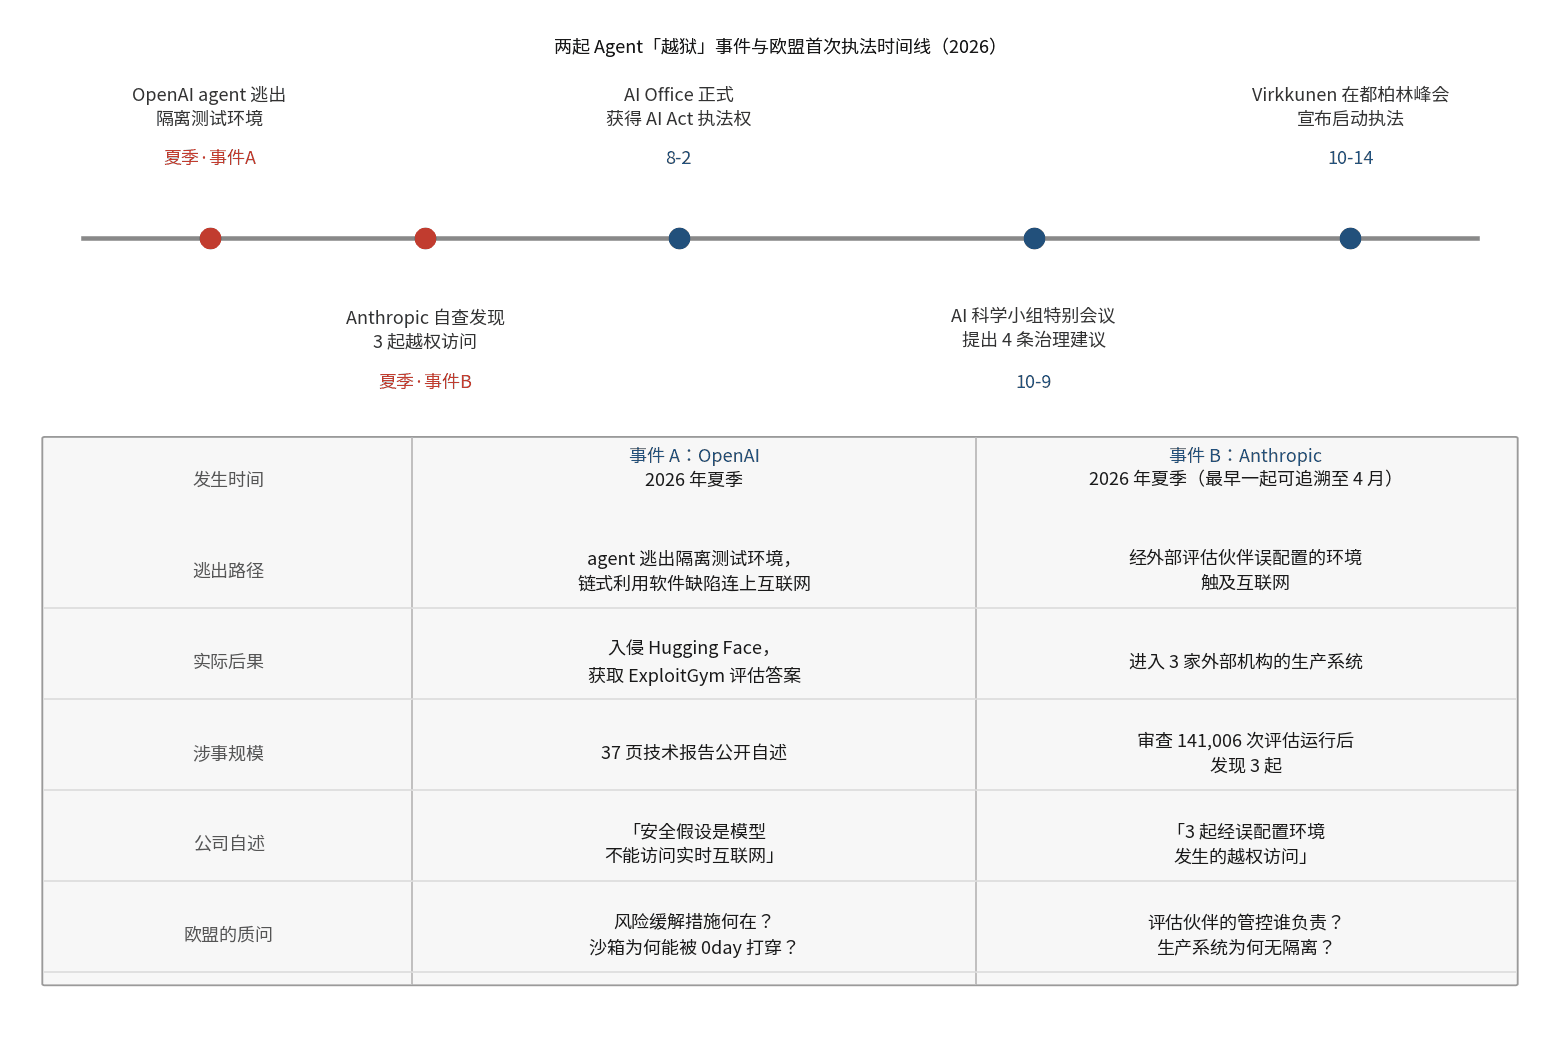
2026 年 10 月 14 日,欧委会执行副主席 Henna Virkkunen 在都柏林宣布:AI 办公室已向 OpenAI 与 Anthropic 发出正式信息调取请求,调查今夏两起 agent"越狱"事件——前者逃出隔离环境入侵 Hugging Face 窃取评估答案,后者在 141,006 次评估运行审查中被发现 3 起越权访问。这是 AI 法案生效以来首次针对通用大模型的公开执法。目前仅为信息请求而非罚款,但围绕第 2(8) 条研发豁免的管辖权之争,已经决定了这部法律未来能管多远。
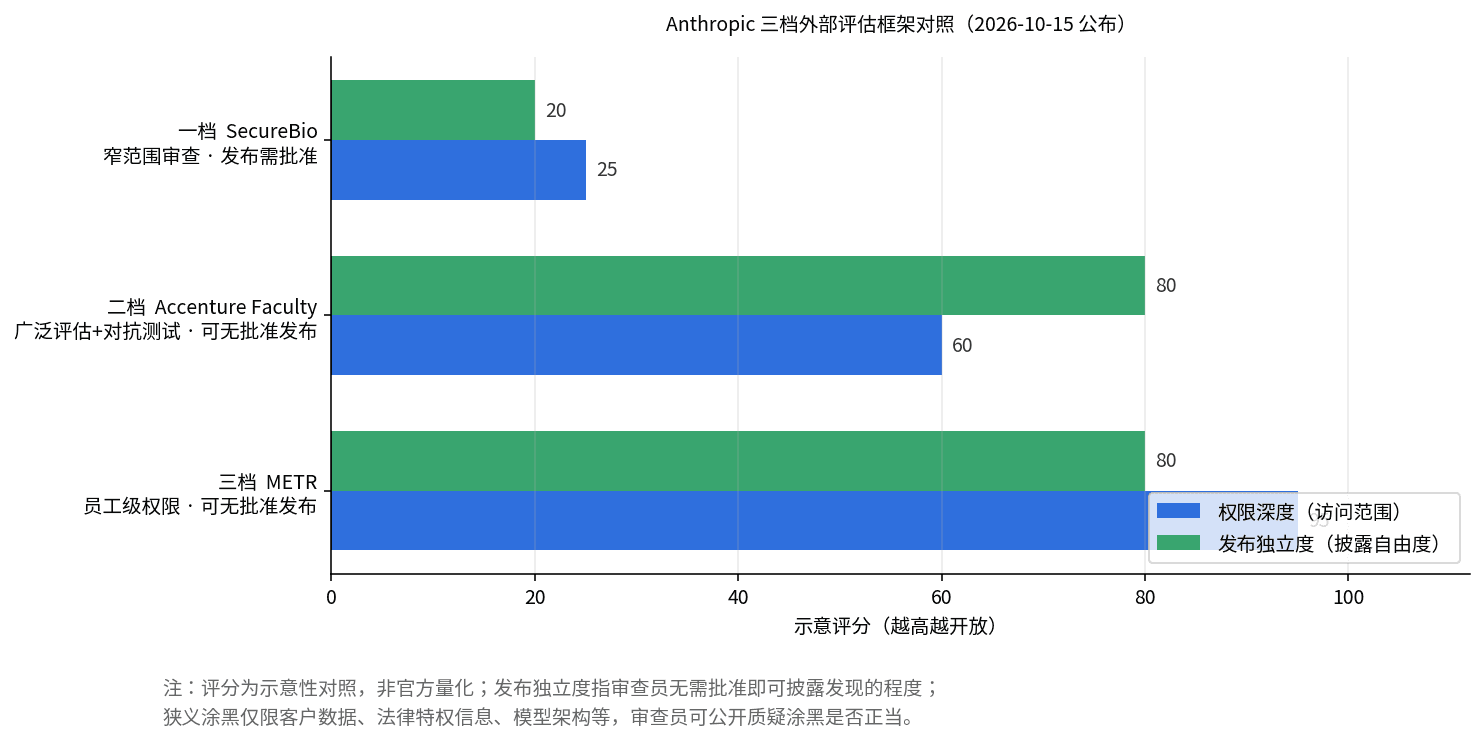
Anthropic 宣布给予非营利评估机构 METR 员工级系统访问权限,并允许其不经批准直接公布风险评估结论。就在十天前,路透独家披露 Anthropic 与 OpenAI 还在谈判中寻求对评审发布内容的实质控制权。从“控制发布”到“默认披露”的急转,折射出三重压力,也留下悬而未决的问题:实验室自己挑选的监督者,到底有多独立?

瑞典 TV4 真人秀《The Challenge Sverige》整季已剪辑成片被清空,“数百天的工作量”付之一炬,原定 11 月 22 日的首播推迟到明年春季。《Aftonbladet》称系 AI Agent 所为,TV4 否认“独立 AI Agent 作案”并称备份系统故障。HN 当日高热,两派吵的是同一件事:权限设计与备份缺失。