拆开跑,快 5 倍:Cerebras 把推理一分为二,同一度电多吐 5 倍 token
2026 年 11 月 17 日,Cerebras 宣布拆分推理正式投产:AMD GPU 处理预填充、CS-3 系统负责解码,单位功率吞吐量达到纯 CS-3 配置的 5 倍,速度不降。这个数字是真的,但口径很窄——一条共享端点、一次厂商自测。
一句话:把活儿拆开干,同一度电能多吐 5 倍 token
2026 年 11 月 17 日,AI 芯片公司 Cerebras 宣布,它的“拆分推理”方案已经正式投产:提示词处理交给 AMD Instinct GPU,回答生成留在自家的 CS-3 系统上。按它在自家推理云上的实测,这套组合的单位功率吞吐量是纯 CS-3 方案的 5 倍,而且生成速度没有下降。测量的是一条共享的 GPT-OSS-120B 端点,时间是 11 月 14 日,对比的是开启拆分前后的同一条端点。这个消息的看点不在“5 倍”这个数字本身,而在它背后的判断:推理这件事正在被拆成两段,而哪段放在哪种芯片上,正在变成一门生意。
先把背景说清楚。过去一年,智能体应用越跑越快,Muse、Copilot、Codex 这类工具要的是“随叫随到”的交互速度,用户敲一行字,等不起半天。可数据中心的电是有限的,机房能批到的兆瓦数就那么多,怎么在同样的功率预算里多伺候几个用户,就成了推理厂商最现实的竞争。Cerebras 的答案是:别让一种芯片包办全程。提示词处理和回答生成是两种完全不同的活儿,硬塞给同一种硬件,就是在浪费电。
预填充和解码,本来就是两种活儿
一次模型推理分两步。第一步叫预填充:模型把用户发来的整段提示词一次性读进去,算出中间状态。这一步的特点是并行度高,算力需求大,像是一次性把一整本账算清楚。第二步叫解码:模型拿着中间状态,一个 token 一个 token 往外吐,每吐一个字,都要把模型数据从内存里再读一遍。这一步是串行的,瓶颈不在算力,而在内存带宽——读得越快,吐得越快。
这个区分决定了硬件分工。GPU 擅长并行计算,处理预填充是本行;Cerebras 的晶圆级芯片则把几十 GB 的静态存储器和每秒几十 PB 的内存带宽做到同一块芯片上,解码时不用反复去片外内存搬数据。按 Cerebras 的说法,它的单芯片静态存储器容量是典型 GB300 GPU 的 350 倍,内存带宽是 5400 倍。正因为模型层和并发请求能直接装进片上存储,CS-3、CS-4、CS-5 才能在解码上跑出所谓“超快”的速度。把预填充挪给 GPU,CS-3 就可以把全部 serving 容量都留给解码,这就是 5 倍的来源:不是芯片变快了,是分工变合理了。
这个思路本身不算新。业内拆分预填充和解码的讨论已经有一阵子,草稿与目标、注意力与前馈等其他拆法也在被尝试。Cerebras 在 10 月 1 日就解释过拆分推理的原理,当时早期测试里也报过 5 倍。11 月 17 日这篇的不同在于,它拿出了投产的实测和给合作伙伴用的部署包,而不只是一次实验结果。从“我们试过,能快 5 倍”到“我们已经在生产环境这么跑了”,是两回事。
5 倍这个数字,到底是怎么测出来的
先说这个数字可信的部分。测量对象是 Cerebras 推理云上的一条共享 GPT-OSS-120B 端点,对比的是同一条端点开启拆分前后的单位功率吞吐量,基线归一化为 1 倍。也就是说,分子分母是同一套服务、同一批流量,只是开关了拆分,5 倍是前后对比,不是拿自家最好的配置去比别人最差的配置。而且 Cerebras 明确说了,生成速度没有下降——如果速度掉了,吞吐量再高也没用,因为智能体应用要的是快,不是单纯多。
再说这个数字的局限,Cerebras 自己在博客里也写了口径,读的时候不能跳过。第一,基线是“纯 CS-3 配置”,不是 GPU 方案,也不是别家推理云的成绩。5 倍说的是“拆开比不拆快 5 倍”,不是“Cerebras 比别人快 5 倍”,这两句话差得很远。第二,测量只来自一条共享端点、一次 11 月 14 日的采样,没有给出绝对的每秒 token 数,也没有给出功率的绝对值。没有绝对值,外人就没法独立复算,只能信它归一化后的比值。第三,这是厂商自己的测量,没有第三方独立验证。Unite.AI 在同日报道里也提醒,核心问题是这条端点上的优势能不能在合作伙伴各自选的加速器、框架和部署规模上复现。
所以,对 5 倍的正确读法是:它证明了拆分这条路在 Cerebras 自家的生产环境里走通了,但它还不是一张行业成绩单。真正能让这个数字站住脚的,是接下来一年里合作伙伴的部署数据。如果 AWS、Fireworks AI 这些早期合作伙伴跑出来的也是接近的倍数,那 5 倍就是真本事;如果只有 Cerebras 自家云能跑出这个数,那它更像是一次漂亮的产品演示。

不只是自家云:给合作伙伴的两种接法
这次发布不只是 Cerebras 自家云的事,它还带了一套给基础设施合作伙伴用的部署包。合作伙伴可以按 Cerebras 提供的参考架构,把自己选的预填充加速器和 Cerebras 系统放在同一个统一网络里共置部署。软件集成有两条路:想快速上线就用端到端拆分软件栈,想自己掌控就用纯解码软件开发包。
端到端软件栈包括四件东西:一个在预填充池和解码池之间路由请求、管理副本容量和健康的拆分推理框架;一个用 vLLM 或 SGLang 这类开源推理引擎处理提示词的预填充引擎;一个在 Cerebras 系统上做回答生成的解码引擎;还有一个叫 KV Portal 的软件,负责把键值缓存之类的中间模型状态通过 RDMA 在两个引擎之间传过去。纯解码开发包则相反:合作伙伴保留自己的推理框架和预填充引擎,只接 Cerebras 的解码引擎和 KV Portal,另外还附带一个模拟解码副本之类的开发辅助工具和一个开源拆分框架的参考集成。
这个“两条路”的设计本身就说明了 Cerebras 的处境。它想卖的不只是自家云上的推理服务,还有“解码加速”这个能力。早期拿到这套方案的合作伙伴包括亚马逊云科技、Fireworks AI、Gimlet Labs 和 General Compute,Cerebras 说正在向更多合作伙伴扩大开放。名单里有云巨头,也有推理服务商,这意味着 Cerebras 不打算只跟英伟达的 GPU 正面拼算力,而是想在别人的数据中心里当一个“解码插件”。这个定位如果跑通,它的对手就不再只是芯片公司,而是所有做推理优化的软件栈。
700 兆瓦与几百兆瓦:野心和问号
除了 5 倍,博客里还有两个规模数字值得留意。Cerebras 说,它计划到 2027 年底,在自家推理云和合作伙伴部署里广泛铺开拆分推理,规模达到几百兆瓦。同时,它提到最近发布的 CS-4、已经大幅扩大的制造规模,以及规划中的 700 兆瓦数据中心容量。几百兆瓦是部署目标,不是已经跑起来的容量;700 兆瓦是规划中的容量,不是已经建好的机房。这两个数字的意义在于,它们把“5 倍”从一次实验变成了一条产品线:Cerebras 赌的是,未来两年推理需求的增长会大到需要几百兆瓦的新增容量,而其中相当一部分会用拆分的方式跑。
这个赌注合不合理,取决于两件事。第一,智能体应用是不是真的会继续膨胀。高盛的研究被 Cerebras 引用来说明智能体需求在涨,但需求涨不等于都跑在 Cerebras 上。Muse、Copilot、Codex 这些应用的推理量确实在涨,可它们背后的算力采购是分散的,谁能拿到订单,要看价格、速度、稳定性和生态,不只看一个 5 倍。第二,CS-4 和 CS-5 能不能按时量产。博客里提到 CS-4 是“最近发布”的,CS-5 也在解码优势的名单里,但量产爬坡从来不是纸面数字,良率、交付和客户验证,每一步都可能拖时间。如果新芯片拖了,几百兆瓦的目标就只能靠 CS-3 硬撑。
还有一个更实际的问题:拆分推理把系统搞复杂了。预填充和解码分开跑,中间要传键值缓存,网络、调度、故障隔离都多了一层。KV Portal 用 RDMA 传状态,听起来很快,但跨厂商、跨机房的部署里,延迟和稳定性都是未知数。Cerebras 的参考架构和模拟解码副本就是为了降低这个门槛,但门槛降低不等于消失。合作伙伴真正上手之后,集成成本到底有多大,要等第一批部署的反馈。
晶圆级芯片这条路,赌的是什么
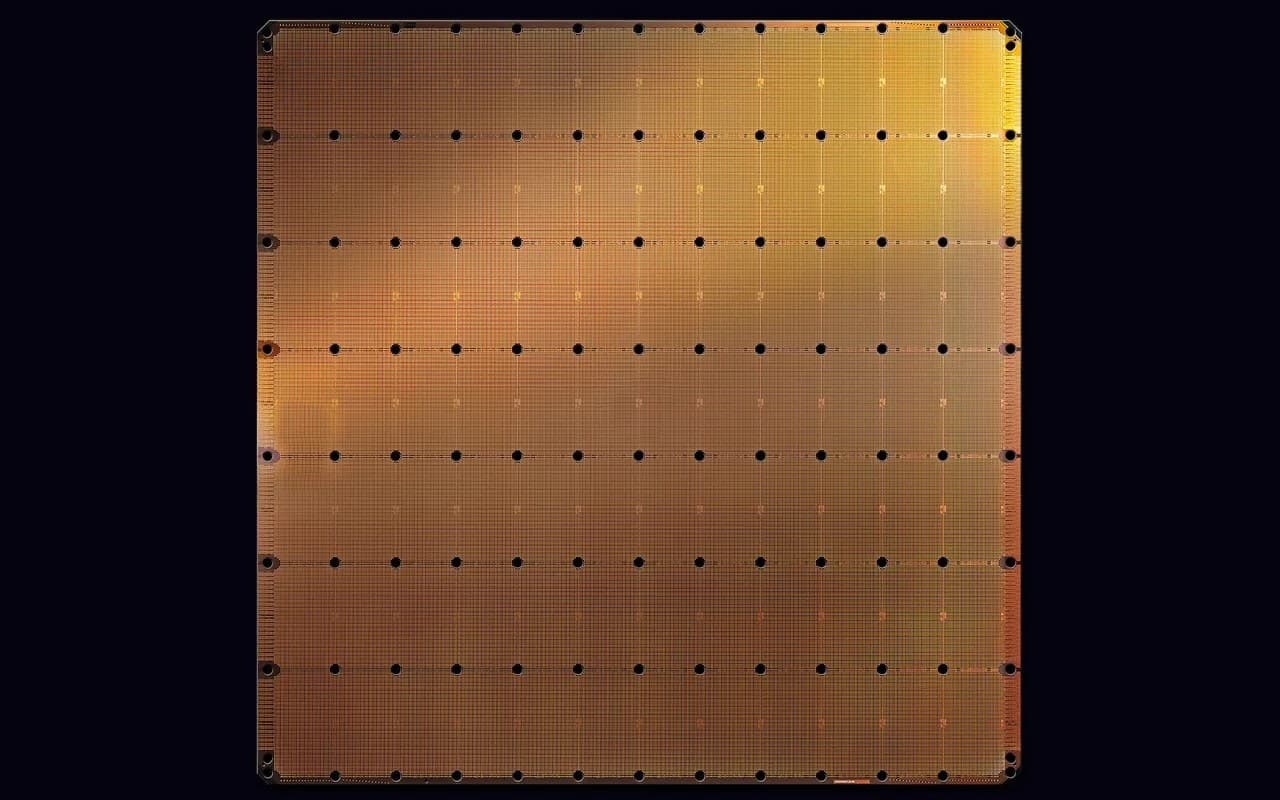
要理解 Cerebras 为什么敢把解码单独拿出来做一门生意,得先看它走的是一条跟别人完全不同的硬件路线。主流 GPU 是把很多块小芯片拼起来用,Cerebras 反其道而行之:直接用一整块晶圆做一颗芯片,也就是所谓晶圆级引擎。一颗芯片就是一整张晶圆,上面排满了计算核心和静态存储器,核心与核心之间不用出片就能直接通信。这条路线的好处很直观:内存带宽大得惊人,数据不用在芯片和显存之间来回搬;坏处也同样直观:这么大一块芯片,制造难度、良率和成本都是硬骨头,一颗芯片上任何一个坏点都可能拖累整片晶圆。
正因为走了这条路,Cerebras 的解码优势才成立。解码是内存带宽的游戏,而晶圆级芯片恰恰是为内存带宽而生的。博客里 350 倍和 5400 倍这两个数字,比较对象是“典型 GB300 GPU”,比的是单芯片的片上静态存储器容量和内存带宽。这个比较要小心着读:它比的是 Cerebras 最强的维度,不是综合性能。GPU 在通用计算、生态和编程模型上的优势,晶圆级芯片并不具备。所以这两个倍数说明的是“在解码这个单项上,Cerebras 的硬件形态占优”,而不是“Cerebras 的芯片全面碾压 GPU”。事实上,Cerebras 这次恰恰承认了 GPU 的价值:预填充就交给 GPU 干,这等于公开说,在它自己的强项之外,GPU 仍然是更好的选择。
这种“各干各的”姿态,其实是整个 AI 硬件行业正在发生的变化。以前大家比的是谁的单颗芯片跑分更高,现在越来越多厂商开始承认,没有一种芯片能包办一切。训练、预填充、解码、向量检索,每一段的瓶颈都不一样,硬用一种硬件跑全程,最后一定会在某一段上浪费。Cerebras 的拆分方案就是这种思路的产品化:它不再试图证明晶圆级芯片什么都能干,而是把自己定位成“解码专家”,把预填充让给 GPU,把系统集成留给合作伙伴。这是一种更务实的打法,但也意味着它的命运跟合作伙伴的接受度绑在了一起——如果 AWS、Fireworks AI 这些早期合作伙伴觉得集成太麻烦,或者跑出来的倍数不如预期,这条路就会走得很慢。
还有一个不能忽视的背景:Cerebras 不是在真空里发布这篇博客。就在同一个月,英伟达刚交出了一份 1158 亿美元季度收入的财报,数据中心业务占了 93%,整个 AI 算力市场仍然是英伟达的天下。Cerebras 的 5 倍,是在一个巨头主导的市场里发出的声音。它不需要说服所有人,只需要说服那些正在为推理成本和交互速度发愁的客户:同样的功率预算,在我这里能多伺候 5 倍的请求。这个说服能不能成立,最终要看客户的账本,而不是博客的措辞。
接下来一年,要盯住哪几个数字
这篇博客发布之后,真正值得跟踪的不是 5 倍本身,而是几个能验证它的数字。第一个是合作伙伴的部署反馈。AWS、Fireworks AI、Gimlet Labs 和 General Compute 这四家早期合作伙伴,会不会在未来几个季度里公开自己的拆分推理数据?如果它们保持沉默,说明集成比预想的难,或者效果不如预期;如果它们陆续报出接近 5 倍的数字,那 Cerebras 的路线就得到了独立背书。
第二个是 CS-4 的量产进度。博客提到 CS-4 是“最近发布”的,但没有给出交付时间表和客户名单。晶圆级芯片的量产爬坡从来不是小事,几百兆瓦的部署目标要靠 CS-3、CS-4、CS-5 一代代芯片去填。如果 CS-4 的交付拖到 2027 年下半年,几百兆瓦的目标就会变得很紧张。第三个是绝对性能数据。Cerebras 至今没有公布拆分方案的绝对每秒 token 数和功耗,行业里也没法把它跟别家的推理服务放在同一张表上比较。什么时候它敢公布绝对值,什么时候才算真正准备好接受横向对比。
最后还有一个问题值得开发者留意:拆分推理会不会变成行业的标准做法?如果答案是肯定的,那么受益的就不只是 Cerebras,所有做推理优化的公司都会跟进,vLLM、SGLang 这些开源推理引擎也会把拆分做得更顺手。到那时,Cerebras 的先发优势会被稀释,它要靠的就是 CS 系列芯片本身的解码速度和几百兆瓦的部署规模。如果答案是否定的,拆分只在 Cerebras 自家云上划算,那它就仍然是一个小众但赚钱的利基市场。两种结局对 Cerebras 来说天差地别,对开发者来说却都是好事:要么推理变便宜,要么多了一种可选的架构。
这对开发者意味着什么
对普通开发者来说,这条新闻的直接意义有限:你今天用的推理服务不会因为这篇博客就变便宜,Cerebras 也没有公布任何价格。它的意义在更长的时间线上。如果拆分推理真的能在几百兆瓦的规模上跑起来,推理的单位成本就有可能下来,智能体应用也就能更便宜地做到“随叫随到”。反过来,如果这个 5 倍只在 Cerebras 自家云上成立,那它对行业的影响就只是一次技术路线的提醒:预填充和解码分开,是个值得认真考虑的方向。
更值得留意的是这条新闻透露的行业风向。推理的竞争正在从“谁的芯片更快”转向“谁的系统更会分工”。模型越来越大、智能体越来越能干,单靠堆算力已经不够了,怎么把提示词处理、解码、缓存、调度拆开,分别交给最合适的硬件,正在变成推理厂商的核心能力。Cerebras 这次押的是“GPU 干预填充、晶圆级芯片干解码”,这是一个清晰的分工答案,但它是不是最好的答案,还要看接下来一年里,别的厂商会拿出什么样的分工方案来回应。
总的来说,Cerebras 这篇博客的可信度在中等偏上:测量方法写得清楚,口径和局限没有藏着掖着,合作伙伴名单和部署目标也都摆在台面上。它的短板也很清楚:只有一个端点的自测数据,没有绝对数值,没有第三方验证。5 倍是个值得记住的数字,但记住的同时也要记住它的定语——在 Cerebras 推理云上,一条 GPT-OSS-120B 共享端点,拆分前后对比,单位功率吞吐量 5 倍,速度不降。等合作伙伴的部署数据出来,这个数字才算真正落地。
评论 (0)
原始来源
相关文章

2026 年 11 月 20 日,OpenAI 发布 MedChemBench:99 道药物化学题,取自 117 篇论文和专利,覆盖 761 个分子。GPT-6.2 Astra 总分 84.5%,但拼分子结构拿 95.4%、选化合物只有 50.4%——总分好看,分项偏科,OpenAI 自己把红线画在了公告里。

2026 年 11 月 18 日,谷歌研究院等团队在 arXiv 发布 BuggyMLE:往 222 个能跑的机器学习仓库里注入 bug,14 个模型从最简单的 95% 一路跌到最难的 9%。一个 90 亿参数的小模型靠从易到难的课表,在 10 个 bug 那档超过了 Claude Opus 5.5。
2026 年 11 月 19 日,OpenAI 披露了内部系统 Performance Factory:Codex 智能体自动调查 ChatGPT 的性能回退,三个多月跑了超过 1700 次调查、找到 600 多个根因。但最终原样合并的修复只有 15 个左右——Agent 已经能把调查的活儿接过去,修复还得有人兜底。