Claude Code 的慢工具终于不用堵住对话了:MCP Tasks 公开测试详解
2026 年 10 月 22 日宣布、v2.1.304 起可用的 MCP Tasks,让慢工具先回一个任务编号、后台慢慢干,中途还能停下来问你一句。本文拆解它与自动后台化的区别、提问机制的三条规则、服务器作者的实现清单,以及它为什么不是工作流引擎。

一句话先说清:慢工具不再堵住对话
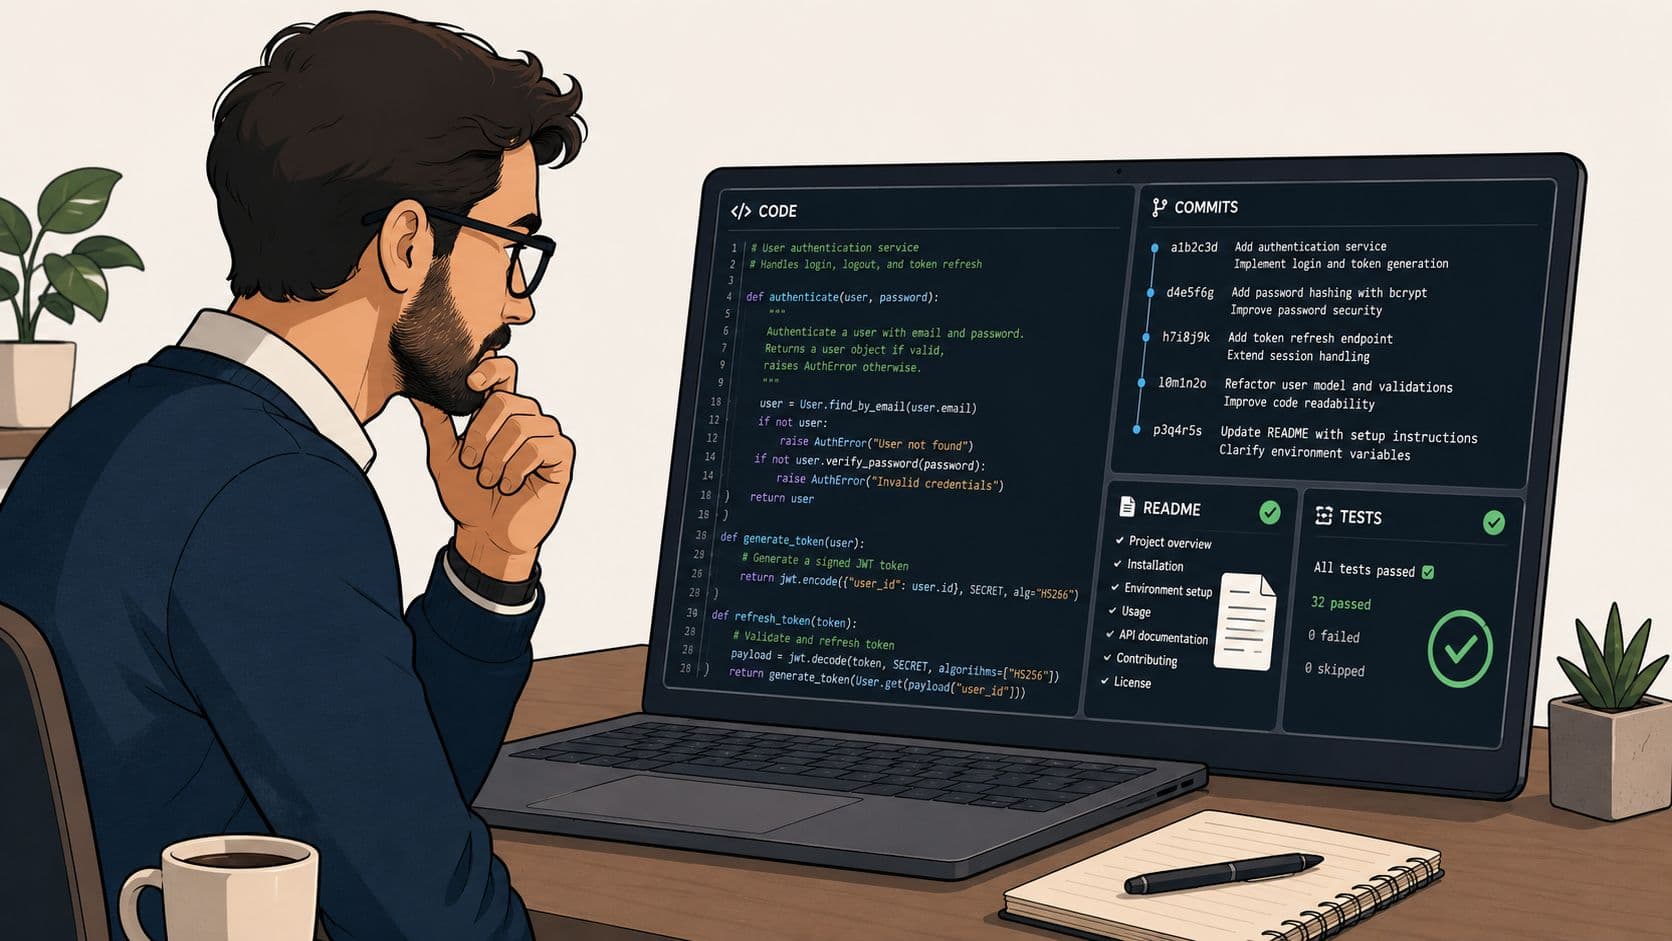
过去 MCP 工具调用是一次请求、一次回答的同步模型:导出一份十分钟的报表、跑一次完整的回归构建,对话就得等十分钟,或者调用直接超时。Claude Code 现在支持的 MCP Tasks 把这个模型改了:服务器可以先回一个任务编号,自己在后台慢慢干,Claude 继续和你聊,任务结束再把结果交回来。更关键的是第二点:任务中途还能停下来问你一个问题——比如“确认把这个分支部署到预发布环境吗?”——你回答后它才继续。这不是又一个聊天增强,而是一次协议层面的改动:慢活、长活和需要人拍板的活,第一次有了体面的异步形态。
需要先划清边界。MCP Tasks 不是让 Claude Code 变快,也不是让模型变聪明。它解决的是等待结构:谁在等谁、等多久、等的过程中能不能干别的、以及人什么时候必须介入。判断它有没有价值,别看演示里的报表生成得多流畅,看你自己的工具里有没有那种“超过两分钟就注定超时、失败后又得从头再来”的调用。有,就值得认真评估;没有,它就是一次普通的协议升级,不必追。
新闻事实:10 月 22 日宣布,v2.1.304 起可用
2026 年 10 月 22 日,MCP 联合创始人之一 David Soria Parra 在旧金山 AGNTCon + MCPCon North America 大会的主旨演讲中宣布 Claude Code 支持 MCP Tasks。次日,Anthropic 的 ClaudeDevs 账号确认 Tasks 与 Elicitations(提问机制)均已在 Claude Code 命令行中可用。Claude Code 官方文档随后把这套机制写进 MCP 参考页:MCP Tasks 目前处于公开测试阶段,要求 Claude Code v2.1.304 或更高版本,覆盖终端命令行会话、Agent SDK 会话和 GitHub Actions 运行。
文档同时把“不在其中”的清单写得同样明确:VS Code 扩展和桌面应用目前没有 MCP Tasks;子代理(subagent)发起的调用不会变成任务;一次性 claude -p 运行也不会;不拉取功能开关的第三方供应商(文档点名 Amazon Bedrock)同样不在其中。服务器一侧也有硬门槛:必须走 2026-07-28 版协议修订,调用必须来自主对话,服务器必须支持 Tasks 扩展。任何一条不满足,调用就退回普通同步工具调用,不会报错、不会排队,只是安静地变回老样子。这个“安静退回”值得留意:上线后如果发现任务没出现,先查版本、查协议版本、查调用来源,而不是怀疑服务器坏了。
协议本身并不新。MCP Tasks 扩展随 2026 年 7 月 28 日的 MCP 版本发布,定义了服务器以任务句柄回应慢请求、客户端轮询取结果的机制。Claude Code 这次做的是客户端落地:把协议能力接进真实的会话、任务列表和提问对话框里。换句话说,10 月的新闻不是“发明了异步”,而是“最主流的 agent 命令行之一终于把异步接通了”。对生态的意义正在于此:服务器作者现在有了一个值得适配的客户端,而不只是协议文档里的一个扩展名。
两种“后台”别混淆:自动后台化与服务器任务
Claude Code 文档里其实有两种容易混淆的后台机制,写代码之前必须分清。第一种是自动后台化:主对话里一个 MCP 调用运行超过两分钟,Claude Code 会把它移到后台任务,继续对话,稍后取回结果。这个机制不需要服务器做任何改动,但它有个硬伤:服务器仍然要把那次请求一直挂着,函数超时、连接中断照样会杀死它;而且它不随会话关闭而存活,关掉 Claude Code,任务就没了。
第二种才是真正的 MCP Tasks:服务器在 tools/call 的回答里直接返回任务对象,包含 resultType 为 task、任务编号 taskId、状态 working、创建时间与更新时间、生存时间 ttlMs,以及可选的状态消息和轮询间隔。Claude Code 此后用 tasks/get 按轮询间隔查状态,任务结束把正常结果交给 Claude。远程服务器上的任务在你退出后继续跑,恢复同一会话就能重新跟进;页脚会显示“1 MCP task”这样的计数,/tasks 里可以查看和停止它。代价是服务器要自己保管任务状态:内存里的任务进程重启就丢,多实例部署下一次轮询可能打到没见过这个任务的实例——生产部署要配持久化存储和分发器,不能只靠示例代码里的内存实现。
对使用者来说,区分两者的最简单办法是看 /tasks 里的标注:标注“runs on the server; survives exiting this session”的才是服务器任务;没有这行字的,多半只是自动后台化,关掉就没。写进团队文档时也要用这个区分,否则“任务会不会在我关机后继续跑”这个问题永远扯不清。
提问机制:Elicitation 是把“人”放进长任务的关键
长任务真正难的不是等,而是中途需要人拍板。MCP Tasks 的提问机制 Elicitation 解决的就是这个:任务运行到需要确认的节点,状态变为 input_required,Claude Code 在交互终端里弹出一个小表单,比如确认部署分支、确认退款金额;你接受、拒绝或按 Esc 取消,都是给服务器的明确回答,服务器再决定继续还是停止。
这里有三条必须写进操作手册的规则。第一,提问只在交互终端会话里送达;在非交互会话里,Claude Code 会直接要求服务器取消需要输入的任务,而不是替你猜一个答案。第二,拒绝和取消也是答案,服务器必须处理“用户说不”的分支,不能假设只有“是”这条路。第三,提问对话框在 /tasks 打开时是隐藏的,要先关掉 /tasks 才能回答——这是一个容易让使用者误以为“卡住了”的小坑,团队内部第一次用时值得专门提醒一次。
我的判断是:提问机制比任务机制更重要。没有提问的长任务,agent 要么在关键步骤前停下来等你全程盯着,要么擅自替你做了不可逆操作;有了提问,人才真正可以“交出去又不失控”。但前提是服务器作者把每个不可逆步骤都设为提问点——协议给了工具,责任还在作者手里。审查一个 MCP 服务器时,先问“哪些步骤会问我”,再问“它能跑多快”。
给服务器作者的清单:从回答格式到取消语义
如果你要给自己的 MCP 服务器加上 Tasks 支持,Claude Code 文档给出的实现清单相当具体,值得逐条对照。回答任务时,tools/call 的结果里不要放 content 数组,resultType 必须是 task;taskId 必填,最多 128 个可打印 ASCII 字符、不含空格,否则 Claude 会收到格式错误的工具错误;状态只能是 working、input_required、completed、failed、cancelled 五种之一;createdAt、lastUpdatedAt、ttlMs 必填,ttlMs 可以为 null;pollIntervalMs 可选,Claude 会把它钳制在 250 到 30000 毫秒之间,缺省按 2000 毫秒轮询。
状态汇报同样有规矩:每次 tasks/get 都要返回完整的任务对象,completed 时把正常工具结果放在 result 里;failed 必须在顶层 error 对象里给 message,否则 Claude 只能看到状态消息或一句干巴巴的“Task failed”;cancelled 也一样。取消是协作式的:Claude Code 发 tasks/cancel,服务器可以在检查点停下来,但也可能把手头的工作做完——所以“取消”在你的服务器里到底意味着“立即停”还是“跑完这一步再停”,必须在文档里写清楚,不能让使用者猜。
还有两个生产细节容易被低估。第一,HTTP 或 claude.ai 连接器服务器上,任务回答必须在单次请求计时内发出:先接活、回任务编号,再慢慢干,顺序不能反。第二,任务的超时语义:后台任务本身默认没有 Claude Code 的时间限制,但工具调用的时间限制(挂钟限制与空闲超时)在服务器回答任务之前一直有效;如果你让 Claude 等结果,限制会覆盖整个任务。这些细节决定了你的服务器在真实会话里是“稳”还是“偶尔抽风”,上线前值得用慢任务、取消、断线重连三组用例各测一遍。
它不解决什么:别把 Tasks 当成工作流引擎
冷静一点:MCP Tasks 不是工作流引擎、不是队列系统、也不是持久化任务平台。它不提供重试策略的可视化编排,不保证任务在服务器重启后恢复(那是你自己的存储要做的事),不处理任务之间的依赖关系,也不提供“任务 A 完了自动触发任务 B”的编排语义。需要这些的团队,仍然要在 MCP Tasks 之上再搭一层自己的编排,或者直接用已有的工作流系统,把 MCP Tasks 只当作“Claude Code 与慢工具之间的握手协议”。
同样,它也不改变模型的能力边界:任务跑得再久,Claude 拿到结果后仍然可能理解错、仍然需要你审。把长任务交给服务器,只是把“等待”从对话里挪走,没有把“判断”也挪走。团队如果指望 Tasks 一上线,agent 就能独立跑完一整天的工作,那是在对协议许愿,不是在用协议。
还有一个现实限制:生态适配需要时间。服务器要升级到 2026-07-28 协议、实现任务方法、处理提问与取消;客户端要升级到 v2.1.304;团队要更新操作手册。未来几个月里,你会同时遇到“支持任务的服务器”和“不支持的服务器”,以及“支持任务的会话”和“不支持的会话”。在这种混合期,最务实的做法是:新服务器按 Tasks 写,老服务器不动,文档里给每个工具标注“是否支持任务”,而不是假设全量切换。
给不同角色的落地建议
对个人开发者:先把 Claude Code 升到 v2.1.304 以上,找一个你已有、且确实慢的 MCP 工具试一次完整流程——发起任务、看 /tasks、等结果、故意取消一次。十分钟的亲手试,比读十篇解读更能告诉你它在你手里稳不稳。注意,VS Code 扩展里试不出来,必须用终端命令行。
对团队负责人:别急着把所有慢工具都改成任务。先挑一到两个“超时最痛、失败代价最低”的工具试点,比如报表导出、测试报告生成;把“哪些步骤必须提问”列成清单,写进服务器的评审标准;同时把“任务在服务器重启后会怎样”写进运维手册。试点跑两周,统计任务成功率、取消率和提问响应时间,再决定扩不扩。
对服务器作者:按文档的任务对象格式实现,先跑通内存版,再上持久化存储;把取消语义、提问点、轮询间隔写进 README;给每个不可逆操作加提问,不要把“用户点一下确认”当成可选项。最后提醒一句:任务编号要能在新连接上被认出来——恢复会话后 Claude 会用新连接继续问这个任务,编号对不上,任务就成了孤儿。
三个值得先试的真实场景
第一个场景是回归测试。改完一处核心逻辑,习惯上要跑完整套测试,短则几分钟、长则十几分钟;以前的做法是开一个终端窗口挂着,或者把测试拆小、分批跑,结果是测试覆盖被人为切碎,真正能发现回归的那组长测试反而最少被跑。现在可以把完整回归包成一个 MCP 任务:服务器接单后回编号,Claude 继续帮你改下一处,等测试跑完再把失败清单交回来。失败的用例要附上完整的失败输出和复现命令,不能只给一句“有 3 个失败”——否则你还得再跑一次才能定位,任务的意义就打了折扣。更稳的做法是让任务结果里直接包含失败用例的日志片段和对应的测试文件路径,Claude 拿到后可以直接定位,不必再问你。
第二个场景是数据类长活:导出报表、同步数据、批量生成文档。这类活的特点是“结果重要、过程无聊”,最适合交给后台任务。但要注意一个细节:导出和同步往往涉及外部系统的写入,任务中途被取消时,外部系统可能已经写了一半。服务器作者必须想清楚取消后的状态:是留下一个可恢复的中间态,还是回滚到开始前?这个答案要写进任务文档,而不是等用户在生产环境里撞上才发现。我的建议是:凡是涉及外部写入的任务,都要在开始前返回一个“可查询的外部单号”,取消或失败后用户至少能凭单号去外部系统核对到底写了什么。
第三个场景是需要人确认的发布类操作:部署到预发布、发布一篇内容、执行一次批量操作。这类任务的价值不在后台运行,而在提问点:机器把准备工作做完,停在“确认执行”这一步,把决定权交还给你。操作手册里要规定提问的粒度:太粗,用户一次确认里藏了十个不可逆操作,等于没确认;太细,用户每两分钟就要点一次,等于没后台。合理的粒度是“一次确认对应一次外部可见的副作用”,比如一次部署、一次发布、一批写入,而不是把一整条流水线包进一个确认框。
混合期的生存策略:新旧工具并存怎么办
未来几个月,团队一定会处在混合期:有的服务器支持任务,有的还停留在同步调用;有的会话在终端里,有的在 VS Code 扩展里;有的同事升到了 v2.1.304,有的还没升。这种时候最忌讳的是写一份“假设全员已升级”的文档,然后让没升级的人自己踩坑。务实的做法是给每个 MCP 工具打上状态标签:支持任务、仅同步调用、仅终端可用、需要协议版本多少。标签贴在团队内部的工具清单里,而不是藏在某个人的脑子里。
另外要建立一条降级规则:当任务机制不可用时,调用应该退回同步模式并明确告诉使用者“这次是同步调用,超时风险仍在”,而不是悄悄退回、让使用者误以为任务在后台跑。Claude Code 的设计本身就是安静退回,这对兼容性是好事,但对使用者是坏事——安静意味着误解的空间。团队可以在自己的封装层里补一句提示:调用开始时说明“本次以任务模式运行”或“本次以同步模式运行”,一句话就能避免大量“我以为它在后台跑”的误会。等生态全面跟上,这句提示再拿掉也不迟。
一句话收尾:MCP Tasks 的价值不在“快”,而在“等得起、问得到、停得下”。慢工具第一次可以体面地离开对话、又体面地回来,还能在关键处停下来问你一句。这正是 agent 从“一次问答”走向“长期协作”必须补上的一块拼图——不大,但缺了它,拼图就不完整。
补一句给还在犹豫的人:不用等生态全部跟上才开始,先让一个慢工具跑起来、问一次问题、取消一次任务,这三步走完,你就知道它在你手里到底稳不稳。
评论 (0)
原始来源
相关文章
2026 年 10 月 23 日发布的 Codex CLI 0.164.0 没有新模型,主角是十个 /presets 槽位、内联的 /model 与 /permissions 参数,以及更难丢的会话恢复。本文按操作层标准拆解:哪些改动值得今天就用,哪些只是顺手修掉的边角。
GitHub 2026 年 10 月 26 日官方 Changelog 宣布 GPT-6.1 Terra 在 Copilot 中正式可用,覆盖 Pro 至 Enterprise 五档,定位日常 agent 编程与终端任务、成本低于 Sol。本文拆解官方原文说了什么、没说什么,梳理 10 月 26 日至 11 月 16 日的迁移窗口,并给出个人、团队、企业管理员三份行动清单。
Vercel 在 2026 年 10 月 15 日 Ship 大会上同时推出 Drives 正式可用与 Daemons 公开测试:前者给 agent 一个沙箱关停后仍在的持久工作区,后者让后台任务无需 HTTP 服务器长期运行。本文讲清两者的用法、边界与不适用场景,并给出务实的两步落地顺序。