Claude Code 团队怎么做代码评审:持续 AI 预审取代纯人工门禁
Anthropic 的 Claude Code 团队把评审从人工门禁改造成持续 AI 预审:六层检查、按风险定级的人类审批、agent 互审三轮上限、确定性 pre-commit hook。一人 vibe 团队可以直接抄走的三件事。
先划一条界:如果你关心的是 Anthropic 自研版本控制系统 Scion 替代 Git 的故事——那是另一篇,VibeFix 此前已经单独报道过。本文只谈同一支团队的另一面:当 90% 的代码都是 Claude 自己写的,他们怎么评审代码。
2026 年 10 月 15 日,Anthropic 在 claude.dev 官方博客发布了《How the Claude Code team does code review》,作者是 Addy Osmani、Morgan Westlee Lunt 和 Qing Wang。Simon Willison 在 10 月 16 日第一时间转述并引用了其中的关键段落。这篇文章值得逐段读,因为它回答了一个所有 AI 编程团队迟早要面对的问题:当 agent 一天提交的代码量超过人类一年的阅读量,代码评审这道"人工门禁"还守得住吗?
Claude Code 团队的答案是:守不住,也不守了。他们把评审从"写完代码、开 PR、等同事看"的终点门禁,改造成了贯穿整个编码过程的持续 AI 预审——原文的比喻是,它现在更像"写作时的拼写检查"(spellcheck while you write)。大多数改动在人类被要求看一眼之前,已经被 Claude 评审并修复过至少一轮。
先看数字:评审是被逼着改的
驱动这场改造的不是理念,是数量。Anthropic 的 monorepo 里,每天落地的变更从 2026 年 5 月的日均约 2500 次,涨到了 9 月的日均 30000 次以上——四个月,12 倍。Claude Code 自己的独立仓库压力同样陡峭:6 月到 9 月,合并的 PR 数量翻了一倍多,而需要 revert 的比例下降了 40% 以上。
注意这个组合:合并量翻倍的同时,revert 率反而大降。这说明他们的目标从来不是"为了快而放松评审",而是"用更少的人类时间,维持甚至提升质量"。文章开篇就把衡量标准钉死了:追踪每个 PR 的人类审批数(中位数和 95 分位数)、人类评论数、PR 等待人类的时间;revert 率和事故率是护栏——如果这两个数字上升,省下来的人类时间就是假的,只是把成本从"评审时间"挪到了"修线上事故时间"。
这是一个值得抄走的度量框架。一人 vibe 团队当然不需要这么重的仪表盘,但"省下的评审时间有没有变成修 bug 时间"这个问题,每个让 agent 写代码的人都该定期问自己一次。
核心判断:"有人读过代码吗"是个粗糙的代理指标
全文最锋利的一句话是:"did a human read the code?" is an imprecise proxy for "what could go wrong with this change, and which check—automated or human—is the right one to catch it?("有人读过这段代码吗",是对"这次改动可能出什么问题、哪种检查——人工还是自动——最适合抓住它"这个真正问题的粗糙代理。)
这句话把评审的目的拆成了两件独立的事:第一,在代码上线前发现并修复问题;第二,在团队里传播代码库的共同理解。传统流程把这两件事绑在同一个人肉环节上:同事逐行读 diff,既找 bug,又顺便学习代码库长什么样。agent 时代,这个绑定解开了——找 bug 的部分可以交给机器,而"传播理解"的部分,需要另想办法(文章后半部分专门讲了他们怎么解决,后文细说)。
一旦接受"人肉逐行读"只是手段而非目的,评审的形态就变了:不再是终点的门禁,而是持续的预审。写代码时拼写检查一直在跑,犯错当场标红;Claude Code 团队的评审现在也是这个位置。
六层检查:门禁拆成了流水线
一个改动从工程师的笔记本(或 Slack 里的 Claude 会话)到用户手里,要穿过六层检查,外加底层的快速回滚:

第 1 层:PR 存在之前,工作就已经被验证过
现在大部分评审发生在 PR 存在之前。他们给 Claude"能运行的东西"——测试、构建、和设计稿对比的截图——然后要求它展示输出,而不是口头说"做完了"。再让一个 fresh context 的子 agent 重新看一遍 diff。这两个习惯来自他们自己的最佳实践指南。
很多人还在 PR 里跑几套内部 skill:一个专找 bug,一个专精简 diff,一个端到端验证行为;UI 改动还要对照设计规范检查。Claude Code 的创造者 Boris Cherny 把"给 Claude 一个验证自己工作的方法"称为拿到好结果最重要的事,他估计这能让最终结果好两到三倍——验证在每个领域长得不一样,可能是一条 bash 命令、一个测试套件,也可能是在浏览器或手机模拟器里实际跑一遍。
这里有个关键的操作细节:当自动评审反复 flag 同一类问题,就在源头修掉它——写进 skill、加一条 lint 规则,或者更新 CLAUDE.md / REVIEW.md 这类 instruction 文件。CLAUDE.md 讲项目是什么(技术栈、约定、目标和非目标),每次评审都会加载,所以在大代码库里要保持短小、指向其他文档;评审者还会 flag 违反其中约定的代码,以及让其中某行过时的改动。REVIEW.md 由代码 owner 写,讲"这块代码什么最重要"——好的 REVIEW.md 很短:说清这个仓库里"失败长什么样"(文档仓库是"它在说谎",配置仓库是"它路由错了"),限制 nit 的数量,列出要跳过的路径,要求给出文件和行号作为证据而不是靠名字猜,还要求摘要开头先给数量、没问题就直说没问题。
第 2 层:每个 PR 的 AI 评审
每个 PR 在人类看之前都会经过一次 Claude 评审:对照整个仓库和 PR 陈述的意图读 diff,问三个问题——改动解决了它的问题吗?符合系统吗?会不会破坏别的东西?公开版本"Code Review for Claude Code"已经在 Team 和 Enterprise 计划上 GA,本地可以用更轻量的 /code-review。
研究预览阶段的数据很说明问题:内部 PR 收到实质性评审评论的比例从 16% 涨到了 54%。超过 1000 行的大 PR 几乎都能找出东西,小 PR 大多干净返回。管理员可以给每个仓库设 Quick、Standard、Deep 三档——在一个漏掉的 bug 比多花评审时间更贵的地方,Deep 值得。
更重要的是 findings 的处理机制:多个 agent 同时找 bug,另一组 agent 对每条 finding 投票,只有足够多 agent 认同"这是真的"才会发出来;纯风格、诊断、清理类的 finding 直接丢掉——这些过滤器先在自己的 PR 上做过 A/B 测试才保留。留下来的以 inline 评论按严重度排序,每条打标签:Important、Nit、Pre-existing(PR 没引入的历史问题不会被算到作者头上)。每条 finding 都必须有回应:要么修掉,要么写理由 resolve 线程。经常是 agent 半夜把修复接过去,作者早上回来,PR 已经又过了一轮。
第 3 层:能拦住合并的安全评审
安全有独立的自动评审。bug 评审或安全评审的 finding 还有没关的,PR 合并不了:要么修,要么写短理由关闭线程(误报就这么清掉)。后面的 commit 修好了问题,finding 会自动清除。开源的 security review GitHub Action 或 /security-review 命令可以配出同样的东西。
第 4 层:拦路的自动化检查
常规项:lint、类型检查、全平台测试、构建。一个 CLI 的 PR 在人类看之前可能已经跑了几十项检查。PR 模板会问"怎么测的"和"怎么回滚",Claude 可以代填,但发起改动的人要签字。
第 5 层:按风险定级的人类审批
这是全文最值得抄的一张表:
- 低风险(文档、文案、内部功能、flag 后的增量改动):自动评审和安全检查全绿后,不需要人类审批;
- 中风险(普通产品改动,以及缓存、自动更新、系统提示词等敏感区):一个人;
- 高风险(最高风险代码,外加一小批永远需要双人的路径):两个人。
三个配套规则钉得很死:第一,定级的是改动,不是作者——分类器读改动内容定风险档,第二个分类器再问"这个改动要不要加人",有些路径(owner 标为敏感的、所有 CI workflow 文件)永远要人;第二,只有信任名单上的作者能走轻量路径,agent 的 approval 永远不算人类的数——自动评审可以放行低风险改动,但填不了"需要人类"的位置;第三,approval 只覆盖某一个具体 commit,agent 又 push 了或有人手解了冲突,审批作废重来。而"谁 prompt 的改动,谁就是 reviewer 之一"——agent 写的 PR,指挥 agent 的人跟自己手写代码负同样的 reviewer 责任。
第 6 层:合并队列、灰度与快速回滚
合并队列把每个改动合入 main 后重跑全部检查,防止两个各自通过的 PR 合在一起把 main 搞坏。新行为通常先上 flag,只给 Anthropic 员工用——他们自己的高强度使用经常在用户之前暴露回归。公开发布先走 latest 通道,stable 通道滞后。
最后一层是"快发现、快回滚":flag 不用部署就能关;每周 on-call 轮值;事故复盘必问"哪一层本该抓住这个问题"。他们坦承还没做出来"熔断器"——revert 和事故数字一动就自动收紧审批,工程师们想要这个,然后才敢让更多代码走零人类合并。一位同事的话值得记住:慢下来确实能降低错误率,但主要是因为你做的每件事都变少了;他们宁愿把"发现和修复问题"的速度练快。
最值得细读的三处:收敛、人、上下文
1. 评审必须收敛:agent 互审会陷入 50+ 轮的循环
这是全文最"血淋淋"的一段。agent 当作者、agent 当评审,两边可以无限互相 busy:一个 CLI 的 PR 一晚上经历了 50 多轮评审和修复,直到作者手动叫停。他们对评审反复 flag 的内容做了 git blame,发现约 59% 是第一轮评审时就已经在那里的代码——评审很少在发现新 bug,只是在每轮多找几个旧 bug。
而且是他们自己把情况搞糟的:习惯了默认跑好几轮,因为每轮确实能多抓点东西。高风险改动这么做值得,每个 PR 都这么做不值得。现在他们把"几轮通过"和召回率一起追踪,并改了重审规则:三轮 cap——三轮之后评审者要求作者停下来重新考虑方案;前几轮之后只重审 diff;flag 的是 bug 的"类别",让作者修掉所有同类实例而不是改一行;不重复发已经发过的 finding。另外评审 agent 每天晚上还会扫一遍现有代码,在旧 bug 惹祸之前抓住它们。
对 vibe 团队的直接启示:如果你让 agent 互相 review,一定要设轮数上限,否则就是在烧 token 陪它们玩"你找茬我改茬"的无限游戏。三轮是个经过实战检验的起点数字。
2. 人类留在环内的五个决策
把资深工程师从深夜逐行读 diff 里解放出来,省下的注意力投向机器不擅长的五个决策:该不该做(方向、品味、范围——有个自称解决评审瓶颈的团队,依然保留对外部团队改动的人工评审,就是为了有人问"这事该做吗");高风险代码(计费、自动更新、CI workflow);会定下被复制模式的架构;读证据(测试输出、跑过的命令和返回、截图、评审者的 findings——如果你说不清这些检查会漏掉什么,就别给快速 approval,老老实实做一次真评审);以及为结果负责——谁 landing 的,出了问题通常谁修,incident review 查的是系统不是追 blame。
"读证据"这一点尤其值得划线:AI 时代的 reviewer 不再靠"把每一行都读一遍"建立信心,而是靠"我知道自动检查覆盖了什么、没覆盖什么"来决定要不要深看。这和 VibeFix 站内《读懂 AI 生成的代码》指南讲的"读代码的重点不是找 bug,是找'你以为它做了、但它没做'的事"恰好互补——那篇教你怎么读,这篇告诉你什么时候值得读。
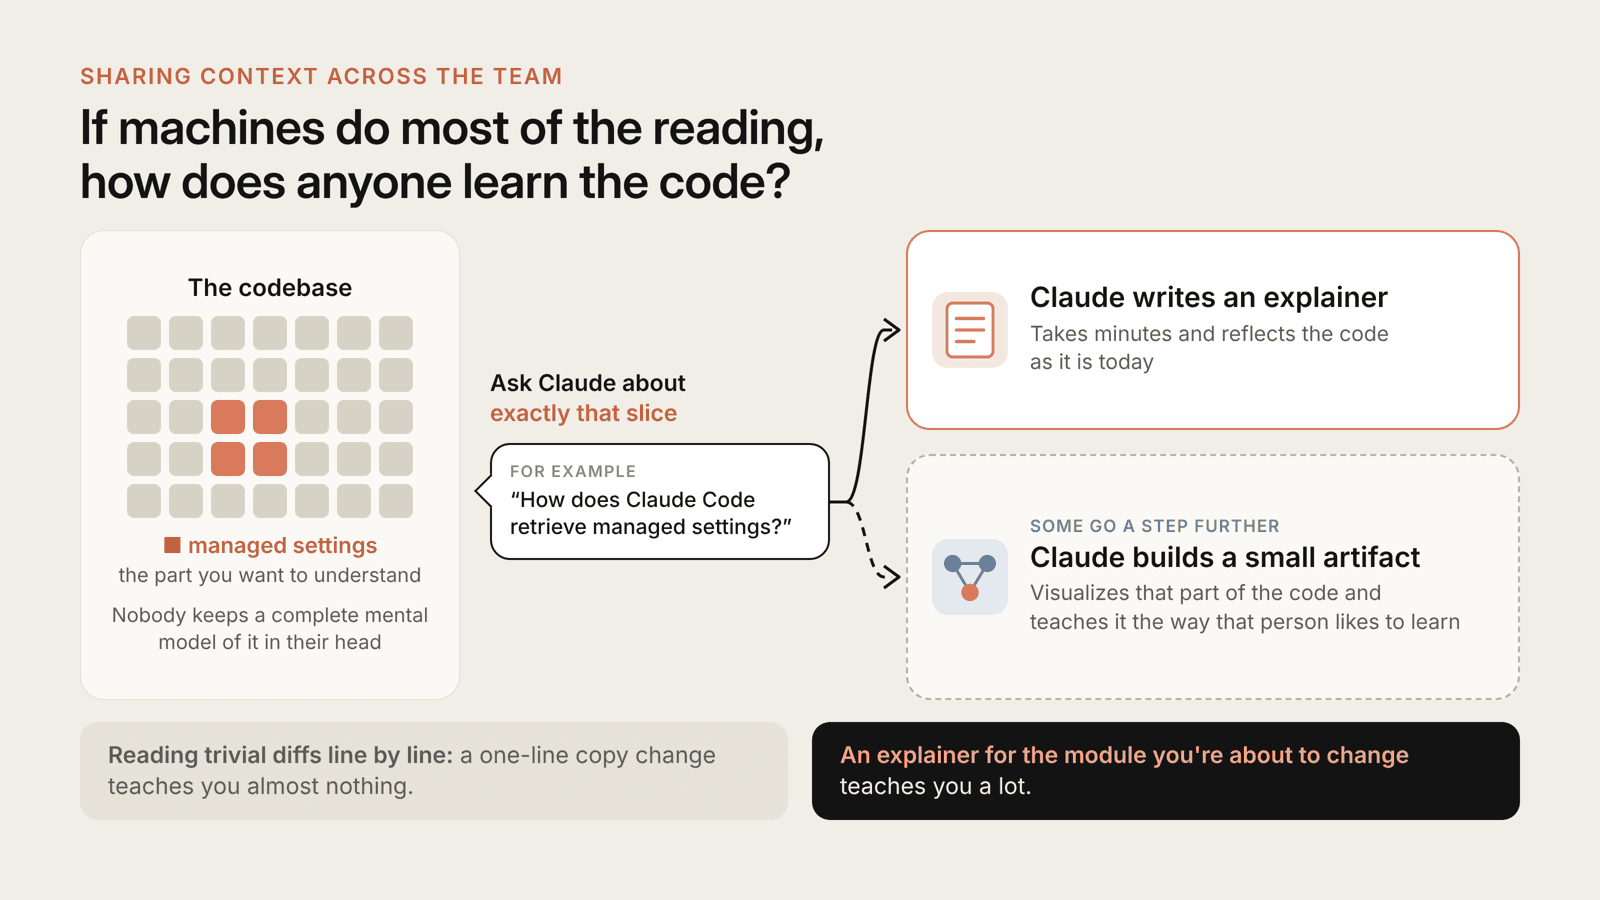
3. 评审的第二个工作:没人读 diff 了,团队怎么共享理解?
机器读了大部分 diff 之后,团队成员怎么学习代码库?他们的答案很干脆:没有正式流程,也不要求任何人脑子里装着 Claude Code 的完整心智模型。想了解某块代码,就让 Claude 给那一小片写个 explainer——几分钟,反映的是今天的代码。有人更进一步,让 Claude 做个小 artifact,用自己喜欢的方式把那块代码可视化讲明白。
他们的论证是:一行文案改动逐行读,几乎学不到东西;要改某个模块前读它的 explainer,学到的多得多。再加上默认在公开 Slack 频道工作,看得见别人在造什么,质量就不会因为"每行没设门禁"而滑坡。
对照组:Geoffrey Huntley 的 pre-commit hook
几乎同一时间(10 月中旬),独立开发者 Geoffrey Huntley 在他的长文《agency》中记录了一套更极端的个人实践,正好和 Anthropic 的官方路线形成对照。
Huntley 的做法是:写一个 pre-commit hook,用确定性脚本检查 git diff——有没有绕过他的诊断库(diagnostics library,封装 OTel 和结构化日志的模式)、直接调用可观测模块的代码。一旦发现,commit 失败,同时注入一段 prompt 要求 agent 改用诊断库。他的原话是:"All of a sudden it's ten out of ten."(十次里十次,全中。)
有意思的是他为什么不用更"正规"的做法:他说也可以去更新 AGENTS.md,但那里面"还有 delta,而且会漂移(drift)"。Skill pack、AGENTS.md、MCP 都是概率性的——"I swear it's astrology for software engineers"(我发誓这就是软件工程师的占星术)。写在那儿的东西读起来很对,但没有任何保证它真的起作用。真正不是占星术的是工程:确定性的检查,失败就拦,拦了就注入纠正指令。他把这套叫"Danger Systems in the loop"——向十几年前的 Danger(在 CI 里自动化"REST 层不许耦合 SQL 层"这类架构检查)致敬,架构约束,亘古如此。
这两条路线其实不矛盾,而是同一答案的两种刻度:Anthropic 把"反复出现的问题修在源头"写进了流程(skill、lint、instruction 文件),Huntley 则把"源头"推到了极致——连 instruction 文件都不信,直接上确定性 hook。对一人 vibe 团队来说,Huntley 的版本反而更趁手:你不需要六层流水线,但你需要一两个"绝不妥协"的确定性检查。想想你的项目里什么是"诊断库"——是 API 必须走统一封装?是所有外部调用必须有超时?是 secrets 绝不进代码?把这些写成 pre-commit hook 里几十行的确定性检查,比在 prompt 里写三段"请务必"管用十倍。这就是"十次里十次"的真正含义:约束要落在机器能强制执行的地方,而不是落在希望 agent 自觉的地方。
判断:评审正在从"人卡 agent"变成"agent 先审、人抽查+纠偏"
把两边的实践拼在一起,一个清晰的范式转移浮出来了:评审不再是"人类作为门禁卡住 agent 的输出",而是"agent 先审、人做抽查和纠偏"。Anthropic 的版本是六层流水线 + 风险定级 + 收敛机制;Huntley 的版本是确定性 hook + prompt 注入。共同点是:人类不再试图"看完",而是设计"看什么、拦什么、什么时候介入"的机制。
对国内一人 vibe 团队有三个可直接抄的动作,按投入从小到大:第一,写一个 pre-commit hook,把你最在乎的一两条铁律变成确定性检查(别超过三条,多了你自己都不想维护);第二,给 agent 立"验证闭环"的规矩——能跑的(测试、构建、截图)必须跑起来展示输出,不许口头说做完了,这是 Boris Cherny 说的"两到三倍"差距的来源;第三,如果你用 agent 互审,设三轮 cap,三轮没过就停下来换方案,别让它们通宵互啄。
以及一个反直觉的提醒:Anthropic 发现,让评审变好的最快方法不是调 prompt,而是"把反复出现的问题修在源头"——lint 规则、skill、instruction 文件。Huntley 更进一步:连 instruction 文件都会漂移,确定性检查才作数。两人的分歧只在"源头"推多远,共识是"别在评审环节反复救火"。下次你的 agent 第五次犯同一个错误,别再写更长的 prompt 了,写个 hook。
这条路通向哪里
产品层面,Code Review for Claude Code 已经在 Team 和 Enterprise 计划上 GA,/code-review 和 /security-review 本地可用——"评审流水线"正在变成开箱即用的商品。但 Anthropic 自己划了一条线:产品只发 findings,不发 approvals,批准 PR 依然是人类的决定;他们自己的仓库走得更远,允许低风险改动只靠自动检查合并,而这条线还在不断移动。
每次评审漏掉东西,他们问的不是"prompt 怎么写更好",而是"模型当时手里缺了什么信息",然后把补救放进 CLAUDE.md、skill 或新的检查。目标从头到尾没变:每个改动的更少人类时间,不比以前更多的 revert。
最后一个细节很 Anthropic:他们邀请"让 agent 开 PR 的团队"来分享——你们自动化了哪些检查、哪些还需要人、觉得他们哪里错了。这不是谦辞,是他们改进评审者的方法论本身:incident 变成 eval,每天跑一遍。评审系统自己,也在被评审。
延伸阅读:评审环节省下来的人类时间,应该花在"读懂代码"上。站内指南《读懂 AI 生成的代码:给"AI 写、你负责"时代的代码阅读术》给了六个实战方法(先拿地图再进城、diff 不超 300 行、不信任清单、交叉验证、每周代码散步),和本文的"什么时候值得读"正好拼成完整拼图。
评论 (0)
原始来源
相关文章
一周之内,GitHub 连推两项"默认安全":Actions workflow lockfile 公开预览(把每个 action 钉死到确切 commit,另有 Require lockfile 策略),以及推送保护开始默认拦截 Anthropic API 密钥。本文拆解 lockfile 的工作原理、GitHub"锁不等于安全"的诚实 caveat,以及给 vibe coder 的 CI 安全清单。
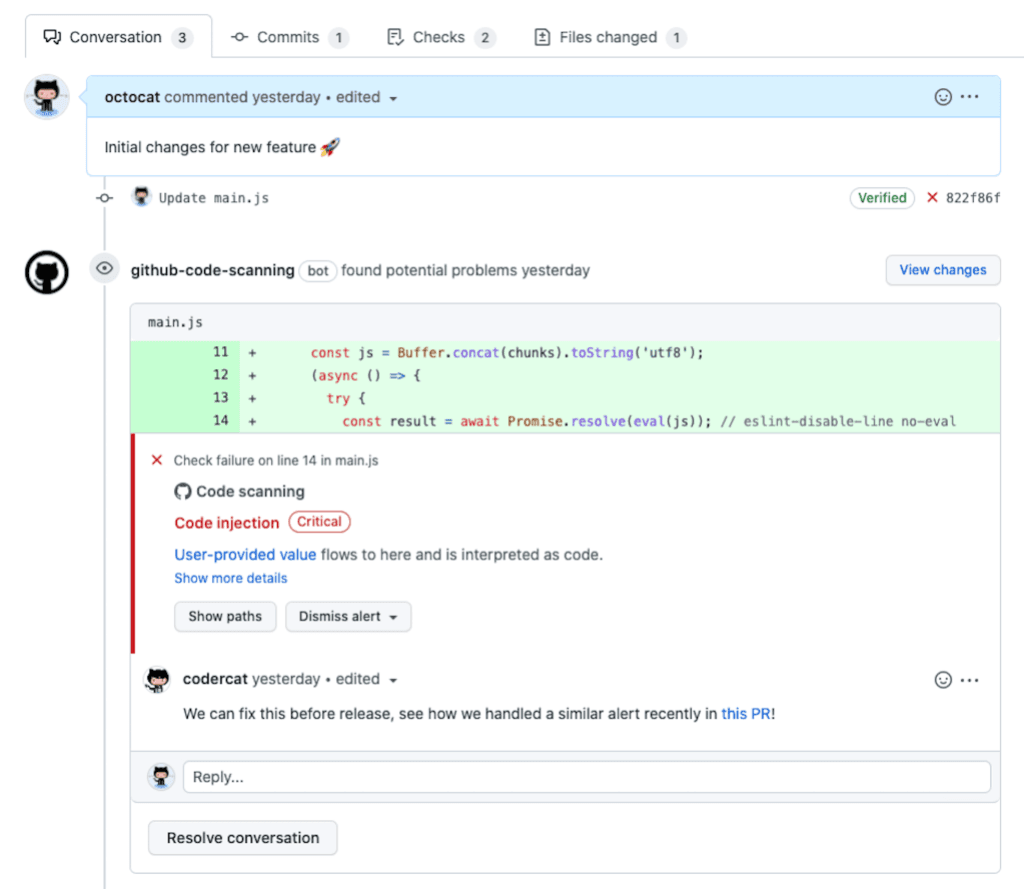
10 月 15 日,GitHub 宣布 AI Scan for pull requests 正式可用:覆盖 PHP、Shell、Terraform、Dockerfile 等 CodeQL 不支持的语言,且不需要 Copilot 许可证。但它的发现是纯建议性质——不能 fail 检查、不能拦合并;计费走独立的 Code Security AI Credits。本文拆解它的能力边界、计费规则与新上线的管理员看板。
清华 THUNLP 联合面壁智能、OpenBMB 推出 PilotDeck 2.0(AGPL-3.0):WorkSpace 隔离终结上下文污染、白盒记忆可查可改可回滚、Always-on 后台常驻执行;智能路由“主强子弱”架构让 7 个高难度任务以 3.15 美元跑出 70.6 分,反超 18.36 美元的纯顶配方案。