下周你的 Codex 会变样:0.161 上线会话内 MCP 登录,GPT-5.5 10 月 14 日退役倒计时
Codex CLI 0.161.0 带来会话内 MCP 登录、Bedrock 新能力与 Daybreak 显式 opt-in;GPT-5.5 将于 10 月 14 日从全计划 Codex 退役。本文拆解四个实锤更新,并给出 10 月 14 日前的迁移 checklist:从 grep 扫配置到 pin 死模型,一项项打勾。
距离 10 月 14 日只剩不到 3 天。如果你每天用 Codex 写代码,下周打开终端时可能会发现两件事:一个陪你写了很久的老模型名字彻底消失了,而 CLI 本身也刚刚换了一副新面孔。Codex CLI 0.161.0 在 10 月 7 日发布,带来了会话内 MCP 登录、Amazon Bedrock 的新能力,以及把 Daybreak 改成显式 opt-in;而 GPT-5.5 的退役倒计时,正在 10 月 14 日那个日期上滴答作响。
对 vibe coding 用户来说,最可怕的从来不是"模型变强了",而是"默认模型被换了、旧模型被拔了"——你的定时任务、自定义 agent、CI 脚本里,可能还藏着一个即将失效的模型名字。这篇是实务预警:先把四个实锤更新讲清楚,再给你一份 10 月 14 日之前可以逐项打勾的迁移清单。
口径说明:这篇的消息源是什么
先透明交代一句:OpenAI 官方博客在本轮没有发布相关博文。本文事实来自三处——官方文档 changelog(learn.chatgpt.com/docs/changelog)的第三方梳理、Codex CLI 0.161.0 GitHub release notes 的第三方报道,以及一篇基于官方文档逐条核对的迁移避坑分析。凡正文标"据报道"或"据梳理"之处,均为第三方转述,我已交叉核对过三方口径的一致性;凡标"官方文档口径"的,是转述中明确引用的文档说法。价格数字($2 / $10)同样来自官方文档 changelog 的转述,下文会标注来源。
先把时间线说清楚
- 9 月 29 日:gpt-6.1-sol 随 Codex CLI 0.159.1 一起把默认模型的位置拿下,定价为每百万 token 输入 $2、输出 $10,支持最长 272K 输入 token(来源:官方文档 changelog,经第三方梳理)。
- 10 月 7 日:Codex CLI 0.161.0(rust-v0.161.0)发布。
- 10 月 8 日:Ultrafast 模式与更快的 steering 上线(桌面端 follow-up 干预更快)。
- 10 月 14 日:GPT-5.5 从 Codex 退役,覆盖 ChatGPT 全计划。
注意第一条和第二条的关系,后面会专门澄清一个很容易写错的点。先记住结论:0.161 没有换默认模型。
GPT-5.5 退役:真正受影响的是哪条登录链
退役范围是:ChatGPT、ChatGPT Work 与 Codex 上的 GPT-5.5,覆盖全部计划——包括 Business、Enterprise 和 Edu。关键限定只有一条:它只影响用 ChatGPT 账号登录(ChatGPT sign-in)的 Codex,不影响 OpenAI API。官方的工作区模型可用性说明写得很直白:ChatGPT 工作区里的模型设置,不会自动沿用到 OpenAI API。
这条限定在实务中意味着,你得先把自己所有的 Codex 入口列出来,在每个入口旁边标注鉴权方式,再决定谁在 10 月 14 日的倒计时之内:
- 笔记本上的 CLI,如果是 ChatGPT 登录——在倒计时内,优先处理。
- GitHub Action 里用
openai-api-key的 Codex 步骤——走的是 API 组织与项目的模型配额,不受影响。 - 私有 CI runner 上用 Codex access token 的任务——它跑的是你的 ChatGPT 工作区身份,受影响,别因为"在服务器上"就漏掉。
- 桌面端侧边栏 Scheduled 里的定时任务——它们不在你的 dotfiles 里,grep 扫不到,必须逐条点开看模型设置。
Enterprise 和 Edu 的团队还有一层:GPT-6 系模型在企业工作区是默认关闭的,GPT-6.1 Sol 也一样,要管理员先开通。本地 config.toml 里写了新模型名字,不等于你有权限用它。更隐蔽的是托管配置(managed configuration,例如 Linux/macOS 上的 /etc/codex/managed_config.toml 或 macOS 的 MDM 描述文件):托管默认值在启动时会覆盖你的本地配置和命令行 --config 覆盖。如果管理员在那里面 pin 了 gpt-5.5,你本地改一百遍,重启一次就被打回原形——这个得找管理员在托管层修。
0.161.0 的四个实锤更新
1. 会话内 MCP 登录:/mcp login <name>
这是 0.161.0 最实在的一个功能:不用退出当前终端会话,直接在会话里给指定的 MCP server 做登录。同版本还更新了鉴权说明——不再暗示凭证一定躺在 auth.json 里,而是把 keyring 存储纳入了说明。对 MCP 重度用户来说,这意味着 MCP 的登录态管理终于跟上了"常驻终端"的工作流:以前切 server 要折腾配置,现在一条命令解决。
2. Amazon Bedrock:multi-agent V2、Ultra reasoning、GovCloud
Bedrock 侧这次加了 multi-agent V2 与 Ultra reasoning(兼容模型未在 notes 里点名),Bedrock Mantle 开始接受 AWS GovCloud 区域。走 Bedrock 通道的团队可以评估这两项能力是否值得切过去,但注意"兼容模型未点名"——上线前先在自己的模型上实测,别默认全量可用。
3. Daybreak 改为显式 opt-in
Daybreak 在 CLI 上现在是显式 opt-in:只有 --enable cli_daybreak 或 features.cli_daybreak=true 能打开它,写 daybreak=true 是不够的。默认状态下,Daybreak 的控件和指示器全部隐藏,/daybreak 不可用,自动 Cyber routing 会被省略——即使是之前保存过的 Daybreak threads 也一样。已保存的偏好本身还在,只是不会被自动启用。
需要按 turn 选择 Cyber 接入方案的话,可以用 codex exec --cyber-access-program,或 TypeScript SDK 里的 cyberAccessProgram 选项;而且即使 cli_daybreak 没开,这个显式 exec 覆盖依然可用,也不会动你保存的选择。实务含义:Daybreak 从"默认在场"变成了"你明确点头它才出现",安全边界更清晰了,但以前依赖它自动路由的工作流要检查一下。
4. 语音设备选择本地化,外加一批修复
语音对话现在可以选麦克风、扬声器和麦克风输入通道,偏好存在本地。修复项里有几条值得单拎出来说,因为它们直接改变"点 Approve 时你在授权什么":
- approved filesystem escalation 的写权限放宽了:一次批准的文件系统提权,现在能授予更广的写访问,但被拒绝的读取和网络限制依然保留。翻译一下:你点"Approve"时,授权范围比上周大了,审批提示要重新读一遍,别凭肌肉记忆点。
- background tasks 保留发起它的那个 turn 的权限:后台任务不再随会话权限漂移,行为更可预测。
- 显式 launch 权限在终端重连和新会话后保留;隐式客户端设置不再覆盖 server 端或已保存 thread 的 web-search 设置。
- Windows 提权终端可用内嵌 server 启动,沙盒 PowerShell 在受保护用户配置下保留相对路径;启动时更早发现可恢复的 SQLite 损坏并把坏库留作备份;响应重试与 WebSocket-to-HTTP 降级开始遵循服务端的 retry 指引,过载时 premature failure 会减少。
0.161 升级实操:升级之后先验三件事
0.161.0 本身是一次常规升级,但叠加上面这些变化,建议按这个顺序走一遍:多花十分钟,少踩三天坑。
- 先升级,再看默认模型。升级完第一件事是敲
/model,确认当前默认。从没 pin 过模型的,你已经在 GPT-6.1 Sol 上;pin 过gpt-5.5的,升级不会替你改,10 月 14 日之前必须手动换掉。 - 重读 approval 提示,跑一遍 MCP 登录。filesystem escalation 的授权范围变大了,升级后第一次点 Approve 时别凭肌肉记忆;MCP 用户跑一遍
/mcp login <name>,确认登录态正常,顺手核对 keyring 里存的是你预期的那套凭证。 - 确认 Daybreak 的状态。以前用过 Daybreak 的,升级后会发现它的控件和指示器都不见了——这是预期的新默认,不是 bug。还需要的,用
--enable cli_daybreak显式打开;不需要的,保持隐藏,攻击面更小。
release notes 里还有两条容易被忽略的运维向修复,值得单独提一句:启动时对 SQLite 损坏的检测提前了,坏库会被保留成备份而不是悄悄丢掉——如果你遇到过 Codex 启动后历史 thread 莫名消失的情况,0.161 之后这类问题的排查会顺得多;thread resume 现在会带上最新已提交的历史记录,断线重连回来上下文更完整。这两条不改变功能,但改变了你凌晨三点排查问题的手感。
还有一条是给 Windows 用户的:提权终端会话现在可以用内嵌 server 启动,沙盒 PowerShell 在受保护用户配置下保留相对路径。之前在 Windows 上被路径问题折磨过的,可以升级后验证一下:以前绕过的那几个脚本,是不是能直跑了。
一句必须的澄清:GPT-6.1 Sol 的"默认"到底是什么时候换的
这是最容易写错、也最容易误导读者的一个点,所以单独说:GPT-6.1 Sol 成为默认模型这件事,发生在 0.159.1(9 月 29 日,随模型发布),不是 0.161.0。0.161.0 的 release notes 里只是重复列出了这一条——"在捆绑目录和 Amazon Bedrock 目录中,GPT-6.1 Sol 为默认模型"。第三方梳理里那个"从发布到成为默认:8 天"的计分,起算点也是 9 月 29 日。
所以正确的理解是:0.161 没有"新切换"任何默认模型,它只是确认 GPT-6.1 Sol 依然坐在默认位置上。对你来说真正要做的只有一件事:打开终端敲 /model 看一眼。如果你从没 pin 过模型,你现在已经在 GPT-6.1 Sol 上了;如果你是 Enterprise/Edu 用户而管理员还没开通,那你要做的不是改配置,是去找管理员。
迁移前先查这七处:退役避坑清单
下面这份清单改写自一篇逐条对照官方文档的迁移分析,七个坑每一个都对应一个真实会炸的场景。建议按顺序过一遍,10 月 14 日之前做完。
坑一:没分清每条工作流走哪种登录
先列入口、再标鉴权方式(见上文"哪条登录链"一节)。只有 ChatGPT sign-in 的在倒计时内,API key 的不受影响。最危险的是"看起来在服务器上所以很稳"的私有 runner——它拿的是你的 ChatGPT 工作区身份,一样会炸。
坑二:只改了 model picker
picker 只改一处。官方 checklist 要求替换 gpt-5.5 的地方包括:工作区默认值、已保存的模型设置、托管配置、自定义 agent、定时任务,以及任何选模型的脚本。本地通常意味着这几处:
~/.codex/config.toml里的model,以及项目级.codex/config.toml;- profile 文件,比如
~/.codex/deep-review.config.toml(codex --profile deep-review会把它叠加到基础配置上)。注意:从 Codex 0.134.0 起,--profile不再读取config.toml里的[profiles.name]表——如果你 grep 出来还有这种旧表,它已经是死配置了,把还需要的设置搬到独立的 profile 文件里; ~/.codex/agents/或.codex/agents/下的自定义 agent 文件,以及[agents]下的agents.default_subagent_model;- shell 脚本和 CI 步骤里
codex exec -m gpt-5.5这种写法。
一条命令能扫掉大部分:
grep -rn "gpt-5\.5" ~/.codex .codex scripts .github 2>/dev/nullgrep 扫不到的两处要手动查:桌面端 Scheduled 里的定时任务(逐条点开看模型),以及上面提到的托管配置(找管理员)。
坑三:自动化里没把模型 pin 死
不设模型时 Codex 用"推荐模型",笔记本上没问题,但在无人值守的脚本里等于把命运交给下一次 CLI 更新——0.161.0 已经演示过一次"默认模型说变就变"。无人值守的一律显式 pin:
# ~/.codex/config.toml
model = "gpt-6.1-sol"
model_reasoning_effort = "medium"单次运行用命令行传:codex exec -m gpt-6.1-sol "Review the current changes"。用 GitHub Action 的话,它有 model、effort、codex-version 三个 input——codex-version 留空等于"永远最新",想要可复现的构建就把它也 pin 死。
坑四:以为改了本地配置就等于开通了权限
Enterprise/Edu 团队重灾区:GPT-6.1 Sol 在这些工作区默认关闭,管理员不开通,你本地写什么都没用;托管默认值还会覆盖本地配置。这个坑的修复人永远是管理员,不是你。
坑五:reasoning effort 照搬旧值
模型换代时,reasoning effort 的档位不是一一对应的,官方文档明确建议先降一档跑个熟悉的任务试试。建议起点:GPT-6.1 Sol 用客户端默认值,Luna 用 high,Astra 用 Light(在 config 里就是 low)。自定义 agent 还有个连带坑:agent 文件如果只设了 model 没设 effort,它会沿用生成请求里已经解析好的 effort——新模型不支持那档就再补一个 model_reasoning_effort,两个字段一起写全,例如:
# .codex/agents/reviewer.toml
name = "reviewer"
description = "PR reviewer focused on correctness, security, and missing tests."
model = "gpt-6.1-sol"
model_reasoning_effort = "medium"
sandbox_mode = "read-only"
坑六:一上来就把速度档开到最大
新模型手感不对时,第一反应往往是把所有旋钮拧满,但官方的速度文档是反着说的:大多数任务不需要 Max 或 Ultra——Ultra 会把部分任务交给 subagent,而 subagent 工作流的 token 消耗比同等单 agent 运行更高。价格表也很实在:
- Fast(CLI 里
/fast):消耗 included 额度,速率为 Standard 的 2.5 倍; - Ultrafast:支持 GPT-6 Astra 与 GPT-6.1 Sol,included 额度按 8 倍消耗、credits 按 6 倍计费,仅 Pro $500 与部分 Enterprise/Edu 计划可用,企业工作区默认关闭;API 用户则通过 Responses API 里
gpt-6.1-sol配service_tier: "ultrafast"单独调用。
合理顺序:先把模型和 effort 调对,再只给那些"你真坐在屏幕前等"的任务加速度。
坑七:换了模型,但没用自己的真任务验过
配置干净不等于新模型适合你的活。挑两三个你最熟的任务——一次典型 bugfix、一条 review prompt、那个每晚跑的定时任务——在 10 月 14 日之前用替换模型各跑一遍,看 diff 和解释的质量,不只看"跑没跑完"。10 月 8 日上线的 faster steering 在这能帮上忙:桌面端里 steer 一个正在跑的任务现在落地更快,Settings → General → Follow-up behavior 里可以设 follow-up 是 steer 还是 queue,跑偏了早点纠正,不用等一个长任务跑完。
定价与替换模型:背景信息一笔
先说定价,因为这是很多人 pin 模型前最想知道的:gpt-6.1-sol 为每百万 token 输入 $2、输出 $10(来源:官方文档 changelog,经第三方梳理;输入上下文最长 272K token)。
退役指引里给的替换建议是:Plus、Pro、Business、Enterprise、Edu 走 GPT-6 Sol(gpt-6-sol),Free 和 Go 在桌面端走 GPT-6 Luna(gpt-6-luna);做复杂编码且账号已开通 6.1 的,直接上 GPT-6.1 Sol。如果不确定团队里每个人是否都已开通 6.1,gpt-6-sol 是更稳的公共默认——先保证 10 月 14 日不断档,再谈最优。
多说一句定价之外的账:Ultrafast 的 8 倍额度消耗,意味着它只适合"你坐在屏幕前等结果"的那类任务。夜间定时任务、CI 里的 review job,用 Standard 档慢慢跑更划算——速度档和模型选择是两笔独立的账,别混在一起算。
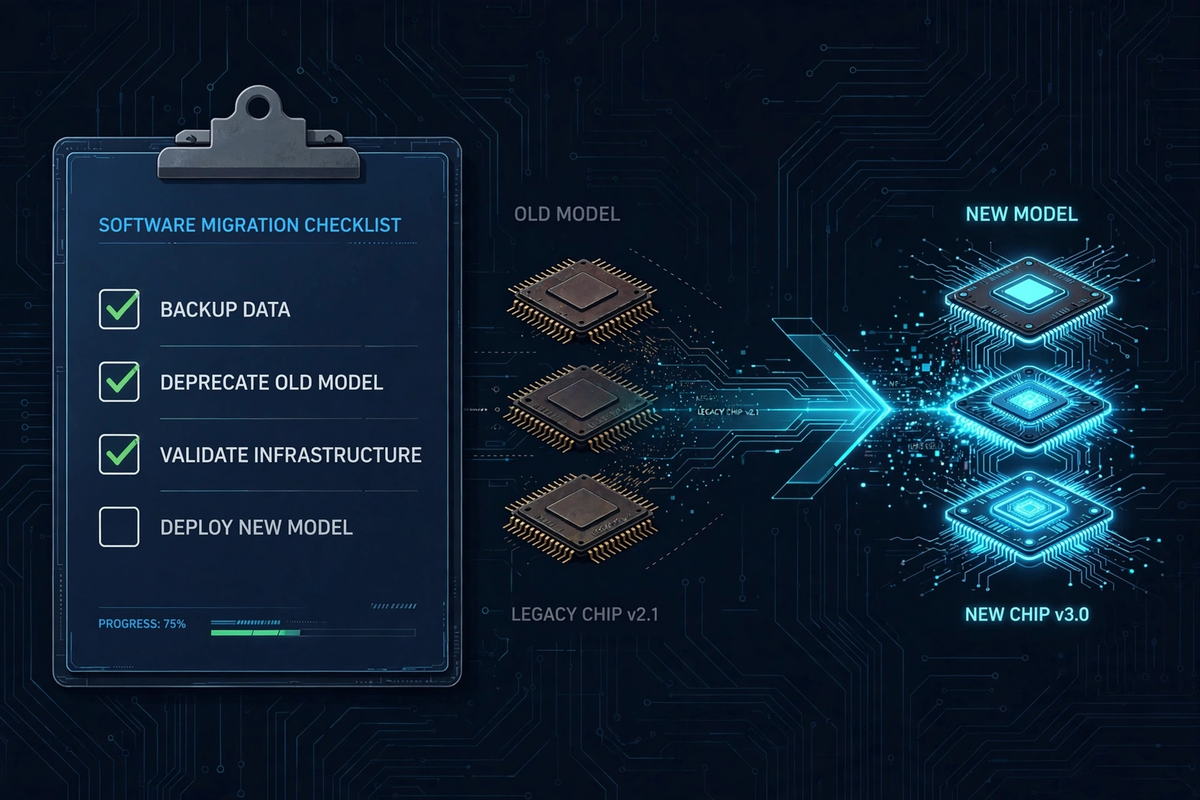
10 月 14 日前的执行清单(照着打勾)
- 列出所有 Codex 入口并标注鉴权方式,圈出 ChatGPT sign-in 的那些。
- 跑
grep -rn "gpt-5\.5" ~/.codex .codex scripts .github,逐条替换;桌面端 Scheduled 定时任务逐条点开确认。 - 检查
[profiles.name]旧表残留(0.134.0 起已失效),有用的设置搬到独立 profile 文件。 - 所有无人值守任务 pin 死模型(建议
gpt-6.1-sol或gpt-6-sol),GitHub Action 额外 pincodex-version。 - Enterprise/Edu:确认管理员已开通替换模型;检查托管配置里是否还 pin 着
gpt-5.5。 - reasoning effort 别照搬:先降一档,用熟悉任务试跑;自定义 agent 把
model和model_reasoning_effort写全。 - 升级到 0.161.0 后重读一遍 approval 提示(filesystem escalation 授权范围变大了),需要 MCP 登录的跑一遍
/mcp login <name>,Daybreak 用户确认 opt-in 状态。 - 10 月 14 日前,用替换模型把两三个核心任务真实跑一遍。
两类用户的额外检查:Bedrock 与 Daybreak
走 Amazon Bedrock 通道的团队,0.161 之后可以评估 multi-agent V2 与 Ultra reasoning 是否值得切过去——但 release notes 没有点名兼容模型,先在 staging 环境用自己的模型实测一轮,确认行为符合预期再上生产。GovCloud 区域的支持则是合规敏感团队的好消息:之前因为区域限制走不了 Bedrock Mantle 的,现在可以重新评估架构。
Daybreak 用户注意行为变化:opt-in 之后,已保存的 Daybreak threads 不会自动走 Cyber routing,控件默认隐藏。如果你之前的工作流依赖"打开 CLI 就自动进入 Daybreak 上下文",升级后会发现 /daybreak 不可用——这不是故障,是新的默认。按 turn 需要不同 Cyber 接入方案的,用 codex exec --cyber-access-program 显式指定,反而比依赖全局默认更可控。建议把这条写进团队的升级公告里,免得有人以为是 regression 去提工单。
和 9 月那篇综述的区别
如果你读过本站 9 月的 codex-cli-september-releases(Codex CLI 9 月版本综述),那篇讲的是版本流水线——0.159 系列一路走来的变化。这篇的角度完全不同:它是一篇倒计时实务预警,只盯两个东西——10 月 14 日这一个 deadline,和 0.161.0 这一个版本里你必须动手改的配置。读完 9 月那篇你知道"发生了什么",读完这篇你知道"周三之前要改什么"。
以及一句提醒:9 月综述里提到的不少"即将到来",在 0.161 里已经落地或改了默认行为(Daybreak 的 opt-in 就是一例)。如果你是按 9 月那篇做的配置,建议用本文的清单重新对一遍,重点看 Daybreak 和模型 pin 这两处。
最后再说一句:模型退役这种事,无聊到你觉得不值得专门处理——直到某个凌晨 3 点的定时任务因为请求了一个不存在的模型而失败。趁还有 3 天,把清单过一遍。
评论 (0)
原始来源
相关文章
Google 在 10 月 9 日的 release notes 公告中宣布:Gemini Code Assist Standard 与 Enterprise 新订阅即日起停售,现有订阅 2026 年内照常自动续费、2027 年起终止。从 6 月个人版停服、9 月控制台限售到 10 月全面停售,Google 用五个月把 AI 编程工具收编进 Antigravity 企业 Agent 平台。单品 AI 编程工具的时代正在落幕,独立开发者的选型逻辑被迫从“比单品”改写为“选生态”。
微软自研代码模型 MAI-Code-1.1-Flash 推出本地版:3-bit 量化、256K 上下文全保留,本地调用零推理费,但官方推荐 120GB 以上内存。第三方实测显示量化版 SWE-Bench Verified 得分 70.80%,仅比全精度版低 1.8 个点。“零推理费”对独立开发者的真实含义是什么?Copilot 的路由器才是真正的护城河。
联想天禧 AI 自研代码智能体框架 TianxiCode 搭配 DeepSeek-v4.1-Flash,在 SWE-bench-Live Lite 分榜以 71% 解决率登顶全球第一,并通过官方 Verified 审核。本文解读这项“真实工程”评测为何更难、“框架>模型”论点的含金量,以及它给 vibe coding 实践者的三点启示。