Codex 学会“抢答”了:Composer predictions 预测你的下一条指令,Tab 一下继续干活
Codex 桌面端 beta 上线 Composer predictions:每次回复结束后,输入框可能浮现一条建议的下一句话,按 Tab 接受、review 后再手动发送。Beta 期间免费且默认开启,它把心智负担从组织语言降级为校验判断——但建议永远只是建议。
从"补全代码"到"补全意图"
写代码的人早就习惯了 Tab 键。光标停在半截函数后面,灰色的代码建议浮现出来,按一下 Tab,几十行代码落地——GitHub Copilot 把这个动作训练成了肌肉记忆。但这一次,OpenAI 把 Tab 的领地往前推了一步:不再补全代码,而是补全你脑子里还没组织好的那句话。
北京时间 10 月 10 日凌晨,OpenAI 在发布说明里上线了一个不起眼但值得细品的 beta 功能:Composer predictions。Codex 回复结束后,输入框里可能会浮现一条"建议的下一句话"。按 Tab 接受,改一改,确认无误再发送。注意这个细节:接受不等于发送,人必须先 review。这是整个功能里最值得划线的一句话。
从交互史上看,这是一次迟到但必然的进化。搜索引擎有搜索建议,手机键盘有下一词预测,邮件客户端有智能回复——所有"人要往框里打字"的场景,最后都长出了预测层。AI 编程助手反而是最后一个补上这一课的:过去两年,所有的智能都堆在了"模型怎么回"上,没人认真想过"人接下来想说什么"。Composer predictions 把预测做到了 prompt 这一侧,补全的不再是代码 token,而是意图本身。
机制:它到底在预测什么
根据官方发布说明,预测的依据是"当前 Codex 线程中的对话上下文"(based on the conversation in your current Codex thread)。换句话说,它不是一个通用的"下一步操作猜测器",而是一个读过完整上下文的续写者:你刚才让 Codex 重构了登录模块,它可能建议"现在给重构后的模块补单元测试";你刚修完一个 bug,它可能建议"跑一下全量测试确认没有回归"。
交互流程被设计得很克制,一共三步:
- 出现:Codex 回复结束后,建议可能出现在消息框里。注意官方用的是"may appear"——不是每轮都有,模型觉得有把握才开口。
- 接受:按 Tab 键,文本落入输入框。这时候它只是一段可编辑的草稿。
- 发送:你 review、修改,手动点发送。接受建议不会自动发送,这是写进发布说明的硬性保证。
这个"三段式"设计其实回答了一个关键问题:预测错了怎么办?答案是——错了就改,改完再发,或者直接无视。预测文本的地位被刻意压低:它是草稿,不是决策。OpenAI 显然吸取了早期"AI 自动执行"类功能翻车的教训,把最终拍板权牢牢留在人手里。
还有一个值得留意的措辞:官方说的是建议"可能"出现(may appear),而不是每轮必现。这意味着预测层内部有一个置信度门槛——模型觉得"这句我很有把握"才开口,没把握就保持沉默。这种"宁缺毋滥"的策略是对的:一个经常猜错的预测框只会训练用户无视它,而偶尔出现、次次靠谱的建议才能真正进入工作流。预测功能的第一课不是"猜得多",而是"猜得准"。对用户来说,这意味着当建议真的浮现时,它值得你多看一眼。
可用范围与开关:先看你有没有资格
这次 beta 的门槛列得很细,照官方原文整理如下:
- 用户:年满 18 岁的个人 ChatGPT Pro 用户,各支持地区可用。注意"个人"二字——企业版、教育版不在这次 beta 范围内。
- 客户端:最新版 Codex 桌面 app。网页版、CLI 暂时没有。
- 线程类型:本地(local)和 SSH 线程。云端线程不在支持列表里。
- 模型:限定 GPT-6 Astra 或 GPT-6.1 Sol。用别的模型,预测不会出现。
功能默认开启。想关掉的话,路径是 Settings → General → Composer,把 Show predictions 关掉就行。默认开启这个选择本身就有信息量:OpenAI 对这个功能的完成度相当有信心,敢让它直接面对所有符合条件的 Pro 用户,而不是藏在实验开关后面等人去挖。
Beta 期间免费:但要看清计费边界
价格是这类功能最容易产生误解的地方,官方这次把话说得很死,分两层:
- 生成预测不花钱:beta 期间,生成预测不计入 Codex 用量限制,也不消耗 credits。模型在后台帮你"想下一句",这部分 token 不走你的账。
- 发出去的消息正常计费:一旦你按了发送——包括接受了预测之后发出去的——就按正常的 Codex 用量限制和计费规则走。
这个计费设计很聪明。它把"AI 的思考"和"人的决策"做了财务上的切割:预测是 OpenAI 请客,因为那是它在主动提供服务;发送是你的动作,所以你买单。对用户来说,beta 期就是零成本试用;对 OpenAI 来说,这是用免费额度换真实交互数据,打磨预测质量。等 beta 结束,预测生成的成本大概率会被折进整体定价里——现在先养成习惯再说,这是标准的平台打法。
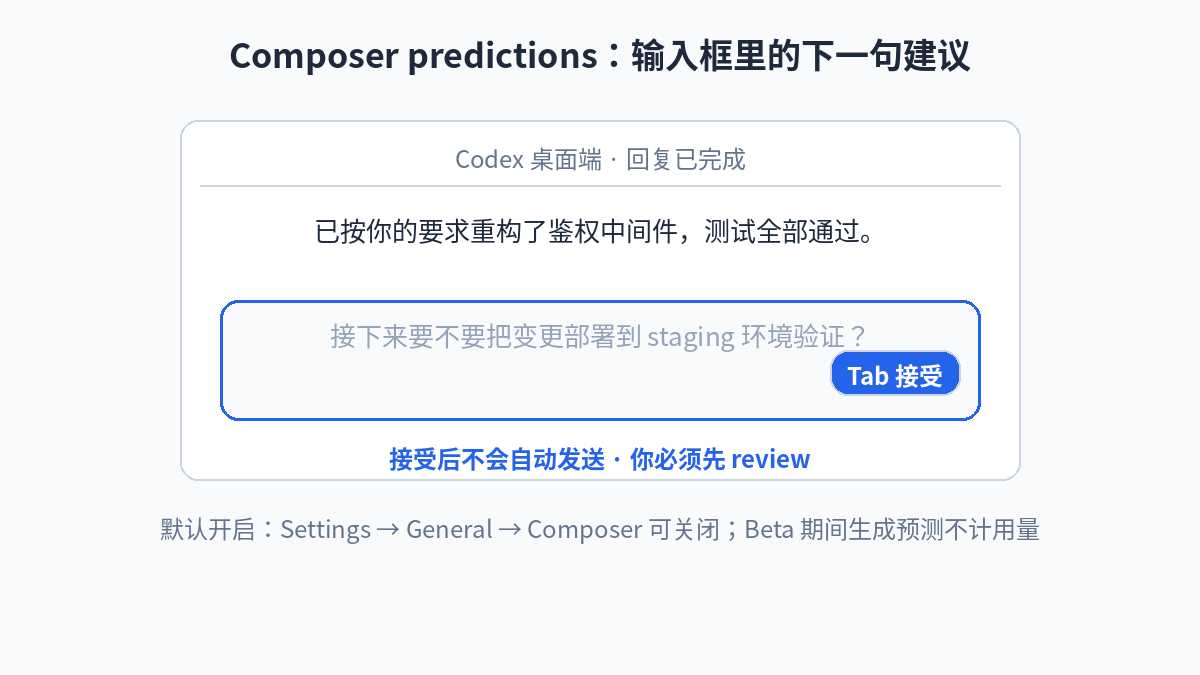 Codex 回复结束后,输入框浮现建议的下一句话,按 Tab 接受、review 后再发送
对 vibe coder 意味着什么
先说结论:这个功能对 vibe coder 的价值,可能比对专业程序员更大。原因很简单——vibe coding 的瓶颈从来不只在"模型写代码行不行",而在"你能不能把意图说清楚"。
回想一下你用 Codex(或者任何 AI 编程工具)的真实工作流:一轮回复结束,你盯着输入框,大脑里同时在跑三件事——刚才的结果有没有问题、下一步该干什么、这句话该怎么组织才能让模型听懂。第三件事是最隐形也最耗神的:把模糊的意图翻译成精确的指令,本身就是一种心智负担。很多人没意识到,自己每天花在"措辞"上的精力,一点不比看代码少。
Composer predictions 恰好切掉了这第三件事。当模型根据完整上下文替你把下一句组织好,你的工作从"从零措辞"降级为"判断这句话对不对、改几个词"。这不是省了几秒钟打字时间,而是把认知负荷从"生成"降到了"校验"——而校验恰恰是人相对擅长、AI 相对不擅长的事。这个分工变化,才是功能真正的含金量。
但硬币的另一面同样要看清。建议不等于指令,这句话值得在脑子里钉死。预测文本看起来越像你想说的,你越容易滑过去不 review,直接 Tab+回车连击。有经验的 vibe coder 都知道,AI 编程里最贵的 bug 往往不是模型写错了,而是人没看清就让它继续了。预测功能把"继续"做得越顺滑,这个风险就越大。我的判断是:把 Tab 当成"省打字的快捷键"用可以,把它当成"不用想的自动驾驶"用,早晚要翻车。
还有一个更深层的变化值得玩味。当预测开始替你说出"下一步",它其实在悄悄塑造你的工作流:你会倾向于走它建议的那条路,因为那条路最省力。长期看,这可能让一部分人的开发路径趋同——大家都沿着模型最擅长的那几条" happy path"走。这对效率是好事,对多样性未必。vibe coder 的核心竞争力恰恰是"奇怪的想法 + 快速验证",如果连"下一步想什么"都外包给了预测,那个"奇怪"可能会被磨平。保持一点刻意的"不听话",可能是这个功能时代最重要的习惯。
放在"28 天连发"里看:小步快走的注脚
这个功能是 OpenAI 那场"28 天连续发布"中的一天更新。和之前几天的大模型、API 更新相比,Composer predictions 显得很小——没有新模型,没有新定价,就是一个输入框里的小建议。但恰恰是这种"小",说明了这场连发的真实成色:它不全是憋大招,也包括这种打磨交互细节的日常 shipping。
从产品史的角度看,这类"小功能"往往比大模型发布更能改变人的日常习惯。GPT-6 Astra 再强,你一个月可能也只在几次关键任务里感受到;而一个输入框里的 Tab 建议,你每天要按几十次。改变发生的地方不在发布会,在肌肉记忆里。OpenAI 显然也明白这一点:预测默认开启、beta 免费、关闭路径藏得不深不浅——这是一套标准的"习惯培养"组合拳。
对比一下友商的动作也很有意思。Cursor 的 Tab 补全、Copilot 的 next edit suggestions,走的都是"预测代码"路线;OpenAI 这次直接跳到了"预测意图",把战场从编辑器内部搬到了对话层。这暗示了一个判断:在 OpenAI 的产品观里,Codex 的核心交互面是 Composer 对话,而不是代码编辑器。代码只是对话的副产品,意图才是主战场。这个站位,决定了未来 Codex 会长成什么样子。
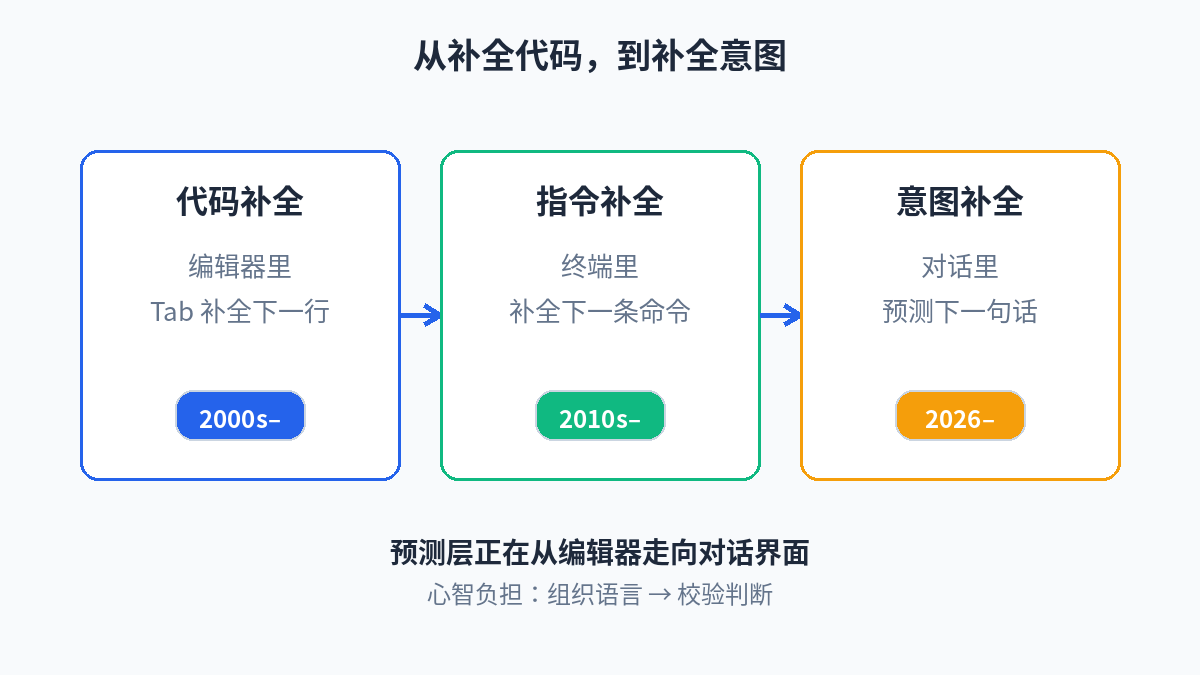 从补全代码到补全意图:预测层正在从编辑器走向对话界面
现在该做什么:三条实操建议
第一,符合条件的 Pro 用户可以直接开着用,beta 期零成本,不用白不用。但给自己定一条铁律:Tab 之后必须扫一眼再发送,哪怕只看三秒。把"review"变成和按 Tab 绑定的连招,而不是可选项。
第二,观察它猜错的时候。预测的质量方差本身就是信息:它总猜错的方向,说明你的工作流里有模型理解不了的跳跃性——那些地方恰恰是你作为人的独特价值所在,也是你写 prompt 最需要下功夫的地方。
第三,不符合条件的用户不用着急。beta 范围(个人 Pro、桌面端、local/SSH 线程、限定两个模型)说明这还在早期验证阶段。OpenAI 的惯例是:beta 跑顺了就会扩到 Plus、扩到网页端。现在可以先看看 Pro 用户的实测反馈,等 GA 了再决定要不要为它升级。
结语:Tab 键的下半场
Tab 键的上半场是补全代码,Codex 用 Composer predictions 踢开了下半场:补全意图。这听起来是个小功能,但它标志着 AI 编程助手的竞争维度变了——从"谁生成的代码更好"变成"谁更懂你下一步想干什么"。后者更难,也更接近"结对编程"的本质:好的搭档不只是手快,更是能接住你的思路,甚至抢先半步。
当然,抢答的前提是答对。预测文本再像人话,它也只是建议。Tab 可以按,脑子不能关——这句话在 AI 编程的每一个阶段都有效,在"AI 开始替你说话"的阶段尤其有效。
一句话总结:Codex 的 Composer predictions 把"下一句预测"做进了 prompt 输入框,beta 免费、默认开启、按 Tab 接受但必须手动发送;它省的不是打字时间,而是组织语言的心智负担——但建议永远只是建议,review 的习惯比功能本身更重要。
原始来源
相关文章
2026 年 10 月 8 日,Harness 宣布收购 Augment Code 部分资产,Cosmos 将变身“Harness Cosmos Software Factory Agent”。本文拆解这笔交易买了什么、软件工厂如何工作、Harness 的 agent-to-agent 闭环逻辑,以及它对 vibe coder 的启示。
Google Nano Banana 2.1 正式 GA:图片输出 token 砍半至 30 美元/百万(1K 图 0.0336 美元),但输入涨到 1.50 美元/百万。给每周生成 200 张图的典型 vibe 项目算月账,并附 Nano Banana 2 退场迁移 checklist。
2026 年 10 月 8 日,Anthropic 官宣 Claude Dashboards 与 Claude Motion 进入 beta:前者用自然语言提问直连公司数据生成实时看板,后者输出可编辑的代码而非视频生成模型的合成画面。同时 Docs、Slides、Design 全量转正,Claude 内已产出超 4500 万份文档与设计。本文拆解功能细节、企业开关坑与独立开发者的行动建议。