代码评审变成基础设施:Copilot 评审开放 API 调用,还给每次请求配了「用力档位」
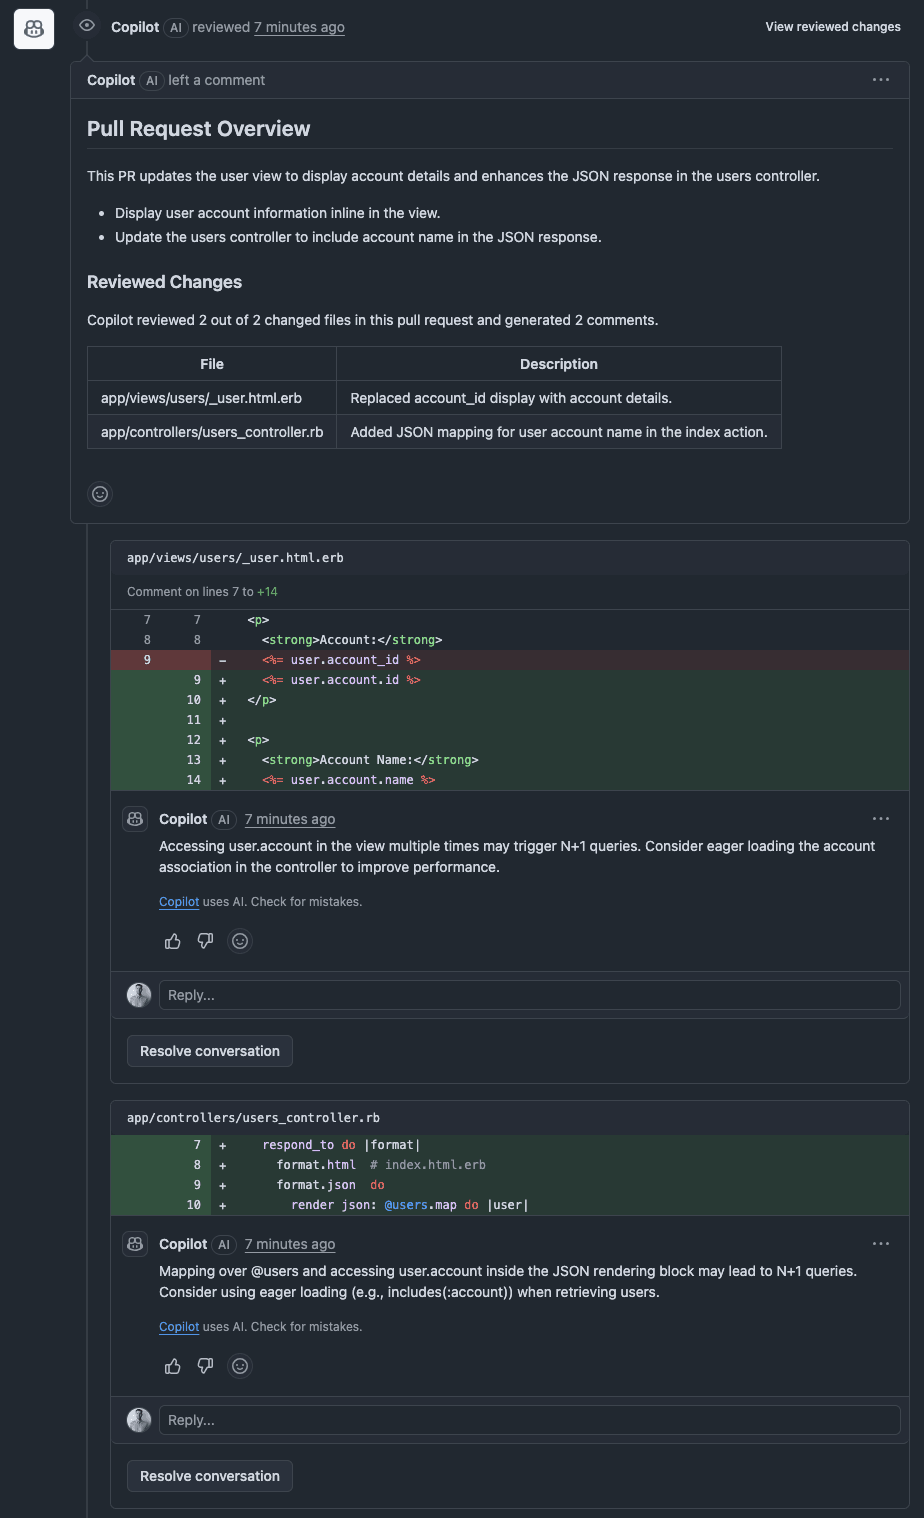
10 月 2 日,GitHub 在 changelog 里宣布:Copilot 代码评审现在可以通过 REST 和 GraphQL API 触发,还能为每次请求单独设定评审力度。同时,Balanced(均衡档)成为新的默认力度,替代了 Lite。这意味着代码评审从「编辑器里的按钮」变成了「流水线里可编排的一步」。
发生了什么:评审从按钮变成了 API
10 月 2 日的 GitHub changelog 宣布了两件事。第一,开发者现在可以通过 REST 和 GraphQL API 请求 Copilot 代码评审——评审不再只能从 GitHub 界面里点,而是能被你自己的脚本、工作流和内部工具触发。第二,每次请求都可以单独设定评审力度(effort level),Balanced 从 9 月 28 日起成为新的默认档,替代了之前的 Lite。
覆盖范围是全的:Copilot Pro、Pro+、Max、Business 和 Enterprise 全部可用。力度可以在四个层级配置——企业、组织、仓库、个人,下一级可以覆盖上一级。
为什么重要:评审的触发时机第一次变得可编程
这件事的真正含义不在「API」三个字,而在触发权的转移。以前,AI 评审是人主动点的:你觉得这个 PR 值得看,才点一下。现在,评审可以长在流程里——CI 跑完自动触发一次深度评审, dependabot 的 PR 触发一次轻量评审,深夜的紧急 hotfix 触发一次最高力度评审。
力度档位的意义也在这里。Lite 便宜但浅,Balanced 居中,更高的档位更贵但更细。把「用多少力」做成每次请求的参数,等于承认了一个现实:不是所有代码都值得同等力度的评审。改个文案和改支付逻辑,本来就不该用同一个标准。
冷静一下:API 不解决评审质量问题
有必要泼一盆冷水:能调 API 不等于评审变准了。评审的准确性、误报率、对业务上下文的理解,这些核心问题一个都没动。API 只是把「请求评审」这个动作自动化了,评审本身的质量天花板还在原地。
更实际的风险是滥用:既然能用脚本触发,就会有人给每个 commit 都触发一次最高力度评审,然后被账单和噪音淹没。我们的判断是——先想清楚触发策略,再写第一行调用代码。建议从窄开始:只给进入主分支的 PR 开自动评审,记录每次评审是由什么变更触发的、谁负责看结论,跑一个月再决定要不要扩大。
我们怎么看:vibe coder 的新玩具
对独立开发者,这次更新最有意思的不是企业级编排,而是「个人工作流可编程」。你可以在自己的 side project 里写个脚本:每次 push 后自动要一次评审,把结论发到你的 Telegram;或者给 AI 生成的大段代码自动触发一次严格评审——让 AI 审 AI 写的代码,听起来像套娃,但这是目前性价比最高的纠错组合。
代码评审正在从「人的习惯」变成「机器的流程」。习惯靠自觉,流程靠设计——而设计触发策略这件事,恰恰是 AI 替代不了你的部分。
原始来源
相关文章

10 月 3 日,Sites in ChatGPT 以约 209 点赞、218 评论冲上 HN 前页。这不是发布,而是一场清算:提示词直达 URL,到底是玩具、原型托管,还是生产力?四个争论焦点、文档实锤的技术事实(D1/R2、登录、自定义域名),以及给 vibe coder 的三个判断。

2026 年 10 月 7 日,Google Developers 发布 Developer Knowledge API 生态:Google Cloud、Firebase、Android 等官方文档变成程序化事实来源,配 gcloud CLI 入口、官方 Agent Skill(一行安装)、MCP server 和多语言客户端库。为什么「文档 API 化」能连根拔掉 vibe coding「模型记错 API」的经典翻车。
2026 年 9 月 30 日,Bitdefender 宣布 AI Guardian 进入公开 beta:给自主 AI Agent 加的安检门,每一次工具调用、文件访问、密钥使用都要先拿到 allowed / flagged / blocked 裁决。首批 macOS 独占、beta 期免费,支持 Claude Code 与 OpenClaw。为什么这道「Agent 行为防火墙」来得正是时候。