别再让 Agent 背过期文档写代码:Google 把官方文档变成 API,gcloud 一行查、Skill 一行装
2026 年 10 月 7 日,Google Developers 发布 Developer Knowledge API 生态:Google Cloud、Firebase、Android 等官方文档变成程序化事实来源,配 gcloud CLI 入口、官方 Agent Skill(一行安装)、MCP server 和多语言客户端库。为什么「文档 API 化」能连根拔掉 vibe coding「模型记错 API」的经典翻车。
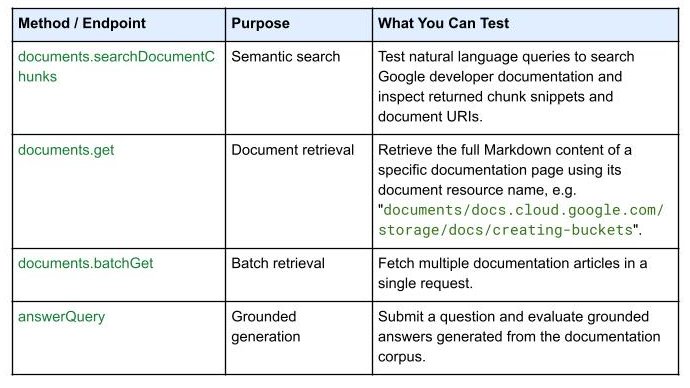
2026 年 10 月 7 日,Google Developers 官方博客宣布:Developer Knowledge API 生态——把 Google Cloud、Firebase、Android 等官方文档变成「程序化事实来源」的一整套工具:gcloud CLI 入口、官方 Agent Skill、API Explorer、多语言客户端库,外加一个独立的 MCP server。
这条新闻不刺激,但可能是本月对 vibe coder 长期价值最大的一条。因为它直击 vibe coding 最常见、也最隐蔽的翻车点:模型用「记忆中的旧 API」生成看似正确、实则跑不通的代码。以后,「先查官方文档」可以变成 Agent 工作流里的标准 skill——这是基础设施级的变化。
发布了什么:文档不再是网页,是 API
Developer Knowledge API 的官方定位很直白:Google 开发者文档的官方程序化事实来源,专为现代 AI Agent、IDE 插件和自动化工作流设计,用结构化 API 取代脆弱的网页爬虫,返回新鲜的 Markdown 格式文档。
几个关键特性:
1. 语义 + 关键词混合搜索,智能分块。 不是简单的全文检索,而是语义理解 + 关键词的混合召回,文档被切成合适的 chunk——这意味着 Agent 拿到的是「刚好够用的上下文」,而不是整页灌进 context 里烧 token。
2. 频繁重新索引。 上游文档更新后很快同步,Agent 读到的永远是新版。这才是「事实来源」三个字的含金量:爬虫方案最大的问题不是慢,而是你不知道它爬的是哪天的版本。
3. Grounded Q&A。 不只是检索,还能基于官方文档做带引用的问答——answerQuery 返回的答案带结构化引用追踪,每一句都有出处。vibe coder 都懂这意味着什么:Agent 再也不能用「我好像记得这个 API 是这样的」来糊弄你了。
四个入口:终端、Agent、浏览器、代码
Google 这次是一口气把四个入口全铺好了,覆盖 Agent 工作的所有场景:
入口一:gcloud CLI。 三个核心命令:
# 直接问出带出处的答案
gcloud developer-knowledge answer-query --query="How do I create a BigQuery dataset?"

# 搜文档片段
gcloud developer-knowledge documents search-chunks --query="Firestore transactions"

# 取某篇文档的元数据和内容
gcloud developer-knowledge documents describe "documents/docs.cloud.google.com/storage/docs/creating-buckets"

# 报错 trace 直接管道进去,做 grounded 排错
gcloud developer-knowledge answer-query --query="$(cat error.txt)"最后一个用法是神来之笔:把报错 trace 直接管道进查询。vibe coder 每天的真实场景——终端里一堆红色报错,以前是复制粘贴去问 AI(AI 再靠记忆瞎猜),现在是一行命令拿到基于官方文档的 grounded 答案。Cloud Shell 预装,标准 gcloud 安装开箱即用。
入口二:官方 Agent Skill,一行安装。
npx skills add google/skills --skill retrieving-developer-knowledge装完之后,你的 AI coding assistant 就知道怎么查 Google 官方文档了。兼容 Antigravity、Claude Code、Cursor、GitHub Copilot 以及自研 Agent 框架——注意这个名单:Google 没有只给自家 Antigravity 开小灶,而是全主流 Agent 通吃。这是聪明之举:文档 API 的价值在于被所有 Agent 调用,封闭起来就死了。
入口三:独立的 MCP server。 Developer Knowledge MCP server,skill 可以走 MCP 协议,也可以 fallback 到 REST API(curl)。——MCP 正在成为 Agent 接入能力的标准插槽,Google 直接给了官方实现。
入口四:多语言客户端库 + API Explorer。 C#、Go、Java、Node.js/TypeScript、PHP、Python、Ruby 全覆盖,API 操作包括 AnswerQuery、SearchDocumentChunks、GetDocument、BatchGetDocuments(单次批量最多取 20 篇文档)。API Explorer 提供零代码的交互式测试界面。
为什么这是基础设施级的变化:三个判断
第一,「过期知识」是 vibe coding 的系统性 bug,终于有系统性解法了。 想想你被坑过的场景:让 Agent 写 Firebase 代码,它用的是两年前 deprecated 的 API;让它配 Cloud Run,它记得的 flag 早就改名了。以前的解法是「你比 Agent 更懂,人工纠正」——这恰恰违背了 vibe coding 的初衷。现在的解法是:把「查最新文档」做成 Agent 的标准前置步骤,用 skill 机制固化下来。知识截止日期(knowledge cutoff)这个概念,正在被「实时文档 API」架空。
第二,skill 正在成为 Agent 能力的「包管理器」。 npx skills add 这个命令值得多看一眼——它和 npm install 是同一个手感。Agent 的能力扩展,正在从「写 prompt」走向「装 skill」:文档查询是一个 skill,代码审查可以是一个 skill,部署检查可以是一个 skill。vibe coder 要适应的新习惯是:给你的 Agent 配 skill 列表,就像给项目配 dependencies 一样。Google 官方带头做 skill,是在给这个生态定标准。
第三,大厂开始「为 Agent 而写文档」了。 官方博客的原话是「专为现代 AI Agent 设计」——文档的消费者不再只是人类开发者,还有 Agent。这意味着文档的写法会变:更多结构化、更多机器可读的元数据、更稳定的锚点。对独立开发者的启示是:你自己的产品文档,也该按「人类 + Agent 双读者」来写。你的 API 文档 Agent 能读懂吗?你的 README 有没有机器可解析的快速开始?Agent 时代,文档是获客渠道。
给 vibe coder 的行动清单
1. 今天就装这个 skill。 一行命令:npx skills add google/skills --skill retrieving-developer-knowledge。如果你用 Google Cloud/Firebase/Android 生态,这是零成本的准确率提升。从此你的 Agent 查文档不再靠记忆。
2. 把「先查文档」写进你的 Agent 工作流。 不只是 Google 的文档——给你的常用技术栈都配上类似的检索 skill(很多大厂在跟进)。在你的 AGENTS.md / 项目指令里加一条:「涉及 XX 生态的 API,先用文档 skill 确认最新用法,再写代码。」
3. 试试 trace 管道排错。 下次终端爆红,别急着复制粘贴问 AI——先跑 answer-query --query="$(cat error.txt)",对比一下 grounded 答案和纯记忆答案的质量差异。这个对比会改变你对「AI 排错」的信任模型。
4. 按「双读者」重写你的产品文档。 检查你的 README/API 文档:有没有清晰的结构化标题?快速开始能不能被机器一步步执行?错误码有没有机器可读的解释?——你的下一个用户可能不是人,是别人的 Agent。
被解决掉的经典翻车:三个真实场景
为了说明这不是纸面价值,具象化三个 vibe coder 都踩过的坑,以及这个 API 怎么拔掉它们:
场景一:deprecated API 的幽灵。 你让 Agent「用 Firebase 写个登录」,它唰唰写完,跑起来报 auth/invalid-api-key 一类的错。查半天发现:它用的是 Firebase v8 的命名空间写法,而你项目里是 v10 的模块化 API——模型训练数据里 v8 的代码更多,它「记得」了旧的。现在 skill 会先检索最新文档,v10 的写法直接作为上下文喂进去,幽灵 API 现形不了。
场景二:改名了的 flag。 gcloud run deploy 的某个 flag 在新版本改名了,Agent 按记忆生成旧 flag,部署失败,报错信息还语焉不详。以前你要人肉翻 release notes,现在 documents describe 直接取最新文档的准确参数表——机器读文档比人读 release notes 快 100 倍,还不会看漏。
场景三:批量迁移的文档地狱。 你要把 30 个 Cloud Functions 迁到 Cloud Run,每个函数的触发器配置、环境变量、权限模型都要查文档确认。以前是人肉开 30 个标签页,现在 BatchGetDocuments 一次取 20 篇文档,Agent 批量比对、批量生成迁移脚本——文档检索从「人的体力活」变成了「Agent 的 API 调用」,这才是「基础设施」的含义。
非 Google 生态用户:这事跟你也有关系
「我又不用 Google Cloud,这新闻跟我有什么关系?」——关系在于范式。Google 开了这个头,其他厂商跟进只是时间问题:AWS、Azure、Cloudflare 都有同样的动机(减少因文档过期导致的支持工单和用户流失)。已经能看到的苗头:各家都在推自己的 MCP server 和 agent skill,文档 API 化是顺水推舟的事。
更值得做的是举一反三:你今天就可以给自己的常用技术栈建「文档检索」习惯——不一定等官方 API。很多文档站有不错的搜索 API 或 sitemap,写一个简单的 skill(curl + 解析),效果能达到官方方案的 70%。核心思想就一句话:永远不要让 Agent 靠记忆写 API 调用。
一句话总结:当文档变成 API,「模型记错 API」这个 vibe coding 的经典翻车点就被连根拔掉了。Google 这次铺的不是一个功能,而是一块基础设施:四个入口、全 Agent 兼容、MCP 原生。装上 skill,让你的 Agent 从今天起只读新版文档——这可能是你今年花 10 秒钟能获得的最大准确率提升。
原始来源
相关文章

2026 年 10 月 8 日,Google Cloud 在 Gemini at Work 2026 大会上发布 Gemini agent:为工作而生的统一 Agent,拿目标自己规划、按任务在 Gemini 和 Claude 模型之间自动选择,并推出拥有独立邮箱、calendar 和通讯录席位的「同事 Agent」。四点判断:Agent 竞赛的下半场是「更像同事的 Agent」。
2026 年 10 月 7 日,GitHub 在 Changelog 宣布:Copilot CLI 1.0.94-0 起,/model 命令可发现本机 Ollama 里的模型,与云端模型并列可选。发现不等于自动接入,需手动确认;模型须支持工具调用与流式输出。同时官方预告了本地模型的智能路由,并明确:选本地模型不会关闭遥测,离线模式仍需显式设置 COPILOT_OFFLINE=true。
OutSystems 于 10 月 7 日在拉斯维加斯 World Tour 上宣布 Agent Experience 全面可用:把低代码平台开放给 Claude Code、Cursor、Codex、Kiro 等任意 AI 编程 Agent——Agent 在设计层面工作,平台确定性地生成代码,内置安全、自动测试与生命周期治理。这是「vibe coding 进企业」的标准剧本:对抗 shadow AI,给 Agent 一条合规的路。但 74% 的返工数据是厂商调研,要打折看;真正的账,是平台锁定的隐性成本。