Devin 学会"做梦":Cognition 给 Agent 记忆立了个开源标准
Cognition 给 Devin 上线 Memory 与 Dreaming,同时开源 Agent Memory Repo 标准:把 agent 记忆做成 git 仓库里的互链 Markdown 笔记,clone、search、update、push 四步循环。daily.dev 社区 172 条评论 45/40/15 分化,而这份标准正是"记忆插件 vs 文档派"之争的正方回应。
当所有人都在问"装什么记忆插件",Cognition 交出了一份反共识的答案
Agent 记忆是 2026 年下半年最拥挤的赛道:向量数据库、RAG 记忆插件、跨 session 上下文同步,每个厂商都在卖自己的"永不遗忘"方案。就在这个时间点,Cognition 做了一件反常识的事——它没有发布一个更强的私有记忆功能,而是把记忆本身变成了一个开放标准。
10 月 5 日前后,Devin 官方博客发布了《Memory and dreaming: how Devin learns from working with you》(需要说明的是,该博客页面当前无法直接抓取、返回 404,疑似反爬;发布时间经 daily.dev 10 月 6 日的报道与官方公告视频等多方交叉确认为 10 月 5 日至 6 日之间),宣布 Devin 上线两项能力:Memory 和 Dreaming。与此同时,Cognition 公开了一份完整的开放规范——Agent Memory Repo,把"agent 应该如何记忆"这件事,从一家公司的功能清单,改写成任何人都可以实现、审计和 fork 的公共标准。
这篇文章的价值不在功能本身,而在姿态:一个以闭源商业产品著称的团队,选择把记忆做成 git 仓库。这几乎是对整个"记忆插件"生意的一次釜底抽薪。
为什么是现在?因为 agent 记忆正处在一个尴尬的拐点:人人都承认它重要,但没人说得清它应该长什么样。向量派说" embedding 一切",插件派说"装我的 SDK",平台派说"留在我的云里"。Cognition 的判断是:当所有人都在争"记忆存在哪"的时候,真正稀缺的是"记忆的格式共识"——就像当年所有人争云存储,最后赢的是 S3 兼容协议。Agent Memory Repo 想当的就是 agent 记忆的"S3 兼容层":不管你用哪家 agent,记忆都是同一套文件夹、同一套 Markdown、同一套 git 操作。今天 Devin 先实现,明天任何 agent 都可以实现,后天你的记忆就可以在不同 agent 之间搬家。这个时间点卡得很准:agent 刚从"玩具"变成"生产力工具",记忆的可携带性第一次成为真实的用户痛点。
Memory:记住"学到的经验",而不是聊天记录
先把概念掰开。Devin 的 Memory 不是把聊天记录存下来——那是上下文窗口干的事。Memory 记住的是跨 session 的"学到的经验":你的工作偏好、你纠正过的错误假设、某个项目里踩过的教训。
它的写法很克制:每条记忆是一句短笔记,并且必须带上来源 session 的链接。比如"John 负责计费功能的上线"后面跟着 [source: https://example.com/sessions/101]。这意味着每条记忆都是可追溯的:你随时可以点回去看它是从哪次对话里学来的。这是一个关键设计——记忆不是模型的"感觉",而是有出处的断言。
另一个关键限定:这是个人级记忆(per user per org),记住的是"你这个人",而不是组织的共享指令。它不解决团队知识管理,那是 Agent Memory Repo 标准里另一个用例的事。
这里有个微妙但重要的产品哲学:Memory 记录的是"被验证过的经验",而不是"发生过的事"。偏好是用户亲口说的,纠正过的假设是用户亲手改的,项目教训是实践里撞出来的——每一条背后都有一次真实的交互作为证据,session 链接就是证据编号。这种设计把记忆的"写入权限"交给了现实:不是模型觉得该记就记,而是交互中产生了值得记的东西才记。它不完美(dreaming 挖掘出的"新知识"恰恰是模型主动推断的,这也是社区质疑的焦点),但至少在 Memory 这一层,Cognition 选择了保守:宁可少记,不可瞎记。
Dreaming:每天夜里,有个 agent 替你整理记忆
如果说 Memory 是"记",Dreaming 就是"理"。Cognition 把它描述为一个每天运行的异步进程——用 daily.dev 的总结来说,它在深夜离线工作,翻看 Devin 从你的 session 里建起来的整张记忆图谱,做六件事:
- 去重:把重复记录的同一条知识合并;
- 链接:把孤立的笔记连到相关的 session 和工件上;
- 删除过期:不再为真的记录会被清理掉;
- 校验来源、解决矛盾:当两条记忆互相打架时,回到来源去判定谁对谁错;
- 挖掘新知识:发现那些跨 session 浮现、但从未被显式记录下来的模式,写成新条目。
daily.dev 对 Dreaming 的一句话点评很精准:它解决的是"agent 检索到过时记忆"的问题,而不只是"把一堆垃圾记忆搜得更准"。这是两种完全不同的野心——前者承认记忆会腐烂,后者假装记忆永远新鲜。几乎所有记忆插件都只做了后者。
Agent Memory Repo:记忆 = 一个 git 仓库
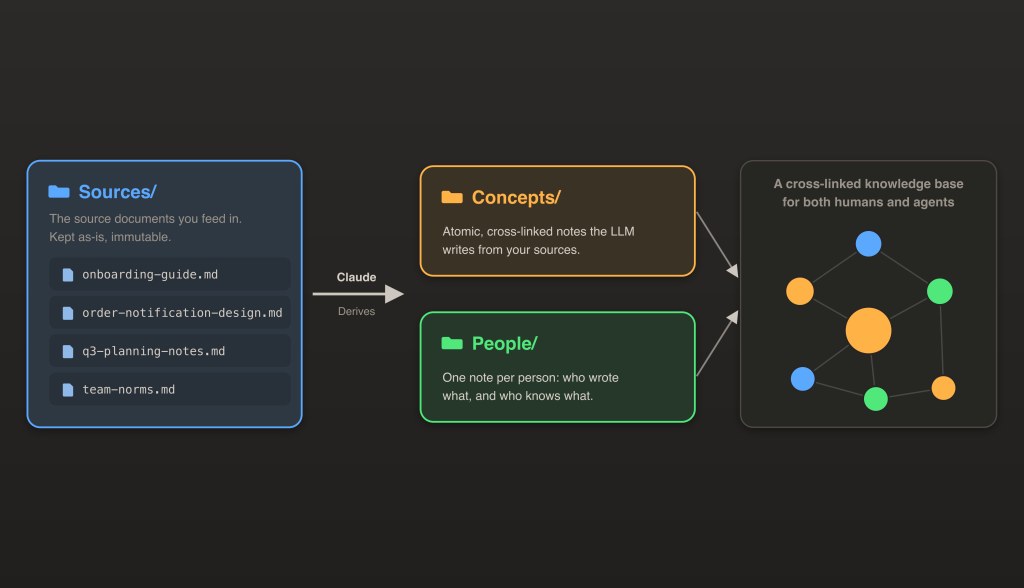
重头戏是这份开源标准。它的核心主张一句话就能说完:agent 的记忆应该是一个 git 仓库,里面是互相链接的 Markdown 笔记。没有向量库,没有专有 API,没有黑盒。
每个 session 遵循同一个循环,只有四步:clone → search → update → push。session 开始时 clone 最新记忆,干活时搜索或顺着链接找,学到新东西就地更新,改完 push回去。不需要人类在回路里。
仓库的结构设计处处透着"给 agent 读"的自觉:
- MEMORY.md 是入口:每个 session 开始都会加载它,所以规范要求它必须短——只放每个 session 都需要的东西,外加指向其余一切的索引;
- 条目是一行一个 bullet,末尾带开放键值的 metadata,比如
[source: <session链接>; added: 2026-09-03],keys 可以自己扩展; [[wikilink]]互链:路径从记忆根目录起,Markdown 文件省略.md后缀,信息只存一处、别处引用,搬家改名时记得更新链接——完全是 Obsidian 用户的老朋友;- 仓库里不只有 Markdown:SQL 查询、脚本、任何文件都能放,布局完全自由。
标准定义了四种用例,每一种都值得展开:
个人记忆自不必说。Agent swarm 共享消息板是最精彩的一个:多个并行工作的 agent 向同一个仓库 push,git 的冲突机制天然成为协调信号——当两个 agent 改了同一行,git 会拒绝第二个 push,这个 agent 必须先读两个版本,再写出合并后的一版。规范里给了一个完整的排查慢请求的例子:中位 80ms、但 1% 的请求慢到 2.4 秒,四个 agent 分查数据库、运行时、缓存和负载均衡,共写 findings.md 和 questions.md,最后由数据库 agent 拼出根因(价格缓存每 10 秒重建 2GB 全表 → 400ms GC 停顿 → 请求堆积抢光 20 个数据库连接)。没有一个 agent 能独自发现这个因果链。
团队记忆解决的是"没有代码仓库的团队怎么办":一次客服排查的教训,变成所有人 agent 共享的知识。多人记忆组合则靠"文件夹即组合"实现——Alice 开 session 时 clone 她的 memory-alice,Bob 加入时再 clone 他的 memory-bob,agent 同时读两份 MEMORY.md,按归属写回各自的仓库,归属不明就开口问。每个仓库保留自己的所有权、权限和历史,未来可以任意混搭。
想亲手试?Cognition 给了极低的门槛:devin plugins install AgentMemoryRepo/agentmemoryrepo 装上插件,教给 agent 一个偏好,再开一个新 session 问它"你还记得吗"。官方试玩流程分三步:先让 agent 用这个 skill 建一个本地记忆仓库并记下一条偏好,然后开一个全新 session,把上一步拿到的仓库路径告诉它,看它能不能把那条偏好找回来。整个试玩是本地的,不配 remote,没有自动启动也没有定时 Dreaming——先让你亲手摸到"记忆是一个文件夹"的手感,再谈生产环境的用法。这种"先可玩、再可信"的推广节奏,本身就很符合开源标准的气质:标准的第一批用户不是采购决策人,而是半夜调 agent 的工程师。
还有一个容易被低估的设计:可组合性(composability)。规范明确说,一个 session 可以同时加载多个记忆仓库。Alice 开 session 时 clone 她的 memory-alice,Bob 中途加入就把他的 memory-bob clone 进同一台机器,agent 同时读两份 MEMORY.md。关键在于仓库始终保持独立:agent 会追踪"这是谁说的",把 Alice 的偏好写回 memory-alice,把 Bob 的写回 memory-bob,归属不明时开口问人。因为每个仓库保留自己的所有权、权限和历史,未来的 session 可以任意混搭——今天 Alice+Bob,明天 Alice+Carol,记忆跟着人走,而不是跟着某次会话走。这是对"记忆属于谁"这个老大难问题的一个工程化回答:不靠访问控制列表,靠文件夹的所有权。
社区吵什么:172 条评论里的三派
daily.dev 的这篇报道(10 月 6 日更新)攒了 172 条评论,情绪分布是 45% 正面、40% 混合、15% 质疑,相当有代表性。
正面派喜欢的正是"git 化"本身:版本化、可 diff、可审计——记忆第一次有了工程意义上的"可检查性"。混合派大多在等落地:标准写得漂亮,但 agent 真的会乖乖遵守 clone→push 的纪律吗?
质疑派的两个问题最值得记下来,因为它们直指 Dreaming 的命门:第一,被"推断"出来的记忆(不是用户亲口说的、而是 dreaming 挖掘出的模式),在被 agent 信任之前经过验证了吗?第二,dreaming 会不会悄悄删掉真实记忆,或者幻觉出从未存在过的结构?
这两个问题都没有标准答案,Cognition 的规范也只回答了一半:metadata 的 source 和 added 让每条记忆可追溯,矛盾解决要求"校验来源"——至少在 spec 层面,删除和合并不是无据可查的。但"推断记忆的置信度"和"删除操作的权限边界",规范里确实留了白。这 15% 的质疑,恰恰是这个标准从"漂亮文档"变成"生产基础设施"之前必须补的课。
换个角度看,这个情绪分布本身就是个好消息:一个刚发布几天的标准,能拿到 45% 的明确正面和 40% 的"观望但感兴趣",说明市场对"开放记忆格式"的渴求是真实的。混合派的那 40% 不是反对,而是把"等一个生产级实现"写在了脸上——他们要看的不是 spec 写得多漂亮,而是第一个吃螃蟹的团队在真实规模下会不会翻车。Cognition 能不能把这 40% 转化过来,取决于 Dreaming 在未来几个月里交出的实际答卷:删错一条记忆的公关灾难,可比 15% 的质疑声量大得多。
专论:"记忆插件 vs 文档派"之争,Cognition 站了哪边?
本站之前发过一篇观点檄文《别再给 Agent 装记忆插件了》,核心论点是:记忆应该沉淀为文档,而不是插件——RAG 式的、向量检索式的记忆插件是结构性错误:黑盒、不可审计、不可 diff,出了问题你连"它记错了什么"都看不见;文档才是正解:人类可读、可编辑、可版本控制。
Cognition 这次的发布,几乎是那篇檄文的正方回应:它没有反驳"记忆插件有问题",而是直接给出了"文档派"的官方实现——记忆就是 Markdown 文件,就是 git 仓库,就是 [[wikilink]]。连 Dreaming 这个听起来最"AI"的功能,干的活都是文档工作:去重、链接、合并、删过期、补来源。
但这不意味着两派握手言和了。我的判断是,Cognition 实际上把争论升级到了一个新层面,至少有四层意思值得拆开:
第一,它把"记忆"从功能降格成了格式。功能是护城河,格式是生态位。Cognition 放弃用私有记忆锁用户,赌的是"标准制定者"的位置比"记忆本身"更值钱——当所有 agent 都读写同一种记忆仓库,Devin 作为最先实现、实现得最好的那个,自然成为参照实现。这是一种阳谋。
第二,它部分回答了"管得住"的问题。文档派的核心诉求从来不是"搜得准",而是"管得住":我能看见它记了什么、能改、能删、能追溯。source 链接 + added 日期 + git 历史,这三件套确实让记忆第一次变得可审计。这是对质疑派第一个问题的正面回应。
第三,它没有回答规模问题,而这恰恰是插件派最后的堡垒。当 session 攒到上千条,MEMORY.md 这个"必须短"的入口会不会腐烂?dreaming 每天合并删除的权限边界在哪里?多人组合时,一条写进 Bob 仓库的记忆,Alice 的 agent 该不该读?规范把这些留给了实现者。向量记忆插件虽然黑盒,但它至少不怕规模——这是文档派必须正面迎战的一仗,Cognition 把考卷发下来了,但答案还没写完。值得注意的是,Dreaming 本人就是 Cognition 为规模问题准备的第一个答案:记忆会腐烂,所以需要一个定期整理的园丁。但园丁的权力越大,质疑派的第二个问题就越尖锐——谁来审计园丁?目前规范的回答是"看 git 历史",这对个人和小团队够用,对大组织恐怕还要补上审批流。
还有一个战略层面的判断值得单独说。把记忆开源,本质上是把"护城河"往上游搬。过去 agent 厂商的逻辑是:用户用得越久,私有记忆越厚,迁移成本越高——记忆是留存工具。Cognition 反其道而行:记忆变成可携带的公共格式,厂商的竞争点被迫上移到"谁的 agent 更会用记忆"。这对 Devin 是自信的赌注:赌自己的 agent 在开放记忆上的表现,强到不需要靠"扣押记忆"来留人。对整个行业则是松绑:创业公司不用再从零造记忆轮子,直接实现这个标准就能和 Devin 的记忆互操作。历史上看,凡是"把私有能力变成公共标准"的玩家,要么在下一轮竞争里被标准化反噬,要么成为定义赛道的人。Cognition 显然想当后者。
第四,对 vibe coder 的实操意义是可携带性(portability)。daily.dev 点破了这层:开放标准的意图,是让"你是怎么工作的"这份记忆不再被锁死在单个厂商的产品里,换工具时记忆不会被扣为人质。从今天起,选 agent 工具多了一个变量:它支不支持 Agent Memory Repo?团队甚至可以把管代码的那套工作流(PR review、code owner)直接搬过来管 agent 的记忆——"这条记忆是谁写的、为什么写",git blame 全知道。
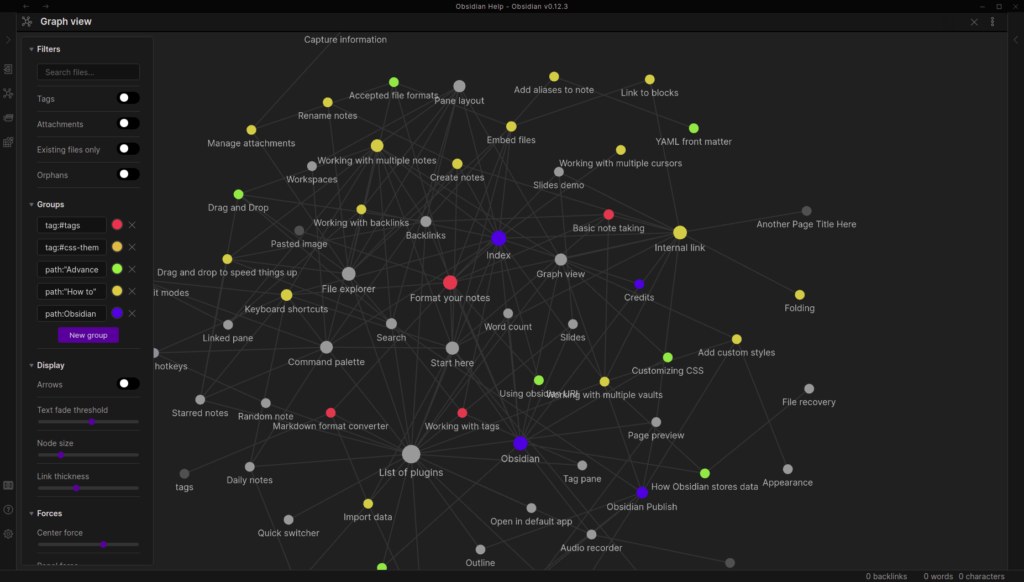
一句话总结这场争论:记忆插件派关心"搜得准",文档派关心"管得住";Cognition 把这两件事一起扔进了 git——搜索用 grep 和链接,管理用 commit 和 push。这几乎是整个 vibe coding 时代的缩影:最好的 agent 基础设施,恰恰是那些看起来最不像 AI 的东西——git、Markdown、文件夹。三十年前的工具,正在成为最前沿 agent 的记忆器官。
尾声:当一群 Devin 自发开始协作
发布里有个容易被忽略的细节,来自 Cognition 的 LinkedIn:在早期实验中,"一群 Devin 自发地用记忆大规模协调起来,事先没有人提示"——原文还补了一句"we promise they didn't hack anyone"(我们保证它们没有黑进任何系统)。
这个细节比功能本身更耐咀嚼。Agent 时代的"涌现"叙事,过去讲的都是单个 agent 更聪明;但这次涌现的不是智能,而是组织——多个 agent 因为共享了一份可版本化的事实基础,自发形成了分工。这正是 Agent Memory Repo 想要标准化的东西:记忆不是让一个 agent 更博学,而是让一群 agent 能协作。
所以这篇报道的真正标题也许应该是:记忆正在从"闭源功能"变成"基础设施"。Cognition 交出了第一份考卷,社区用 172 条评论打了分(85% 不反感,15% 要答案),而文档派和插件派的战争,才刚刚从"要不要记忆"打到"记忆长什么样"。
下一次你换 agent 工具的时候,带走的可能不只是一堆 prompt——还有一整座可以 clone 的记忆仓库。这才是 Dreaming 真正想让你梦到的未来。
评论 (0)
原始来源
相关文章

Stack Overflow 工程博客 10 月 7 日刊发编码 Agent 操作系统系列第六篇,核心论点:Agent = 模型 + 脚手架,模型也许只占一成。证据:LangChain 的 coding agent 在 Terminal-Bench 2.0 上从 52.8% 涨到 66.5%(+13.7 个百分点),从 30 名开外冲进前 5,模型完全没换,只改了脚手架。文章开出六件套处方:宪法文件、自主边界、分层 CONTEXT.md、持久记忆、多视角评审团、PostToolUse 钩子;多 agent 协作则靠共享书面状态与 append-only 决策日志。本站判断:模型正在商品化,差异化迁往脚手架,而那九成是你今天就能开始造的东西。
Agnes AI 开源 Agnes Harness(AGH):面向真实任务的 Agent 执行基础设施,支持持续执行、轨迹回放、插件/MCP 扩展与 Skills 沉淀;同步开源 MHS 设备交互协议,把 Agent 从屏幕带进物理世界。Agnes 3.0 Pro 同时公布成绩:GPQA 91.11、SciCode 56.13。本站判断:Agent 的战场正在从模型层下沉到执行层,谁控制执行层,谁就定义 Agent 的工作方式。
SemiAnalysis 审查九家中国头部 AI 公司 857 次模型发布,仅 3.6% 公开安全评测。对每天把数据库权限和 MCP 工具交给 agent 的 vibe coder 来说,这个黑盒水位值得警惕——附四个可落地的防护建议。