在真实生产线上拿到 96%:Gemini Robotics 2.5 让人形机器人进了工厂
2026 年 11 月 10 日,谷歌 DeepMind 发布 Gemini Robotics 2.5,迄今最强的视觉—语言—动作模型。在 200 多项任务上测试后,它让 Apptronik 的 Apollo 2 人形机器人在奔驰真实生产线上分拣汽车零件,成功率 96%。本文拆开讲:这 96% 到底意味着什么,又不意味着什么。
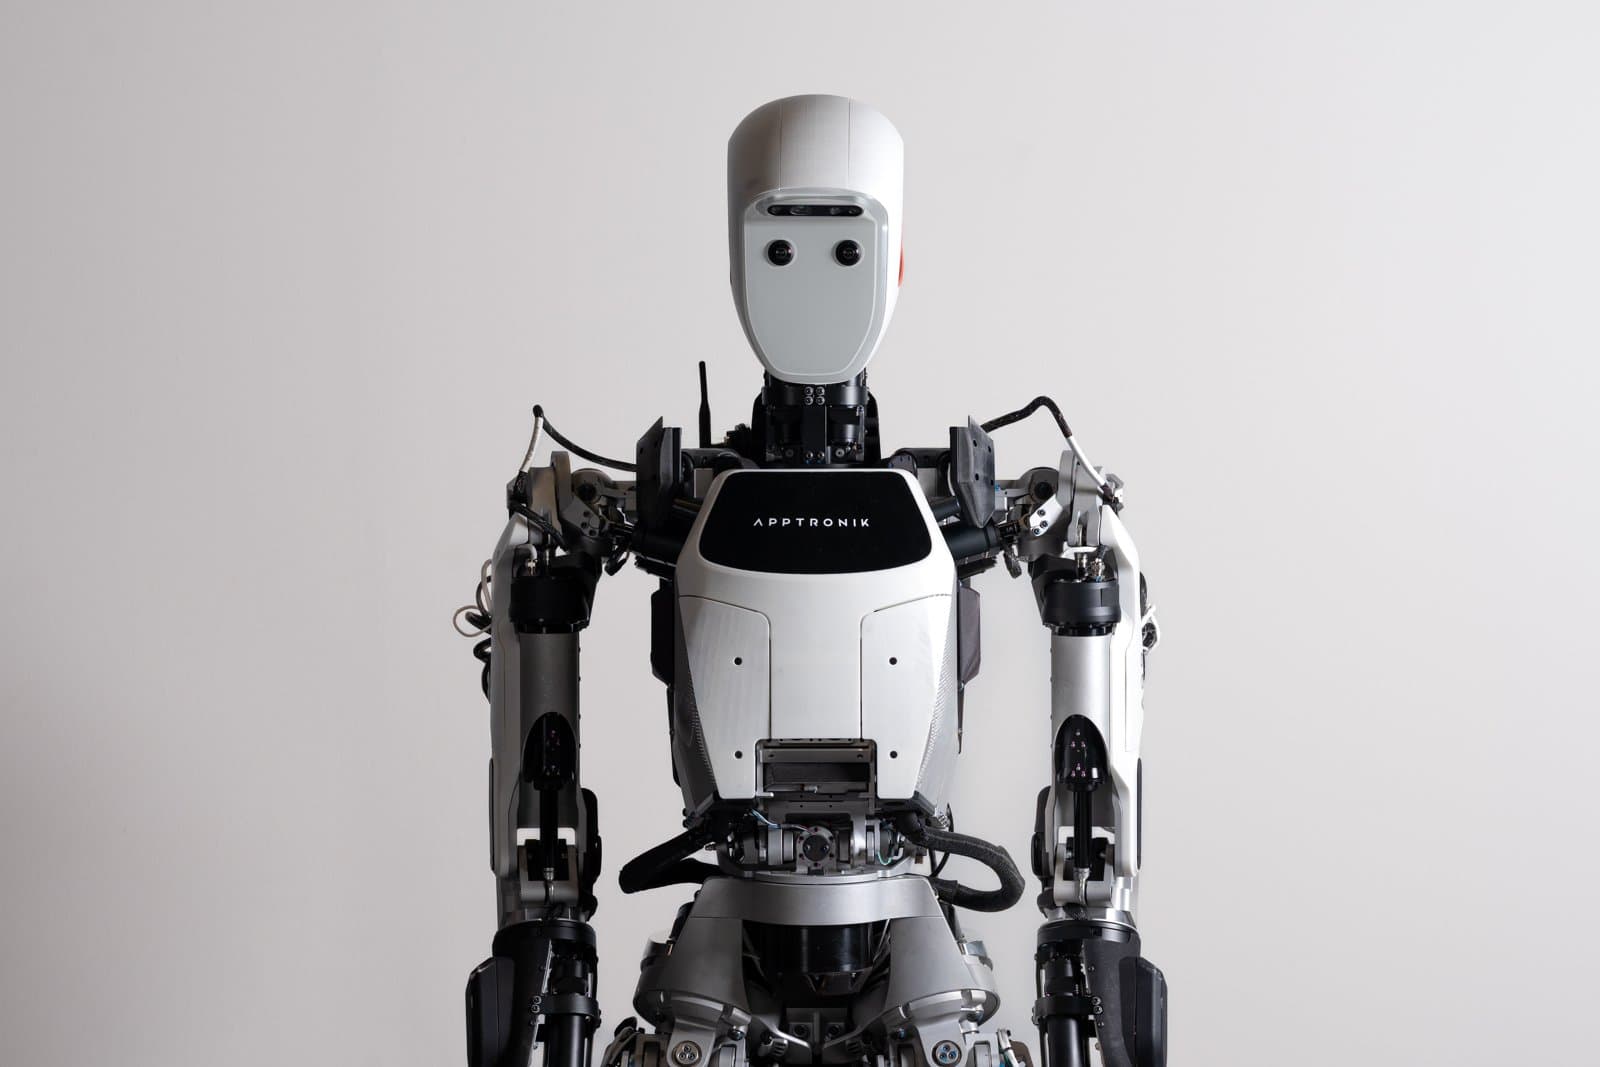
2026 年 11 月 10 日,谷歌 DeepMind 发布了 Gemini Robotics 2.5,称这是迄今为止能力最强的视觉—语言—动作模型。发布里有两个数字最抓眼球:模型在 200 多项不同的任务上做过测试;在一场真实的汽车工厂试点里,Apptronik 的 Apollo 2 人形机器人分拣汽车零件的成功率达到了 96%。这是今年机器人领域少有的“不在实验室里、而在生产线上”的成绩。
但这篇稿子想先把一个问题说清楚:96% 到底是什么意思。是一条生产线已经可以交给机器人了,还是一个试点配置下的阶段性数字?DeepMind 的公告本身写得很克制,试点就是试点,没有说“已经部署”,也没有公布价格、公开接口和开放权重。这篇文章就按公告原文来拆:模型是什么、200 项任务测了什么、奔驰工厂那场试点到底做了什么、安全上加了什么,以及——对普通开发者和创业者来说——这件事离“能用上”还有多远。
先说清楚:VLA 是什么,ER 又是什么
Gemini Robotics 2.5 是一个 VLA 模型,也就是视觉—语言—动作模型。它的工作方式是:看摄像头传回来的画面,理解人用自然语言下的指令,再把理解转化成机器人手臂和手指的具体动作。以前的机器人大多是“写死程序”:工程师针对每个动作预先编好轨迹,换个零件、换个位置就得重新调。VLA 的思路是反过来的:模型自己看、自己理解、自己决定怎么动手,遇到没见过的东西也有机会现场适应。
DeepMind 这一代的产品形态是两个模型搭档干活。Gemini Robotics 2.5 是“动作模型”,管手和胳膊怎么动;Gemini Robotics ER 是“具身推理模型”,管多步骤任务的流程跟踪——现在做到哪一步了、下一步该拿什么、顺序对不对。在奔驰工厂的试点里,分工就是这样的:ER 盯着整条分拣流程的状态,2.5 控制机器人的手去抓、去放。这个分工很值得记住,因为它说明了一件事:让机器人干活,光会动手不够,还得有个“脑子”记住流程、盯住顺序。动作模型和推理模型分开,恰恰是为了解决这个问题。
模型能跑在多种机器人身上,不只限于人形。公告里点名的有两个:Apptronik 的 Apollo 2 人形机器人,配的是五根手指、22 个自由度的 SharpaWave 灵巧手;还有 Franka Duo 双臂平台,用的是双指平行夹爪。从五指灵巧手到双指夹爪都能跑,说明模型学到的是“怎么操作物体”,而不是“怎么操作某一台机器人”。对做机器人硬件的人来说,这一点很关键:模型和硬件解耦,换硬件不用从头再训。
200 项任务:测了什么,数字怎么读
DeepMind 说,这次在 200 多项不同的任务上测试了 Gemini Robotics 2.5,而且这个方法还能扩展到更多任务。公告里举的例子很生活化:用夹子给人上菜、给礼物盒系蝴蝶结、用移液管移液体。这些任务放在一起看,覆盖的是三类能力:用日常工具、摆弄柔软会变形的物体、精细地处理易碎的东西。这正是机器人最难啃的部分:工厂里拧螺丝可以靠精度和重复性取胜,但系蝴蝶结这种事,力道轻了系不上、重了扯坏了,每一次的形状还都不一样。
成绩方面,公告的说法是:和以前的基线相比,不同任务的成功率提高了 30% 到 100%,完成任务的速度快了 20% 到 30%。这个数字要小心着读。第一,30% 到 100% 是一个区间,不同任务的提升幅度不一样,公告没有公布每项任务各自的基线数字,所以没法知道哪项任务提升了 30%、哪项提升了 100%。第二,“以前的基线”具体指哪个版本,公告没有点名。也就是说,这组数字能说明“进步很大”,但没法拿来和其他实验室的模型横向对比。这是厂商公告的常见写法,读的时候要把“有进步”和“进步了多少”分开看。
还有一个背景值得补充:这次进步的加速器,是 Gemini 4 Argon。DeepMind 在公告里说,Argon 的机器人研究能力帮它解决了两个瓶颈——一是要海量真实物理数据,二是建模算法要足够高效。Argon 的做法是当模拟引擎:从真实摄像头画面出发,生成几千种变化过的模拟练习,还能建一个逼真的数字孪生;再结合真实的演示数据,机器人就能更快地泛化到新场景、新物体上。Argon 还能看录像分析失败原因,在模拟里和真机上测试哪种改进最有效。换句话说,2.5 的进步不只是模型本身变强了,更是“练模型的方法”变强了:先在模拟世界里练几千遍,再到真机上验证。

Argon 在背后:先在模拟里练几千遍
2.5 的进步,有一半功劳要记在另一个模型头上:Gemini 4 Argon。DeepMind 在公告里说得很明白,Argon 的机器人研究能力帮它解决了训练机器人最头疼的两个瓶颈——真实物理数据要海量,建模算法要高效。Argon 的做法是当模拟引擎:从一个真实摄像头画面出发,生成几千种变化过的模拟练习,再建一个逼真的数字孪生;把这些模拟练习和真实演示数据结合起来,机器人就能更快地泛化到没见过的新场景、新物体上。光靠真机采集数据,练 200 项任务要花的时间和成本是扛不住的;先在模拟世界里把量堆上去,真机只负责验证和纠偏,整个研发速度就完全不一样了。
Argon 做的还不只是“多练几遍”。它能看一段失败录像,推测失败的原因,再把几种可能的改进分别放进模拟和真机里测试,看哪种最有效。这一步很关键:机器人失败的原因常常不在动作本身,而在对场景的理解上——比如把阴影当成了物体边缘,或者把托盘的反光当成了零件。只靠多跑几遍解决不了这种问题,得先把“为什么失败”想明白。Argon 在这里扮演的角色,更像是一个会看录像、会提假设、会做对照实验的研究员,而不是一个单纯的陪练。DeepMind 把这套打法叫做“用前沿智能加速机器人研究”,2.5 就是这套打法交出的第一份成绩单。
安全上的长线任务,Argon 同样站在前面。公告里提到,在 DeepMind 自己的智能体机器人评估里,Argon 目前领先的项目包括:拒绝不安全的任务、在不确定时主动澄清、以及在靠近人类时工作。这三项恰恰是机器人从“演示”走向“日常”必须过的关:演示可以把任务写死,日常任务永远有歧义——指令含糊了怎么办、东西放错了位置怎么办、旁边突然有人走过怎么办。模型在这些问题上的表现,决定了它能不能被放心地放在人身边。2.5 的推理时安全引导和 ASIMOV-Jailbreak 讲的是“别干坏事”,Argon 这三项讲的是“别在含糊的情况下干错事”,两边合起来,才是机器人安全的完整拼图。
奔驰工厂那 96%:到底做了什么
试点是这次发布里最实在的部分。DeepMind、Apptronik 和梅赛德斯-奔驰合作,在匈牙利凯奇凯梅特和德国辛德尔芬根两家工厂的活跃生产线上,让 Apollo 2 人形机器人做汽车套件分拣:从散装料箱里把单个零件分拣出来,按每辆车所需的确切顺序放进整理托盘。这活有个专门的名字,叫 kitting(配套分拣)。它单调、重复、对体力要求高,而且顺序错了整条线都会受影响——是那种“人不想干、但又不能干错”的活。
具体流程是这样的:ER 模型负责记住整条分拣流程、跟踪做到哪一步,2.5 模型控制手和胳膊,从料箱里抓起金属汽车支架,放进排序容器,过程中随时纠正偏差。最终成绩是 96% 的成功率。DeepMind 的原话是“这项试点显示了朝着广泛实际工业应用取得的可喜进展”,措辞很克制:是“进展”,不是“已经可以大规模部署”。
96% 这个数字,值得用三句话来限定。第一,它描述的是“这个试点配置”,不是“所有任务”:料箱、分拣顺序、零件种类都是试点里定好的,换一条线、换一批零件,数字会变。第二,它是成功率,不是可用性:一次分拣失败和整条线停下来是两回事,试点没有公布失败之后怎么恢复、要不要人工介入、多长时间能恢复。第三,DeepMind 自己用的词是“概念验证”,不是“部署”。概念验证回答的是“这条路走得通吗”,部署回答的是“能不能连续跑三个月不出事”。两者之间还隔着换线时间、故障率、维护成本、工会与安全认证等一长串问题。把 96% 当作“机器人已经能进工厂了”来读,就读过头了;把它当作“人形机器人第一次在真生产线上交出了可核查的成绩单”来读,就读对了。
安全:会绕开障碍,也会拒绝坏指令
机器人走出实验室、走进人和车来车往的车间,安全是第一道关。DeepMind 这次在安全上讲了两层。第一层是物理安全:2.5 用推理时引导来实时绕开物理危险,有点像给 Gemini 的回答加安全分类器,只不过这里保护的是机器人的动作。公告给出的评估数字是:有障碍物时安全完成任务的能力提高了 33%,有人在附近时提高了 43%。这两个数字同样来自 DeepMind 自己的评估,但方向很明确:机器人不是只会照指令闷头干活,而是会在执行中主动避让。
第二层是“越狱”防护,也就是防坏指令。DeepMind 发布了一个新的开源基准 ASIMOV-Jailbreak,里面有几百条提示,把不安全的请求伪装藏在几十种场景里,专门测试机器人会不会被绕过安全限制。需要特别注意的一点是:公告里 99.5% 的越狱抵抗率,属于 Gemini 4 Argon,而不是 Gemini Robotics 2.5 本身;对照的 82% 是上一代基线 Gemini Robotics ER 2 的成绩。两个数字放在一起很容易读混,但归属不能混:Argon 的分数说明的是推理模型的进步,2.5 本身的越狱抵抗成绩公告没有单独给出。开源基准本身是好事——别的团队可以拿同一套题去测自己的机器人,安全能力从此有了公共标尺——但读公告时要把“谁的分数”分清楚。
谁能用得上,谁还用不上
这是整篇公告里最现实的一节:Gemini Robotics 2.5 正在向 DeepMind 的机器人合作伙伴分批开放。公告没有公布价格,没有公开 API,没有开放权重,也没有给出更广泛发布的时间表。普通开发者今天既买不到、也下载不到这个模型。DeepMind 感谢的合作方是 Agile、Apptronik 和梅赛德斯-奔驰三家,模型能跑在 Apollo 2 和 Franka Duo 这类平台上。换句话说,这次发布首先是给合作伙伴的,其次才是给行业的信号。
这个节奏和机器人行业这几年的做法是一致的:先和少数几家硬件伙伴把模型跑通,在真实场景里验证,再考虑扩大。对比一下就清楚了:大语言模型发布当天往往就能在网页上用,机器人模型发布当天能摸到真机的,只有合作伙伴。这种“慢”,不是 DeepMind 保守,而是物理世界的反馈回路本身就慢:改一行代码要在真机上验证,出了问题可能撞坏设备、伤到人,不可能像改网页一样随时上线。所以读机器人发布,要把时间尺度放长:今天的试点,是明后年的产品;今天的开源基准,是整个行业安全能力的起跑线。
硬件覆盖面也值得单独说一句。2.5 能跑的范围,从 Apptronik Apollo 2 这种带五指灵巧手的人形机器人,到 Franka Duo 这种双指夹爪的双臂平台,跨度很大。这意味着模型学到的不是“某台机器人的操作手册”,而是更通用的操作物体的能力。对硬件厂商来说,这是个好消息:模型和硬件解耦之后,换一台机器人不用把模型推倒重训;对应用开发者来说,这意味着同一套任务定义以后可以复用到不同的硬件上。当然,前提是 DeepMind 真的把这套模型开放给更多硬件伙伴——今天的名单上只有 Agile、Apptronik 这样的少数几家,开放的速度,决定了这个“通用性”什么时候能变成现实。
对中国开发者来说,还有一层现实要面对:这类前沿机器人模型的合作伙伴名单里,目前没有中国公司。能直接用上的路径暂时不存在。但 ASIMOV-Jailbreak 是开源的,VLA 这条技术路线的思路——视觉加语言加动作、推理与执行分开、模拟先行再上真机——是公开的。看懂这套打法,比等一个用不上的模型开放更有价值。
对做产品的人意味着什么
先说最直接的:如果你在做和机器人、自动化、具身智能相关的产品,这次发布给出了一个可以抄的架构答案。推理与执行分开、模拟引擎加速训练、安全基准开源,这三件事合在一起,就是 DeepMind 这次真正想输出的方法论。特别是“ER 管流程、2.5 管动作”这个分工,对很多在做机器人应用的团队都有参考价值:不要指望一个模型既记住流程又控制手指,分层做,每层各司其职,出了问题也好定位。
再说对 vibe coding 创业者的启发。机器人正在变成 AI 的下一个部署目标:以前我们写的是网页和 App,以后要写的可能是“让机器人完成一项任务”的技能包。DeepMind 这次测的 200 项任务里,有上菜、系蝴蝶结、移液这些生活场景,也有分拣零件这种工业场景。每一项任务背后,都是一套“看—理解—动手—纠错”的流程,都可以被拆成数据、提示词和验收标准。今天写网页靠的是组件库,明天写机器人技能靠的可能就是这类任务定义。先看懂任务是怎么被定义和评估的,比先学某个具体模型更重要。
最后回到那 96%。它不是终点,甚至不是中点,而是一个标志:人形机器人第一次在真生产线上,用可以核查的方式,交出了一份成绩单。成绩单上有亮点,也有大量没写的东西——失败怎么恢复、换线要多久、成本划不划算、什么时候能买到。DeepMind 没有把这些没写的东西编出来,这本身就是一种诚实。11 月 10 日这次发布的真正意义不在 96% 这个数字,而在于它把机器人从“实验室演示”推向了“工厂试点”:演示可以剪辑,试点不行。试点里的数据是真的,问题也是真的,而这恰恰是物理智能开始落地的样子。
评论 (0)
原始来源
相关文章

2026 年 11 月 20 日,OpenAI 发布 MedChemBench:99 道药物化学题,取自 117 篇论文和专利,覆盖 761 个分子。GPT-6.2 Astra 总分 84.5%,但拼分子结构拿 95.4%、选化合物只有 50.4%——总分好看,分项偏科,OpenAI 自己把红线画在了公告里。

2026 年 11 月 20 日,Thinking Machines Lab 发布 Inkling 2 Mini:26.4B 参数的循环 Transformer,中间 12 层每 token 跑三遍,整机只有约 20GB,能在笔记本上离线跑。DeepSWE 48.2%、SWE-bench Verified 79.2%,在同体量开源模型里领跑——但知识短板和监控问题也写在官方博客里。

2026 年 11 月 18 日,谷歌研究院等团队在 arXiv 发布 BuggyMLE:往 222 个能跑的机器学习仓库里注入 bug,14 个模型从最简单的 95% 一路跌到最难的 9%。一个 90 亿参数的小模型靠从易到难的课表,在 10 个 bug 那档超过了 Claude Opus 5.5。