微软研究员人机协作攻克 31 年 KLS 猜想:agent 铺开搜索、人类负责剪枝
微软研究院 10 月 21 日宣布,Xinzhi Zhang 与 Zhao Song 用人主导的 agent 研究流程证明了 31 年悬而未决的 KLS 猜想:AI agent 探索 100 多条路径、人类逐轮剪枝;同 token 预算下无监督模型未能解出。
31 年的老问题,被「人指挥 AI」的方式拿下了
10 月 21 日,微软研究院发布博客:高级研究员 Xinzhi Zhang 与合作者 Zhao Song 证明了 Kannan–Lovász–Simonovits(KLS)猜想——一个 1995 年提出、在高维几何与概率论里悬了 31 年的中心问题。论文《An O(1) Bound for the KLS Constant》最早 10 月 1 日挂上 arXiv,10 月 4 日的修订版完成了最终证明。
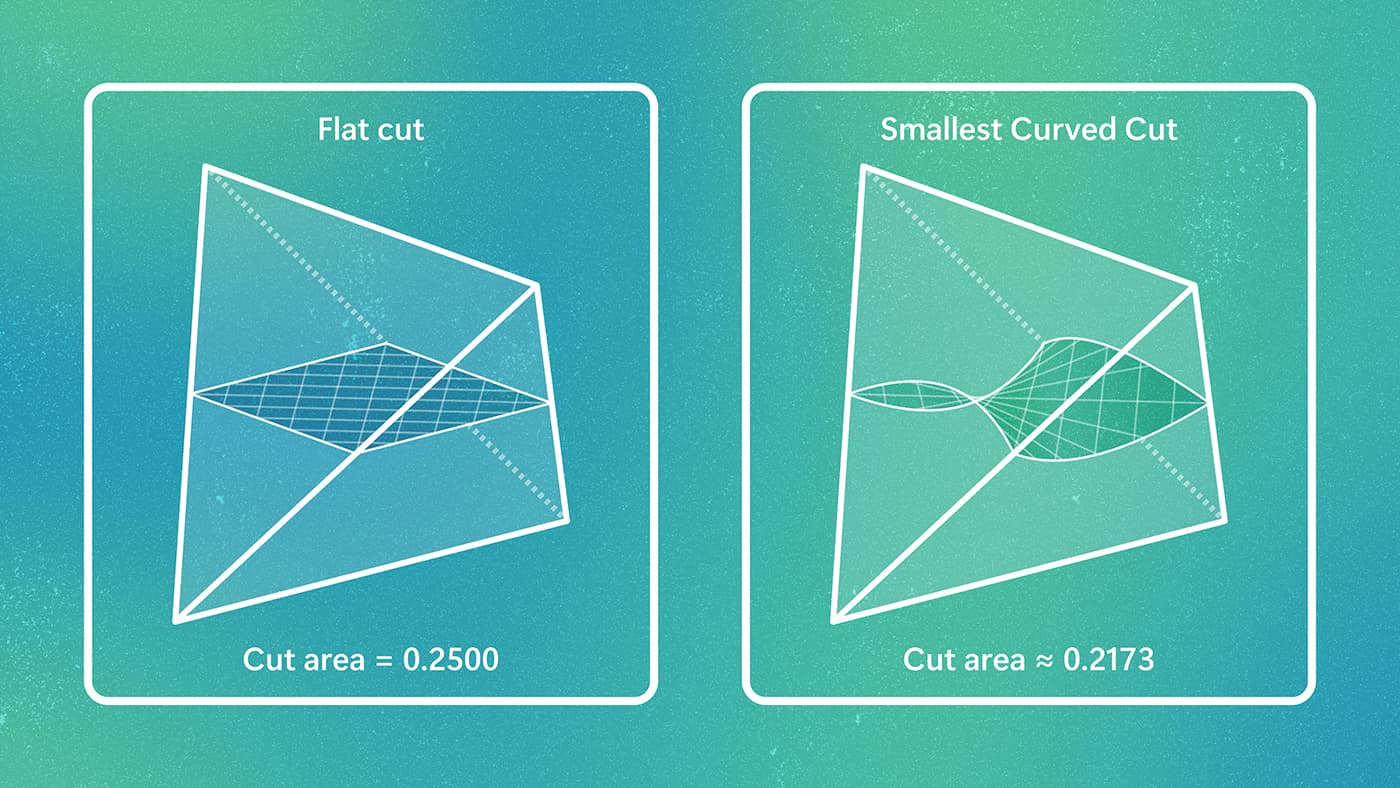
先用人话讲讲 KLS 猜想在问什么。想象一个高维空间里的「凸体」(比如高维版的西瓜),你要把它切成体积相等的两半。切法有无数种:平面直切,或者弯弯曲曲地切。KLS 猜想说:最优的平面切,永远不会比最优的任意形状切差太多——两者面积之比被一个「普适常数」封顶,而且这个常数不随维度增长。维度从 3 维涨到 3000 维,结论照样成立。
这为什么重要?因为这类「切口」几何决定了随机游走探索一个分布的速度——也就是高维采样、统计、优化算法的理论地基。西蒙斯研究所称它是「凸几何最重要的开放问题之一」,Quanta 杂志说它「横亘在统计与计算机科学的许多问题中心」。而在此之前,最好的结果(2026 年 7 月)还允许那个界随维度缓慢增长。
关键不是 AI 多聪明,而是「人怎么指挥 AI」
这篇报道最值得细读的不是数学,而是方法。微软博客把分工说得非常坦白:
- AI agent 干了什么:在结构化的人主导流程里,探索了 100 多条候选路径,做了大量高阶张量的冗长计算,找到了一个新的数学判据(criterion),成了最终证明的地基;还承担了推导细节、文稿准备和内部证明检查。
- 人干了什么:定方向、剪枝、组装。研究员在每一轮看 agent 的中间结果,砍掉没前途的方向,把最有希望的结果送进下一轮。
- 最关键的一步是人想出来的:发现新判据可以递归应用——每个改进后的界可以喂回同一个论证得到更紧的界;10 月 1 日版本把维度依赖压到了「迭代对数」(增长极慢但仍在增长);最后一步是把整个递归精炼过程再重复一遍,并证明每轮引入的小误差衰减得足够快、总和被普适常数封顶。这个想法来自作者早年在线性规划快速算法上的工作,AI 没想出来。
微软还做了一个对照实验:在另一条线上,用几个前沿模型无监督地解同一个问题,给了差不多相同的总 token 预算——没解出来。博客的原话是:「最终的成功既依赖 AI 系统的能力,也依赖研究员的数学判断。」
这对整天和 agent 打交道的人是个重要提醒:agent 的正确用法不是「扔一个问题进去等答案」,而是「人定方向、agent 铺开搜索、人修剪」。KLS 证明就是这个工作流的教科书案例。
数学界的验证规格拉满了
一个由企业实验室宣布的数学大结果,最怕的是「自说自话」。这次的外部验证出奇地强:
- 同一天,另一个顶尖专家团队独立挂出了完整证明,直接建立在微软论文第一版的基础上,并称之为「证明中的关键一步」;
- 同一天还出现了第三个基于相近思想的证明;
- 随后有人放出了 Lean 4 形式化验证,把关键判据和机器检查结合了起来;
- 作者还把证明精简了,并用 Lean 验证了精简版,待最终评审后发布。
独立证明是数学里最强的验证形式之一:它说明结果不依赖某一条脆弱的推理链。对 vibe coder 的启示也很实在:当你让 agent 生成关键代码或做重要推导时,「第二条独立路径」是最便宜的保险——换个模型、换个 prompt 重新做一遍,对得上才敢信。
和之前「AI 数学突破」报道的区别
读者可能记得,不久前还有陶哲轩公开抵制 OpenAI 数学证明的新闻(本站发过)。那次争议的核心是:AI 生成的证明可不可信、算不算数学。这次微软的叙事聪明得多——它从头到尾没说「AI 证明了猜想」,说的是「人主导的 agent 研究流程证明了猜想」,并且把人的原创贡献(递归方法、误差有界论证)和 AI 的贡献(搜索、计算、检查)分得清清楚楚。
这种「分工透明」的写法,恰恰是未来人机协作科研报道的范本:不夸大 AI,也不贬低人。Agent 在这次事件里的角色,用微软自己的话说,是「探索数学可能性的同时,研究员评估、剪枝、重定向搜索」。
对 vibe coder 的三点启发
第一,把 agent 当「搜索器」而不是「解题器」。KLS 团队让 agent 并行探索 100 多条路径,人只做剪枝。你在重构、找 bug、做技术选型时,完全可以复制这个模式:让 agent 一次铺开多个方案,你来做裁判,而不是让它一条路走到黑。
第二,关键想法仍然来自人的跨领域联想。「重复整个递归精炼」的灵感来自线性规划——一个看似不相关的旧领域。Agent 擅长在既定方向上穷举,不擅长跳出框架。你的领域知识和旧经验,恰恰是 agent 最缺的那块拼图。
第三,给 agent 的工作配「第二验证者」。数学界用独立证明 + Lean 形式化来确认结果;你在工程里可以用:换模型复算、写测试反向验证、关键路径人工 review。Agent 写代码越快,这套验证越不能省。
31 年的猜想被拿下,靠的不是更聪明的模型,而是一种更聪明的人机分工。这句话,值得每个每天和 agent 结对编程的人贴在显示器上。
这个猜想到底难在哪:31 年的来龙去脉
KLS 猜想得名于三位提出者:Ravi Kannan、László Lovász、Santosh Vemula(1995)。它问的是一个看似简单的问题:对一类「表现良好」的高维概率分布(数学上叫 isotropic log-concave 测度),用平面去切和用任意形状去切,效果差多少?
打个比方。你有一个 1000 维的「西瓜」,想找到它最细的「腰」(瓶颈)。你可以拿一把「平面刀」(超平面切割)去找,也可以拿任意形状的「异形刀」去找。KLS 猜想说:平面刀找到的腰,永远不会比异形刀找到的腰粗太多——粗的倍数被一个跟维度无关的常数封顶。维度从 10 涨到 10000,这个倍数不变。
为什么数学家在乎?因为「切口」决定了随机游走(MCMC 采样)探索分布的速度。如果 KLS 成立,大量关于高维采样的定理就有了统一的地基;之前很多结果只能写成「假设 KLS 成立,则……」。现在这些「假设」可以去掉了——微软博客的原话:「a wide range of results that previously relied on the conjecture as an assumption can now be stated unconditionally.」
31 年里,人们把界从最初的指数级一路压下来:2000 年代压到多项式级,2026 年 7 月 Brayden Letwin 的 21 页论文压到 O(log1/4 n)——还差一点点:界仍然随维度缓慢增长。这最后「一点点」,就是 10 月这篇 140 页论文拿下的:O(1),与维度彻底无关。
证明的三步:判据 → 递归 → 重复递归
微软博客披露的技术路线有三步,每一步都值得展开:
第一步:找判据。团队先从改进 7 月的结果入手。AI agent 在结构化流程里探索了 100 多条候选路径,大量涉及高阶张量的冗长计算——这是典型的「机器擅长、人不擅长」的苦力活。产出是一个新的数学判据(criterion):一个可验证的条件,满足它就能推出更好的界。这个判据成了整个证明的地基。
第二步:发现递归。研究员注意到,新判据可以「自我喂养」:把改进后的界喂回同一个论证,能得到更紧的界。10 月 1 日的论文版本用这个办法把维度依赖压到了「迭代对数」(log* n)——一个增长极慢、但终究还在增长的函数。猜想还没完全拿下。
第三步:重复整个递归。这是神来之笔:不只应用一次递归,而是把整个递归精炼过程再重复一遍,并证明每轮引入的小误差衰减得足够快、总和被一个普适常数封顶。这个想法来自作者早年在线性规划快速算法上的工作——典型的跨领域联想,AI 没想出来,人想出来了。10 月 4 日的修订版就此完成了 O(1) 的证明。
注意这个分工的精妙:AI 负责「广度」(100+ 路径的穷举式探索),人负责「深度」(识别递归结构、跨领域联想、误差有界的论证)。博客特别强调:递归方法、重复应用、误差有界证明是研究员的原创贡献。这不是客套——在数学署名伦理里,分清这个很重要。
Lean 4 形式化:为什么数学家开始信任机器检查
这次事件还有一个容易被忽略的配角:Lean 4 形式化验证。简单说,就是把证明翻译成一种计算机能逐行检查的「形式语言」,让机器确认每一步推理都合法。这次有人把微软论文的关键判据形式化了,作者自己也把精简版证明做了 Lean 验证(待发布)。
这件事的意义不亚于证明本身。数学证明越来越长(这篇 140 页),人类 reviewer 不可能逐行验算,形式化验证正在成为「第二双眼睛」。对 vibe coder 的类比很直接:Lean 之于数学证明,就像测试之于代码。你不会把没跑过测试的代码合入主分支,数学家也开始不把没过形式化检查的长证明当定论。这是一个正在发生的范式转移,而 AI 恰恰是加速它的力量——因为 AI 擅长做形式化这种「繁琐但确定」的工作。
科研 agent 工作流:一份可复制的操作手册
KLS 证明最值钱的遗产可能不是数学结果,而是这套「人主导的 agentic 研究流程」。把它翻译成任何人都能用的操作手册:
- 1. 人定「搜索空间」,不给定理。研究员没有让 AI「证明 KLS」,而是让它「探索改进 7 月结果的路径」。任务粒度决定成败:太大 agent 乱枪打鸟,太小没有惊喜。
- 2. 并行铺开,批量剪枝。100+ 条轨迹并行探索,人每轮看中间结果、砍掉没前途的。这正是 coding agent 里「plan → 批量生成方案 → 人选」的模式,放到科研上同样成立。
- 3. 给 agent 配「苦力型」任务。高阶张量计算、文献内证明检查、文稿整理——繁琐、确定、可验证。把人的脑力留给「识别结构」和「跨领域联想」。
- 4. 保留「无监督对照组」。微软专门跑了一组「无监督 + 同 token 预算」的对照,证明了「人主导」不是心理安慰而是真实增益。你在评估 agent 工作流时,也可以留一个对照:同样预算,纯 agent 跑 vs 人机协作跑,差多少?
- 5. 产出要经得起「第二验证者」。数学界的第二验证者是独立证明 + Lean;你的第二验证者可以是另一个模型、另一套测试、一次人工 review。
这套流程的适用边界也很清楚:它适合「搜索空间大、验证标准清」的问题(数学证明、bug 狩猎、架构选型),不适合「目标本身模糊」的问题(产品创意、审美判断)。知道边界,和知道方法一样重要。
对照组实验:同样 token 预算,无监督就是不行
微软博客里最诚实的一段,是关于「另一条线」的披露:团队用几个前沿模型、无监督地解同一个问题,给了和主流程差不多相同的总 token 预算——没解出来。博客没有展开细节,但这个对照的价值巨大:它回答了一个所有人都在问的问题:「人主导」到底带来了多少增益,还是只是心理安慰?
答案:增益是真实的,而且大到「成与不成」的区别。同样的算力,有人指挥就解出来了,没人指挥就卡住了。这说明当前 agent 的瓶颈不在「算力」也不在「单步智能」,而在搜索策略:100 条路径里哪 5 条值得深挖、什么时候该换思路、什么时候该停下来——这些元决策,人目前还是做得比 agent 好。
对每天调 agent 的人,这个结论有个直接推论:给 agent 加预算,不如给 agent 加「剪枝」。与其让它在一个错误方向上烧 10 倍 token,不如每 20 分钟停下来看一眼它的中间产物。KLS 团队的「迭代式人工剪枝」,翻译成工程语言就是:checkpoint + 人工 review,而不是 fire-and-forget。
名词解释:这篇里的数学黑话
高维几何:研究高维空间里形状性质的数学分支。直觉在高维会失效——比如高维球体的体积几乎全集中在表面附近。这种「反直觉」正是 KLS 这类问题难的原因。
对数凹测度(log-concave measure):一类「形状良好」的概率分布,高斯分布是典型代表。KLS 猜想讨论的就是这类分布,所以结论能覆盖统计和机器学习里的大量实际场景。
Cheeger 常数 / Poincaré 常数:衡量一个分布「瓶颈」有多细的数学量。瓶颈越细,随机游走越难穿过去,采样越慢。KLS 本质上是在说:这类分布的瓶颈不会细得离谱。
迭代对数(log* n):对 n 反复取对数直到 ≤1 所需的次数。n=10100 时 log* n 也只有 5——增长极慢,但数学上「增长就是增长」,不算 O(1)。10 月 1 日版本卡在这里,10 月 4 日版本跨过去了。
Lean 4:一种定理证明器的语言,可以把数学证明写成机器可逐行检查的形式。这次 KLS 证明的 Lean 形式化,是「机器检查数学」趋势的又一个里程碑。
补充一个时间线细节:论文 10 月 1 日挂 arXiv 初版时,证明还不完整(只到迭代对数);10 月 4 日的修订版才完成 O(1)。也就是说,最后那关键的三天,是「重复递归 + 误差有界」这个人类想法的落地期。Agent 铺了三个月的路,人用三天走完了最后一公里——这个节奏,恰恰是人机协作的常态:机器负责把路铺到 99%,人负责认出最后 1% 在哪。
为什么一条数学新闻值得 vibe coder 读完
可能会有读者问:VibeFix 不是报 AI 应用和 vibe coding 的吗,为什么报一条纯数学新闻?三个理由。第一,这是目前公开记录里「人机协作」最成功的硬核案例——不是写个小游戏、做个 demo,而是 31 年未解的猜想。所有关于「agent 到底能不能干正事」的争论,这条新闻都是一手证据。
第二,它定义了未来两年 agent 产品的形态。KLS 流程里的「并行探索 + 人工剪枝 + 第二验证者」,本质上就是下一代 coding agent 该有的样子:不是一个闷头干活的黑盒,而是一个「可检查、可剪枝、可验证」的协作界面。现在的 agent 产品(Codex、Claude Code、Copilot)都在往这个方向走,这篇报道是它们的理论注脚。
第三,它回答了 vibe coder 最深的焦虑:「agent 越来越强,我还有什么用?」KLS 的答案是:你的用处从「写」变成了「判」——判断哪个方向值得走、哪个结果可信、什么时候该停。在这个分工里,人的品味和判断力不是被替代了,而是被放到了更重要的位置。这或许是这条数学新闻里,最不数学、却最值得带走的一句话。
 微软研究院官方 KLS 猜想示意图:平面切割 vs 最小曲面切割
评论 (0)
原始来源
相关文章
字节跳动 Seed 实验室 10 月 13 日成立独立的模型对齐与准备部门,中国前沿实验室首家。首批 10 名研究员、算力与模型团队对等,职责覆盖 agent 测试与 CBRN 风险——恰与 OpenAI、腾讯同周披露 agent 失控事件。
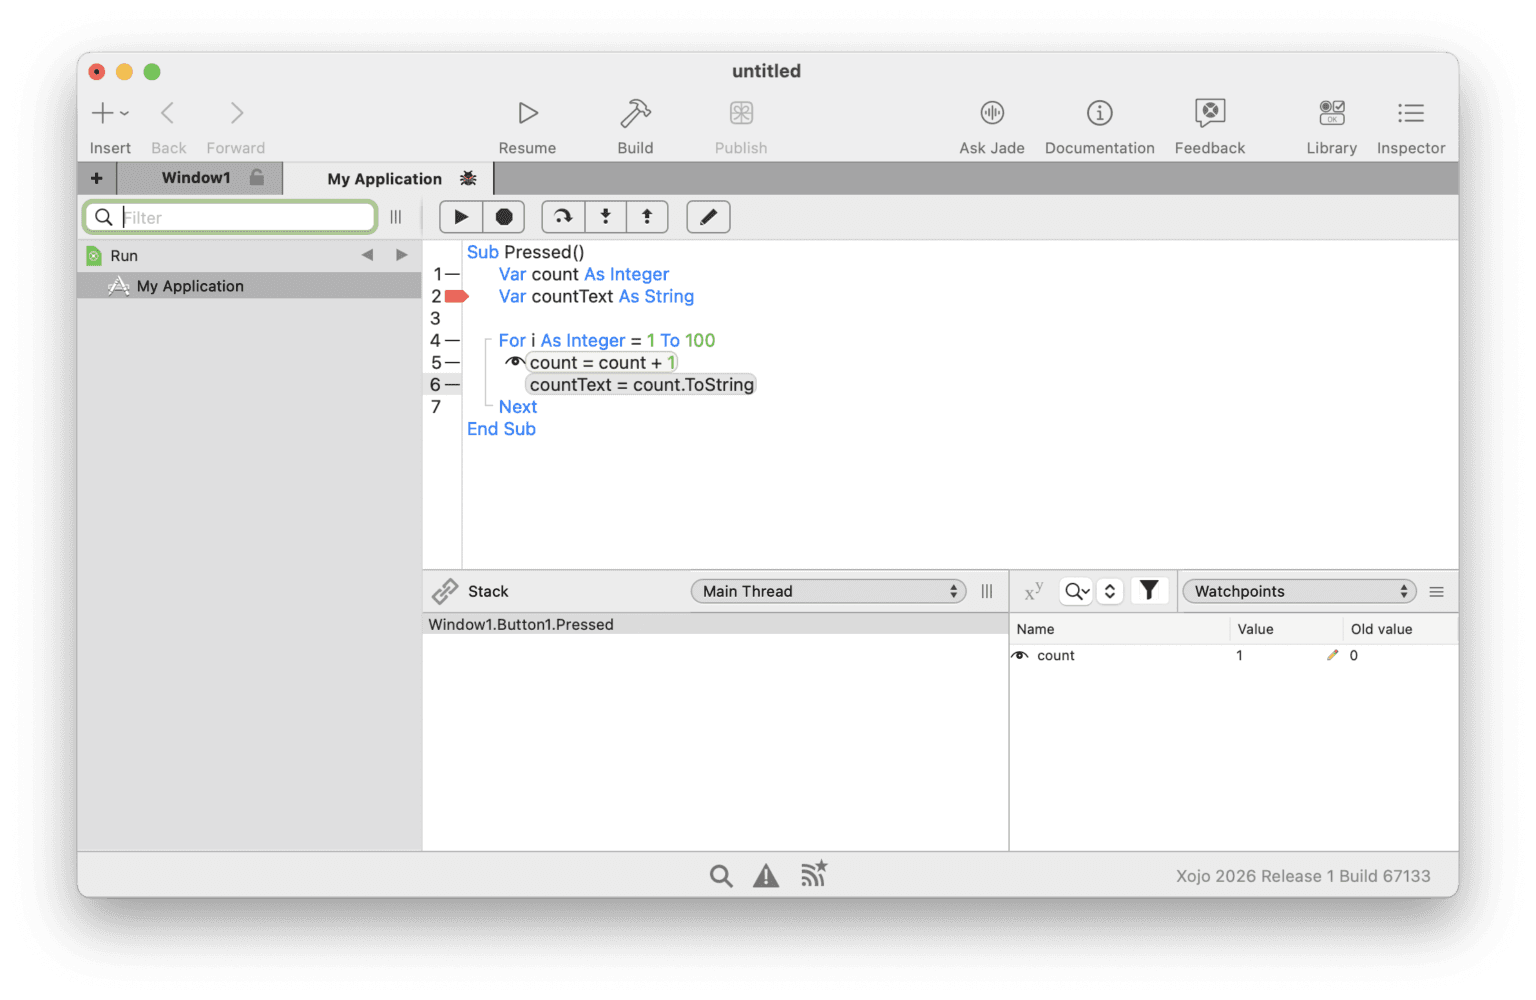
Xojo 2026 Release 3(10-20)上线 Agentic Mode:外部 agent 改项目文件,IDE 自动重载、调编译器编译、把错误交还给 agent,形成真正的编译-重载-修复闭环。30 年 RAD 老兵转向 agent,是对“AI 只属于新工具”叙事的有力反证。
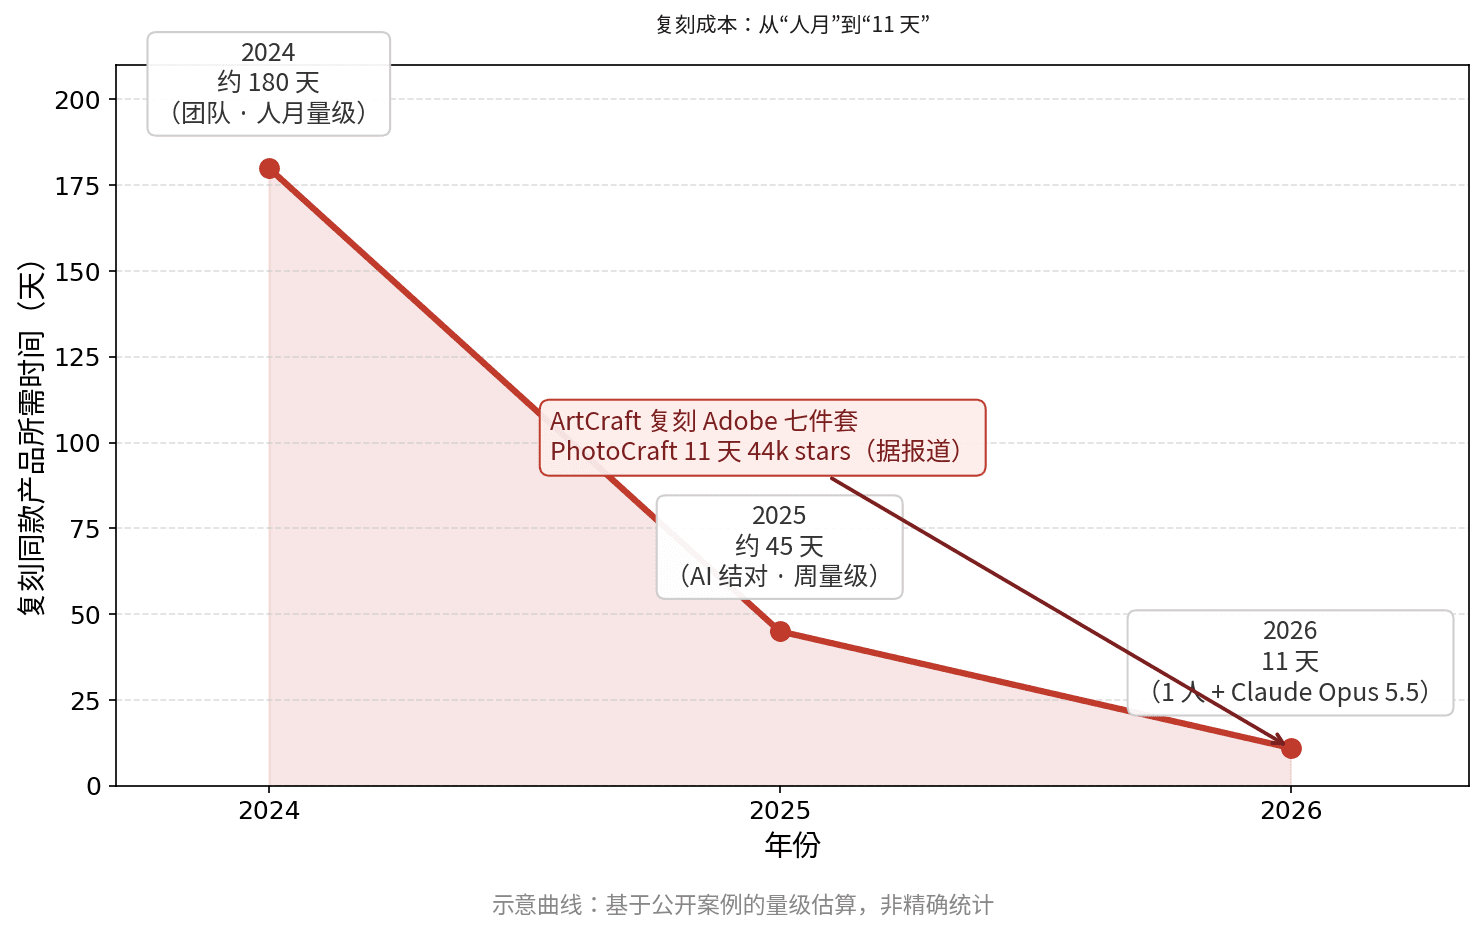
2026 年 AI 把克隆成本打到趋近于零:Steam Next Fest 开发者提交量据报道同比 -18%,一位开发者用 Claude Opus 5.5 十一天复刻 Adobe 全家桶、拿下 44k stars。功能不再是护城河。本指南给出 vibe 项目的反克隆预案:数据/网络/身份三层护城河框架、速度与社区绑定的实操、免费版可抄而核心放服务端的分层防御、被抄当天的 72 小时清单,以及 8 项护城河健康度自查。