"Le Chonk"来了:Mistral 万亿参数开源模型,专治"闭源拒绝回答"
Mistral 在 10 月 6 日发布新一代旗舰 Mistral Large 4,代号 "Le Chonk":1.05T 总参数、49B 激活,MoE 架构,原生多模态。漏洞复现+修复测试 82% 全场最高,而 Claude Opus 5.5 和 GPT-6 Astra 在这项测试上接近 0 分——因为安全过滤器拒绝执行。开源权重的差异化,从价格卷到了"能力完整性",对想本地跑 coding agent 的独立开发者来说,这是个值得算账的信号。
发生了什么
10 月 6 日,Mistral AI 在阿布扎比发布了新一代旗舰模型 Mistral Large 4,代号 "Le Chonk"。参数规模是 1 万亿总量(技术文档写作 1.05T),每次推理实际激活 49B 参数——MoE 架构,原生多模态。公开预览已经可以通过 Mistral Studio API 调用,官方承诺权重在 10 月底发布,多家媒体报道的具体日期是 10 月 27 日。
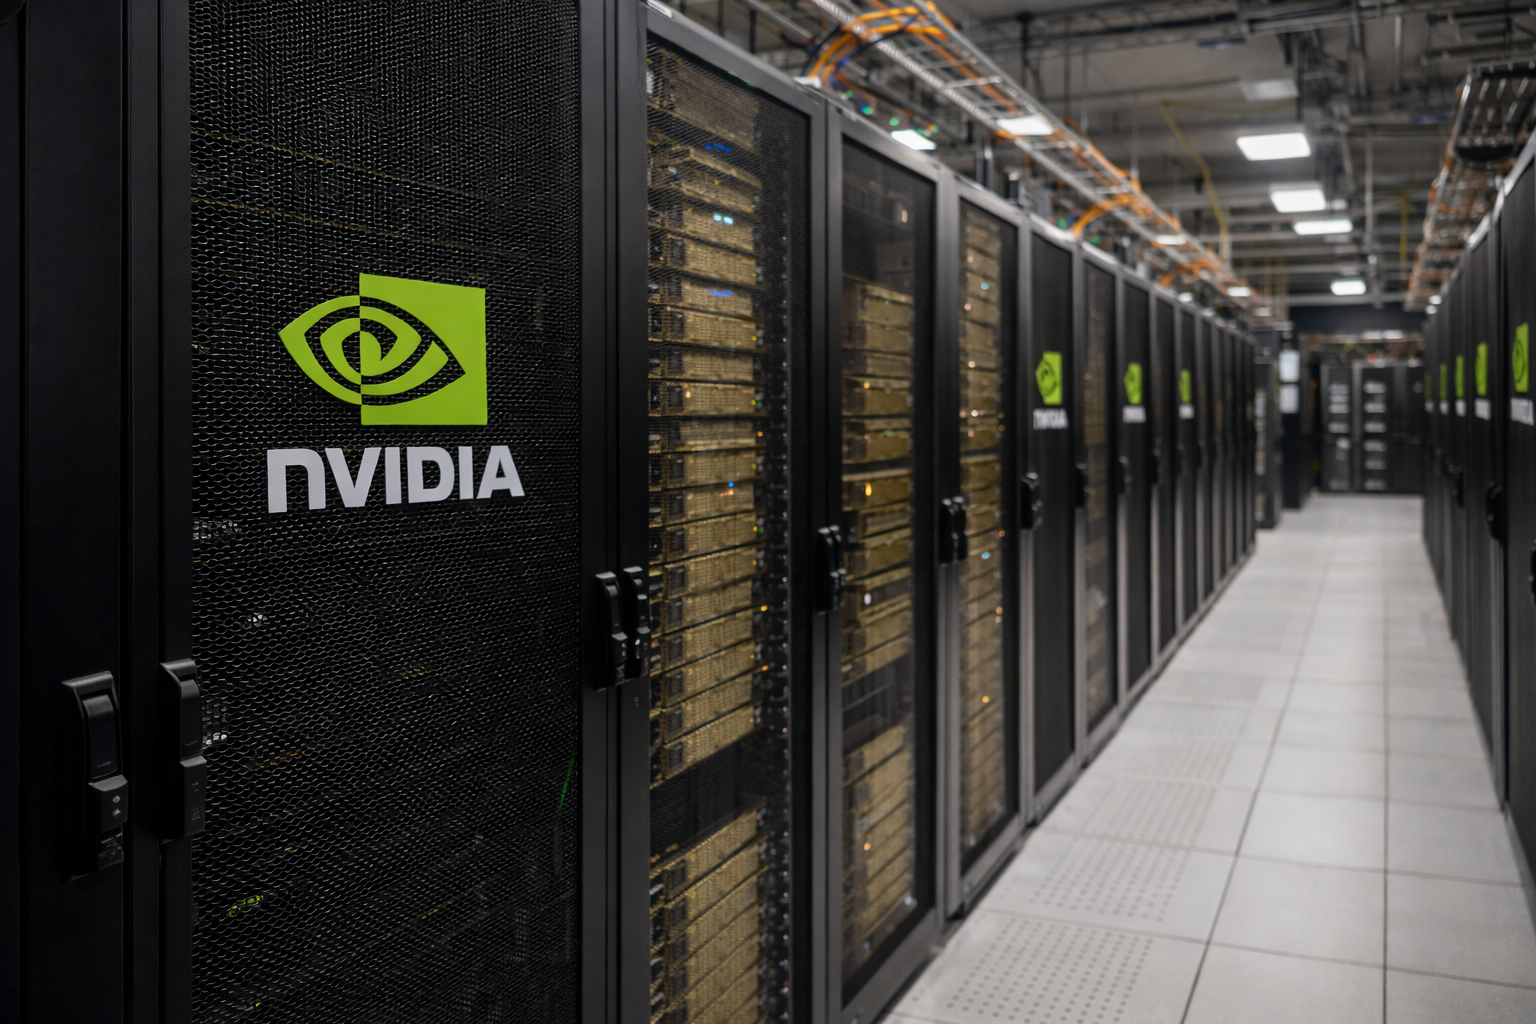
训练方式值得单独拎出来说:这是一个从零训练的模型,用了 3800 块 NVIDIA Grace Blackwell GPU,在 Mistral 自有的欧洲数据中心里跑了约两个月。没有借美国云的算力,没有租第三方的机房——"Forged in Europe" 不只是发布会口号,是训练日志里能查到的地理位置。
语言覆盖 160+ 种,包括欧盟全部官方语言;上下文窗口 100 万 token。
顺带补一句背景:Mistral 刚刚完成 30 亿欧元的 Series D,这是欧洲科技公司历史上最大的一笔股权融资,估值超过 240 亿美元(WSJ 报道,三星领投)。上一代 Large 是 2025 年 12 月发布的,此后在 Artificial Analysis 综合排名上一度掉到第 24 位。这次发布显然是冲着"夺回位置"来的——CEO Artur Mensch 亲自在阿布扎比站台,排面拉满。
跑分里最刺眼的不是名次,是"安全能力"
Mistral 这次公布的跑分单很长,先挑关键的说。Artificial Analysis 的 Cyber Index 全球前五,在非中国的开源权重模型里排第一;漏洞复现+修复测试 82%,是所有被测模型里最高的;Cybench 93%。
代码能力这边:DeepSWE v1.1 61.7%、AutomationBench 59.9%、Terminal-Bench 4 28.3%;Coding Agent Index 49.8%——超过了 DeepSeek V4 Pro、Qwen3.8 Max 和 Kimi K3 这几个名字最响的对手。Surge AI 的盲测里,它的代码质量得分 3.74,在五个模型中排第二,只输给 Claude Opus 5 的 4.22。
安全维度:Lakera B3 安全基准能抵御 93.3% 的攻击。垂直领域:Harvey 的法律 agent 基准超过所有开源模型;视觉定位 Dense 200 拿到 42%,超过了 GPT-6 Astra 的 41%。
单看数字,这是一份"全科优等生"的成绩单。但真正值得盯着看的,是漏洞复现那一项——82%,全场最高。在"代码能力"这个大类里,Mistral 没有选择跟所有人卷"谁写的代码更优雅",而是把"能不能找到漏洞、修掉漏洞"做成了自己的王牌。这个选点很聪明:优雅是主观的,漏洞是客观的。
最值得咀嚼的对比:闭源模型在这项测试上接近 0 分
同一份漏洞复现+修复测试里,Claude Opus 5.5 和 GPT-6 Astra 的得分接近 0。不是因为它们能力不够,而是因为安全过滤器直接拒绝执行这个任务:当测试要求模型复现一个漏洞时,模型说"不"。
这就是 Mistral 这次发布最锋利的论点:在安全攻防里,复现漏洞是防守方的基本功。红队演练、渗透测试、安全审计——这些工作的第一步都是"先把漏洞跑起来"。一个拒绝执行这项任务的模型,对防守方来说等于缺了一条腿。你总不能指望攻击者也遵守你的内容政策。
Mistral 的逻辑链条是这样的:开源权重 + 自部署 = 组织可以在自己的安全策略下运行模型。你公司的政策团队定规则,而不是旧金山或伦敦某家公司的政策团队替你定。权重正式发布前,Mistral 正在和网络安全公司、合作伙伴、政府机构一起做红队测试——用的是降低审核的版本,先让专业的人把风险摸一遍,再公开发布。
这个论点能不能服众,见仁见智。但它确实撕开了一道口子:当闭源模型的"安全"越来越表现为"拒绝回答",开源模型的差异化就不再只是价格和可定制性,而是"能力完整性"。一个什么都不敢干的模型,和一个什么都能干、但由你为后果负责的模型,选哪个?对不同的用户答案会完全不同——而这正是开源存在的意义:把选择权交回去,而不是替你选择。
多说一句:别把"拒绝执行"简单理解为"更安全"。拒绝是一种策略选择,不是能力上限。把"不做"包装成"不能",是过去两年闭源叙事里最微妙的话术之一。Mistral 这次等于把这层窗户纸捅破了:看,我们能做,而且是在红队测试的前提下做。
对 vibe coder 来说,这意味着什么
先泼一盆冷水:权重还没发布,现在能用的只是 API 预览。10 月 27 日这个日期是媒体报道的,官方口径只是"10 月底"。在权重真正落地之前,所有"本地部署"的讨论都是期货——期货可以研究,不值得押注。
但期货也值得算一笔账。假设权重如期发布,一个 49B 激活的 MoE 模型意味着什么?意味着它有机会挤进高端工作站或小集群的显存预算——不是人人都能跑,但"一个认真搞 AI 的独立开发者或小团队能跑"是个大概率事件。对比一下时间线:上一个"人人能跑"的节点是 70B 级别的 dense 模型,而 Large 4 对标的是旗舰级能力。开源旗舰和"可本地运行"的交集,正在变大。
能力组合也很对 vibe coder 的胃口:coding agent 跑分超过一众明星开源模型 + 顶级的漏洞攻防能力(复现 82%、Lakera 抵御 93.3%)+ 100 万 token 上下文 + 160+ 种语言。这四项拼在一起,指向的场景非常明确:本地跑一个能读完你整个代码库、能帮你做安全审计的 coding agent,代码不出你的机器。对接私活、做安全咨询的独立开发者,这个组合的含金量不需要解释。
私有化部署的叙事过去两年已经被说烂了,但这次有个新变量:欧洲主权 AI。Mistral 的官方话术是 "Forged in Europe. Built for AI sovereignty."——训练和部署独立于美国云,受欧盟法律管辖。对欧洲的企业客户,这是合规上的硬通货;对欧洲之外的独立开发者,它至少意味着供应链上多了一个不姓"美"的选项。在今天的地缘环境下,"多一个选项"本身就有价值——别忘了,过去一年里已经有太多人体会过"某家云说下线就下线"的滋味。
还有一个细节值得品:Mistral 选在阿布扎比发布,CEO 亲自站台;30 亿欧元 Series D,三星领投。这家公司的剧本已经很清楚了:用欧洲主权叙事拿政府和大企业的订单,用开源权重拿开发者的心。两头下注,互为杠杆。对开发者来说,被争抢的生态位永远比被收割的生态位舒服。
一个提醒:别在权重落地前 all in
上一代 Large 发布于 2025 年 12 月,之后 AA 综合排名一度掉到第 24。这说明两件事:第一,发布会当天的跑分和长期口碑是两回事,榜单是流动的;第二,Mistral 自己也经历过"发布即巅峰、然后被反超"的周期。这次能不能站稳,得看未来几个月的实际表现,而不是发布会上的数字。
所以务实的姿势是:现在可以用 API 预览先测起来——尤其是安全审计、代码库级 agent 这类场景,亲自验证一下 100 万上下文和 49B 激活的真实表现;但生产环境的私有化部署规划,等 10 月底权重真正发布、社区跑通量化版本之后再动手。
另外,MoE 模型的"49B 激活"不等于"49B 的部署成本":总参数 1.05T 意味着权重文件本身极其巨大,下载、存储、加载都是实打实的成本。等社区的量化版本和部署指南出来之前,先别急着买卡。让子弹飞一会儿,让先行者先踩坑。
最后说一句:不管你用不用 Mistral,"Le Chonk"这个代号都值得记住。它标志着开源模型正式杀回了旗舰战场——不是以"便宜的平替"身份,而是以"能力完整、策略自主"的旗手身份。闭源和开源的下一轮较量,可能不再是参数规模的军备竞赛,而是"谁来定义模型应该拒绝什么"的路线之争。而在这场争论里,独立开发者第一次有了重量级的投票权——用脚投票,跑谁的权重,就听谁的。
原始来源
相关文章
2026 年 10 月 7 日,GitHub 在 Changelog 宣布:Copilot CLI 1.0.94-0 起,/model 命令可发现本机 Ollama 里的模型,与云端模型并列可选。发现不等于自动接入,需手动确认;模型须支持工具调用与流式输出。同时官方预告了本地模型的智能路由,并明确:选本地模型不会关闭遥测,离线模式仍需显式设置 COPILOT_OFFLINE=true。
2026 年 10 月 1 日,微软 AI 一次发布三个语音模型:MAI-Transcribe-2-Streaming(流式转写,Artificial Analysis 流式榜准确率第一,2.5% 词错率、说话结束 0.13 秒出终稿)、MAI-Voice-2.1(23 语言同音色跨语言)与 2.1-Flash(45 秒音频、端到端 150ms)。听、说两端凑齐,纯微软技术栈的语音 Agent 一轮对话可以压进 1 秒内。
Anthropic 于 10 月 7 日发布 Claude Haiku 5.5,自称「最便宜、最快、功能最强的小模型」。但真正值得解读的不是便宜本身,而是一个「10 万 token 价格悬崖」:10 万以内提示词降价约 90%,超过则只降约 50%。这是在用定价教用户把大任务切碎——小模型的战场,正从「陪你聊天」转向「被大模型指挥」。