OpenAI 让 AI 学会说 COBOL:开源 MultiLangBench 要求模型从零重写 SQLite,迁移准确率从 5.4% 干到 97.9%
OpenAI 10 月 19 日发文,把 COBOL、Fortran、Visual Basic 这些"低资源语言"第一次变成可测量的能力:开源 MultiLangBench(只给文档、从零实现 SQLite 3.40.1,覆盖 20 种语言),外加一套要求字节级一致的 COBOL 迁移测试。GPT-6.1 Sol 迁移准确率从上一代的 5.4% 干到 97.9%。但所有数字都是 OpenAI 自报的——本文逐项打折,并给出三条给老系统维护者的实操建议。
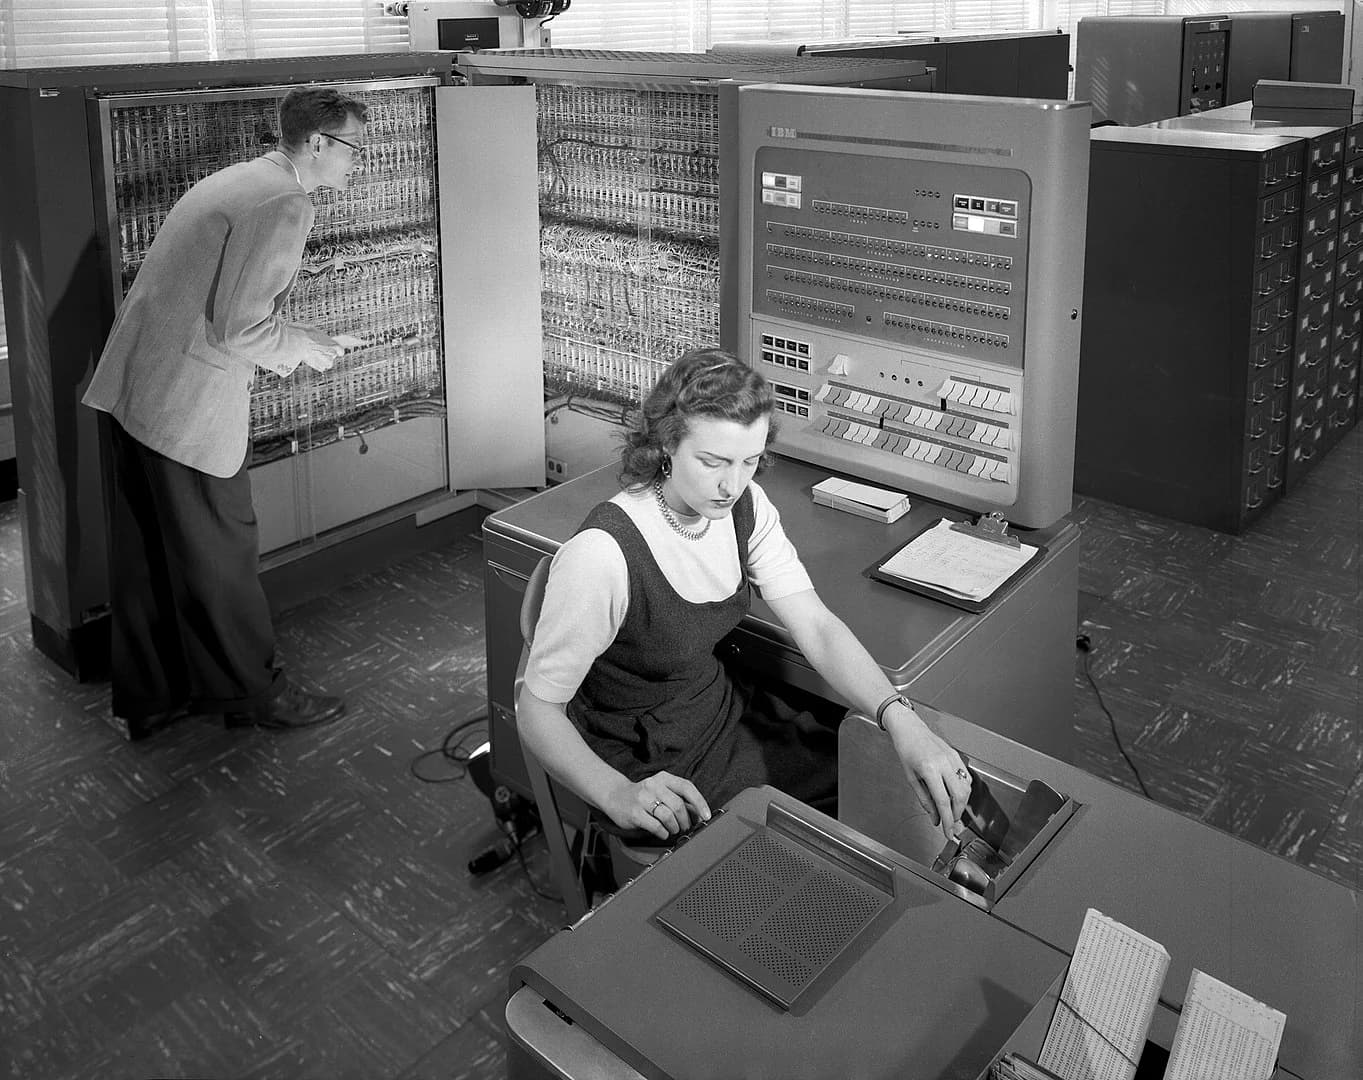
2026 年 10 月 19 日,OpenAI 发了一篇不太"性感"的研究帖,标题是《Advancing coding in low-resource programming languages》(推进低资源编程语言的代码能力)。没有新模型发布,没有发布会,甚至连一个像样的 demo 视频都没有。但如果你做的东西跟真实世界的老系统沾边,这可能是 OpenAI 今年最值得细读的一篇技术公告:它第一次把"AI 能不能搞定 COBOL 这种上古语言"变成了一件可以测量的事,还顺手开源了一套评测——MultiLangBench,要求模型只看文档、从零重写一个 SQLite。
这件事有意思的地方不在于分数有多高,而在于它暴露了一个长期被掩盖的真相:我们天天谈论的"AI 写代码革命",其实只发生在 Python、JavaScript、TypeScript 等少数几种"富资源"语言里。一旦离开这个舒适区,AI 的表现会断崖式下跌。而恰恰是那些 AI 最不擅长的语言,支撑着银行、税务、天气预报和核反应堆安全分析。OpenAI 这次选择直面这个断层,值得认真对待——当然,成绩单上的数字全部来自 OpenAI 自己,先把"厂商自报"四个字钉在这里,后面我们会逐项打折。
你的银行还在跑 COBOL,你的 AI 助手却看不懂它
先建立一个基本认知:COBOL 不是什么博物馆里的古董。OpenAI 在帖子里引用了一组数字:COBOL 支撑着全球超过 40% 的在线银行系统、80% 的线下刷卡交易和 95% 的 ATM 交易。Fortran 则至今仍跑在天气预报模型和核反应堆安全分析里。Visual Basic 也一样,大量企业内部系统还靠它续命。这些语言有一个共同点——在公开互联网上能找到的代码和文档少得可怜,远不能和 Python、JavaScript 相比。OpenAI 把它们称为"低资源语言"(low-resource languages),意思是:训练数据少,模型见得少,自然也学得差。
这就形成了一个荒诞的对照。一边是各家大厂 coding agent 你追我赶,SWE-bench 分数刷到飞起;另一边是银行 IT 部门的真实困境:当年写 COBOL 的那批工程师大多已经退休,文档残缺不全,最关键的业务规则——比如一笔利息到底怎么算、一个舍入发生在第几位小数——只存在于代码本身。你让最强的 AI 编程助手去读一段 40 年的 COBOL,它大概率会一本正经地胡说八道。这不是模型"笨",而是它在训练时就没见过几行像样的 COBOL。
断层的一边是代码,另一边是人,而人的问题更急。2019 年的一项从业者调查显示,COBOL 程序员的平均年龄是 58 岁,每年约有 10% 退休;德勤委托 Forrester 做的调查则发现,71% 的大型机团队报告人手不足。ACT-IAC 的一份传统代码现代化报告估算,仅美国就有 84,000 个大型机岗位空缺,无人填补。这个剧本在疫情期间已经预演过一次:2020 年新泽西州的失业救济系统在申请洪峰下崩溃,州政府不得不公开呼吁退休的 COBOL 程序员回来救火。"政府求退休人员回来修关键基础设施"——这张画面正在以更大的规模,成为银行业的日常。
更要命的是,这些系统不是"等着被替换",而是越用越多。Micro Focus 的全球调查估算,每天约有 8000 亿行 COBOL 代码在生产系统里运行,92% 的受访企业把 COBOL 视为战略资产,超过一半预计自家的 COBOL 应用至少还要再跑 10 年。美国国税局、社会保障署、财政部、退伍军人事务部,全都跑在 COBOL 上。如果 COBOL 明天停摆,美国经济的大片区域会在几小时内陷入停顿。这不是怀旧,是承重墙——而承重墙的维修工,正在以每年 10% 的速度退休。
所以 OpenAI 这次要解决的不是"让 AI 写出更漂亮的 Python",而是"让 AI 在没见过多少样本的语言里也能干活"。这对 vibe coding 时代同样有意义:今天你用 AI 搭一个新项目,选的都是主流技术栈;但明天当你想用 agent 去接管一个十年前的内部系统、或者给客户的老代码做迁移时,模型的"低资源语言能力"直接决定了它是帮手还是灾难。
两个新考试:从零造一个数据库,再把老代码搬走
OpenAI 设计了两套评测,分别考察两种能力:一种是"从零构建",一种是"无损迁移"。前者叫 MultiLangBench,后者是 COBOL 迁移测试。两者都已经公开,前者更是直接开源(Apache-2.0,放在 openai 的 GitHub 组织下)。
MultiLangBench:只给文档,重写 SQLite
这个测试的想法很"粗暴":给模型一份 SQLite 3.40.1 的官方文档,不给源码,然后要求它用 20 种编程语言中的一种,从零实现一个与 SQLite 兼容的数据库引擎。判分方式是:把模型写出来的可执行文件跑一遍测试,测试用例是从 SQLite 自家的 TCL 测试套件转换来的,大约 24,000 个(日常跑可以用 272 个的子集,省钱)。最巧妙的是"裁判"的设计:不检查模型的输出文本像不像 SQLite,而是让真正的 SQLite 3.40.1 去读取模型产出的数据库文件——文件格式对不对,一读便知,想靠背诵糊弄过去没那么容易。

而且 OpenAI 在仓库 README 里写了三条明确的防作弊规则:第一,评测环境里必须清除一切现成的 SQLite(库、可执行文件,连 Python 自带的 sqlite3 都不行),防止模型直接 import 作弊;第二,全程断网,模型下不到 SQLite 源码;第三,写错语言或混用语言,通过率直接判 0 分。评分本身也是一个二元组——(通过率,API 成本),把"花多少钱"写进了分数里。一个考 60 分花几美元的模型,和一个考 62 分花十倍价钱的模型,在这里是两种不同的产品。这个设计值得所有做 agent 评测的人抄作业:成本本来就该是能力的一部分。
这 20 种语言的名单本身也值得细看:除了 COBOL、Fortran、Visual Basic、OCaml 四个"低资源"主角,还有 C、C#、C++、Common Lisp、Go、Java、JavaScript、Lean、PHP、PowerShell、Python、Ruby、Rust、Scala、Swift、Zig。评测设计是语言无关的——给每个实现喂同一个初始数据库和一条 SQL 查询,比对输出数据库与参考实现是否一致,同一套测试逻辑横跨 20 种语言,不需要为每种语言单独写测试脚手架。这也是它最有野心的地方:以后任何一家想宣称"我们的模型最懂 COBOL",不用吵架,直接跑同一套题。便宜的 GPT-6 Luna 也值得单独看一眼:它在 COBOL 上只从 10.9% 涨到 17.1%,OCaml 从 25.6% 到 34.1%,Fortran 从 21.4% 到 31.4%——单样本成本 $0.77 对 $3.48。翻译一下:便宜档模型离"能在低资源语言里干活"还差得远,想做低资源迁移,暂时还得为推理预算买单,成本红利还没轮到中档模型。
COBOL 迁移测试:翻译老代码,但一个字节都不能差
第二个测试更贴近真实世界的痛点:把 COBOL 程序翻译成 C++、Java、Kotlin、Python 或 Rust。判分用的是隐藏测试集,要求输出字节级一致——迁移只有在全部测试通过时才算数。这里有个 OpenAI 特意点出来的"陷阱":COBOL 的定点数运算在没有明确请求舍入时会直接丢掉多余的小数位。所以一个"好心"帮你四舍五入的重写版本,跑起来毫无报错,却可能算出不一样的钱。在金融系统里,这就是事故。把"行为一致"而不是"看起来对"作为唯一标准,是这套测试最硬核的地方。
成绩单:从"几乎不会"到"接近跑满"(全部厂商自报)
下面所有数字都来自 OpenAI 10 月 19 日的帖子,没有任何独立第三方复测。先看结论,再打折。
- MultiLangBench(20 种语言平均,最大推理档):GPT-6 Astra 通过率 87.4%,上一代 GPT-5.6 Sol 只有 26.8%。Astra 在 20 种语言中的 19 种上都超过了 83%,COBOL 是唯一例外——但也从 10.9% 涨到了 72.1%。
- 分语言看:Fortran 从 21.4% 涨到 83.5%,Visual Basic 从 27.5% 涨到 89.4%,OCaml 从 25.6% 涨到 85.8%。注意 COBOL 依然是 20 种语言里最难的一个,72.1% 的"最好成绩"恰恰说明低资源语言的上限还远没到。
- 便宜的那个:GPT-6 Luna 在同一测试上拿到 40.3%,单样本 API 成本约 0.77 美元,上一代是 3.48 美元——便宜了约 78%。这意味着"够用且便宜"的中间档正在形成,不是所有任务都需要上最贵的模型。
- COBOL 迁移(低推理档):GPT-6.1 Sol 准确率 86.6%,上一代 GPT-5.6 Sol 同档只有 5.4%——从"基本不可用"到"可用",一代之差。同时 API 成本还低了 39%。
- COBOL 迁移(高推理档):GPT-6.1 Sol 达到 97.9%,OpenAI 的说法是"接近跑满这套测试"。上一代没有公布同档数据,无法对比。

5.4% 到 97.9%,这个跨度本身就说明了一件事:低资源语言此前的"不行",很大程度上不是任务本身不可解,而是模型根本没被认真训练过。一旦把数据、训练方法和评测补上,曲线的斜率会非常陡。这对所有"小语种"技术栈都是好消息——你的冷门语言不是注定被 AI 抛弃,只是还没轮到它吃训练红利。
三个判断:为什么这比又一个榜单重要
判断一:评测设计比分数更值得抄。这两年 AI 编程的榜单已经多到让人麻木,但 MultiLangBench 有三个设计是真诚的:第一,裁判独立于模型——用真正的 SQLite 当 oracle,而不是让另一个模型来打分;第二,成本写进分数——(通过率,API 成本)二元组逼着你回答"这分花多少钱买的";第三,防作弊规则写在明处——断网、清环境、语言合规判零分。对比之下,很多榜单连"模型有没有在训练时见过测试题"都不敢谈。如果你也在给团队的 agent 选型做评测,直接抄这套结构:公开 spec、独立 oracle、显式禁掉捷径、成本并列呈现。
判断二:低资源语言是模型能力的"暗物质"。主流语言的高分越来越不能说明问题——Python 代码在训练语料里堆积如山,高分可能只是在"背诵"。而低资源语言像一面镜子:数据少,背无可背,考出来的才是真正的泛化能力。OpenAI 这次把 COBOL、Fortran、VB 摆上台面,等于承认了一个事实:agent 要进真实世界,就得过"老系统"这一关。银行、政府、制造业的老系统不会因为 AI 只会 Python 就重写自己。谁先搞定低资源语言,谁就先拿到这批预算最充足、意愿最强烈的客户。
补充一个冷峻的数字:Gartner 在 2026 年 6 月的大型机预测里写道,2026 年启动的大型机下线项目中,超过 70% 将无法产生预期收益,首要原因就是对生成式 AI 工具的高估。这和 OpenAI 的分数不矛盾——它说的是另一件事:翻译准不准,和迁移成不成,是两个问题。Anthropic 在 2026 年 2 月的一篇 COBOL 现代化文章里把话说得更实在:AI 真正改变的是"发现与分析"阶段的经济学——把"搞清楚老系统到底在干什么"这件事变便宜,而不是让翻译本身 magically 正确。Cognition(Devin 背后的公司)在 2026 年 4 月公布的 Itaú Unibanco(拉美最大私营银行)案例也印证了这一点:重构速度提升 5 到 6 倍、零生产事故,但他们自己也明确划线——交易系统的全自主迁移"目前 agent 还做不到"。所以务实的姿势是:把 AI 当作知识转移的加速器,趁着还懂业务的老工程师没退完,把系统里的隐性知识榨出来、写成测试,而不是赌一次全自动翻译。窗口正在关闭,84,000 个空缺岗位不会自己长出来。
判断三:开源评测是这篇帖子最硬的通货。分数可以自吹,但把 MultiLangBench 开源(Apache-2.0)意味着任何人都可以拿 Claude、Gemini、DeepSeek 去跑同一套题。OpenAI 敢这么做,要么是对自家模型极有信心,要么是算准了"定义赛道"比"赢一次榜单"更值钱。对社区来说这是好事:以后再有人宣称"我们的模型最懂 COBOL",直接上 MultiLangBench 跑分,少废话。
而"谁来定义赛道"这场仗,OpenAI 并不是唯一的玩家。IBM 的 Watsonx Code Assistant for Z 在 2026 年 3 月更新到 2.8 版,专为 COBOL 转 Java 设计,通过 MCP 直连作业控制元数据、copybook 库和 VSAM 数据定义——它有 OpenAI 没有的东西:生产环境的上下文。AWS 的 Transform for mainframe(2025 年发布)打着"端到端大型机现代化 agentic 服务"的旗号,已经拿下了 Transamerica、Allianz、Marriott 这些参考客户。GitHub Copilot 也把 COBOL 解释、为无文档函数生成测试、重构建议写进了文档化的能力清单。格局正在变成:OpenAI 定义公开考试,IBM 和 AWS 卖"离生产系统更近",Anthropic 和 Cognition 卖工作流。考试分数只是入场券,真正的合同签在"谁手里有 copybook 和 JCL"上。这也是 OpenAI 把评测开源的精明之处——当不了离生产最近的人,就当定考卷的人。
该打的折扣:五点保留意见
泼五盆冷水,都是基于公开信息的合理怀疑,不是抬杠。
第一,污染风险真实存在。SQLite 的源码和 TCL 测试套件是公开的,几乎可以肯定在训练语料里。测试用例的命名用了 SHA-256 哈希、做了一层转换,能防住"背测试题",但防不住"背过 SQLite 源码"。一个背过源码的模型重写起来自然占便宜。跨语言对比(同一模型在 20 种语言上的表现差异)是更可信的读法——COBOL 明显弱于其他语言,恰恰说明这套测试还是测出了真东西。
第二,基准程序不等于 40 年的老系统。MultiLangBench 的任务是干净的:文档齐全、目标明确、有标准答案。而真实世界的银行核心系统是:文档缺失、业务规则散落在代码各处、牵一发而动全身。OpenAI 自己在帖子里也承认,生产级迁移仍然需要专家评审和针对业务规则的测试。97.9% 是在一个"出题人精心设计过"的测试上的分数,不是"明天就能重写你行里的核心账务系统"的通行证。
第三,数字全部来自出题人自己。截至发稿,没有独立第三方跑过 MultiLangBench 并公布结果。解释这篇评测的 explainx 也提醒:仓库初版只有 3 个 commit、目标语言列表都没在 README 里写全。这套测试的公信力,要等第一批独立复测出来才能真正确立。在那之前,所有"从 X% 到 Y%"的表述,都请在心里自动加上"据 OpenAI 称"。
第四,测试测的是"最干净版本的问题"。Tech Times 在 10 月 21 日的跟进分析里,把真实迁移的脏活列了个清单:copybook——被几十上百个程序共享的数据结构定义,改一处牵全身,而 OpenAI 的测试只测单文件程序;JCL——决定 COBOL 程序在大型机上如何被提交、如何分配文件的作业控制语言,翻译出来的程序单测全过,塞回 JCL 作业流里照样可能挂;CICS——银行柜面交易跑的交易中间件,迁移它等于连事务语义一起翻译。这些都不在测试范围内。OpenAI 自己在帖子里也承认,生产迁移仍需专家评审和针对业务规则的测试。97.9% 的真实含义是:"在出题人精心清理过的考场里接近满分",不是"明天能接管你行里的核心账务系统"。
第五,"看起来对但算得不一样"是最危险的失败模式。Factory.ai 的 Legacy-Bench 跑的是真实 COBOL 任务(多程序代码库里修 bug),发现模型会产生静默的错误输出:一个工资计算程序 29 个测试过了 24 个,扣款金额却是错的——没有报错、没有编译失败,悄无声息。44 个没有任何模型解出来的任务里,31 个是 COBOL 任务。2026 年 4 月发表在 arXiv 上的 COBOL-Coder(基于 Qwen2.5-Coder 微调的领域专用模型)也在论文里老实承认:评测只覆盖单文件程序,跨文件依赖、copybook、JCL 都没测。换句话说,连专门为 COBOL 微调的模型,都还没敢碰真实系统的脏活。OpenAI 的 97.9% 是重要的一步,但别把它当成终点线——终点线在 copybook 和 JCL 那边。
给从业者的三条实操建议
如果你手头真有老系统要维护,或者团队正在评估用 AI 做迁移,这三条比分数有用:
- 先让 AI 解释,再让它重写。把一段 COBOL/Fortran 丢给模型,先让它逐段解释业务逻辑,人工核对无误后再谈迁移。解释错了,重写一定错;解释对了,重写才有地基。
- 迁移之前,先有测试。OpenAI 这套测试的核心思想就是"行为一致是唯一标准"。你自己的迁移项目也一样:先把老系统的关键输入输出整理成测试集,迁移后逐项比对。没有测试的迁移,就是闭眼开车。
- 盯住小数点。COBOL 定点数那个陷阱不是个例——金融、税务、计费逻辑里,"看起来对但算得不一样"是最高发的事故类型。让 AI 重写这类代码时,把舍入规则、精度、边界值单独列成 checklist,逐项验收。
最后说一句:这篇帖子最让我在意的不是 97.9%,而是 OpenAI 选择在这个时间点做这件事。当所有人都在卷"AI 写新代码有多快"时,有人开始认真回答"AI 能不能接住旧世界"——而旧世界里,跑着的是我们的钱、我们的电网和我们的天气预报。AI 编程的下半场,很可能不是从零写出更多新应用,而是把过去六十年攒下来的老系统,安全地搬进下一个六十年。这场考试,OpenAI 先交了卷,还把试卷公开了。接下来,就看其他家敢不敢来考了。
评论 (0)
原始来源
相关文章
AI 选技术栈时优化的是"最快跑起来",而不是"三年后还合适"。本文给独立开发者第三条路:既不硬扛也不推倒重写——一套六步换栈实战流程,旧系统全程可运行,每一步都可回滚。
VideoGen 发布首个视频生成模型 Model 1:文字或图片输入,最长 10 分钟多镜头成片输出。其"思考中枢"先规划剧本节奏再生成像素,但成本与速度数字目前均为厂商自报。

10 月 17 日,开发者 Gathin T. 发帖称把爸妈的小米电视"vibe coding"了:Claude Code 经 Wi-Fi 找到电视、停用 25 个广告包、重写桌面启动器。他开源的 cleanyourtv 几天内拿下 10,700 个 GitHub star,覆盖 107 款机型实测。本文拆解让这一切成为可能的 ADB 链路、周末的集体狂欢,以及狂欢之下不应被淹没的三个警告。