你的 Agent Skill 是复制粘贴的:200 万次采用追踪揭示的供应链真相
10 月 8 日 arXiv 论文《Skill Constellations》用 git 历史重建了 agent skill 的复制网络:219 万次采用里一半 SKILL.md 是逐字复制,top1% 仓库贡献 94.7% 传播,上游修复到不了已安装的副本;按传播网络排的 top100 审计能拦截 14.9% 后续高风险采用,按 star 排只有 0.5%。Star 识不出枢纽,缺失的更新通道才是结构性风险。
一句话:你的 Agent Skill 很可能是"抄来的",而且抄来就没再更新过
10 月 8 日,不列颠哥伦比亚大学的 Fahd Seddik 在 arXiv 上放出论文《Skill Constellations: Tracing the Supply Chain of Agent Skills on GitHub》(编号 2610.11169)。10 月 10 日,安全媒体 Ground Truth 跟进报道。这篇论文做了一件之前没人做过的事:把 GitHub 上所有 SKILL.md 文件的 git 历史扒出来,重建了 agent skill 的"复制网络"——谁抄了谁、什么时候抄的,第一次有了带日期的答案。
先说一下 skill 是什么,免得后面鸡同鸭讲。Agent skill 就是一个文件夹,里面装着 SKILL.md 的指令说明,外加一些脚本。Claude Code、Codex 这类 AI 编程 agent 读到它,就会按里面的指令干活——而且是拿着你的用户权限干活:跑 shell 命令、访问网络、改文件,一个都不少。所以装 skill 这个动作,更接近"装软件",而不是"收藏书签"。你以为你在收藏一份工作流说明,实际上你在给 agent 发一张权限 passes。
再看规模:2,193,119 次 skill 采用、259,596 个仓库、1,612,846 个不重复的 skill。最刺眼的一个数字是:GitHub 上一半的 SKILL.md 文件,是另一个文件的逐字复制(verbatim copy)。一半。你在 GitHub 上随手看到的 skill 说明,有一半是复印机吐出来的。
论文把单个 skill 的复制网络叫做 constellation(技能星座)。一个静态快照只能告诉你"哪些仓库现在装着这个 skill",只有 git 历史能告诉你"谁第一个装的、谁从谁那儿抄的、抄了几手"。这篇论文的全部发现,都建立在这张带日期的复制图上。此前的安全研究大多停留在快照层面:数一数哪些仓库装了某个 skill,或者一次只盯一两个 skill 看。这次是第一次有人把"传播"本身当成研究对象。
它是怎么"看到"复制的:方法论值得单独讲
这篇论文的方法部分,是 vibe coder 也能看懂、甚至能借鉴的。作者用的数据源叫 GitSkills(2026 年 7 月发布,归档在 Zenodo),收录的是 2025 年 10 月 1 日之后首次提交、带合法 front matter、文件名严格叫 SKILL.md、且不在 fork 仓库里的文件。然后他们把每个仓库默认分支里每条 SKILL.md 路径的完整 git 历史都拉了下来。
关键定义有两个。第一是 lineage(谱系):同一个 skill 被编辑改出来的各个版本,只要编辑链连得上,就归到一个谱系里,谱系的第一次出现就是它的 origin。第二是 copy event(复制事件):当一个 commit 一次性加入 10 个或更多 SKILL.md 文件,并且其中某个更早的采用者已经持有这些谱系里至少一半的现有版本,就判定这是一次"复制",那个更早的采用者就是来源。10 个文件这个阈值,是为了过滤掉"我自己写了几个 skill"的情况,抓住的是"我从别人那儿整包搬来的"。
作者还拿安装器(installer)的记录做了一次交叉验证:推断出的复制关系,和真实安装记录对得上,说明这套"看 git 历史猜谁抄谁"的方法不是纸上谈兵。当然论文也留了个严谨的尾巴:推断出的来源是"分发源",不是"原创作者"——一个仓库可能因为到处转载别人的东西而变得很有影响力,哪怕它一行原创指令都没写过。这个区分很重要,后面讲 star 的时候还会回来。
论文一共提了四个研究问题,翻译一下就是:skill 复制长什么样、为什么长这样(RQ1);哪些仓库是传播源头,star 能不能识别它们(RQ2);高风险能力在复制网络里分布在哪儿,修复能不能传到已有的副本(RQ3);审计应该审谁,按网络位置排是不是比按热度排更好(RQ4)。下面按这个顺序讲发现。
还有一个容易被规模数字掩盖的时间维度:这 219 万次采用,发生在不到一年里。论文只收录 2025 年 10 月 1 日之后首次提交的 SKILL.md——这个格式本身才十个月大。十个月,从零到 25 万个仓库、161 万个不重复 skill、一半文件是逐字复制。这种扩张速度,在软件生态史上是罕见的:npm 用了好几年才长到这个体量。Skill 生态是在"没有包管理器"的情况下,靠复制粘贴裸奔到这个规模的。基础设施的缺位不是未来的风险,是已经发生的现状——只不过之前没人把它画出来。
复制压倒原创:这条供应链是"抄"出来的
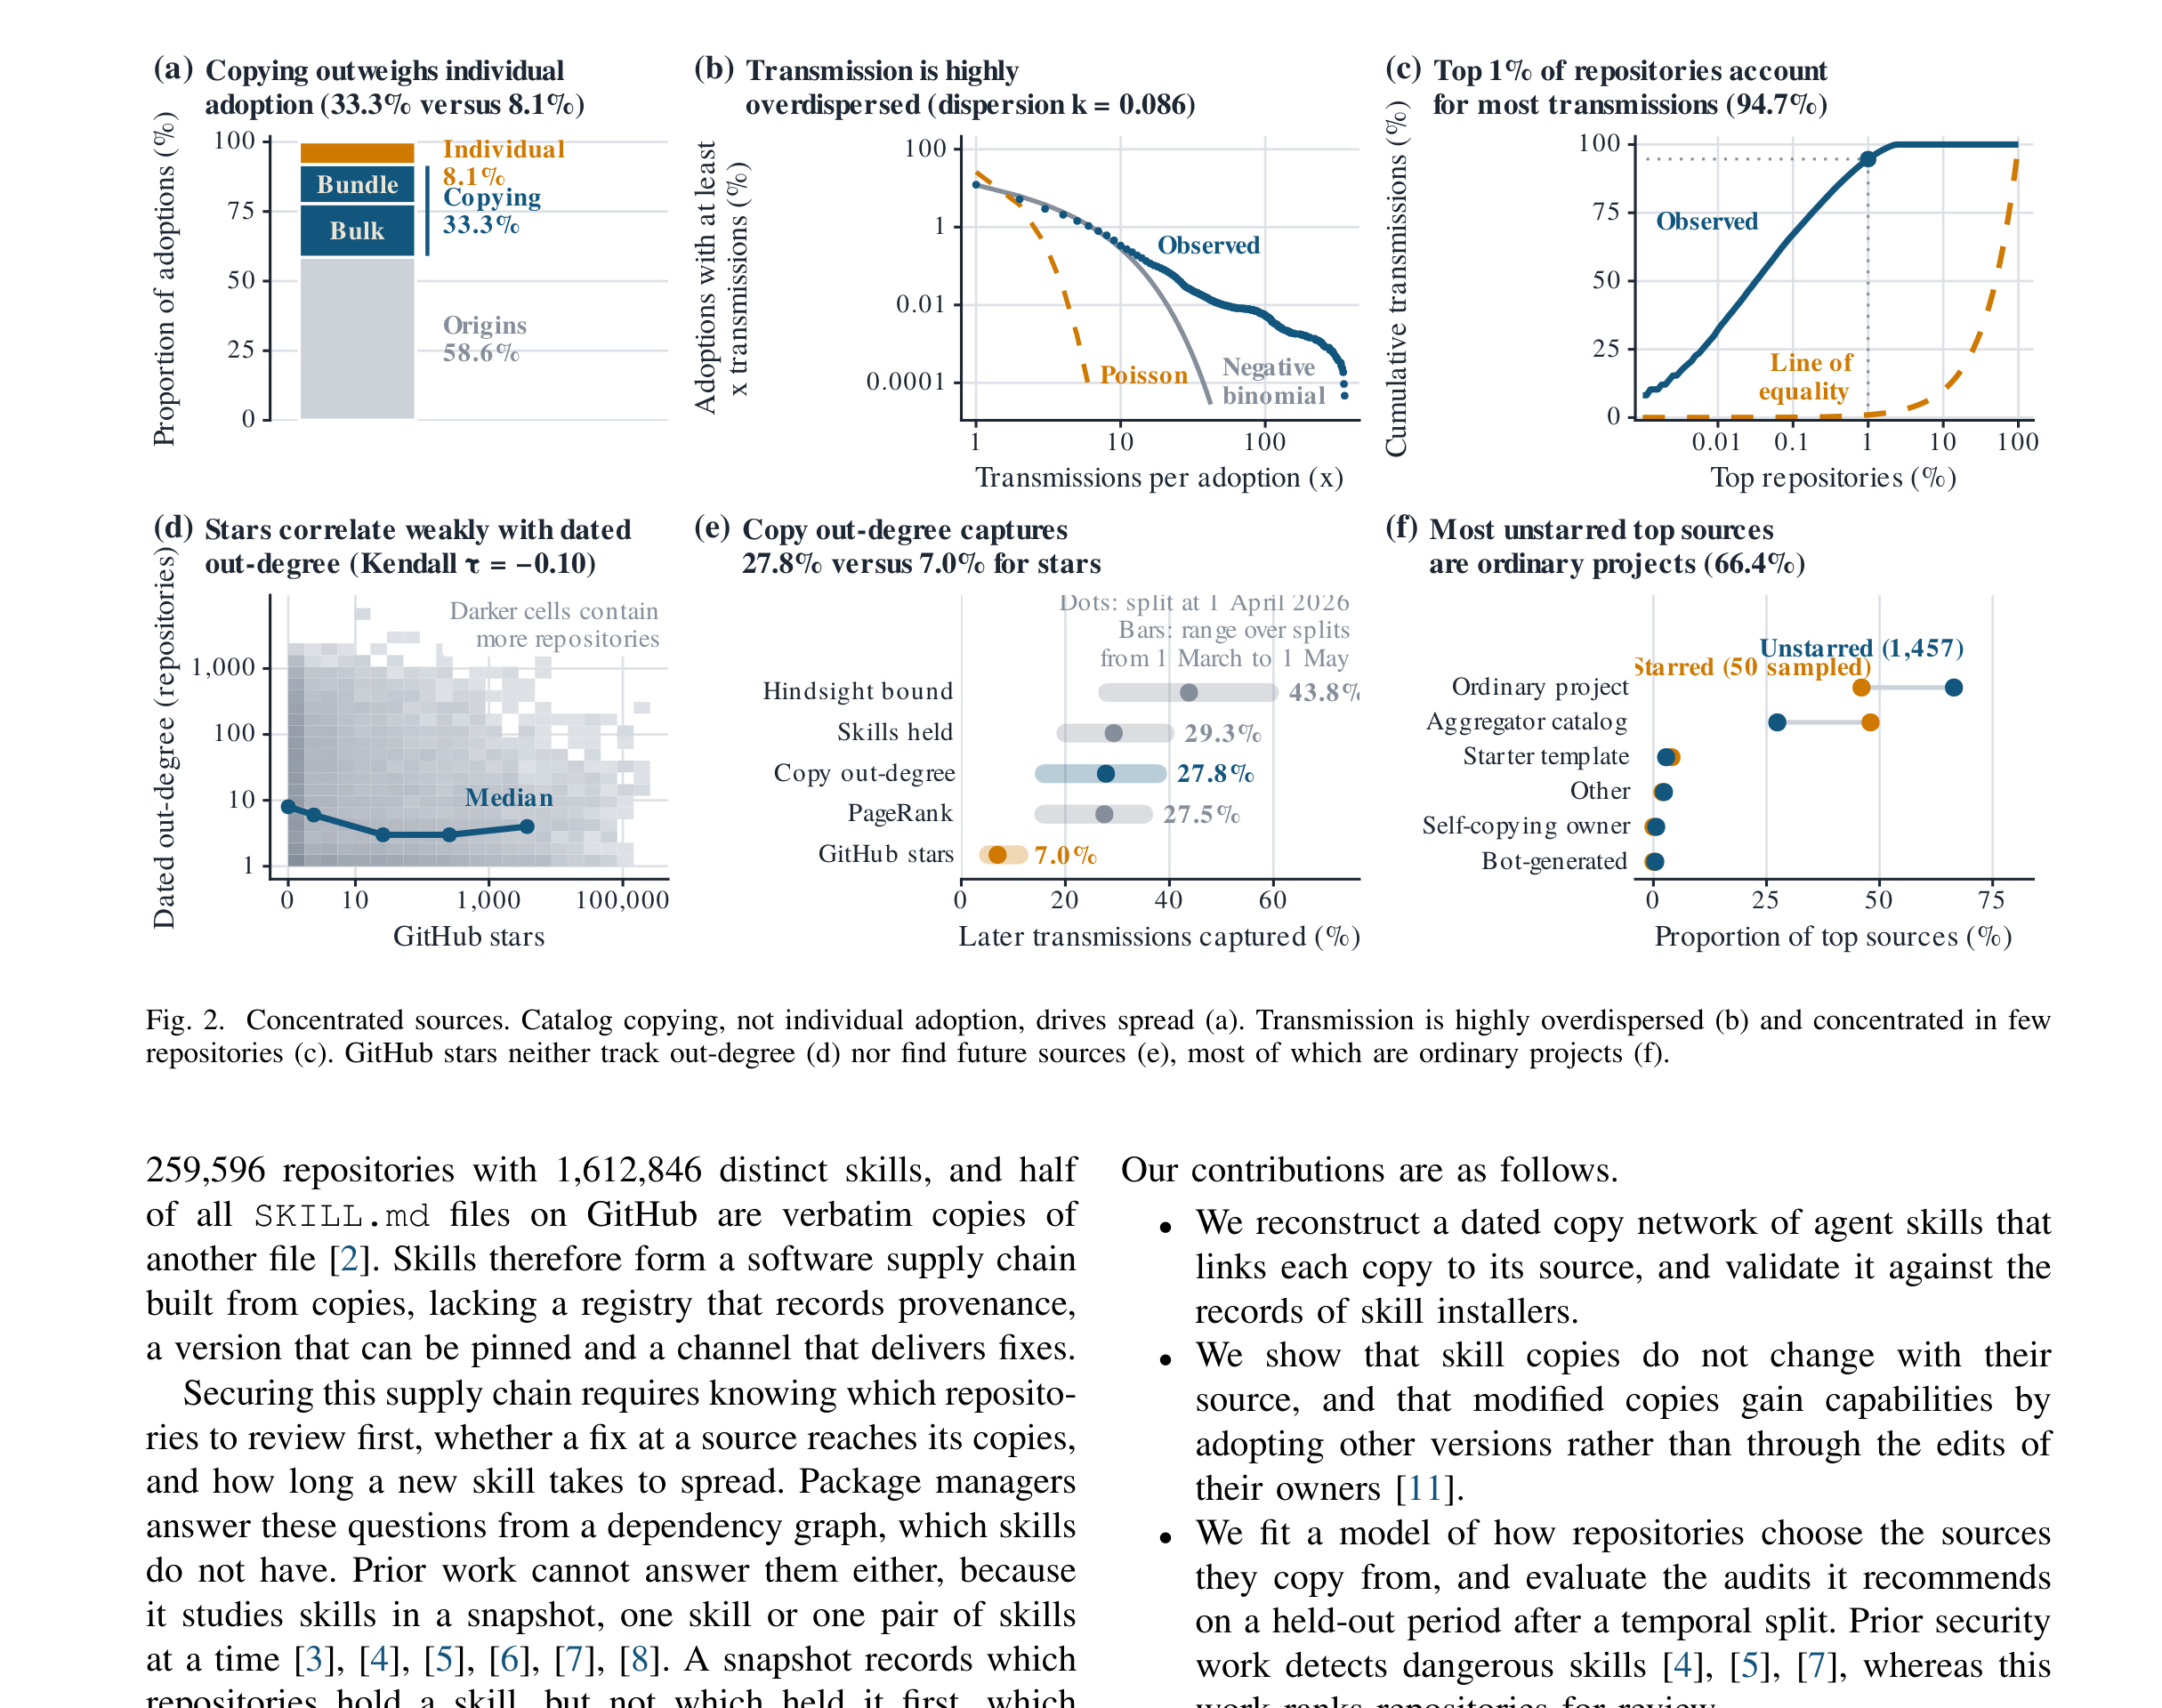
论文的统计很直白(图 2a):在全部 skill 采用中,33.3% 是复制来的,8.1% 是独立采用的,剩下的 58.6% 是源头。也就是说,一个 skill 出现在一个新仓库里,每三次里就有一次是直接抄的,而不是作者自己写的。
抄,还是集中地抄。传播高度集中在极少数仓库手里:top 1% 的仓库贡献了 94.7% 的全部传播(图 2c)。论文里举了一个具体的例子:web-design-guidelines 这个 skill,一共 972 个采用者,其中 490 次是沿着传播链抄出去的,最深的一条链抄了 12 代(图 1b)。想象一下:一个 skill 被转抄 12 手,传到第 12 个仓库的时候,它和源头还剩多少关系?中间但凡有一手改了点什么,后面的人根本无从知道。
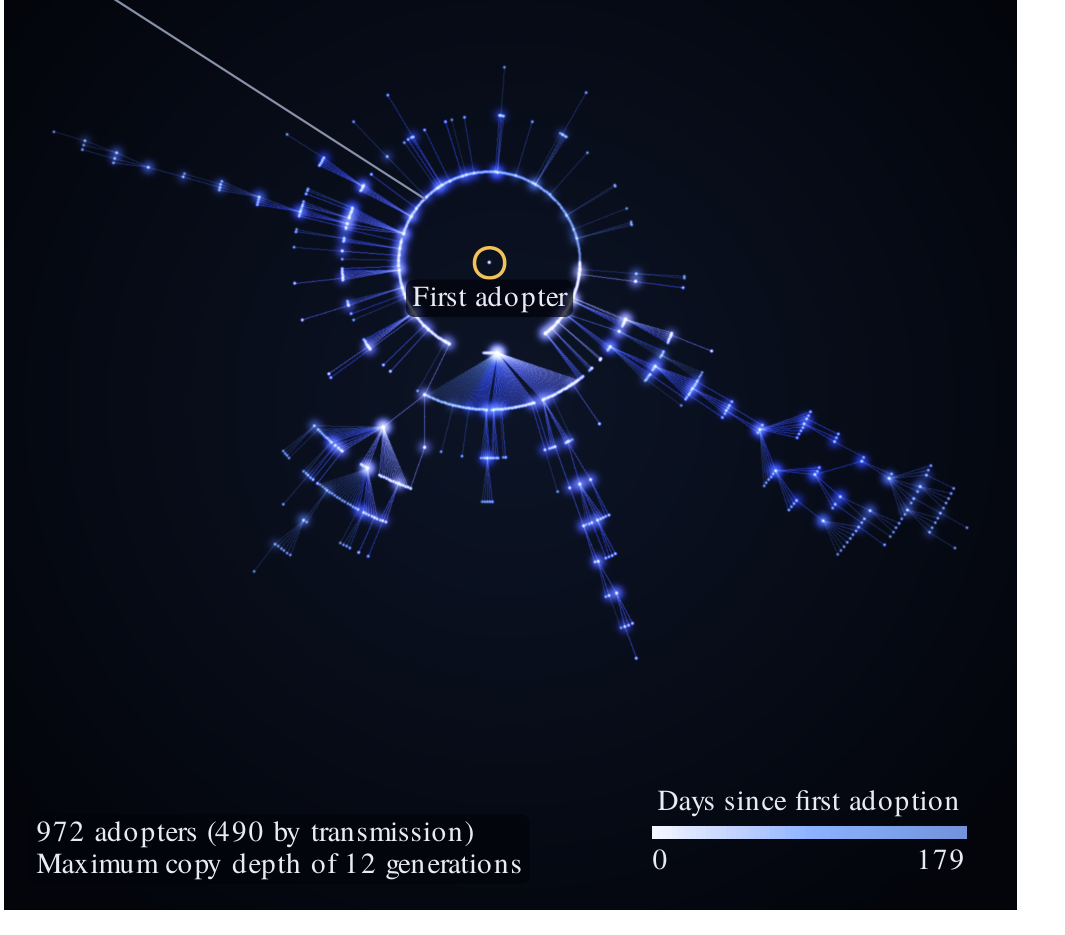
图 1a 是整个仓库网络的可视化:50 个成员过百的社区(按主题标注了其中 12 个),外环那一圈,是 64.2% 的"孤岛"仓库——它们装着 skill,但不参与传播。真正的传播枢纽,藏在中间那一小撮亮点里。看这张图的第一感觉应该是:skill 的世界不是"百花齐放",而是"几个源头 + 无数复印件"。
上游修了,你收不到:这条供应链没有"更新通道"
这是论文里对普通用户最扎心的一句:skill 副本几乎不随来源变化,上游的修复到不了已经装走的副本。
打个比方:公司把应急预案复印了贴在每层楼,半年后总部改了预案——墙上那些复印件不会自己更新。Agent skill 的分发在今天就是这个状态:没有注册表、没有版本号、没有出处记录。npm 有 lockfile 和 semver,pip 有 requirements.txt,连浏览器插件都有自动更新,skill 什么都没有。你装 skill 的动作,本质上是一次"复制粘贴",粘完之后,它和源头就断了联系。
对 vibe coder 来说,这意味着你仓库里、~/.claude/skills 目录下躺着的那一堆 skill,很可能是几个月前某个版本的 frozen copy。它带不带已知问题、作者后来修没修、修了你知不知道——三个问题的答案都是"不知道"。更麻烦的是,skill 不是普通文档:它是指令和脚本,agent 会拿着你的权限去执行它。一个 frozen 的旧版本 skill,风险不在于"过时",而在于"带着旧问题继续跑"。
Star 识不出枢纽:大家都排错了审计队
论文里最反直觉的发现是关于 star 的。Star 数和"被抄次数"(dated out-degree)的 Kendall 相关系数是 -0.10——基本不相关。一个仓库 star 再多,也不代表它是 skill 的传播源头;真正的枢纽,可能是一个没人 star 的普通项目。
作者做了一个模拟审计来验证:如果按传播模型排出的 top100 仓库去审计,能拦截 14.9% 的后续高风险 skill 采用;如果按 star 最高的 100 个仓库去审计,只能拦截 0.5%。三十倍的差距(图 2e)。更细的数据:用"被抄次数"排序能覆盖 27.8% 的后续传播,star 只能覆盖 7.0%;而那些没有 star 的顶级传播源里,66.4% 是普通项目(图 2f)——不是什么 awesome 列表,不是什么网红仓库,就是普通项目。
这句话值得做安全的人抄下来:大家装 skill 看 star,安全团队排审计清单也看 star——这篇论文说,两边看的都是错的指标。真正该审的,是传播网络里的枢纽节点。Star 衡量的是"注意力",复制网络衡量的是"内容实际怎么流动的",这是两回事。
多说一句实操的:如果你的团队今天就想动手,不用等论文的模型开源。把团队里所有 skill 的来源仓库列出来,按"被多少人抄"而不是"多少 star"排个序,排前面的那几个,就是你的审计优先级。审什么?三件事:它最近更新过吗,更新内容是什么;它声明的权限和实际行为一致吗;它的上游还有上游吗。十分钟能做完,但很少有人做。
被改过的副本:能力是"抄"来的,不是"写"出来的
论文还有一个容易被忽略的发现,关于那些"不是逐字复制"的副本。直觉上你会以为:副本被主人改过,说明主人在维护它,改动会让它越来越贴合需求。但数据说的是另一回事:被修改过的副本获得新能力的方式,主要是"又去抄了别的版本",而不是主人自己动手改。
这句话的信息量很大。它意味着 skill 的演化模式不是"分叉后各自生长"(像开源软件 fork 之后各自演进),而是"不断重新拼凑"。一个仓库的 skill 变强了,不是因为主人写了新东西,而是因为主人又从别处抄了一版更强的拼进来。这种演化方式下,"原作者维护"这个概念几乎不存在——每个人都是转载者,转载者之间互相转载。
再往深想一层:高风险能力(比如打包的可执行文件、预授权的高危工具调用)在这张网络里的分布,遵循的也是传播逻辑,而不是"谁写的"逻辑。一个高风险 skill 之所以危险,不是因为它被某个坏人写出来了,而是因为它被某个枢纽仓库转载了,然后沿着复制链铺开。防"写坏 skill 的人"和防"转载坏 skill 的枢纽",是两种完全不同的安全策略。这篇论文站的是后者。
Ground Truth 的报道里还点了一个值得注意的外延:这套分析同样适用于 Anthropic 的 knowledge-work plugins 这类"官方组合包"——skill 加 connector、命令、工作流组件打包在一起分发。论文没有指控这类官方包有任何问题,它只是提出了一个所有人都该回答的问题:你的 skill 从哪儿来?有没有版本引用?更新怎么推送到已安装的人手里?装完之后它拿到什么权限?官方包也一样,一个都别想躲。
先别恐慌:这篇论文"没说什么",和"说了什么"一样重要
认真读论文的人会注意到作者的谨慎,Ground Truth 的报道也花了大篇幅讲这些限定条件,值得转述:
第一,风险标签标的是"能力",不是"恶意"。200 个人工标注样本上,严格标签的 precision 是 98.3%、recall 是 80.9%。但它标的是"打包了可执行文件""预授权了高风险工具"这类能力——一个好用的自动化脚本和一个恶意脚本都能执行命令。标签的意思是"这里值得细看",不是"这里有坏人"。作者把风险计数称为"下限":没被标出来的,不等于就是安全的。
第二,14.9% 对 0.5% 是模拟审计,不是真实拦截。作者是在一个留出的后验时段里模拟"如果当时审了这些仓库会怎样",并没有部署过真实干预。论文自己也承认:复制网络之外的新 skill,依然占了后续高风险采用的相当份额。模拟能证明"按网络排比按 star 排好",证明不了"这样就能防住攻击"。
第三,覆盖范围是公开 GitHub 上这个格式诞生后的前十个月,不含 fork。你私有的那一堆 skill、公司内网传的 skill,都不在这张图里。
所以这篇论文讲的不是"skill 里有病毒",而是"非恶意的结构性风险":就算所有人都是好人,这条没有版本、没有更新通道的复制链,本身就会让修复到不了用户手里。站里之前发过的 SkillCloak 讲的是恶意 skill,这篇是另一面——好人写的好 skill,抄 12 手之后,一样可能是个带着旧问题的 frozen 版本。结构性风险比恶意更难防,因为它不依赖坏人存在。
给 vibe coder 的四条建议
第一,装 skill 之前,先看"它从哪儿来",而不是"它有多少 star"。论文配了一个交互式查看器(fahdseddik.github.io/Skill-Constellations),代码和数据也开源了(GitHub 上的 Skill-Constellations 仓库,数据版本 data-v1.0)。下次从某个 awesome 列表里装 skill,先花两分钟看看它的源头仓库和更新状态——源头三个月没动过,就要掂量一下。Star 数在这件事上是噪音,论文已经用 -0.10 的相关系数盖了章。
第二,团队共享 skill,一定要版本化。论文给平台的建议大意是:应该分发"版本化引用"而不是"副本"。这话直接对应上了腾讯云刚开源的 TeamAI——把 skill 装进 git 仓库、用 push→评审→pull 的流程分发(本站另文报道)。个人用 skill 可以随手抄,团队用 skill 必须像管依赖一样管:能 pin 版本、能收到更新、能 review 变更。TeamAI 这类工具的价值,恰恰在于给复制链补上了"更新通道"。有意思的是,TeamAI 让团队内部分发 skill 变得更容易,而这篇论文恰恰警告了"分发越容易、复制链越长、修复越到不了"——两篇报道连起来看,才是完整的故事:共享 skill 是刚需,但共享必须带版本。
第三,把 skill 写进你的"依赖清单"心智。定期检查 ~/.claude/skills、项目里的 skills 目录,看看哪些是几个月没动过的 frozen copy。npm audit 大家都会跑,skill audit 现在还没有趁手的工具,但手动 review 的习惯可以先有。至少做到:你说得出每一个 skill 是从哪儿来的、什么版本、作者最后一次更新是什么时候。说不出来,就别让它拿着你的 shell 权限跑。
第四,如果你也在分发 skill(写教程、维护 awesome 列表、做 skill 合集),你就是传播网络里的一个节点。论文的数据说,top 1% 的仓库贡献了 94.7% 的传播——很多"枢纽"自己都没意识到自己是枢纽。转载 skill 的时候,附上源头链接和版本号;源头更新了,同步一下你的转载。这不是什么高尚的义务,这是这条供应链目前唯一能用的"更新通道":靠人肉。
npm 花了十年解决的问题,skill 还没开始
把 skill 的今天和 npm 的早期对照一下,会发现历史在押韵。npm 早期也是复制粘贴的天下,后来才有了 registry(注册表记出处)、semver(版本号定预期)、lockfile(锁死依赖树)、audit(扫已知漏洞)。Skill 的生态在 2026 年,还处在"复制粘贴时代":没有注册表记 provenance,没有能 pin 的版本,没有推送修复的通道。
论文的最后一句建议很克制:平台应该分发版本化引用,而不是副本。翻译成大白话就是:别再让用户复制文件夹了,给 skill 一个像 npm 包那样的"名字@版本",装的是引用,更新走通道。在那一天到来之前,每个 vibe coder 能做的,就是把上面四条建议当成临时补丁:看源头、要版本、勤检查、转载留出处。
供应链安全这个词,在 2026 年的 agent 世界里有了新含义:以前我们担心的是 npm 包投毒,现在要担心的,是你让 agent 读的那一堆 markdown——它们可能是被抄了 12 手的复印件,而原件早就改了。论文的标题叫"技能星座",看完只觉得,每一颗星星后面,都拖着一条看不见的复印链,而这条链的长度,决定了你离风险有多远。
评论 (0)
原始来源
相关文章
AI coding 时代,密钥泄露不再靠人手滑——AI 会主动把 key 写进代码、注释、commit 里并 push。本指南给 vibe coder 一套凭据五态管理框架(生成→存储→使用→轮换→泄露应急),全部可直接抄走:.env 分层与预提交钩子、生产密钥托管选型、AGENTS.md 三条红线、第三方 key 最小权限、30 分钟泄露止血 SOP,以及每月 5 分钟巡检清单。
10 月 10 日腾讯云宣布开源内部自用 TeamAI:把团队的 Skill、规则、MCP、环境变量和知识库装进 Git 仓库,用 push→评审→pull 流程分发,一人配置全员复用,适配 16 种 Agent。注意时间线:仓库 4 月 27 日已创建,10 月 10 日是官方开源宣布日。腾讯自称的“成本降 76%”是单方说法,产品思路比 marketing 数字更值得看。
CNBC 10 月 11 日报道:美国软件开发岗招聘自 2025 年 2 月底上涨近 15%,同期整体招聘跌 7%。但 71% 的增量是 senior 岗、37% 带 AI 头衔,总量仍比疫情前低 27.5%;斯坦福数据显示 22-25 岁初级开发者就业跌近 20%。增长的不是写代码的岗,是驾驭写代码机器的岗。