腾讯云开源 TeamAI:把团队的 Skill 装进 Git,一人配置全员复用
10 月 10 日腾讯云宣布开源内部自用 TeamAI:把团队的 Skill、规则、MCP、环境变量和知识库装进 Git 仓库,用 push→评审→pull 流程分发,一人配置全员复用,适配 16 种 Agent。注意时间线:仓库 4 月 27 日已创建,10 月 10 日是官方开源宣布日。腾讯自称的“成本降 76%”是单方说法,产品思路比 marketing 数字更值得看。
先讲清楚时间线:仓库 4 月就有,10 月 10 日是"官宣日"
10 月 10 日,腾讯云宣布开源内部自用的 TeamAI 工具,支持跨 Agent 共享 Skill。FX168 在 10 月 12 日 09:53 跟进报道,英文媒体 China AI Wire 也在 10 月 10 日当天做了报道。但有一个时间细节必须先讲清楚,免得误导:TeamAI 的 GitHub 仓库(Tencent/teamai-cli)创建于 2026 年 4 月 27 日——这是 GitHub API 上的公开记录。10 月 10 日是腾讯云官方"宣布开源"的日子,不是项目从零启动的日子。仓库 4 月创建之后一直在迭代(1047 个 commit、71 个 release),10 月 10 日是它从"内部工具"变成"公开开源项目"的新闻事件点。本文讨论的新闻,就是这个官宣事件。
为什么这个区分重要?因为中文媒体圈之前有过把"仓库创建时间"当成"新闻日期"的翻车案例。按 VibeFix 的时效铁律,新闻事件必须落在近两周内——TeamAI 落在窗口内的,是 10 月 10 日的官宣,不是 4 月 27 日的建仓。先把这个说清楚,后面聊的才站得住。
顺着时间线还能看到产品的演变。TSNMedia 在核查时翻到了 8 月 25 日的一个 README 旧版本,那时的 slogan 还是"The team harness for AI agents"(团队 Agent 的脚手架),主打"Git 原生管理 skill、规则、MCP、环境变量和知识库";现在官网标题换成了"Make Every Team AI Native"(让每个团队 AI 原生),从"工具描述"升级成了"愿景口号"。一个 slogan 的变化,说明团队在 8 月到 10 月之间想清楚了自己的叙事:不卖功能,卖"团队 AI 化"这个结果。官宣前的两个月,产品在做的不仅是写代码,还有想清楚"怎么讲自己的故事"——这对独立开发者做产品发布是很好的参照。
TeamAI 是什么:一句话,"团队的 AI 配置也用 Git 管"
FX168 的报道把 TeamAI 的定义讲得很干脆:它是一款基于 Git 的团队 AI 协作工具,把团队使用的 Skill、工作规范、工具配置和项目知识统一放进 Git 仓库,像管理代码一样进行评审、更新和版本管理,再同步到成员各自使用的 Agent 中,真正实现"一人配置,全员复用"。
翻译成 vibe coder 的语言:你平时散落在 ~/.claude/skills、各个项目的 .cursor/rules、MCP 配置文件里的那些"AI 资产",TeamAI 让它们有了一个统一的家——一个 Git 仓库。团队里一个人配好了 skill 和规则,push 到仓库,评审合并,其他成员 pull 下来,每个人自己习惯用的 Agent 里就都有了。不用每个人重复配一遍,不用在群里传配置文件,不用担心"你用的 skill 是三个月前的版本"。新成员 onboarding 的第一天,跑一遍 teamai init,就和老员工站在同一套 AI 配置上——"环境一致性"这个后端圈的老概念,第一次被用到了 AI 工具链上。
目前 TeamAI 已适配 16 种 Agent,包括腾讯自家的 WorkBuddy、CodeBuddy,以及 Claude Code、Codex、Cursor 等主流工具。仓库 README 里的兼容性表格列了 19 个条目(含区域变体),覆盖 skill、规则、环境变量、MCP 等维度的支持情况。入口有两个:命令行(npm install -g teamai-cli)和 Agent skill(在 AI 工具里发一句话就能装,然后用 /teamai 对话式管理:建团队、加团队、分享 skill、开 dashboard)。
上手流程官方写得极简,翻译一下:管理员先在 Git 托管上建个共享仓库(默认分支保护起来,成员给推分支的权限),跑 teamai init <仓库地址>;成员分两种,在项目里用就 cd 到项目目录跑 teamai init,在个人全局用就加 --scope user。之后每次开 AI 会话,TeamAI 自动 pull 管理员发布过的最新 skill 和规则更新,不用手动同步。分享 skill 更简单:跟 AI 说一句"/teamai 把我的 xxx skill 分享给团队",剩下的它办。
这个"发一句话就能装"的设计值得注意。TeamAI 自己就是一个 skill(skills/teamai 目录),你让 AI 加载这个 skill,它反过来帮你管所有 skill——用魔法打败魔法。这种"自举"设计在 2026 年的 agent 工具里很常见,但 TeamAI 是第一个把它用在"团队治理"场景里的:管理员不需要学新工具,会在 AI 对话框里打字就行,门槛压到了最低。
16 种 Agent 适配表里,藏着三条信息
README 里那张兼容性大表,值得逐行读。第一梯队是"全勾"的:Claude Code、Codex、CodeBuddy、WorkBuddy——skill、规则、环境变量、agents、hooks、MCP、模型,七项全支持。注意腾讯把自家的 WorkBuddy、CodeBuddy 和 Claude Code、Codex 放在了同一梯队,这个排序本身就是一种表态:TeamAI 不是"腾讯系 Agent 的配套工具",是"所有主流 Agent 的中立层"。
第二梯队是"部分支持"的,信息量更大。Cursor 不支持模型(models 那一列是横线),GitHub Copilot CLI 也不支持模型;OpenCode、Pi 这些新兴 agent,在 Team Improvement 的 usage、sessions 两列是空的。翻译一下:TeamAI 的"分发配置"能力是普适的,但"观测改进"能力取决于 Agent 本身开不开放 telemetry 接口。Agent 越开放,TeamAI 越强大;Agent 封闭,TeamAI 就只能做"分发器",做不了"仪表盘"。这其实是整个 agent 生态的现状:配置层先统一,观测层还在各玩各的。
第三,表格里有些名字 vibe coder 可能不熟:Oh My Pi、OpenClaw、Hermes、DeepSeek Harness、Qoder、Kiro、Trae、ZCode、JoyCode。16 种这个数字不是凑的,它覆盖了"国际主流 + 国产全家桶 + 新兴 agent"三层。国产 agent 里 CodeBuddy、WorkBuddy、Qoder、Kiro、Trae、ZCode 全在,说明 TeamAI 的首要目标用户就是中文团队——毕竟 skill 沉淀这个方法论,在中文 vibe coding 圈的热度是最高的。先服务好基本盘,再谈全球化,这个策略是对的。
三层能力:执行、上下文、改进
按官方的产品分层,TeamAI 有三层能力,建在 Git 之上:
Team Execution(团队执行):让每个 agent 都按团队的方式工作——skill、规则、环境变量、agents、hooks、MCP、模型,一次配置,向全员 AI 环境自动分发。这是现在最成熟的一层,也是"一人配置、全员复用"的核心。
Team Context(团队上下文,beta):让每个 agent 都懂团队——learnings(成员试错经验自动沉淀、促知识共享)、codebase graph(源码解析建代码库知识图谱)、teamwiki。这一层的思路是:团队的知识不应该只存在老员工的脑子里,应该变成 agent 能读到的上下文。
Team Improvement(团队改进,beta):让每次执行都让团队变强——usage(AI 使用情况 dashboard)、sessions。低可信的学习内容会被归档,过期的 skill 和 rule 会被打标。相当于给团队的 AI 资产做"保鲜管理"。
仓库支持 GitHub、GitLab、GitCode、CNB、TGit 和私有 Git 服务,还搞了个 teamai-hub 组织,提供预装了生产级 skill、规则和 review agent 的模板——没团队仓库的人,可以从模板 fork 一个起步。这个设计很"腾讯":降低冷启动门槛,先让你用起来。
工作流:push → 评审 → pull,像管代码一样管 skill
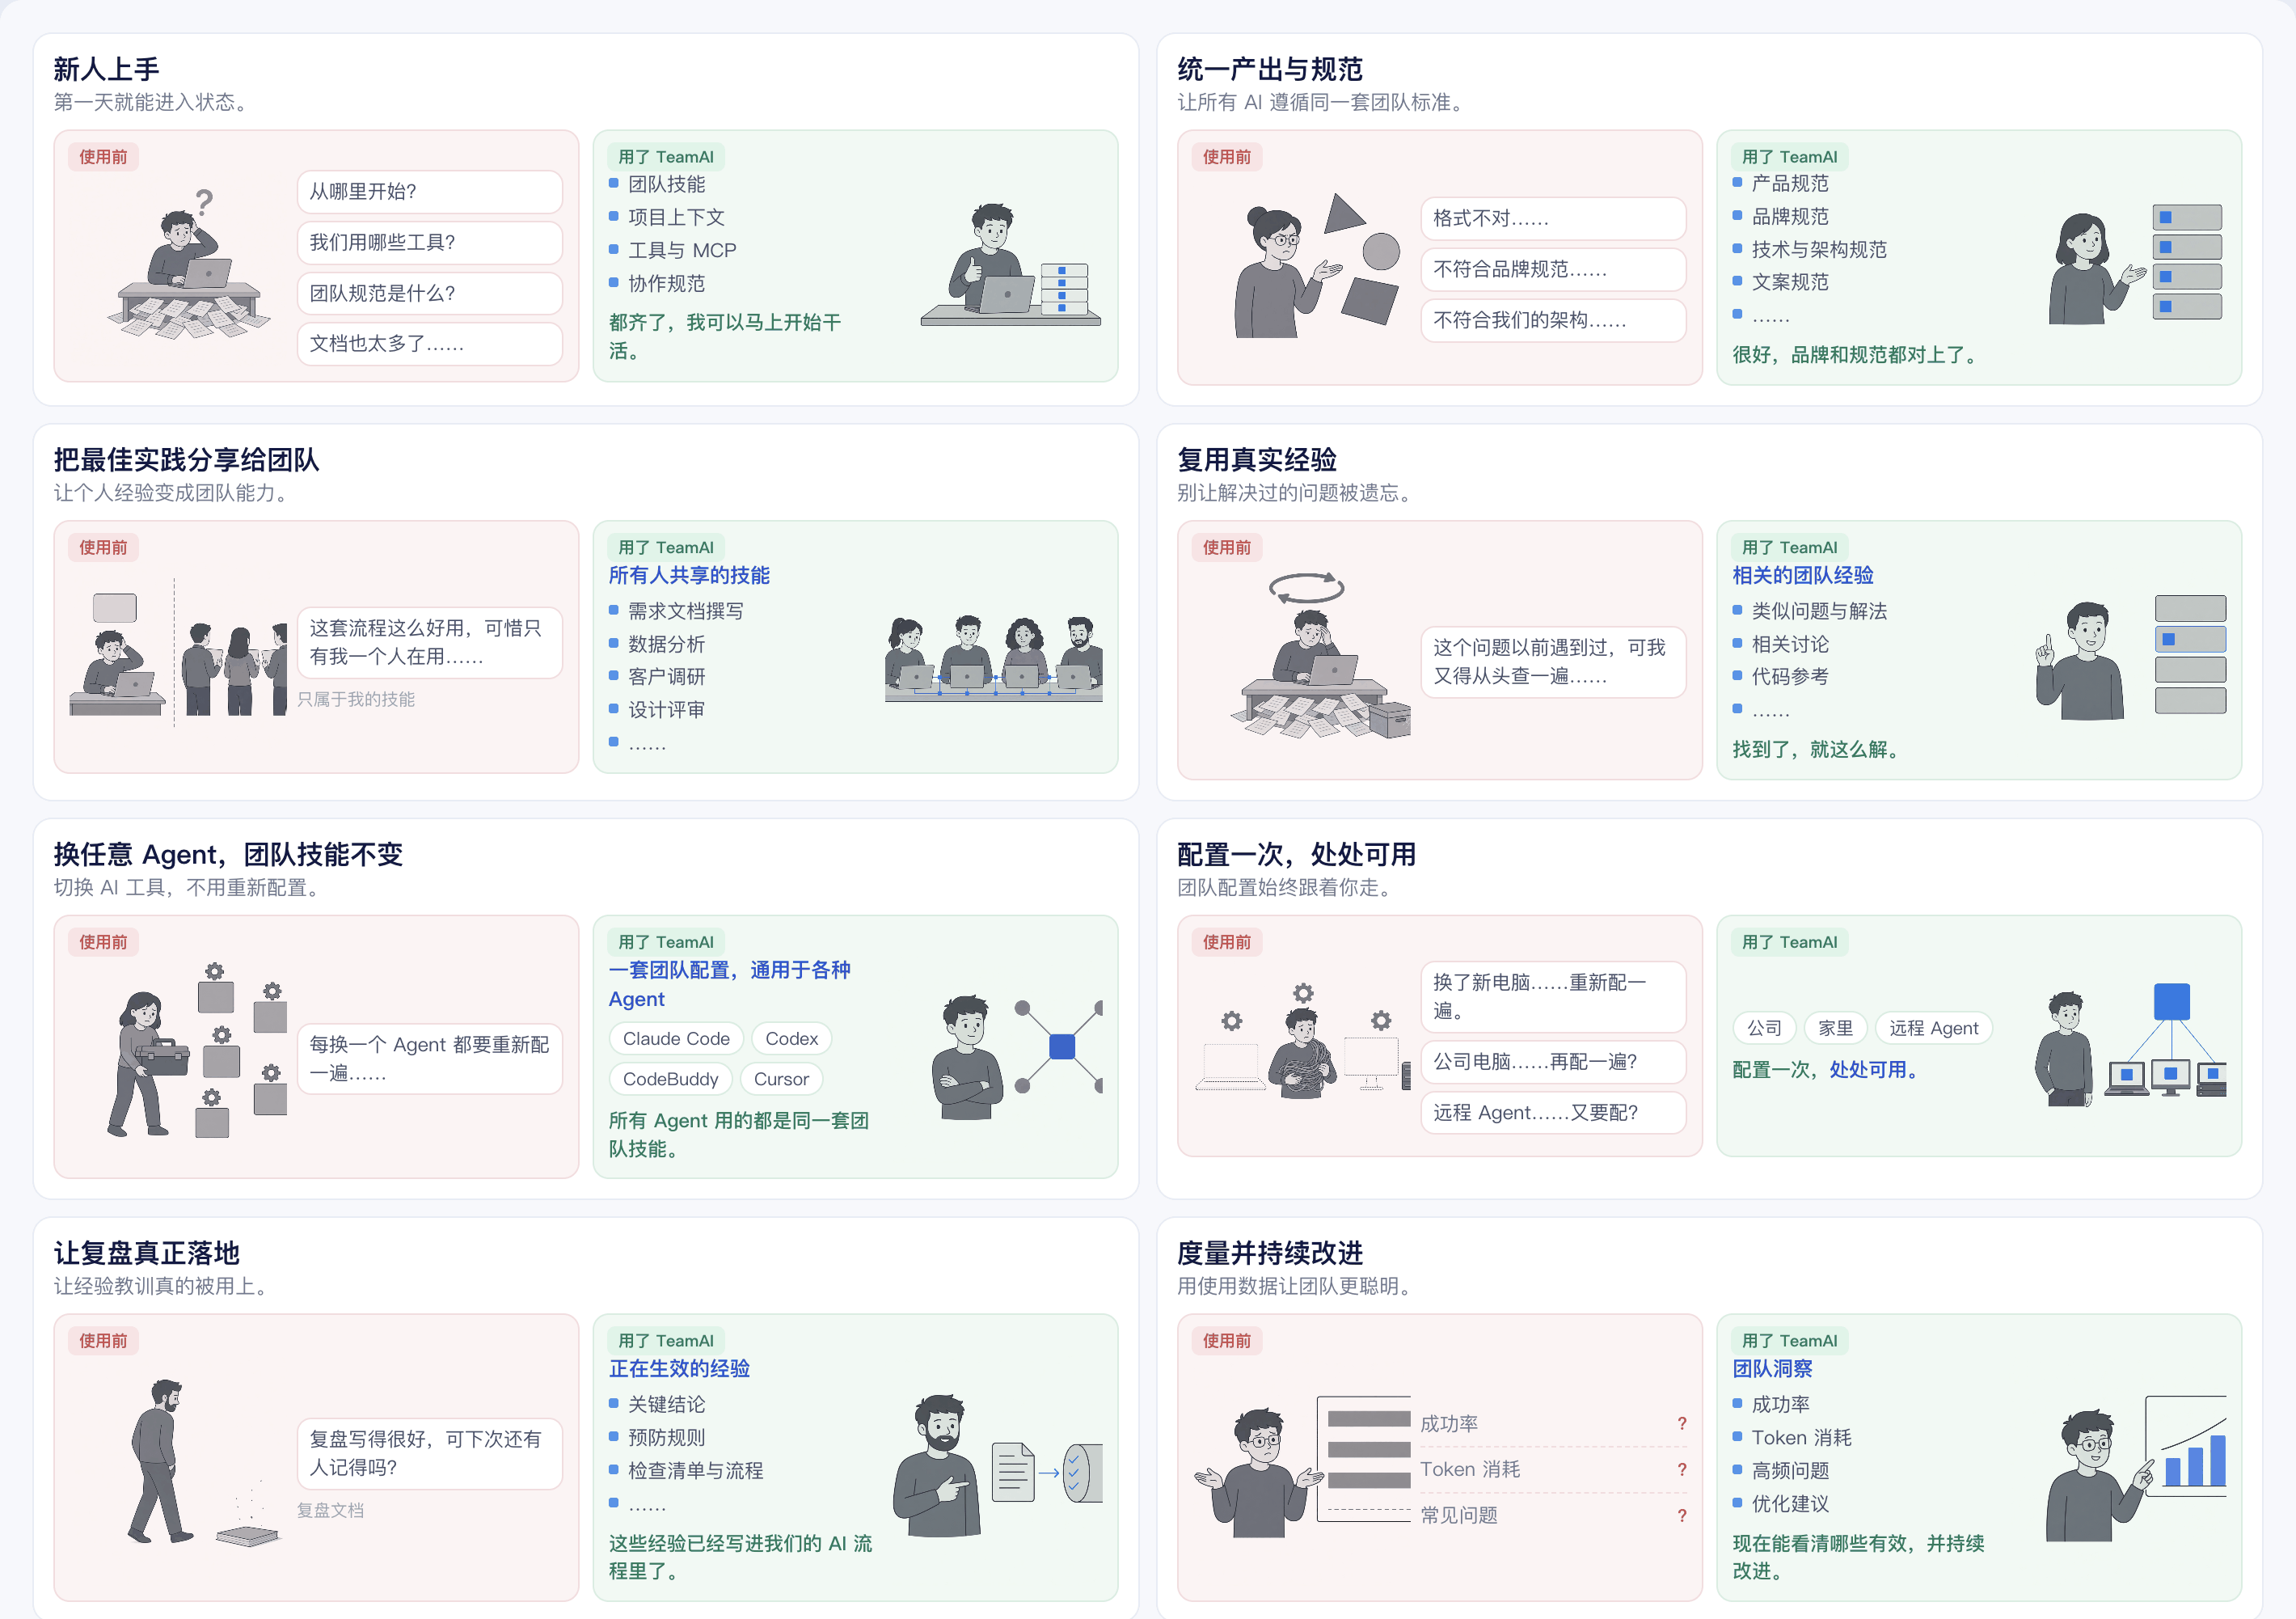
TeamAI 最有方法论味道的部分,是它的工作流。成员想分享一个 skill,跑 teamai push,会开一个 merge request;评审人合并之后,其他成员在会话开始时 teamai pull,自动同步更新。Skill 的变更走的和代码变更完全一样的流程:分支、评审、合并、同步。
这个设计解决的是 skill 协作里最痛的三个问题。第一,版本混乱:以前 skill 靠群里传文件,A 用的 v1、B 用的 v3,谁都不知道;现在 Git 就是版本真相。第二,质量失控:谁都能往共享目录里扔 skill,扔个有问题的进来全员中招;现在 MR 评审卡一道,至少有人看一眼。第三,更新断层:skill 作者修了 bug,以前靠"群里吼一声大家重新下载";现在 pull 一下就行。
有意思的是,这套流程恰好回应了本站同期报道的 Skill Constellations 论文(arXiv 2610.11169)提出的问题。那篇论文发现,agent skill 的分发是一条没有版本、没有更新通道的复制链,上游修了下游收不到,star 还识不出真正的传播枢纽。TeamAI 的 push→评审→pull,本质上就是给团队内部的 skill 复制链补上了"版本"和"更新通道"。两篇报道连起来看才完整:论文诊断了病,TeamAI 开了一味药——虽然这味药目前只管得到"一个团队内部",管不到整个 GitHub。
腾讯自称的成绩单:13 个任务,成本降 76%——先打个问号
China AI Wire 的报道里引用了腾讯云的一组内部测试数据:在 13 个开发任务里,给低成本模型接入共享的团队知识后,综合质量分提升了 6.1%,模型调用成本下降了 76%。CNMO 和观点网的转述把对比口径讲得更细:是"便宜模型 + 团队知识"打"高配模型无知识",前者赢了。
这组数字很性感,但必须打三个问号。第一,样本太小:13 个任务,在统计上基本说明不了什么,换 13 个别的任务结果可能完全不同。第二,方法不公开:质量分怎么打的、成本怎么算的、基线模型选的什么,腾讯没公布方法,也没给数据集,外部无法复现。第三,这是单方说法:数据来自腾讯云自己,TSNMedia 在核查时明确写了"未找到已发表的方法或数据集",属于 vendor claim,不是独立验证。
另外,China AI Wire 还提到 TeamAI 已接入腾讯的 ClawPro agent 平台,但 TSNMedia 同样备注:没找到腾讯官方公告证实这一点。所以"接入 ClawPro"目前也只能算媒体引述,不是实锤。
这么较真不是为了挑刺,而是 VibeFix 的一贯立场:大厂的内部测试数据,看看就好,别当成选型依据。TeamAI 真正值得讨论的,是它的产品思路(Git 管 AI 资产),不是它的 marketing 数字。6.1% 和 76% 这两个数字,记住"腾讯自己说的"这个定语就行。
观点:Skill 正在从"个人文件"变成"团队资产"
TeamAI 真正有新闻价值的地方,不在于"腾讯又开源了个东西",而在于它标志着一个方法论拐点:2026 年上半年,skill 沉淀还是个人方法论——每个人在自己的 ~/.claude 目录里攒 skill,写博客分享心得;到了 2026 年下半年,skill 开始变成团队资产,有人开始用 Git、用评审流程、用 dashboard 来管它了。TeamAI 是这个拐点上第一个大厂级的开源动作。
腾讯为什么开源这个?可以合理推测三层动机。第一层是生态:WorkBuddy、CodeBuddy 是腾讯自己的 AI 编程产品,TeamAI 适配 16 种 Agent 表面中立,实际是把"团队 AI 资产"这个概念的定义权拿在手里——以后团队管 skill,先想到的是 TeamAI 这套流程,而流程里最顺手的自然是腾讯系 Agent。第二层是人才:1047 个 commit、71 个 release,说明内部已经用了小半年,开源等于把社区变成免费 QA 和贡献者。第三层是标准:MIT 许可、不绑定腾讯云(支持 GitHub/GitLab/私有 Git),姿态做得很开,为的就是让它成为事实标准。开源策略上,这是一手高明的棋。
和字节的 TRAE 对照看更有意思。TRAE(本站 cycle42 报道过)是"个人工作台"思路:把工作和代码装进一个人的 Agent 工作流,优化的是单人效率。TeamAI 是"团队资产层"思路:优化的是"一个人的配置怎么变成所有人的配置"。一个管个人,一个管团队,两者不冲突,甚至互补:TRAE 解决"你怎么用 AI 干活",TeamAI 解决"你们怎么一起用 AI 干活"。巨头在 agent 工具链上的分工,正在从"IDE 大战"转向"工作流分层",这个趋势值得盯。下一家可能出手的是阿里或字节——"团队 skill 管理"这个位置,现在只坐了腾讯一家。
但也要看到 TeamAI 的边界。第一,它解决的是"团队内部"的 skill 分发,Skill Constellations 论文讲的"全网复制链"问题,它管不着——你的团队 skill 还是可能抄了外面某个 12 手的 frozen 版本进来。第二,16 种 Agent 的适配,本质是"把同一份配置翻译成 16 种方言",翻译质量取决于每种 Agent 的开放程度,Claude Code 和 Cursor 的 skill 格式都不一样,长期维护 16 套适配是持续成本。第三,beta 的两层(Context、Improvement)才是真正难的部分:learnings 自动沉淀、过期 skill 打标,这些"保鲜"能力做不好,团队仓库最后会变成另一个没人敢动的"祖传 skills 目录"。
风险提示:团队 skill 仓库本身,就是新的单点风险
话要说两面。TeamAI 把团队的 AI 资产集中到一个 Git 仓库,方便是方便了,但这个仓库本身就成了新的单点风险。想想看:skill 是拿着用户权限跑的指令和脚本,一个被投毒的 skill 经由 teamai pull 分发到全员,等于一次投毒、全员中招。以前 skill 分散在各人手里,坏也坏得有限;现在集中管理,评审流程就是唯一的防线。
腾讯的文档里明确写了:不要把 secret 值放进共享的环境变量。这个提醒很实在,但也暴露了边界:env vars 共享的是"配置",不是"密钥",团队得自己解决 secret 分发(比如用 vault、走本地覆盖)。MR 评审能拦住明显的坏东西,拦不住精心构造的投毒——评审人也是人,看 skill 的眼光和看代码的眼光还不是一回事。团队用 TeamAI,第一件事应该是定评审标准:什么 skill 能进,什么不能进,谁有合并权限。
还有一个组织层面的风险:流程越重,skill 的更新越慢。MR 评审、版本管理、dashboard,这些都是为了"管好",但管的代价是"变慢"。小团队如果照搬大公司的评审流程,一个 skill 更新要等三天,那还不如群里传文件。TeamAI 的流程是可选的(也可以直接 push),团队要根据自己的规模调"管"和"快"的平衡点。工具不背这个锅,定流程的人背。
给 vibe coder 的四条建议
第一,如果你在带团队(哪怕是 3 个人的小团队),可以试试 TeamAI 的思路,不一定非要用 TeamAI。核心方法论就一句话:AI 资产进 Git,走评审。就算不用它的 CLI,建个仓库把团队的 skill、rules、MCP 配置放进去,约定"改 skill 必须提 PR",效果就已经有了八成。工具是次要的,流程是主要的。
第二,一人公司也别觉得这事跟你没关系。"团队"可以是现在的你和三个月后的你。把 skill 放进 Git,最大的受益者是"未来的你":三个月后你想不起来某个 skill 是哪儿来的、改过什么,git log 全记得。Vibe coder 的 solo workflow 里,缺的往往不是工具,是"给未来的自己留记录"的习惯。
第三,抄 TeamAI 之前,先去读 Skill Constellations 那篇论文。两篇报道是姊妹篇:一个讲"怎么分发",一个讲"分发有什么坑"。你要往团队仓库里引入外部 skill,先查一下它的复制链和更新状态,别把 12 手的 frozen 旧版本当成团队资产供起来。分发越方便,越要警惕源头——这是这两篇报道合在一起要讲的完整故事。
第四,给你的 skill 仓库定个"保鲜"规则。TeamAI 的 Team Improvement 层现在还是 beta,过期 skill 打标、usage dashboard 这些能力不成熟,团队得自己补:约定每个 skill 的 owner,约定"三个月没更新的 skill 自动进 review 列表",约定新成员 onboarding 时有人讲一遍 skill 仓库的结构。工具只能搭架子,保鲜靠的是组织习惯。很多团队的 wiki 最后都变成了"没人敢删的垃圾场",skill 仓库不想要这个结局,就得从第一天定规矩。
仓库数据备查:Tencent/teamai-cli,创建于 2026-04-27,截至撰稿时 5383 stars、414 forks、1047 commits、71 releases,MIT 许可。10 月 10 日官宣开源后 star 还在涨,说明"团队管 skill"这个痛点是真实存在的。痛点真实,方案待验证——这是对 TeamAI 最公允的一句话评价,也是本文的结论:痛点真实存在,方案仍待时间验证。顺带一提,5383 这个 star 数放在腾讯开源项目里不算高(对比它家 star 数十万的明星项目),但考虑到它 4 月建仓、10 月才官宣,涨势基本都发生在官宣之后,说明这次官宣的传播是有效的。一个判断:未来三个月看它的 star 能不能过万,过了,说明"团队 AI 资产管理"真是个赛道;没过,说明这只是个"看起来很美"的内部工具。
评论 (0)
原始来源
相关文章
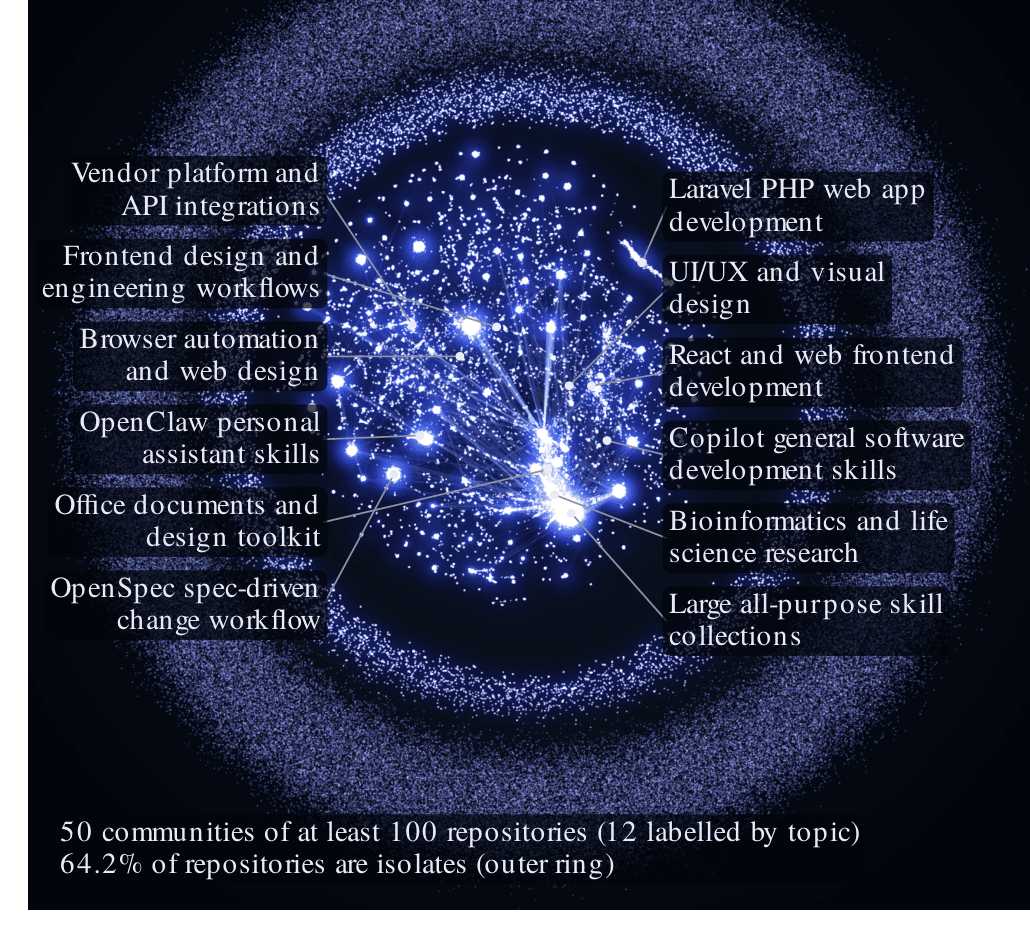
10 月 8 日 arXiv 论文《Skill Constellations》用 git 历史重建了 agent skill 的复制网络:219 万次采用里一半 SKILL.md 是逐字复制,top1% 仓库贡献 94.7% 传播,上游修复到不了已安装的副本;按传播网络排的 top100 审计能拦截 14.9% 后续高风险采用,按 star 排只有 0.5%。Star 识不出枢纽,缺失的更新通道才是结构性风险。
2026 年 10 月 8 日,中国团队 MirroS 发布论文《AgentGarten: Code Worlds for Evolving Agents》并开源仓库(Apache-2.0)。核心主张:代码管物理、神经渲染器管光影,智能体把经验写成 playbook(一技能一文件)沉淀进化。复刻 OpenAI 2019 躲猫猫实验:当年自博弈 RL 用约 1 亿 episode 学会的技能,如今靠'行动—复盘—写 playbook'循环在 10 轮内学会,同一套流程通用五个代码世界。
2026 年 10 月 1 日,Google 暂停了 OSS 漏洞赏金计划的产品漏洞提交受理,原因是自动生成的无效报告太多。这场暂停背后,是 vibe coding 时代最硬的结构性矛盾:AI 把“发现漏洞”的成本打到接近零,却把“验证报告”的成本全部甩给了人类审核者。从 Linux 内核不堪重负的安全邮件列表,到 GTIG 翻倍的漏洞披露数据,本文深度拆解事件全貌,并给出对独立开发者的直接启示:AI 扫漏洞、批量投报告的粗放赏金狩猎模式已经死了,游戏规则正在被改写。