SWE-bench Pro 十月榜:Claude Opus 5.5 以 89.9% 登顶,但这个榜单本身 30% 的题是坏的
10 月 2 日更新的 SWE-bench Pro 显示,Claude Opus 5.5 以 89.9% 领跑,Sonnet 5.5(81.3%)和 Claude Fable 5.1(81.2%)紧随其后。但别急着下单:OpenAI 今年 7 月的审计估计,这个基准公开题集里约 30% 的题目是坏的,连榜单维护方自己都说别拿它做购买决策。
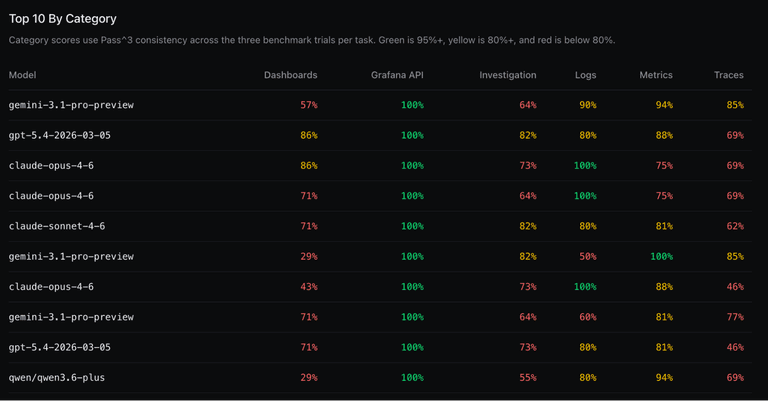
发生了什么:Anthropic 包揽前三,但数字要打折看
10 月 2 日更新的 SWE-bench Pro leaderboard 上,Claude Opus 5.5 以 89.9% 断层领先,第二名 Claude Sonnet 5.5 是 81.3%,第三名 Claude Fable 5.1 为 81.2%。76 个模型参评,榜单区分度确实拉开了——第一名和第三名差了将近 9 个点。
SWE-bench Pro 测的是长周期仓库级任务:给 agent 一个真实代码库,让它修 bug、加功能、跑通测试。和只测单函数生成的基准不同,它更接近「让 agent 干一天活」的真实场景,所以一直被当作 coding agent 选型的硬通货。
但先看反面:这个榜单 30% 的题可能是坏的
今年 7 月,OpenAI 做了一次审计,结论相当不客气:公开题集 731 道题里,约 30% 是坏的——测试本身有问题、环境不可复现、或者答案就不唯一。OpenAI 随后撤回了之前「推荐采用这个基准」的说法。
榜单维护方 BenchLM 自己也在页面上写了诚实声明:不同厂商的测试配置(脚手架、工具预算、重试策略、运行次数)并不一致,小分差只能看方向;这个页面不应该单独决定一次 coding agent 的采购。一个连出题方都不敢打包票的榜单,你敢拿它做技术选型吗?
我们怎么看:榜单是营销,eval 才是生产力
说句得罪人的话:2026 年的模型榜单,一半是给投资人看的,一半是给媒体写稿用的。对真正要用的团队,正确姿势从来不是「看谁分高用谁」,而是拿自己的仓库、自己的任务,跑自己的 eval。
具体怎么做?从你的 issue tracker 里挑 20 个真实任务(修 bug、加小功能、写迁移),给每个候选模型/agent 跑一遍,记录一次通过率、人工介入次数、token 消耗。一周时间,你得到的结论比任何公开榜单都准。公开榜单告诉你「这个模型很强」,你的 eval 告诉你「这个模型在我的代码库上很强」——后者才是你要花的钱。
Opus 5.5 的 89.9% 当然是个强信号,Anthropic 在 coding 上的统治力也不是一天两天了。但记住 30% 这个数字:当你看到任何「第一名」的时候,先问一句——第一名的考卷,印对了吗?
原始来源
相关文章

Gergely Orosz 走访 OpenAI、Anthropic、Cursor、Ramp 后写下的 2026 行业现状:近 100% 代码由 AI 生成、Agent PR 八个月涨近 10 倍、code review 沦为表演、IDE 被判为遗产产品。本文提炼报告要点,并给出 vibe coder 的三个判断与四件本周可做的事。
2026 年 9 月 30 日,Bitdefender 宣布 AI Guardian 进入公开 beta:给自主 AI Agent 加的安检门,每一次工具调用、文件访问、密钥使用都要先拿到 allowed / flagged / blocked 裁决。首批 macOS 独占、beta 期免费,支持 Claude Code 与 OpenClaw。为什么这道「Agent 行为防火墙」来得正是时候。

2026 年 10 月 8 日,Google Cloud 在 Gemini at Work 2026 大会上发布 Gemini agent:为工作而生的统一 Agent,拿目标自己规划、按任务在 Gemini 和 Claude 模型之间自动选择,并推出拥有独立邮箱、calendar 和通讯录席位的「同事 Agent」。四点判断:Agent 竞赛的下半场是「更像同事的 Agent」。