腾讯混元开源 Hy Memory 2.0:决定"AI 该记住什么"的 30B 模型,与打通 10 款工具的记忆中枢
腾讯混元把 agent 记忆框架 Hy Memory 升级到 2.0 并三层全开源:专为记忆写入训练的 Hy-Memory-30B-A3B 模型、Python 框架 hy-memory、本地优先的 MemHub(打通 Claude Code / Cursor 等 10 款工具)。但第三方独立评测指出:记忆系统只和写记忆的 LLM 一样好。
做 vibe coding 的人都有过这个体验:换个新会话,agent 就像失忆了一样,你得把项目背景、之前的决策、踩过的坑重新讲一遍。记忆,是 agent 从"一次性工具"变成"长期搭档"的分水岭——但记忆到底该怎么做,一直没有标准答案:有人向量一把梭,有人全塞进上下文,有人干脆不要记忆。
10 月 16 日,腾讯混元把它的 agent 记忆框架 Hy Memory 升级到 2.0,并且三层全开源:专为记忆写入训练的 Hy-Memory-30B-A3B 模型(Apache 2.0,已上 Hugging Face)、Python 框架 hy-memory、以及本地优先的应用 MemHub——后者能把 Claude Code、Cursor、Codex、OpenCode、Qwen Code 等 10 款工具里用户授权的对话与编码轨迹,统一收进一个本地数据目录。这不是发个 demo,是把"记忆"当成一门工程来做:chat、working、coding 三种场景,记忆的形状各不相同。
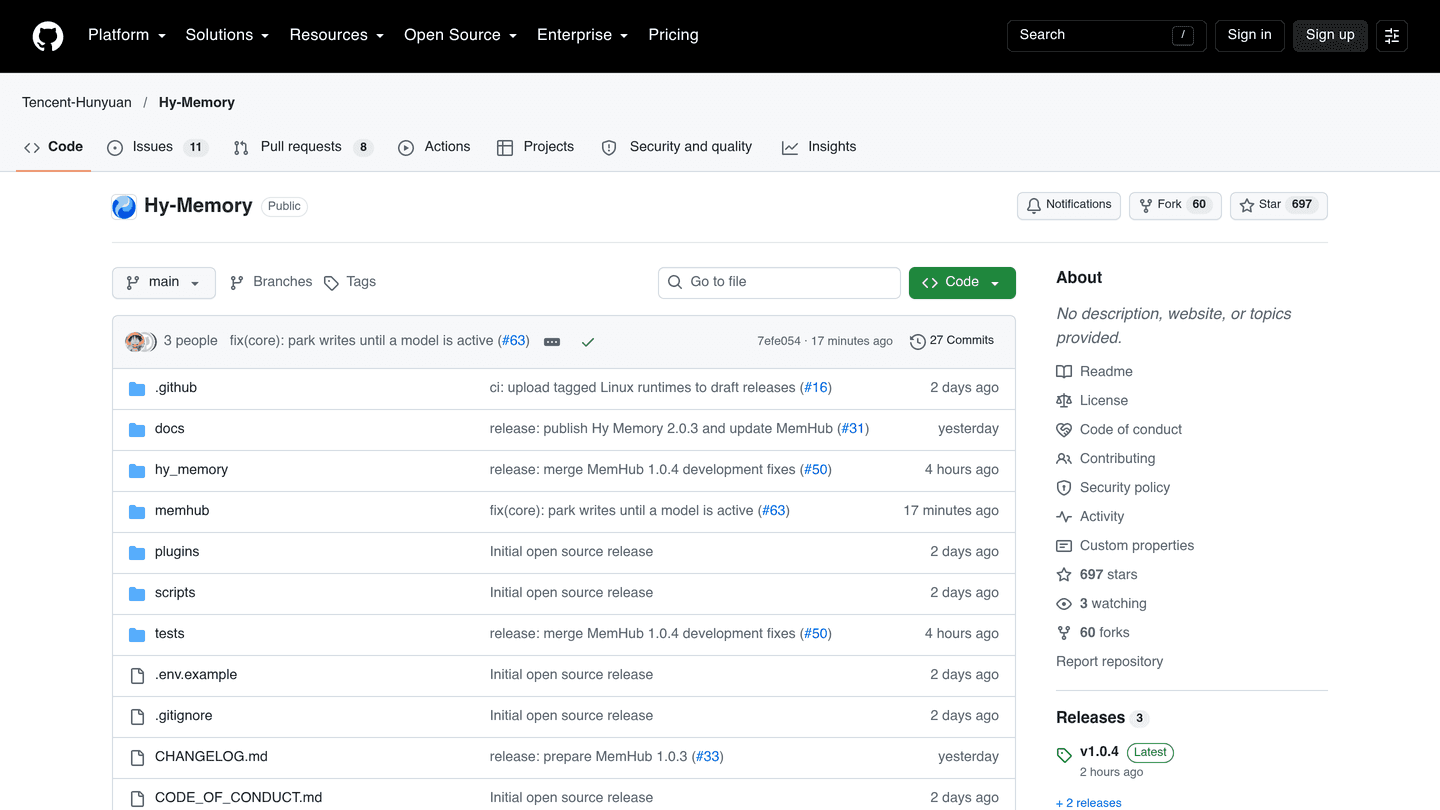
仓库 10 月 15 日创建,截至 10 月 18 日已有 697 个 star。更值得注意的是,开源三天内就出现了一份来自第三方的独立评测,用 LongMemEval 实测后得出了一个相当扎心的结论——"记忆系统好不好,取决于写记忆的那个 LLM 有多好"。这篇稿子会把官方说法和这份批判放在一起讲,因为真正的判断恰恰藏在两者的缝隙里。
记忆不是"向量一把梭":三种场景,三种记忆形状
Hy Memory 2.0 最核心的设计判断是:记忆没有统一形状,任务场景决定了记忆长什么样。框架先经一个场景路由器分流写入,再进不同的管线:
 三种任务场景,三种记忆形状。内容整理自 Hy Memory 官方 README。
chat 场景走 8 层认知记忆,从 L0 原始对话逐层抽象:L1 原始对话(只追加)、L2 原子事实(版本化、不可变记录)、L3 会话摘要,一直到 L6 心智模型(抽象的叙事模板、图层)和 L7 前瞻意图——L7 甚至带有过期时间,过期后降级为普通事实。注意 L4(身份)与 L5(知识)目前还是保留位,说明这套层级是为未来扩展预留的,不是拍脑袋的 8 层。
working 场景(文档、表格、研究、内容创作这类生产力工作)是双层:事实层 + 可复用经验层。一次带工具调用的会话同时产出两层——事实层恰好 1 条("这次会话做了什么":任务、方法、结果,带原文出处),经验层 0 到 N 条("下次类似任务可复用的做法",必须过一个价值阈值,带任务、检索键、解法、边界环境、置信度)。两层互相链接(事实指向派生的经验,经验指回来源事实),被取代的事实还能通过任务进展链追溯。
coding 场景复用 working 的同一条双层管线和数据结构,但有三处不同:提取规格换成软件工程专用(主体必须是代码或决策,记录精确坐标如文件/函数/分支,而不是粘贴代码);存储完全隔离(独立的数据库与集合);最重要的是多了一条版本演进 diff 链——记录同一段代码被改了几次、每次为什么改。
这个设计里藏着一个很对的直觉:chat 记忆要的是"这个人是谁、想要什么"(越抽象越好),working 记忆要的是"做过什么、学到了什么"(事实与经验分开),coding 记忆要的是"代码怎么一步步变成现在这样"(演进轨迹本身就是知识)。"向量一把梭"的问题在于,它用同一种形状装了三种完全不同的东西。
另外框架给了 lite / pro / ultra 三档模式:lite 是纯向量读写、零 LLM 调用(场景参数直接忽略);pro 加上 LLM 提取与调和;ultra 再加 System 2 的图谱归纳与跨域清扫(图数据库常开)。分档的意义很实际:不是所有记忆都值得花 LLM 的钱, ingestion 的成本也要分级。
决定"记住什么"的 30B 模型
三层开源里最有野心的是 Hy-Memory-30B-A3B:总参数 30B、每次只激活 3B 的 MoE 模型,专门为"记忆写入"这个任务训练——用的是带归因的强化学习(attributed RL),目标是高精度的长期记忆抽取与冲突调和。技术报告挂在 arXiv:2610.22196,模型 Apache 2.0 协议上架 Hugging Face。
它的定位很精准:直接替换 Mem0、MemOS、Hy Memory 这些框架里负责"写记忆"的通用模型。也就是说,腾讯把"写记忆"单独拎出来,当成一个值得专门训练模型的子任务。这背后是一个判断:记忆 pipeline 里最难的不是检索(向量检索已经很成熟),而是"把一段对话变成值得存的记忆"这一步——抽什么、怎么抽、冲突了听谁的。
官方还给了自报成绩:在四个框架上平均 55.49%,对 Claude Opus 5 的 54.62%。这句话必须打上厂商自测的水印——测试集、评测方法都是自己定的,数字看看就好。真正有意思的不是 55.49 对 54.62,而是"专门训练的记忆写入模型能和通用大模型掰手腕"这个事实本身:如果写记忆真的可以被做成一个独立、可优化的子任务,那记忆系统的架构就还有很大的重构空间。
MemHub:打通 10 款工具的本地记忆中枢
如果说模型和框架是"记忆怎么做",MemHub 回答的是"记忆存在哪"——这是 vibe coding 读者吵了很久的问题。MemHub 是一个 local-first 的桌面应用 + CLI:把用户授权的各家 AI 工具(Claude Code、Cursor、Codex、OpenCode、Qwen Code 等 10 款)的对话历史与编码轨迹,统一收进一个本地管理的数据目录,实现跨应用的记忆召回。
几个产品细节值得注意:local-first 意味着记忆先落本地,跨应用召回不经过第三方服务器;有签名的 macOS 桌面版(v1.0.4)+ npm 上的 memhub-cli(1.0.5),说明它想同时吃下"点点鼠标的用户"和"终端重度用户";写入支持按来源隔离(source="cursor" | "codex"),检索时可以只看某一家工具的记忆——这个设计很清醒:跨应用召回是能力,但用户得有权利说"别把那家的东西混进来"。
对 vibe coding 工作流来说,MemHub 瞄准的痛点非常具体:你可能上午用 Cursor 改代码、下午用 Claude Code 调架构、晚上在 Codex 里跑测试——每个工具都只记得自己那一段。MemHub 想做的是那个"记得全部"的本地中枢。当然,它的前提是用户逐个授权,记忆的搬运工当得合不合规,全看授权链做得干不干净。
第三方独立评测泼了一盆冷水
开源三天后,dev.to 上出现了一篇独立评测,作者 teolex2020 是同赛道记忆产品 Aura 的作者——利益关系他在文中明确披露了,反而让这篇评测的可信度更高。他用 LongMemEval 给 Hy Memory 做了实测,标题就很不客气:《Tencent's Hy Memory Is Only as Good as the LLM That Writes It》(腾讯 Hy Memory 的好坏,取决于写记忆的那个 LLM)。
 独立评测数据:写记忆的模型越强,成绩越好。数据来源:dev.to / teolex2020,2026-10-16。
先看第一组结果:用便宜的 Gemini Flash 做记忆写入,60 道题 Hy 只答对 43%,而作者自己的 Aura(写入时完全不用 LLM,纯本地 embedding)是 95%。拆开看更扎心:"助手说过什么"这类题,Hy 是 0%——32 个答错的题里有 32 个回答是"我没有这个信息"。作者还做了对照:把检索量放大到 40 条记忆(约 7900 字符,和 Aura 可读的文本量相当),正确率还是 45%——说明信息不是在检索时丢的,是在"把对话变成事实"的写入环节就丢了。
第二组结果更有信息量:换成 Claude Opus 5.5 做写入(贵,每题约 5 美元,只测了 18 题),知识更新题从 6/10 回升到 9/10,追平 Aura;Hy 还会把旧值保留为历史("当前值 25:50……历史值 27:12"),作者认为这个设计是对的。但"助手说过什么"即使换 Opus 也只从 0/8 涨到 4/8——助手给过的建议,一半还是没能进记忆。
这个批判要结合官方设计一起看才公平:Hy 的 chat 记忆 L2 存的是"原子事实",天然偏向"用户说了什么",助手输出的建议、推理过程在事实抽取环节容易被当成"过程性内容"过滤掉。这是架构取舍,不是 bug——但取舍的代价就是:在"记住助手干过什么"这个 vibe coding 核心场景(续写代码、接着调试)上,Hy 目前是吃亏的。coding 场景的双层 + diff 链正是为了补这一块,但评测测的是 chat 管线,两边的表现不能混为一谈。
判断:记忆工程的胜负手在"写入",不在"检索"
把官方发布和独立评测放在一起,一个判断浮出水面:记忆系统的好坏不在检索,在写入。"写记忆"这一步决定了信息的上限——写入时丢掉的东西,检索时再怎么努力也找不回来(40 条记忆还是 45%,就是证据)。向量检索、重排、图谱这些检索侧的优化,都是在写入定好的天花板底下跳舞。
这也解释了为什么腾讯要专门训练一个 30B 的记忆写入模型:它赌的是"写入"可以被做成独立、可优化、可替换的部件。如果这个赌注成立,记忆系统的竞争会从"谁的检索引擎强"变成"谁的写入模型准"——赛道会被重构。而独立评测恰好从反面验证了同一个结论:换更强的写入模型,成绩立刻回升。双方在"写入是关键"这一点上意外地一致,只是官方用来自证、评测用来挑刺。
对 vibe coding 读者来说,有三条可以直接用的:第一,选记忆方案时,先看它的写入管线怎么处理"助手输出"——很多方案默认只记用户说的话,这对结对编程场景是致命的;第二,coding 场景的版本演进 diff 链这个想法值得单独记住,"代码被改了几次、为什么改"这种轨迹信息,是任何向量检索都挖不出来的;第三,local-first + 跨工具打通的方向是对的,但落地前先看授权链——记忆越全,泄露面越大。
最后做几点划界,避免混淆:本文讲的是腾讯混元的 Hy Memory 2.0,不要和腾讯云 2026 年 8 月 3 日发布的 TencentDB Agent Memory v2.0 混为一谈,那是另一个团队的旧项目;官方自报的 55.49% 对 54.62% 是厂商自测数据,测试集与方法由官方制定,引用时请保留这个定语;独立评测的样本量不大(Opus 写入只测了 18 题),且作者是竞品方,结论的方向可信、具体数字建议打折看。
记忆这门工程,Hy Memory 2.0 给出了一个相当完整的答卷:分场景的记忆形状、专门训练的写入模型、本地优先的跨工具中枢。但独立评测提醒了所有人:答卷写得再漂亮,阅卷的是"写记忆的那个模型"。记忆系统下一步的战争,不在向量数据库里,在写入管线里。
评论 (0)
原始来源
相关文章
10 月 17 日,The Verge 报道大网站开始把 AI agent 拒之门外:摩根大通、嘉信理财确认封锁 agent 访问客户账户,Yelp 只放行付过数据授权费的 agent,达美与第三方 agent 无合作。本文梳理谁在关门、为什么,回顾亚马逊与 Perplexity 打了一年多的官司,并给 vibe coder 四个关于“路权战争”时代做开发的判断。
IBM Research 展示"agent factory":1 个协调者 agent 带 4 个并行工作者 agent,用纯开源模型做芯片设计空间探索,把量子纠错解码器 Relay-BP 的硬件实现提速 52 倍,推理成本仅约 26 美元。商业模型能跑到 204 倍,但要 299 美元。瓶颈不在模型能力,在"推理经济学"。
CVE-2026-111322(10 月 15 日):开源工作流引擎 Archon 的 /api/* 控制 API 默认无鉴权、绑定 0.0.0.0,CVSS 9.8。同一网络的攻击者可直接给 coding agent 下指令、以 bypassPermissions 在主机执行任意命令;截至 10 月 16 日无补丁。本文解释漏洞原理、分析 agent 工具为何总在“默认安全”上翻车,并给出三步自查。