Agent 挂了别重来:三层 checkpoint 让长任务随时能续
长任务的三种死法:上下文爆了、进程挂了、人把它掐了——共同点是进度全部作废。这篇指南给出三层 checkpoint:git 提交纪律保代码、数据快照保数据、阶段摘要保过程,外加幂等设计与每月 10 分钟恢复演练。Ctrl+C 从此只是小插曲。
长任务是怎么死的
问每个 vibe coder 一个问题:你最长的一次 agent 任务跑了多久?以及——它最后是怎么死的?答案通常是三种死法之一:上下文爆了(对话太长,agent 开始胡言乱语)、进程挂了(终端关了、网络断了、机器休眠了)、人把它掐了(看着不对劲,Ctrl+C)。
三种死法的共同点是:之前的进度全部作废。两小时的调研、半小时的依赖安装、一小时的测试运行,一次 Ctrl+C 回到解放前。Earendil 刚发布的 Pi Durable(本站昨日报道)把"checkpoint 续跑"做成了 agent 执行框架,但它的思想不需要等框架成熟——今天就能用三层 checkpoint 把你的长任务武装起来。
第一层:git 提交纪律——最便宜的 checkpoint
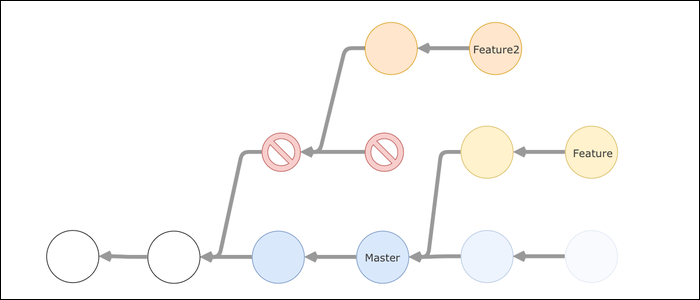
规则只有一条:每完成一个"可独立验证"的步骤,就提交一次。不是"做完整个功能再提交",而是"迁移写完且测试通过→提交;API 端点加完且自测通过→提交;前端接完且页面能跑→提交"。
把这条写进你的 AGENTS.md 或项目指令:"每个子任务完成后必须 git commit,commit message 说明验证方式"。agent 很听话,你让它每步提交,它就每步提交。这样即使任务在第 8 步挂了,前 7 步都在 git 历史里躺着——恢复不是"重来",是"从第 8 步继续"。
进阶技巧:让 agent 在开工前先建分支。长任务一律 feature 分支,挂了、跑偏了、改崩了,分支一删,main 干干净净。这比任何"撤销提示词"都可靠,因为 git 不会 hallucinate。
第二层:数据快照——给"不可逆"上保险
代码能 git 回滚,数据不行。agent 删库、改错迁移、写坏生产数据的故事,每个月都在上演。checkpoint 思想在这里的落地是:任何 agent 碰数据库之前,先有可回滚的快照。
具体做法按成本排序:Supabase/Neon 这类平台的分支功能(一条命令 fork 出完整数据副本,agent 在分支上折腾,验证通过再合回来);传统数据库的定时快照 + 任务前手动快照;至少,给迁移脚本加上 down 迁移——up 能执行,down 就必须能回滚。
还有一条铁律:agent 永远不直连生产库。staging 或分支副本是它的游乐场,生产库的写权限只属于经过你 review 的迁移脚本。这条规则的成本是多一次部署,收益是少一次删库跑路。
第三层:运行态 checkpoint——向 durable execution 借思想
前两层保的是"产出",第三层保的是"过程"。Pi Durable、Temporal、Restate 这类 durable execution 框架的核心思想可以提炼成三条,不用框架也能用:
1. 步骤即记录。 让 agent 把每一步的输入输出写进一个结构化的任务日志(JSONL 文件就行):第几步、调了什么工具、结果是什么、耗时多久。任务挂了,你打开日志就知道"死在哪一步",而不是对着几千行对话记录大海捞针。
2. 操作设计成幂等的。 这是 checkpoint 能"续跑"而不"重做"的前提:同一条命令跑两次,结果不变。创建资源前先检查存在性("如果表已存在则跳过"),写文件用覆盖而非追加,API 调用带幂等键。让 agent 在写脚本时遵守幂等,续跑时就不用担心"第 3 步又执行了一遍把数据写重了"。
3. 恢复点是人定的,不是天生的。 在长任务开始前,先和 agent 约定:"每完成一个阶段,输出一份状态摘要(已完成/进行中/待办/阻塞点)"。这份摘要就是你的恢复点——新开一个会话,把摘要粘进去,agent 就能接着干。上下文窗口会爆,摘要不会。
恢复演练:别等真挂了才试
checkpoint 和备份一样,不演练等于没有。每月做一次 10 分钟的演练:
故意 kill 掉一个运行中的长任务,用 git log 找到最后一个好的提交,从那里开新分支继续;用一份阶段摘要开新会话,看 agent 能否无缝接上;恢复一次数据库分支快照,确认流程走得通。演练中发现的任何"卡住"(比如摘要信息不够、分支合并不了),都是真事故发生前最便宜的学费。
三个反模式
反模式一:checkpoint 太粗。 "做完再提交"等于没有 checkpoint。检验标准:任意时刻 kill 任务,你最多损失 15 分钟的工作。超过这个数,说明提交粒度太粗。
反模式二:只备代码不备数据。 git 历史再完整,也救不回被 agent 改坏的数据库。代码和数据是两套 checkpoint,缺一不可。
反模式三:把 checkpoint 当摆设。 提交了但不写验证信息、建了分支但从不在分支上验证、写了摘要但恢复时发现信息不够——checkpoint 的质量决定恢复的质量。每次恢复后问自己:这次恢复顺畅吗?不顺畅的地方就是下次要修的。
一句话总结
长任务的可靠性不靠"一次跑成"的运气,靠"随时能续"的设计。git 提交纪律保代码,数据快照保数据,阶段摘要保过程——三层 checkpoint 建起来,Ctrl+C 就从"灾难"降级成"小插曲"。框架会进化,但这个思想不会过时。
相关文章

10 月 3 日,工程师 Kevin Liao 发表檄文冲上 HN 前页:记忆插件是一场 RAG 片段抽奖,Agent 需要的是文档工作区。本文拆解他的诊断、开源的 Operator Memory 插件、两个最强的反方质疑,以及今晚就能开始的最小实践。

Gergely Orosz 走访 OpenAI、Anthropic、Cursor、Ramp 后写下的 2026 行业现状:近 100% 代码由 AI 生成、Agent PR 八个月涨近 10 倍、code review 沦为表演、IDE 被判为遗产产品。本文提炼报告要点,并给出 vibe coder 的三个判断与四件本周可做的事。

每个 vibe 项目都会经历同一个黑色幽默时刻:网站白屏了,朋友比你的监控先告诉你。这篇实战为一人团队搭建完整错误监控体系:5 分钟 Sentry 最小闭环、错误边界、上报上下文设计、后端结构化日志、AI 调用专项防护、告警分级降噪,最后附上线检查清单。