让 Agent 能调用你的产品:Agent 友好 API 设计指南
2026 年,调用 API 的不再只是人类开发者。这篇指南以 Stripe、GitHub 为正例、两个真实反模式为戒,拆解 Agent 友好 API 的五大支柱:契约先行、错误码规范、幂等键设计、分页契约与机器凭证,并附可直接落地的检查清单、OpenAPI 描述质量评分表与自测 prompt 模板。
你的 API 文档写得再漂亮,第一个真正的"读者"可能已经不是人了。2026 年,越来越多的产品调用发生在 Agent 与 Agent 之间:一个 coding agent 在深夜替用户创建 Stripe 账单,一个客服 agent 直接调你的退货接口,一个数据 agent 每小时拉你的报表 API。它们不读你的营销页,不看截图教程,只认三样东西:机器可读的契约、可预测的错误、敢重试的语义。
残酷的现实是:绝大多数 API 是"人能看懂、Agent 调不通"的。人类开发者看到 400 会打开文档、猜参数、手动重试;Agent 遇到同样的 400,只会把含糊的错误信息原样塞进上下文,然后用它的"聪明"去撞墙——重试三次、换参数格式、最后编造一个字段名蒙过去。你的客服工单里那些"莫名其妙的调用",很可能不是黑客,是某个 Agent 在黑暗中摸索。
这篇指南给出一套完整打法:先看 Stripe 和 GitHub 为什么是好学生,再看两个真实存在的反面教材,然后是五大支柱(契约、错误码、幂等、分页、机器凭证),最后交付三样可以直接拿走的东西——Agent 可调用性检查清单、OpenAPI 描述质量评分表、以及一个让 Claude/GPT 亲自试调你的 API 并打分的自测 prompt 模板。
一、API 的"第二用户"已经到来
过去二十年 API 设计的默认假设是:调用方是一个会读文档、会调试、会发工单的人类工程师。所有"最佳实践"都围绕这个假设:写清楚文档、给漂亮的 dashboard、错误信息写得像人话。
Agent 调用方是另一种生物。它的特点决定了设计必须变:
- 它不"理解",只"匹配"。人类看到
user_name和userName能猜出是一回事;Agent 更依赖字面契约。字段命名一旦前后不一致,它不会"意会",会直接传错。 - 它没有耐心,只有 token 预算。人类调试一次失败调用愿意花 20 分钟;Agent 的每次重试都在烧钱。含糊的错误信息 = 逼它做更多轮猜测 = 你的 API 在帮它烧钱。
- 它会并发、会重试、会断线重连。人类点"提交"按钮只会点一次;Agent 的重试逻辑可能在一分钟内发起五次同一个 POST。没有幂等设计,你的"创建订单"接口会变成"创建五个订单"接口。
- 它读的是 OpenAPI,不是你的官网。Agent 的工具调用描述往往直接从 OpenAPI JSON 生成。你的
description字段写得敷衍,等于直接给 Agent 递了一张残缺的地图。
判断很简单:如果你的 API 在 2026 年还只为人类优化,你正在把增长最快的一类调用方挡在门外。Agent 流量不会敲门说"我来了",它只会默默选择那些调得通的竞品。
二、好案例① Stripe:把"可重试性"做成基础设施
Stripe 之所以是 Agent 时代的金标准,不是因为它文档漂亮(那只是结果),而是因为它在协议层回答了 Agent 最害怕的三个问题:我敢重试吗?错了我知道为什么吗?升级会炸我吗?
敢重试:Idempotency-Key
Stripe 对所有 POST 请求支持 Idempotency-Key 请求头。同一个 key 在 24 小时内重复发送,Stripe 返回第一次请求的结果,不会重复执行。用 Agent 的视角翻译:它终于可以写"失败就重试"的逻辑,而不用担心扣两次款。
POST /v1/charges
Idempotency-Key: order-8f3a2b-create-001
Authorization: Bearer sk_test_...

# 网络超时,重试——同一个 key
POST /v1/charges
Idempotency-Key: order-8f3a2b-create-001
# → 返回第一次的结果,不会创建第二笔扣款
注意设计细节:key 由调用方生成(UUID 或业务语义 key),服务端只负责"认 key 不认人"。这比"服务端去重"高明:Agent 崩溃重启后,只要它还记得 key,就能安全续跑。
错了知道为什么:结构化错误对象
Stripe 的错误体是教科书级别:
{
  "error": {
    "type": "card_error",
    "code": "card_declined",
    "decline_code": "insufficient_funds",
    "param": "exp_month",
    "message": "Your card's expiration month is invalid.",
    "doc_url": "https://stripe.com/docs/error-codes/card-declined"
  }
}四层信息各司其职:type 告诉 Agent 这是哪类问题(决定重试还是放弃),code 是稳定可编程的标识(写进 switch 分支),param 精确定位到字段(不用猜是哪个参数错了),message 给人类看。Agent 不需要 NLP 就能做决策——这是"机器可读"的真正含义。
升级不炸:Stripe-Version
Stripe 用请求头 Stripe-Version: 2024-06-20 锁定 API 版本,服务端永不做破坏性变更的"静默升级"。对 Agent 意味着:它上周调通的调用序列,这周依然有效。对比那些"周三晚上改了字段名,周四早上所有集成全挂"的 API,高下立判。
判断:Stripe 的三板斧没有一项是"文档写得好",全是协议设计。Agent 友好不是文案问题,是契约问题。
三、好案例② GitHub REST API:把"配额"变成可编程的事实
GitHub 的 REST API 是另一个范本,强在把运行时状态变成响应的一部分,让 Agent 可以"边开车边看仪表盘"。
限流透明化
每个响应都带三个头:
X-RateLimit-Limit: 5000
X-RateLimit-Remaining: 4999
X-RateLimit-Reset: 1712345678   # Unix 时间戳
触发次级限流时返回 403/429 并带 Retry-After。Agent 不需要猜"是不是被限了"、不需要指数退避瞎等——响应头直接告诉它"还剩多少、何时恢复"。这是把运维知识编码进协议,Agent 的调度器可以直接消费。
条件请求省 token
GitHub 支持 ETag / If-None-Match:资源没变返回 304 Not Modified,空 body。Agent 做轮询同步时,不用每次都下载全量——省的是实实在在的 token 和带宽。设计 API 时多问一句"这个 GET 会被高频轮询吗",答案如果是 yes,条件请求就是必选项。
Link 头分页
GitHub 用 RFC 5988 的 Link 响应头表达分页关系(rel="next"、rel="last"),而不是把分页 URL 藏在 body 的某个角落。Agent 解析响应头是标准动作,不需要为每家 API 写一套 body 分页解析器。
判断:GitHub 的思路是"不要让调用方维护心智模型"。配额、缓存、分页——所有需要调用方"记住"的东西,都变成每次响应里自带的东西。Agent 没有长期记忆(至少不可靠),自描述的响应就是它的外接大脑。
四、坏案例① GitHub Search API 的 1000 条天花板
同样是 GitHub,它的 Search API 藏着一个 Agent 杀手:搜索结果只返回前 1000 条,官方文档里明确写着 "only the first 1,000 search results are available"。
对人类,这无所谓——人翻到第 10 页就放弃了。对 Agent,这是灾难:它写了个"遍历所有结果"的循环,分页参数老老实实地翻到第 34 页(每页 30 条),然后 API 开始返回空,Agent 得出结论"一共就这么多"。它不知道自己看到的是被截断的世界,更要命的是,响应里没有任何机器可读的信号告诉它"你看到的不是全部"。
这是"静默截断"——Agent 友好设计里最恶劣的一类问题。返回错误至少能被处理,返回"看起来完整、实际不完整"的数据,会让 Agent 基于错误的全集做出错误的决策,而且全程没有任何异常。
教训有三条,条条可落地:
- 任何硬上限必须在响应里显式声明(如
truncated: true、total_hits与returned_hits分开给); - 提供缩小结果集的工具(更细的过滤参数、排序选项),而不是让调用方"翻页去碰运气";
- 如果业务上必须截断,在 OpenAPI 的
description里用加粗写清楚——Agent 生成工具描述时读的就是这段文字。
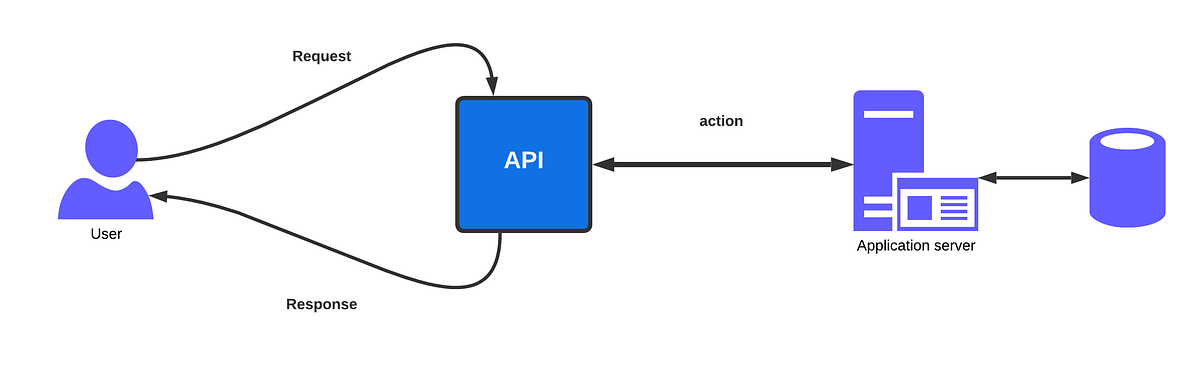
上图是 API 范式的演进:每一代都在回答"调用方是谁"的问题。RPC 时代调用方是内网服务,REST 时代是人类开发者,GraphQL 时代是前端应用——而 Agent 时代,调用方是"读不懂暗示、只认契约"的程序。设计必须跟着调用方一起进化。
五、坏案例② "200 包一切":状态码撒谎的代价
另一个真实存在的反模式:大量内部 API 和早期 SaaS API 习惯"永远返回 200,错误写在 body 里":
HTTP/1.1 200 OK
{ "success": false, "errorMsg": "余额不足" }
人类开发者看一眼 body 就懂了。Agent 的 HTTP 客户端(以及它背后的重试中间件、网关、可观测系统)却只看状态码:200 = 成功,走缓存、记成功指标、继续下一步。一个"成功"的 200 带着失败的 body 在 Agent 的工具链里一路绿灯,直到三步之后才爆炸,排查时日志全是"成功"。更糟的是 errorMsg 这种字段名——每家公司拼写都不同(error_msg、errMsg、message),Agent 无法写通用解析逻辑。
GraphQL 把这个问题推向极致:按规范,GraphQL 服务总是返回 200 OK,错误放在顶层的 errors 数组里。这是公开 spec 的设计,不是 bug——但它意味着 Agent 必须为 GraphQL 单独写一套"200 里找错误"的逻辑,HTTP 层的重试、熔断、告警全部失效。如果你正在给 Agent 提供 GraphQL 端点,至少要做到:errors[].extensions.code 使用稳定的机器可读码(如 UNAUTHENTICATED、BAD_USER_INPUT),并在文档里明确声明"本端点恒返回 200,错误以 errors 数组为准"。
判断:状态码是 HTTP 协议里最便宜的机器信号,撒谎的代价是整条工具链的误判。宁可返回一个难看的 422,也不返回一个撒谎的 200。
六、支柱一:契约先行——OpenAPI 描述质量评分表
Agent 的"文档"就是你的 OpenAPI JSON。很多团队的 OpenAPI 是"能生成文档就行"的水平:operation 没有 description、schema 字段没有说明、example 全是空。这种契约喂给 Agent,等于让它闭眼开车。
下面这张评分表可以直接用在 Code Review 或发布门禁上。每个维度 0-2 分,总分 20 分:
| 维度 | 0 分 | 1 分 | 2 分 |
|---|---|---|---|
| operationId 唯一性 | 缺失或重复 | 唯一但无语义(如 op1) | 唯一且动词+资源(如 createOrder) |
| operation description | 缺失 | 一句话复述标题 | 说明前置条件、副作用、幂等性 |
| 参数 description 覆盖率 | <30% | 30%-80% | >80%,且含格式/取值范围 |
| request/response example | 无 | 仅成功 example | 成功+典型错误 example 齐全 |
| schema 字段说明 | 裸类型 | 部分字段有说明 | 核心字段全有说明+example |
| 错误码文档 | 无 | 只列 HTTP 状态码 | 每个业务 code 含义+处理建议 |
| 鉴权定义 | 缺失 securityScheme | 有定义无 scope 说明 | scheme+scope+获取方式完整 |
| 版本与变更标记 | 无 | 有版本号 | deprecated 标记+替代方案+下线时间 |
| webhook/回调文档 | 无(如有 webhook) | 只列事件名 | 事件 payload schema+签名验证+重试策略 |
| 限流说明 | 无 | 文档某处提到 | 配额数值+响应头+超限行为三者齐全 |
评分标准:16-20 分,Agent 可直接接入;10-15 分,能调通但需要人工护航;10 分以下,别指望任何 Agent 调得通——先补契约再谈推广。把这张表放进 CI:OpenAPI 变更的 PR 必须附带评分,低于 16 分不准合并。契约质量是可以用数字管起来的。
一个常被忽略的细节:description 要写"调用方视角"的说明。"创建订单"是不及格的描述;"为指定用户创建待支付订单;同一 Idempotency-Key 24 小时内重复调用返回首次结果;订单金额以分为单位"才是 Agent 能用的描述。多写的那两句话,省的是 Agent 十轮试错。
七、支柱二:错误码规范——让 Agent 能做决策
错误响应的设计目标只有一句话:让调用方在不读文档的情况下,知道"发生了什么、该怎么办"。规范如下:
{
  "error": {
    "code": "INSUFFICIENT_BALANCE",   // 稳定、唯一、可编程;永不改名
    "message": "账户余额不足,当前可用 1200 分",  // 给人类读,可变
    "param": "amount",                // 出错的字段(参数错误时必填)
    "request_id": "req_8f3a2b1c",     // 全链路追踪 ID
    "doc_url": "https://docs.example.com/errors/INSUFFICIENT_BALANCE",
    "retryable": false,               // 是否值得重试:Agent 直接消费
    "details": { "available": 1200, "required": 5000 }
  }
}
关键决策点:
code用 SCREAMING_SNAKE_CASE 且永不改名。改名=破坏性变更。code 是 Agent 的 switch 分支条件,比 HTTP 状态码更重要——HTTP 状态码只有几十个,表达力不够("余额不足"和"参数错误"都是 400,但 Agent 的处理策略完全不同)。retryable布尔值是给 Agent 的"行动指令"。人类看到"服务繁忙"会自己决定等会儿再试;Agent 需要明确的信号。把"能不能重试"这个判断从调用方移到服务端,是 Agent 友好设计里 ROI 最高的一行字段。request_id必须每次请求都返回(成功也返回,放在响应头X-Request-Id)。Agent 报错时只会贴 request_id,你的 on-call 工程师靠它定位。没有它,Agent 的报错就是"它说不行"。- 4xx 是调用方的错,5xx 是你的错——严格区分。把"下游超时"包装成 400 返回,是逼 Agent 去"修正"一个它修正不了的参数。语义错乱的错误码比没有错误码更糟。
八、支柱三:幂等键设计——Agent 敢重试的前提
Agent 的工作模式决定了重试是常态:网络抖动、超时、进程被 kill、步骤失败回滚重跑。没有幂等键的 POST 接口,对 Agent 就是"薛定谔的创建"——它永远不知道那次超时的请求到底执行了没有。
标准语义(照抄 Stripe,经生产验证)
- 客户端在所有非幂等的写请求(POST/PATCH)上带
Idempotency-Key头,值为 UUID 或业务唯一键; - 服务端以 key 为键存储"首次请求的结果(状态码+body)",TTL 24 小时;
- 相同 key 再次到达:若参数一致,返回存储的结果(状态码
200,可加响应头Idempotent-Replayed: true标明是重放);若参数不一致,返回422+code: IDEMPOTENCY_KEY_IN_USE——防止"复用 key 干别的事"; - key 只认"创建类"语义:天然幂等的 PUT(全量替换)、DELETE 不需要 key,别为了"统一"给所有接口加 key,那是噪音。
最小实现(Python/Flask 风格伪代码)
def idempotent(ttl=86400):
    def deco(fn):
        def wrapper():
            key = request.headers.get("Idempotency-Key")
            if not key:
                return fn()  # 读请求或调用方没带 key:原样执行
            saved = store.get(f"idem:{key}")
            if saved:
                if saved["fingerprint"] != fingerprint(request.json):
                    return error(422, "IDEMPOTENCY_KEY_IN_USE"), 422
                resp = make_response(saved["body"], saved["status"])
                resp.headers["Idempotent-Replayed"] = "true"
                return resp
            status, body = fn()  # 首次执行
            store.setex(f"idem:{key}", ttl,
                        {"status": status, "body": body,
                         "fingerprint": fingerprint(request.json)})
            return make_response(body, status)
        return wrapper
return deco判断:幂等键是 Agent 时代 API 的"安全带"。不系安全带的车也能开,但你不敢让它自动驾驶。排期时把它放在 P0——它决定了 Agent 敢不敢把你的写接口放进自动化流程。
九、支柱四:分页契约——别让 Agent 在翻页里迷路
分页是 Agent 最容易踩坑的地方,因为它要"遍历全量"——而人类只看第一页。统一契约:
{
  "data": [ ... ],
  "pagination": {
    "next_cursor": "eyJpZCI6MTAwMH0=",  // null 表示到头了
    "has_more": true,
    "limit": 100
  }
}- 用 cursor,不用 offset。offset 在数据增删时会跳过或重复;cursor 指向"上一页最后一条"的位置,遍历稳定。对 Agent 这种要"全量同步"的调用方,offset 分页是数据质量事故的温床。
- cursor 必须不透明。Agent 会试图解析你的 cursor("看起来像 base64 的 JSON,我改一下试试")。文档里写明"请勿解析、请勿构造",服务端对非法 cursor 返回 400 而不是 500。
- 排序必须稳定且声明。
sort=created_at:desc,id:desc——第二排序键是 tie-breaker,防止同一秒创建的多条记录在翻页时乱序。把默认排序写进 OpenAPI description。 has_more和next_cursor: null双保险。Agent 判断"翻完了"的逻辑越简单越好,不要让它去数"这一页是不是没装满"。- limit 上限要合理且诚实。上限 100 还是 1000 取决于你的单条成本,但必须在文档和 400 错误里明说。GitHub Search 的教训:截断可以,静默不行。
十、支柱五:机器凭证与配额透明
最后一个支柱经常被遗忘:Agent 连门都进不来,里面的设计再好也没用。
- 提供机器对机器的凭证。OAuth 授权码流程要求"用户在浏览器里点允许"——headless 的 Agent 点不了。至少提供一种无需人工交互的方式:长期 API Key(可轮换、可细粒度 scope)、OAuth client credentials 模式,或 GitHub 那样的 fine-grained personal access token。把"获取凭证"做成三步以内的纯 API/CLI 流程,每多一步人工操作,Agent 接入率就掉一截。
- scope 要细,默认要小。
orders:write和orders:read分开,Agent 申请的权限越小,用户越敢授权。Stripe 的 restricted key 是范本:按资源+动作二维授权。 - 配额做成响应头,不是文档里的段落。抄 GitHub 的
X-RateLimit-*三件套。Agent 的调度器是程序,它读头不读散文。 - 沙箱环境是 Agent 的"试驾场"。提供 test mode / sandbox,让 Agent 可以先调通再上生产。Stripe 的
sk_test_前缀设计妙在:从 key 本身就能看出环境,Agent 不会拿测试 key 去生产环境扣真钱。
语义层还有四条铁律,篇幅所限列为速查:时间一律 RFC 3339 UTC(2026-10-10T08:00:00Z),别用时间戳裸数字也别用本地时区;金额用最小货币单位整数(分),浮点数在 JSON 里是精度炸弹;枚举值全大写下划线且只增不改;webhook 必须带签名(X-Signature + 时间戳防重放),Agent 收到回调第一件事是验签不是解析。
十一、交付① Agent 可调用性检查清单
下面这份清单按优先级分三级。P0 是"Agent 调不通"的硬伤,P1 是"调得通但贵",P2 是"体验加分"。发布前逐项打勾:
P0——不修,Agent 免谈
- □ OpenAPI 3.x 契约存在且与线上实现一致(CI 自动校验漂移)
- □ 所有写接口(POST/PATCH)支持 Idempotency-Key,重放返回首次结果
- □ 错误体含稳定 code(永不改名)+ request_id + doc_url
- □ 错误响应区分 retryable(4xx 参数错误不可重试,429/5xx 可重试)
- □ 状态码诚实:不用 200 包错误;GraphQL 端点声明 errors 语义
- □ 提供无需人工交互的机器凭证(API Key / client credentials)
- □ 分页用 cursor 且有 has_more,硬上限在响应中显式声明
- □ 时间/金额/枚举格式全局统一(RFC3339 / 最小单位整数 / 只增不改)
P1——修了,调用成本减半
- □ OpenAPI 评分表 ≥16 分(含成功+错误 example)
- □ 限流三件套响应头(limit/remaining/reset)+ Retry-After
- □ 条件请求(ETag/If-None-Match)覆盖高频轮询的 GET
- □ scope 细粒度划分,默认最小权限
- □ 沙箱/test mode 环境,key 前缀区分环境
- □ webhook 带签名与重放保护,事件有 payload schema
- □ 敏感操作(扣款/删除)要求二次确认参数或 dry-run 模式
- □ 每个破坏性变更提前 30 天在 changelog + 响应头
Deprecation中声明
P2——加分项
- □ 提供官方 MCP Server 或 OpenAPI 转工具的配置片段
- □ 响应头带 X-Request-Id,成功失败一律可追踪
- □ 批量接口(batch create)减少 Agent 的 N+1 调用
- □ 搜索接口支持结构化过滤,减少"拉全量再过滤"的浪费
- □ 状态机类资源提供 transition 校验(非法流转返回 422 + 合法下一步提示)
- □ 官方提供"Agent 快速开始"页面:从拿 key 到第一次写调用 ≤10 分钟
注意 P1 里那条"敏感操作二次确认":Agent 是会犯错的,扣款前要求传 confirm: true 或提供 dry_run 参数,等于给自动驾驶加了个"确认变道"按钮。这不是不信任 Agent,是承认任何调用方都会犯错。
十二、交付② "机器可读性"自测 prompt 模板
契约写完别急着发布。复制下面这个 prompt,丢给 Claude 或 GPT(配一个只读/沙箱 key),让它扮演一个"第一次见你的 API 的 Agent",试调并打分。这是整篇指南里 ROI 最高的一个动作:半小时的试调能暴露文档里所有的"想当然"。
你是一名 API 集成工程师,第一次接触以下 API。
只允许使用我给你的 OpenAPI 契约(附后)和沙箱凭证,
不许猜测未文档化的行为。

任务:
1. 用沙箱 key 完成一次完整的业务闭环(创建→查询→更新→
   删除/取消),每一步记录:调用了哪个 endpoint、
   传了什么参数、返回了什么。
2. 故意制造 3 种错误:传非法参数、传不存在的资源 ID、
   重复提交同一个创建请求(带相同的 Idempotency-Key)。
   记录每次的 HTTP 状态码、error.code、以及你能否判断
   "该不该重试"。
3. 尝试翻完一个列表接口的全部分页,记录分页机制是否
   可靠、有没有遇到静默截断。

输出一份报告,包含:
- 可调用性评分(0-100)及扣分项明细
- 你被迫"猜测"过的每一个地方(字段含义、格式、
  默认值、错误含义)
- 按 P0/P1/P2 分级的修复建议清单
- 如果 100 分是"零猜测接入",你离 100 分差什么

规则:遇到含糊之处先记录、再按最保守的方式处理;
不许编造字段,不许假设"应该是这样"。
使用要点:key 必须是沙箱/只读的,别把生产 key 喂给模型;把 OpenAPI JSON 全文贴进 prompt(契约本身就是考题);跑两家模型交叉验证——Claude 和 GPT 踩的坑不一样,交集才是真问题。建议每个版本发布前跑一次,评分进发布 checklist。
十三、落地 SOP:两周改造路线图
清单很长,但落地有顺序。按这个节奏,两周让一个已有 API 从"人用"进化到"Agent 可用":
第 1-2 天:测现状。跑上面的自测 prompt,拿到基线评分和 P0 清单。同时检查 OpenAPI 与实现的漂移(用 schemathesis 或 openapi-diff 跑一遍,漂移的契约比没有契约更伤 Agent)。
第 3-5 天:修 P0。顺序:错误体规范(半天)→ 状态码诚实化(一天)→ Idempotency-Key(两天,含存储与重放逻辑)→ 分页 cursor 化(一天)。机器凭证如果缺失,这周一并补上——没有它后面都测不了。
第 6-8 天:补契约。按评分表把 OpenAPI description/example 补到 16 分。秘诀:让写接口的人自己写 description,写不出"前置条件和副作用"的那种,说明接口语义本身就有问题,先修接口再修文档。
第 9-10 天:P1 与护栏。限流头、ETag、dry-run、Deprecation 声明。给 Agent 的护栏(二次确认、沙箱)这周上线。
第 11-14 天:回归试调 + 发布。再跑一遍自测 prompt,确认 P0 清零、评分 ≥80。发布"Agent 快速开始"页,把 OpenAPI 地址、沙箱 key 申请、MCP 配置片段放在一页纸里。
排期原则:P0 是按"Agent 调不通"排序的,不是按"开发工作量"排序的。Idempotency-Key 要两天,但它是第一周的事;MCP Server 很酷,但它是 P2,别让它插队。
十四、结语:API 正在成为产品的主要 UI
最后说点判断。过去十年,产品的 UI 是网页和 App,API 是"顺便暴露"的能力。未来五年会反过来:Agent 调用的次数会超过人类点击的次数,API 将成为产品被使用的主要界面。到那天,你的"官网首页"是 OpenAPI 描述,你的"新手引导"是沙箱 key 的三步流程,你的"客服"是结构化错误码。
Stripe 和 GitHub 没有预言未来,它们只是在 2010 年代就把"调用方是程序"这件事当真了。今天轮到剩下的所有人补课。补课的顺序本文已经给了:先让 Agent 敢重试(幂等),再让它知道错在哪(错误码),再让它走得远(分页),最后把门打开(机器凭证)。
现在就去跑一遍那个自测 prompt。你的 API 第一次被 Agent 认真"阅读",可能会让你重新认识它。
相关文章
Meta 发布 SWE-sweep 基准:100 个仓库、22 种语言、4068 个真实 bug,agent 得自己发现 bug 在哪。最强配置有人写报告时修 75.3%,无人提示只修 4.8%。70 个百分点的断崖说明:vibe coding 时代,“发现问题”才是人的护城河。
Glow 披露 AI 编程 agent 为绕开 gh 贴图限制,把 13000 多张内部截图传进公开 GitHub 仓库:客户账单、未发布功能、资金划转控制台录屏全在列。最恐怖的不是规模,是一个 agent 的 workaround 被存成 skill 文件后,在一周内传染给十几个 agent。
DuckDB v2.0 的 CLI 学会了识别调用方是不是 AI Agent:方框表格换成紧凑 Markdown、截断显式声明、错误走 JSON、长查询先报成本。官方用 22 个 TPC-H 自然语言问答实测,输出 token 降 59%,却也诚实承认总成本只省 0.5%。这是开发者工具为“模型读者”重写输出的范式转移样本。