有 Bug 报告修 75%,没人告诉就只修 5%:Meta SWE-sweep 撕开 AI 编程智能体的遮羞布
Meta 发布 SWE-sweep 基准:100 个仓库、22 种语言、4068 个真实 bug,agent 得自己发现 bug 在哪。最强配置有人写报告时修 75.3%,无人提示只修 4.8%。70 个百分点的断崖说明:vibe coding 时代,“发现问题”才是人的护城河。
同一个最强配置,在同一批 20 个仓库上做对照实验:给它一份人类写好的 bug 报告,它能修掉 75.3% 的 bug;把报告拿走,其它条件完全不变,它只修掉 4.8%。70 个百分点的断崖,发生在同一个模型、同一个 agent 框架上,唯一的变量是——有没有人先告诉它,哪里坏了,坏成什么样。
这组数字来自 Meta 研究团队 10 月 1 日发布的 SWE-sweep,一个全新的 AI 编程智能体基准。它的口号很直接:How many bugs can LMs find & fix in large codebases?(大语言模型能在大型代码库里发现并修复多少 bug?)据报道,该基准共收录 100 个开源仓库、22 种语言、4068 个真实 bug——但它最狠的设计不是规模,而是一个减法:不给 issue 描述。
这意味着 agent 拿到的只是一个处于固定提交点的仓库,和一句宽泛的指令:"尽可能多地找出并修复 bug"。没有 issue 标题,没有复现步骤,没有文件名和行号提示。它得先自己翻仓库、读文档、跑测试,判断"哪里不对劲",然后才是修。而这恰恰是过去所有编程基准都在替 agent 省掉的那一步。
为什么是 Meta 来做这件事,时机也很值得玩味。2026 年的 vibe coding 浪潮里,"AI 程序员"的叙事已经从"帮你写代码"滑向了"替你干活"——自动修 bug、夜间扫仓库、无人值守重构,pitch deck 里什么都有。但所有支撑这些叙事的分数,几乎都来自"考解题"的基准。SWE-sweep 像是 Meta 给行业泼的一盆带着数据的冷水:先别聊取代,先测测你们的 agent 在没人带路的情况下,能不能走出第一步。
先说清楚:它和 SWE-bench 不是一回事
本站 10 月 6 日发过《SWE-bench Pro 十月榜》,读者很可能把两者搞混,这里必须划清界线。SWE-bench 系列(含 Pro)考的是解题:给你代码库,外加一份用户已经写好的 issue——哪里坏了、大概怎么复现都讲清楚了,agent 只管修。考的是"修得对不对、快不快"。
SWE-sweep 考的是发现:issue 本人被从考场里请出去了。agent 得先回答"这里有没有 bug",再回答"怎么修"。用考试打比方,SWE-bench 是开卷考里老师还给你划了重点;SWE-sweep 是把你扔进一个 40 万行的代码库,说"里面有几十个错,自己找"。两者测的根本不是同一种能力,分数也完全不可比——这也是为什么 SWE-sweep 的榜首只有 4.7%,而 SWE-bench 榜单上动不动 70%+。
这个区分很重要,因为它决定了你怎么解读分数:4.7% 不是"模型变笨了",而是"考试变难了"——难在考官终于开始考那道一直被跳过的题。
更深一层看,SWE-bench 的高分本身就有"分数通胀"的嫌疑。一份写得好的 issue,其实已经替 agent 完成了整个调试流程里最难的两步:定位("大概是支付模块的问题")和定性("预期行为应该是 X,实际是 Y")。agent 剩下的工作,经常只是把自然语言描述翻译成代码 diff——而这恰恰是大语言模型最擅长的事。所以过去两年我们看到的"AI 编程能力指数级上升",有一部分上升的是"人类把问题描述得越来越清楚"的能力,而不是模型本身。SWE-sweep 的价值就在于它第一次把这两件事拆开了称。以后再看到某个模型的编程分数,第一反应应该是去翻它的测试条件:issue 给了多少提示?提示越多,分数的水分越大。
这 4068 个 bug 是怎么"藏"进去的
SWE-sweep 的构造方法值得细说,因为它决定了这个基准的可信度。研究团队从开源仓库里收集真实的 issue–PR 配对,然后为每个仓库找到一个历史上 bug 共存数量最多的提交点,把那一刻同时存在的 bug 一次性"冻结"在那里。每个 bug 都带两样东西:修复补丁(fix patch)和测试补丁(test patch)。
评估时,agent 提交修改后的代码库要过两道关:第一道,恢复仓库原有的测试套件全量跑一遍,确认没有引入回归——官网写得非常直白,agent 被明确告知不许弄坏已有测试,否则整轮直接记 0 分;第二道,针对每个 bug 跑一组隐藏测试,这些测试在原始代码上至少有一个是失败的(fail-to-pass),修复后必须全过。
还有一道更关键的筛选:只有"从仓库本身就能发现"的 bug 才会被收录。所谓"能发现",指预期行为必须能从仓库内部推断出来——文档、类型注解、已有测试、调用方代码、不变量、命名标准,或者干脆就是崩溃、数据丢失这种谁都认的坏味道。官方说,除了 2 个 bug 之外,所有 bug 都有明确的仓库内契约(repository contract)描述预期行为。这是在堵一个显而易见的漏洞:如果 bug 连人都得靠"上帝视角"才知道,那考 agent 就是耍流氓。
官网甚至把发给 agent 的完整 prompt 公开了,读下来能感到设计者的"防作弊"执念。prompt 里明确定义了什么算"可接受的预期行为来源":一是用户看得到的文档(含 docstring、类型注解,以及模块声明自己实现的外部标准);二是普遍共识,比如 C++ 程序不该段错误、不该误删用户数据、UI 不该卡死。而"带外知识"被一律排除在外——维护者的意图是什么、issue 原文怎么说、训练数据里记不记得这个项目,全部不算数。agent 还被要求开工先跑一遍测试套件,记住哪些本来就是红的:只有这些"本来就红"的测试允许继续红,其它的一律不许碰,碰了整轮记零分。换句话说,这个基准不仅考"你找不找得到 bug",还考"你动刀子的时候手稳不稳"。
顺带一提,榜单上所有模型用的都是同一个 agent 脚手架 mini-SWE-agent。官网 FAQ 里专门回应了"换脚手架会不会更高":论文里拿 Claude Code 和 Codex 做过消融实验,结果是并没有明显超越 mini-SWE-agent——后者甚至还强过 Codex 一截。所以这份榜单比的,基本就是模型本身的差距。
排行榜:分数低得诚实,账单高得吓人
来看官网实时榜单(截至本文撰写时):
- 第 1 名:Sol 5.6(xhigh),4.7%,单轮成本 7,230 美元
- 第 2 名:Luna 5.6(xhigh),2.5%,单轮成本 224 美元
- 第 3 名:Terra 5.6(xhigh),1.5%,单轮成本 357 美元
- 第 4 名:Luna 5.6(high),1.4%,单轮成本 28 美元
- 第 5 名:Opus 5(xhigh,Anthropic),1.3%,单轮成本 5,363 美元
- 第 6 名:Kimi K3(Moonshot AI),0.6%,单轮成本 2,451 美元
三组对比值得嚼一嚼。第一,榜首 Sol 5.6 拿下 4.7% 的代价是 7,230 美元——一次全量 sweep 烧掉七千多美元,而官网还补了一句:正在尝试更高的推理模式,但单轮可能突破 1 万美元。这意味着"发现 bug"这件事,目前的解法是用钱砸长轨迹硬扛,边际收益还递减:官方明确说,重复尝试能多找回一些 bug,但收益递减,而且拉长单轮轨迹还有可能把之前修好的又弄坏。
第二,性价比之王其实是第 2 名的 Luna 5.6(xhigh):2.5% 的分数是榜首的一半多一点,成本却只有 224 美元——大约是榜首的 1/32。如果你想拿这个基准当"夜间扫仓库"的工具,Luna 5.6 这个档位才是现实选择,尽管 2.5% 的绝对值依然寒酸。
第三,Anthropic 的 Opus 5 花了 5,363 美元只拿到 1.3%,Kimi K3 花 2,451 美元拿到 0.6%。钱和分在这里完全不成正比——这说明"自主发现 bug"考的不是堆算力能线性解决的东西,模型之间存在真实的能力断层。
还有一个容易被忽略的细节:榜单上所有模型跑的是同一个 mini-SWE-agent 脚手架,而官网 FAQ 明确说,论文里用 Claude Code 和 Codex 做过消融对比——换脚手架并没有显著超越。这意味着当前这份榜单的天花板,基本就是"模型 + 通用脚手架"这个组合的天花板,而不是某个被埋没的工程技巧。想突破 5%,大概率需要新的 agent 范式,而不是把现有轨迹拉得更长——而拉长轨迹这条路,官方已经剧透了结局:收益递减,还可能把修好的弄坏。
观点:断崖之后,人的位置反而更清楚了
75.3% 到 4.8% 的断崖,撕开的其实不是模型的"遮羞布",而是我们过去两年对 AI 编程的测量幻觉。SWE-bench 们一直在测量"有人把问题嚼碎了喂到嘴边之后,模型咽得有多快",然后我们把这个分数误读成了"模型能独立干活的程度"。SWE-sweep 只是把那只一直托着模型的手拿开了——分数立刻现出原形。
这对 vibe coding 时代意味着什么?意味着"谁来发现问题"才是人的护城河,而不是"谁来写修复代码"。写修复这件事,模型已经很强了:有人给报告就是 75.3%,三个里面修好两个还多。但"注意到哪里不对劲"这件事,模型几乎交白卷。这恰好对应了真实开发中最值钱、也最难外包的那部分工作:读报错时的直觉、对"这段逻辑闻起来不对"的敏感、把用户一句含糊的"好像有点卡"翻译成可复现问题的能力。
第二个祛魅对象是"无人值守自动化修 bug"的叙事。如果你正计划让 agent 每天夜里自动扫一遍仓库、早上起来收 PR,请把这份榜单打印出来贴在显示器上:最强的配置、无人提示、7,230 美元一轮,修好率不到 5%。这不是"再等等模型会变强"的问题——在"发现"这个维度上,当前的 agent 范式(长轨迹探索 + 试错)本身就贵且低效。无人值守的 bug 猎人,在 2026 年 10 月这个时间点,是个伪命题。
对"75% vs 5%"还可以有第二层解读:bug 报告的本质,是人类一次性替 agent 干完了"发现"和"定位"两件事。一份好的报告里,"预期行为 vs 实际行为"定义了问题,"复现步骤"圈定了范围,剩下的才是"写个补丁让测试变绿"——而这正是模型最擅长的模式匹配。所以断崖的两端,测的几乎是两种不同的智能:5% 那一端考的是"在没有路标的大楼里找漏水点",75% 那一端考的是"有人指着漏水点,考你会不会修水管"。前者需要的是世界模型和主动探索,后者需要的是代码生成——恰好一个是模型的短板,一个是长板。这个拆分,比任何"AI 取代程序员"的时间表争论都更有信息量。
最后说句大实话:这个基准最扎心的不是分数,而是它重新定义了"编程能力"的构成。过去我们默认"会写代码 = 会编程",于是模型写代码越快,我们越焦虑。SWE-sweep 把编程拆成"发现问题"和"解决问题"两截之后,焦虑的指向变了——该焦虑的不是"我写代码没 AI 快",而是"我能不能比 AI 更早、更准地发现问题"。好消息是,这恰恰是经验、业务理解和用户同理心最值钱的地方,也是最难被基准测试量化的部分。护城河一直都在,只是我们之前量错了地方。
给独立开发者的三条实操结论
第一,永远给 agent 配一个"信号源",再让它干活。 榜单已经证明,agent 是优秀的修复执行器、糟糕的侦察兵。实操上就是:failing test、error trace、用户报告、崩溃日志——任何一个具体的信号,都能把 agent 从 4.8% 的地狱拉回 75% 的天堂。工作流设计上,"人负责定位到文件级、agent 负责修"依然是 2026 年性价比最高的姿势。
第二,把"写 bug 报告"当成核心竞争力练。 这听起来反直觉:AI 时代,最重要的技能之一居然是写 issue?但数据摆在那里——一份写清楚"预期行为是什么、实际行为是什么、怎么复现"的报告,能让同一个模型的产出差出 15 倍。会写报告的人,指挥 agent 的效率就是别人的十几倍。这对独立开发者是好消息:这项能力不花钱,只花心思。
第三,别为"自主发现"付高价。 如果你用 API 跑 agent 做代码审查或定时扫描,注意成本结构:xhigh 推理档位的单轮成本是 high 档的几十倍,分数提升却只有零点几个百分点。现阶段更划算的策略是:用便宜档位做广撒网式的可疑点标记(当 linter 用),真正的"这是不是 bug"的判断留给人。
第四,学 SWE-sweep 的 prompt:让 agent 动手前先跑测试基线。 官网 prompt 里最值得抄的一招,是强制 agent 开工先跑全量测试、记住"本来就红"的有哪些。这对 vibe coder 日常使用 agent 改代码同样适用:让它先建立"改之前的世界是什么样"的基线,改完 diff 一眼就能看出是修好了还是搞砸了。很多人用 agent 改代码翻车,根因都是没有基线——到底是它引入的回归,还是本来就坏的,扯不清。有了基线,agent 的每一次修改都可审计,这才是敢让它碰生产代码的前提。
诚实地说,这个基准也有它的边界
一篇合格的报道不该只转述官方的强项。SWE-sweep 自己也在 FAQ 里承认了两处边界,值得拎出来。第一,它本质上还是"历史衍生"基准:所有 bug 都来自人类已经发现、修复、合进主分支的 issue–PR 对。这意味着它测的是"人类能发现的那类 bug 里,agent 能发现多少"——那些人类自己都没发现的 bug,本来就不在分母里。用官方的话说,这类基准必然低估仓库里真实存在的 bug 数量。所以 4.7% 这个数字,乐观解读是"下限",悲观解读是"连人类已发现的子集都只搞定 4.7%",两种读法都成立。
第二,agent 被剥夺了互联网访问权,也不能看仓库之外的任何代码。现实中的开发者查 bug 会 Google、会翻 Stack Overflow、会看上游 changelog——这些"带外知识"在基准里算作弊,在现实里算基本功。所以 SWE-sweep 测的是"纯靠读仓库"的发现能力,是一个偏保守的、实验室条件的数字。把它理解成"自主发现能力的下限估计",比理解成"agent 真实水平"更准确。
但这并不削弱它的结论。恰恰相反:一个偏保守的测试都测出了 70 个百分点的断崖,说明"发现"这个短板不是测试条件苛刻造成的假象,而是真实存在的能力鸿沟。更值得期待的是后续:官网说公开投稿通道即将开放,还在评估更多模型(FAQ 里点名了 Astra、Fable、5.5 这些还没上榜的)。当各家新模型陆续跑上这个榜单,我们第一次有了一把量"发现能力"的尺子——以后再看到"我们的 agent 能自主修 bug"的宣传,先问一句:SWE-sweep 多少分?
日期口径与来源说明
透明起见,说明一下日期:swesweep.com 官网页面本身没有显式日期戳。本文采用的 2026-10-01 发布日期,依据三方交叉印证——官方仓库 facebookresearch/swe-sweep 的创建时间(2026-10-01T04:59:29Z,本文已亲自调用 GitHub API 核实);VibeLeaderboard 的情报页标注 "Published Oct 1, 2026,来源 swesweep.com";generativeai.pub 的深度解读确认"Meta researchers published on October 1"。三者一致。
一手来源:SWE-sweep 官网(含完整排行榜与评估细则)、facebookresearch/swe-sweep 仓库。排行榜数字与评估方法引自官网原文;75.3% vs 4.8% 的对照实验数据引自 generativeai.pub 的解读(同一批 20 个仓库上的对照)。
原始来源
相关文章
Google、Google DeepMind、马里兰大学、弗吉尼亚大学联合提出 RRSI:不锁死 agent 能改什么,而是正则化"它怎么搜索"。去掉正则化的进化把 evolve 分数推到 92.8,OOD 却只有 40.3;RRSI 以 90.5/43.6 实现更好迁移且 token 更少。一篇用数据说话的论文:自我改进本身也需要正则化。
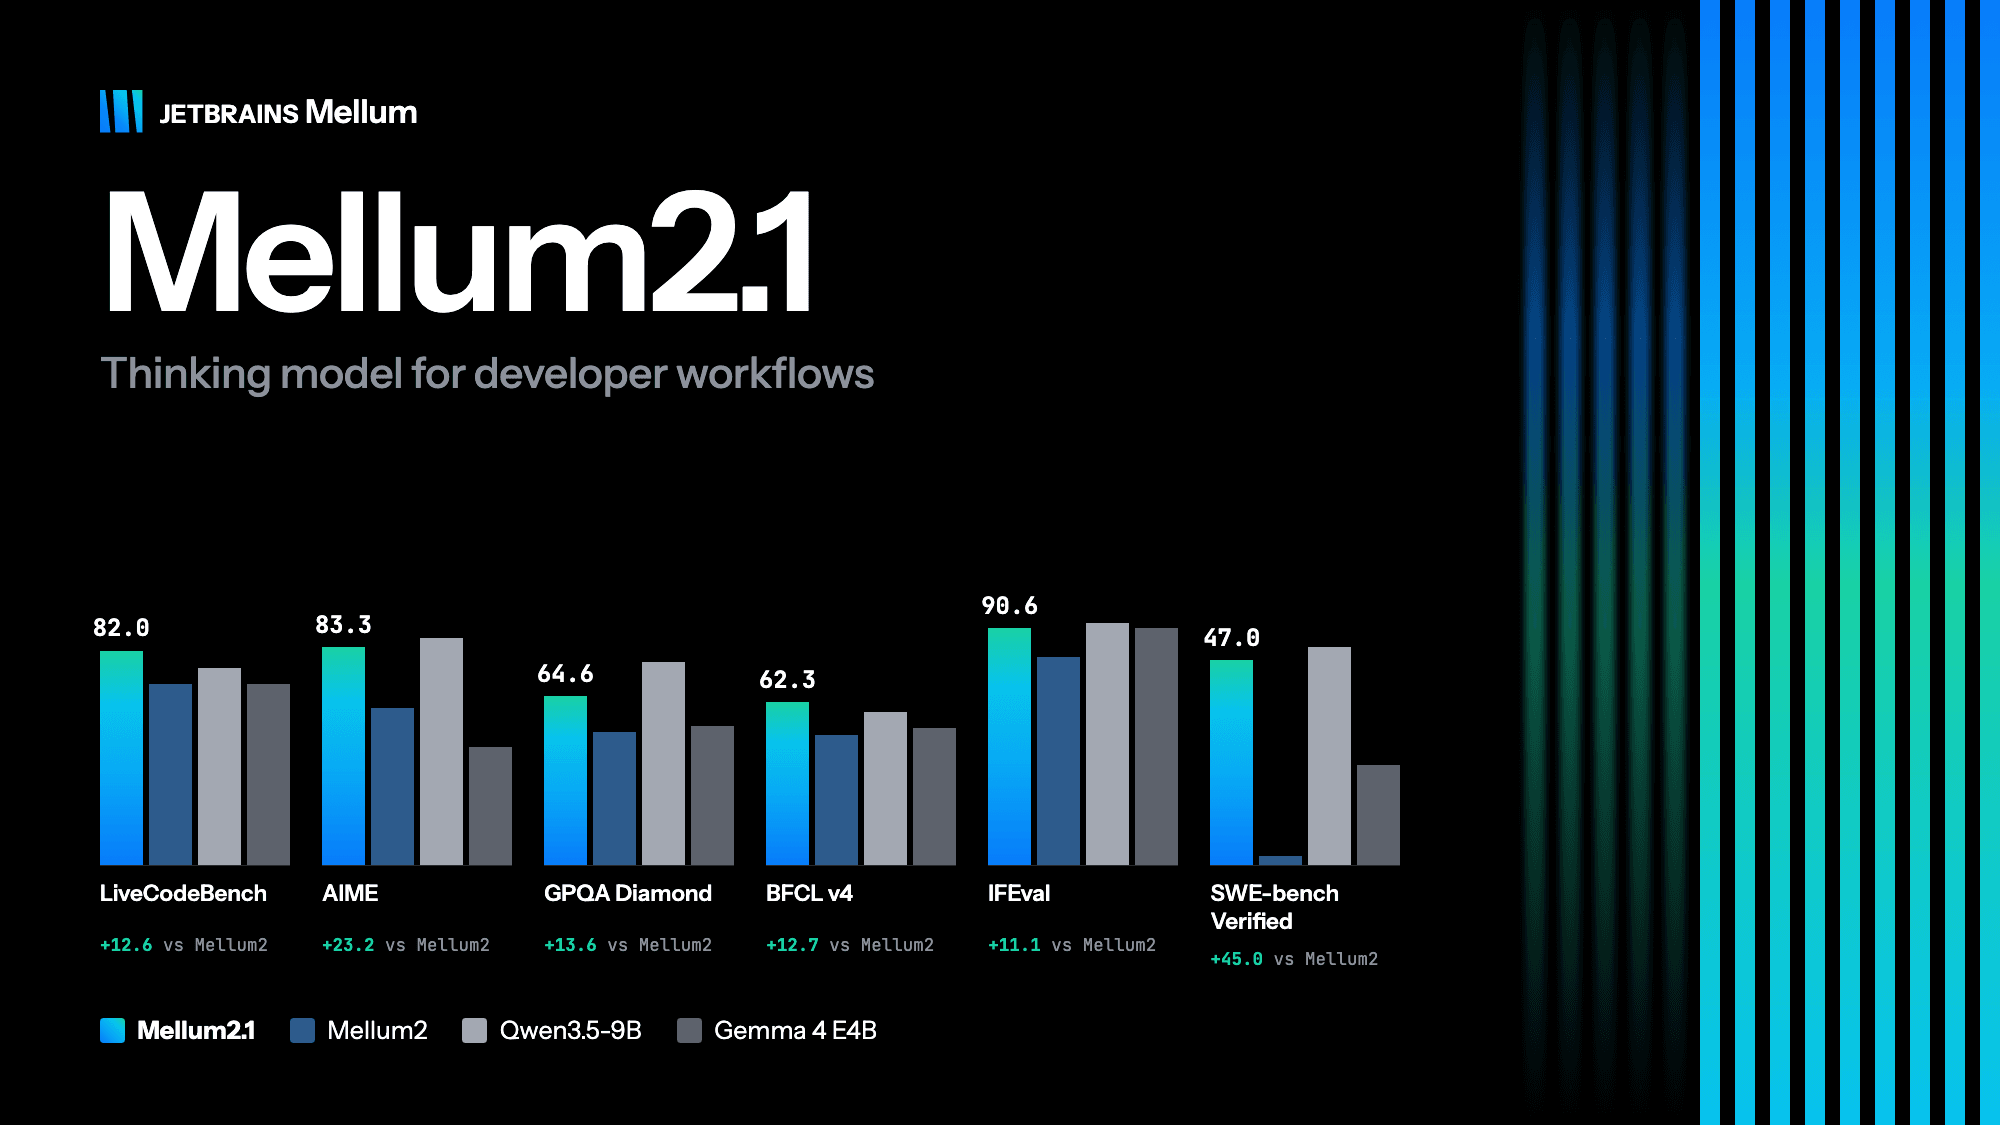
JetBrains 开源 Mellum 2.1:12B MoE 模型,每 token 仅激活 2.5B 参数。架构自 6 月以来原封不动,靠真实环境强化学习把 SWE-bench Verified 从 2.0 干到 47.0。Apache 2.0 协议、可自托管,定位是 coding agent 里便宜快速的执行层——写代码和调工具是强项,最硬核的 agent 任务仍落后 Qwen3.5-9B。
2026 年,调用 API 的不再只是人类开发者。这篇指南以 Stripe、GitHub 为正例、两个真实反模式为戒,拆解 Agent 友好 API 的五大支柱:契约先行、错误码规范、幂等键设计、分页契约与机器凭证,并附可直接落地的检查清单、OpenAPI 描述质量评分表与自测 prompt 模板。