自我改进本身也需要正则化:Google 等提出 RRSI,戳破 agent 自进化的过拟合泡沫
Google、Google DeepMind、马里兰大学、弗吉尼亚大学联合提出 RRSI:不锁死 agent 能改什么,而是正则化"它怎么搜索"。去掉正则化的进化把 evolve 分数推到 92.8,OOD 却只有 40.3;RRSI 以 90.5/43.6 实现更好迁移且 token 更少。一篇用数据说话的论文:自我改进本身也需要正则化。
Agent 圈最近最火的方向叫 RSI——Recursive Self-Improvement,递归式自我改进。思路很性感:不碰模型权重,让 agent 自己改"模型外面的自己":prompt 怎么写、工具怎么调、context 怎么管、失败了怎么爬起来,一轮一轮自我迭代,越变越强。
但 Google、Google DeepMind、马里兰大学、弗吉尼亚大学联合发表的一篇论文,给这场狂欢泼了一盆带着数据的冷水:你们看到的"越改越强",可能只是"越刷越熟"。论文提出的 RRSI(Regularized Recursive Self-Improvement,给 agent harness 的递归式自我改进施加正则化),核心论点一句话——自我改进本身,也需要被正则化。
日期口径先说清楚:机器之心对这项研究的报道发布于 2026 年 10 月 6 日(报道页面日期戳"新闻眼 10.06 08:03",明确标注来源机器之心,侦察员亲眼核实);论文本身挂在 arXiv,编号 2609.24972,即 2026 年 9 月。开源代码在 google-research/rrsi,项目主页 regularized-rsi.com。
RSI 为什么火:从"调模型"到"调 harness"
先讲清楚 RSI 火的背景。2026 年的 agent 开发有个公开的秘密:模型越来越强,但"模型之外的部分"才是拉开差距的地方。两个团队用同一个模型,一个 agent 好用得飞起,一个蠢得像砖头,差的不是模型,是 harness——prompt 工程、工具编排、记忆管理、错误恢复这些"模型外面的自己"。
RSI 的逻辑是:既然 harness 决定成败,那就让 agent 自己优化 harness。用同一批 evolve tasks 反复评估每次修改,好的留下,坏的扔掉,循环往复。听起来像进化算法+LLM 的结合,理论上应该越进化越强。过去半年,从学术界到独立开发者,无数人涌进了这个方向。
论文作者们先肯定了这个方向的价值,然后话锋一转:你们的评估方法,有个致命的结构性问题。
RSI 的前世今生:一个 30 年的老想法
RSI(递归式自我改进)不是 2026 年的新词,它是个有 30 多年历史的老想法——只是直到最近才从哲学变成工程。
这个概念最早可以追溯到 Jürgen Schmidhuber 在 1987 年的毕业论文:他设想了一个能改写自己代码的机器,每一次改写都让自己变得更聪明。后来 Eliezer Yudkowsky 在 2000 年代把它变成了 AI 安全讨论的核心概念——"智能爆炸":一个能自我改进的 AI,会进入越变越聪明的正反馈循环,最终远超人类。当时的讨论全是哲学和科幻,因为没人知道怎么实现"改写自己"。
转折点在 2023-2024 年。大模型的能力跨过了一个阈值:它们开始能写出"还不错"的代码,包括"改进自己的代码"。最早的雏形是各种"自我反思"(self-refine)技巧:让模型看自己的输出,挑毛病,重写,循环几次,质量确实提升。然后是 prompt 优化的自动化:DSPy 这类框架把"调 prompt"变成了可搜索的优化问题。
2025 年,RSI 从"调 prompt"进化到"调 harness"。标志性事件是几篇论文证明:让 LLM 自己改 agent 的工具调用策略、记忆管理逻辑,效果超过人类专家手工调优。也是从这时起,"evolve tasks + 循环评估"成了标准范式,RSI 从实验室走向了工程实践。
2026 年的 RRSI,是这个链条上的最新一环:当所有人都在做 RSI 时,有人停下来问"你们的评估靠谱吗"。这种"第二代问题"——不是问"能不能做",而是问"做得对不对"——往往标志着一个方向从狂热期进入成熟期。就像深度学习在 2015 年左右开始认真讨论过拟合和泛化,RSI 在 2026 年开始讨论正则化,说明它真的进入主流了。
这个历史视角给我们的启示是:RSI 不会是昙花一现。从 1987 年的设想到 2026 年的工程化,它走了 39 年。RRSI 不是给 RSI 泼冷水,而是给它铺路——让它从"看起来很美"变成"真的可靠"。
harness 到底是什么:拆给 vibe 开发者看
论文里反复出现的 "agent harness" 是个关键概念,但对很多 vibe 开发者来说可能有点抽象。拆开看,它就是"模型之外的所有东西",具体包括五层:
第一层:Prompt 层。系统提示词怎么写、 few-shot 示例怎么选、输出格式怎么约束。这是 harness 里最表层、也最容易改的一层,大部分"调 agent"其实都在调这一层。
第二层:工具层。agent 能调用哪些工具、工具的参数怎么设计、工具返回的错误怎么处理。工具设计的好坏,直接决定 agent 的能力上限——给 agent 一把钝刀,它再聪明也切不动肉。
第三层:Context/Memory 层。对话历史怎么压缩、长期记忆怎么存取、检索什么时候触发。这是 2026 年 agent 工程最卷的一层,各种记忆框架层出不穷。
第四层:控制流层。任务怎么分解、子任务怎么调度、失败了重试几次、什么时候该问人类。这是 harness 的"操作系统",决定了 agent 的行为模式。
第五层:评估与恢复层。怎么判断任务做完了、做错了怎么回滚、异常状态怎么恢复。这是论文里 screening 和 smoke test 所在的那层,也是最容易被忽视的一层。
RSI 的"自我改进",改的就是这五层。而 RRSI 的警告是:改得越多,过拟合的风险越大——因为每一层都有自己的"刷分"空间。Prompt 层可以背下 evolve tasks 的答案模式,工具层可以针对测试任务特化参数,记忆层可以记住测试集的 quirks。五层一起刷分,evolve score 能不好看吗?
对 vibe 开发者的实操建议是:给你的 harness 分层做"健康检查"。每隔一段时间,问自己五个问题:我的 prompt 里有没有针对特定任务的硬编码?我的工具参数是不是只在测试任务上调过?我的记忆里是不是存了一堆测试数据的特征?我的重试逻辑是不是在掩盖真实 bug?我的评估集上次更新是什么时候?如果答案让你心虚,说明你的 harness 可能已经在"刷分"了。
"越刷越熟":evolve score 的三宗罪
问题的核心在于:Harness Evolution 一轮又一轮地用"同一批 evolve tasks"评估修改。这在机器学习里有个经典名字——在验证集上反复调参,调出来的不是泛化能力,是对验证集的过拟合。论文把 RSI 场景下的过拟合拆成了三类:
第一宗罪:benchmark-specific fitting(只在特定 benchmark 上拟合)。agent 的修改越来越适配这批任务的 quirks,而不是变强了。就像学生把模拟卷的答案背下来,高考换套卷子就露馅。
第二宗罪:evaluation noise chasing(追逐评估噪声)。LLM 的输出有随机性,一次评估的涨分可能是运气。没有正则化的进化流程,会把"运气好"的修改当成"真变强"留下来,一轮一轮累积下来,harness 里塞满了玄学。
第三宗罪:complexity accumulation(复杂度堆积)。每次进化都倾向于"加东西"——多一个检查步骤、多一层重试、多一段 prompt。单个修改看都有道理,累积起来 harness 变成臃肿的怪物,维护成本爆炸,推理 token 翻倍,稍微换个场景就崩。
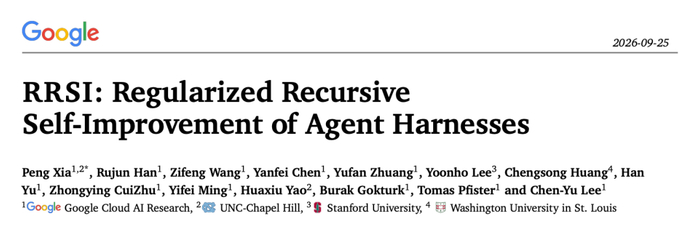
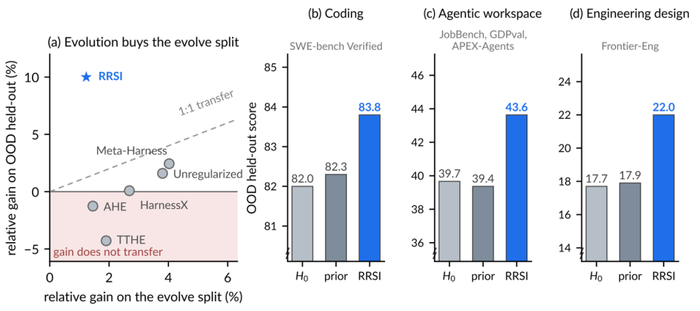
论文给出了一个反直觉但扎心的数据:在 Agentic Workspace 上,去掉正则化的 Unregularized Evolution 把 evolve score 推到了 92.8,高于 RRSI 的 90.5——进化分数更高。但一测 OOD(分布外任务,真正没见过的新任务),Unregularized 只有 40.3,RRSI 是 43.6。分数更高的那个,真实能力反而更差。这就是"越刷越熟"的数学形态:evolve score 涨的每一分,都在为 OOD 的崩盘添砖加瓦。
更扎心的是成本:每个 trial 的 Policy Token 消耗,Unregularized 是 3.80M,RRSI 是 2.42M。不加正则化的进化,不仅效果差,还更烧钱——因为它在追逐噪声的路上做了大量无用功。
RRSI 的方法:不锁死进化,只管住"怎么搜"
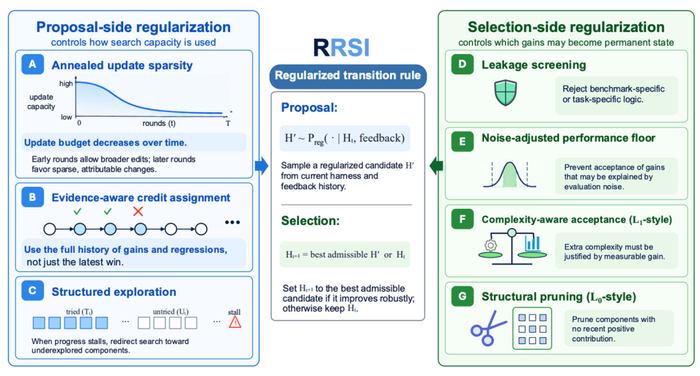
RRSI 的聪明之处在于它没有走极端。它没有说"别自我进化了",也没有说"锁死修改空间",而是说:进化可以继续,但"如何搜索"必须被正则化。
具体拆成两端。Proposal 端(决定尝试改什么):不是什么修改都值得试,提案本身要过筛选,避免天马行空的修改浪费评估预算。Selection 端(决定哪些修改有资格成为永久状态):不是涨分就留下,要过更严格的"永久化"标准,包括 smoke test 和 screening——论文披露,30 轮进化里真正被接受的 Candidate 只有 10 个:9 个涨分不够被拒,6 个 screening 没过,2 个没过 smoke test。
这个"10/30"的数字值得多看两眼。它意味着:在没有正则化的世界里,那 20 个被拒的修改里,有相当一部分是"看着涨分其实有害"的。如果照单全收,harness 会被这些"伪改进"慢慢带偏。RRSI 的本质,是给进化过程装了一个"质检员"——宁可错杀,不可放过。
用人话翻译:以前的 RSI 是"只要这次考试分数高,什么学习方法都保留";RRSI 是"分数高还不够,学习方法本身要经得起换套卷子考"。这个转变的哲学意味很浓:它把机器学习里最古老的智慧(正则化、交叉验证、奥卡姆剃刀)重新应用到了 agent 这个新物种上。
数据:跨三个域的验证
论文没有只在一个 benchmark 上自嗨,做了跨三个域的验证:
Coding 域:在 Terminal-Bench 2.1 上进化,SWE-bench Verified 从 82.0 提升到 83.8。注意这个细节——进化的场景和验证的场景是不同的 benchmark,这本身就是 OOD 思维的体现。
Agentic Workspace 域:JobBench 从 36.0 提升到 40.7,GDPval 从 48.8 提升到 52.3。
Engineering Design 域:Frontier-Eng 从 17.7 提升到 22.0。
OOD 最高提升 +4.7 个点。数字不算夸张,但方向一致——三个域全部正向。这比"某个 benchmark 暴涨 20 个点"可信得多,因为后者往往就是过拟合本合。
当然,局限也要如实写:OOD 验证局限在 8 个 benchmark 上。8 个 benchmark 的"分布外",和真实工程任务的"分布外",中间还隔着一道鸿沟。真实任务有模糊的需求、屎山代码、跨团队扯皮,这些都不是 benchmark 能模拟的。论文的方法论贡献是 solid 的,但"能否推广到真实工程任务"还要打个问号——作者自己也没宣称解决了这个问题。
如果 RRSI 是对的,agent 基础设施会变成什么样
做个思想实验:如果 RRSI 的核心论点被广泛接受——"自我改进需要正则化"——agent 基础设施会变成什么样?
评估基础设施会成为一门独立生意。今天的 agent 评估是"跑几个 benchmark 看分数",RRSI 之后,评估要回答三个问题:evolve 分数多少、OOD 分数多少、两者差距多大(gap 越大过拟合越严重)。已经有创业公司在做"agent 评估即服务",RRSI 给了它们新的卖点:不只告诉你分数,还告诉你"你的进化是不是在刷分"。
再看 harness 版本管理——它会变得像代码版本管理一样重要。论文里 30 轮进化只接受 10 个 candidate,这个"接受/拒绝"的决策记录,本身就是宝贵的资产。未来的 agent 平台可能会内置"harness git":每次进化是一个 commit,附带 evolve 分数、OOD 分数、token 消耗,随时可回滚。我们之前报道过 vibe 项目的 Prompt 版本管理(cycle12),RRSI 把这个需求从 prompt 扩展到了整个 harness。
第三,"进化预算"会成为 agent 运维的新指标。论文披露 Unregularized 每个 trial 烧 3.80M token,RRSI 只用 2.42M——正则化省了 36% 的 token。当 agent 开始 7×24 小时自我进化,token 预算就是真金白银。CIO 们会问:你的 agent 每月花多少 token 在"自我改进"上?改进的 ROI 是多少?RRSI 这类方法,从"效果更好"变成"更省钱",商业落地的阻力会小很多。
最后,也是最深远的:RRSI 暗示了"agent 对齐"的一条新路。今天的 AI 安全讨论,大部分在模型层面(RLHF、宪法 AI)。但未来的 agent 对齐,可能更多在 harness 层面:一个不受约束自我进化的 agent,和一个"进化过程被正则化"的 agent,哪个更可控?RRSI 的 Proposal/Selection 机制,本质上是给 agent 的自我改变加了"刹车片"。这个思路如果推广开,agent 安全会从"管模型"变成"管进化过程"。
当然,这些都是推演。RRSI 只是一篇论文,8 个 benchmark 的验证还很初步。但好论文的价值从来不只是数据,而是它提出的问题。这篇论文提出的问题——"你的 agent 真的在变强,还是只是在刷题?"——值得每个做 agent 的人放在桌上,时不时看一眼。
争议:这篇论文在挑战谁
RRSI 真正的火药味不在数据,而在它的方法论挑战。它挑战的是当前 agent 工程实践里两个根深蒂固的假设。
第一个假设:"训练/进化分数越高越好"。这是从深度学习时代继承来的直觉,但在 RSI 场景下,论文用 92.8 vs 90.5 的反转证明:分数更高可能恰恰意味着过拟合更严重。如果这个结论成立,大批 agent 团队的评估体系都要重写——你不能再盯着 evolve curve 往上走就开香槟,得同时看 OOD 曲线。
第二个假设:"agent 越自主越好"。RSI 的浪漫想象是 agent 完全自主进化,不需要人类插手。但 RRSI 的 Proposal/Selection 机制,本质上是把人类的先验知识(什么修改值得试、什么标准算过关)编码成了正则化项。完全自主的进化是低效的,带约束的进化才是高效的——这和人类教育小孩的道理一样:完全放养不如有纪律的自主。
也有反对的声音。一种观点认为:RRSI 的正则化本质上是"用 8 个 benchmark 的 OOD 来防过拟合",但这 8 个 benchmark 本身也可能被未来的进化过程拟合——这是"元过拟合"问题,正则化只是把过拟合推后了一层,没有消灭它。这个批评有道理,但论文的回应也很实在:推后一层也是进步,完美的泛化本来就不存在。
另一种更务实的质疑来自工程界:30 轮进化只接受 10 个 candidate,这个"质检"成本谁来付?每次 screening 和 smoke test 都要烧 token、跑评估。对独立开发者来说,RRSI 的流程可能太重了——你没有 Google 的算力。对这种质疑,论文没有直接回答,但它开源了代码(google-research/rrsi),等于把"重不重"的判断权交给了社区。
对 vibe/Agent 开发者的启示:harness 才是下个战场
最后说说这篇论文对我们读者的实操意义。三个判断:
第一,harness 是下个战场,模型是上个战场。2026 年大家的模型差距在缩小(GPT-6、Claude、Gemini、开源模型在多数任务上已经难分伯仲),真正的差异化在 harness。RSI/RRSI 这类"自动化优化 harness"的方法,长期看会变成标配——就像当年的超参数搜索一样,从黑科技变成基础设施。
第二,给你的 agent 加"进化纪律"。即使你不用 RRSI 的完整流程,它的核心思想可以直接借用:评估修改时,留出一批"进化时绝对不看"的 held-out 任务;任何修改要进主分支,必须过 smoke test;定期清理 harness 里"不知道为什么存在"的逻辑。这三条是零成本的,今晚就能做。
第三,警惕"分数幻觉"。如果你在调 agent 的 prompt 或工作流,记住 92.8 vs 40.3 的教训:在你调参的那批任务上分数涨了,不等于变强了。养成习惯:每次"优化"完,找几个完全没见过的任务测一下。涨分但 OOD 跌了,就是过拟合,回滚。
一句话总结:RRSI 的价值不在于它提出的某个具体算法,而在于它把一句老话重新钉在了 agent 时代的墙上——"没有免费的午餐,自我改进也不例外"。进化需要纪律,纪律需要正则化。下次当你看到某个 agent 宣称"自我进化了 100 轮,分数涨了 30%"时,先问一句:OOD 测了吗?
(日期口径重申:机器之心报道发布于 2026 年 10 月 6 日,页面日期戳亲眼核实;论文 arXiv 编号 2609.24972 为 2026 年 9 月。代码与项目主页链接见正文。)
原始来源
相关文章
Meta 发布 SWE-sweep 基准:100 个仓库、22 种语言、4068 个真实 bug,agent 得自己发现 bug 在哪。最强配置有人写报告时修 75.3%,无人提示只修 4.8%。70 个百分点的断崖说明:vibe coding 时代,“发现问题”才是人的护城河。
微软 10 月 7 日发布"混合智能"战略:Microsoft Execution Containers 在 Windows 11 GA,策略在 agent 控制之外强制执行;MAI-Code-1.1-Flash(137B/6.8B)经 3-bit 量化下放端侧;GitHub HydraFusion 路由器延伸到 Windows,按任务在本地与云端模型间路由。本文拆解三件套、成本争议与对独立开发者的实际意义。
2026 年,调用 API 的不再只是人类开发者。这篇指南以 Stripe、GitHub 为正例、两个真实反模式为戒,拆解 Agent 友好 API 的五大支柱:契约先行、错误码规范、幂等键设计、分页契约与机器凭证,并附可直接落地的检查清单、OpenAPI 描述质量评分表与自测 prompt 模板。