一行配置换掉 CUDA?亚马逊 TorchNeuron 让 PyTorch 直跑 Trainium,还开源
亚马逊 Annapurna Labs 开源 TorchNeuron:PyTorch 代码只需改一行配置、无需重写,即可跑在 Trainium AI 芯片上。CUDA 的护城河从来不在硅片里,而在软件生态——亚马逊是第一个真正对"迁移成本"这堵墙动手的挑战者。
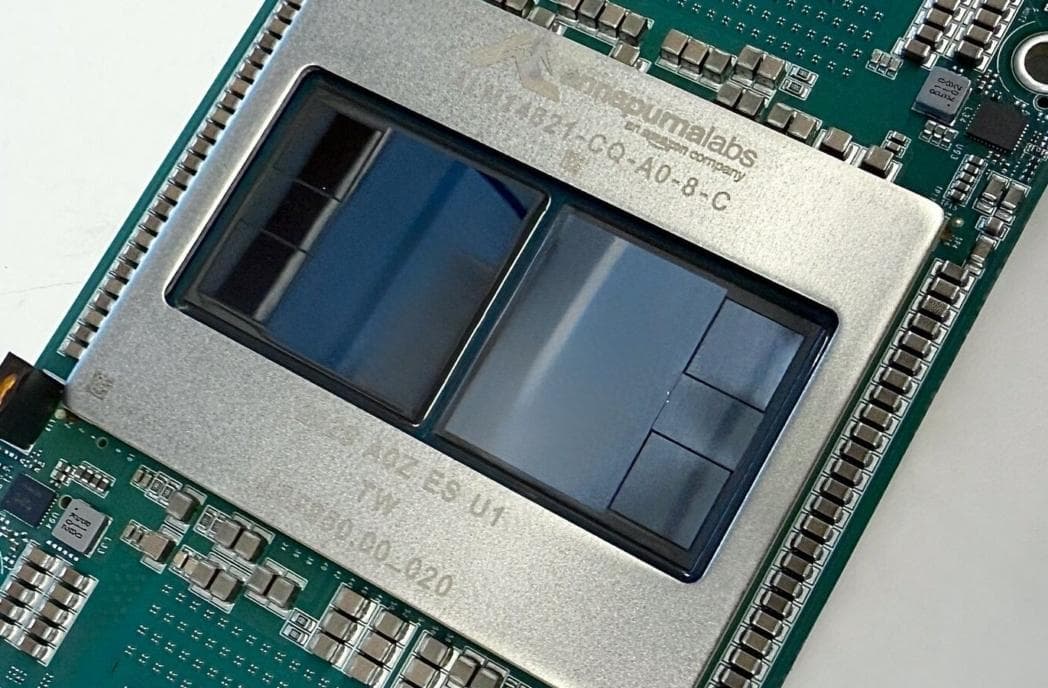
路透社 10 月 19 日从旧金山发出的一篇报道,把 AI 芯片战争推到了一个新的战场。亚马逊旗下芯片部门 Annapurna Labs 宣布推出 TorchNeuron:一款让 PyTorch 代码无需改写、只改一行配置就能跑在亚马逊 Trainium AI 芯片上的软件——并且,它将作为免费开源软件公开发布。路透社的导语把意图写得很直白:
Amazon.com is introducing a new tool that allows its custom AI chips to run code written in the most popular AI coding language without modification, seeking to erode the advantage that underpins Nvidia's dominance in the AI computing market.
翻译成大白话:亚马逊要拆的,是英伟达统治 AI 算力市场的根基。而它选的拆法,出乎了很多人的意料——不拼芯片参数,拼"你的代码不用改"。
这件事值得单独写一篇,不是因为"又一家云厂商发了 AI 芯片",而是因为亚马逊第一次把竞争打到了正确的地方。过去所有挑战 CUDA 的尝试,几乎都在比拼芯片本身:FLOPS、内存带宽、能效比。亚马逊这次换了个打法:你的 PyTorch 代码已经写好了,我让你一行不改就能跑。护城河不在硅片里,在软件生态里——亚马逊是第一个真正对"迁移成本"这堵墙动手的人。
事件本身:三句话讲清
根据路透社记者 Stephen Nellis 的报道(标注 "By Stephen Nellis"、"SAN FRANCISCO, Oct 19 (Reuters)"、发布时间 "2026-10-19T13:03:40+00:00"),核心事实有三层:
第一,代码零改写。用 Annapurna Labs 自己的话说:
TorchNeuron lets developers run code written in a language called PyTorch on Amazon's Trainium AI chips with a single configuration change and no rewriting needed, according to Amazon's Annapurna Labs chip unit.
注意措辞:"a single configuration change"(一行配置变更)、"no rewriting needed"(无需重写)。在 AI 基础设施的世界里,"把 CUDA 代码迁到另一家芯片" historically 意味着数周到数月的重写和调优。TorchNeuron 把这个成本压缩到了改配置的级别。
第二,免费开源。亚马逊计划在周一(10 月 19 日)于硅谷的一场开发者大会上正式发布这款软件,并表示:
Amazon, which plans to announce the software at a developer conference in Silicon Valley on Monday, said the software will be publicly released as a free and open-source offering.
开源是整件事里最值得玩味的决定,我们后面单独展开。
第三,已经有 30 多家早期客户在用。Annapurna Labs 软件副总裁 Colin Brace 在接受路透社采访时说:
"This has been about meeting customers where they're at," he told Reuters in an interview.
他还透露,超过 30 家早期客户——覆盖机器人、世界模型和语音 AI 领域——已经在用这款新软件,并且切换到亚马逊芯片能带来大幅的成本节约:
Brace said more than 30 early customers — spanning robotics, world models and voice AI — are using the new software, and that the switch to Amazon's chips can result in steep cost savings.
"Meeting customers where they're at"(去到客户所在的地方,而不是让客户来迁就你)——这句话几乎就是整次发布的战略摘要。

为什么这次不一样:护城河从来不在芯片里
先说一个判断:英伟达的护城河,从来不是"芯片更快"。过去十年里,纸面参数超过英伟达的 AI 芯片出现过不止一款,它们都死了。真正的护城河是 CUDA 生态——cuDNN、cuBLAS、NCCL,以及围绕它们生长出来的整个工具链、教程、Stack Overflow 回答和工程师的肌肉记忆。一个 ML 工程师的 PyTorch 代码天然就是"CUDA 形状"的:他调的每一个算子、遇到的每一个坑、抄的每一份代码,默认都是为英伟达硬件写的。
这意味着,挑战者的真正敌人不是英伟达的下一代 GPU,而是迁移成本。一家公司要把训练管线从 NVIDIA 迁走,付出的不只是新硬件的钱,还有工程师数周的重写、调优、踩坑,以及"万一出问题没人可问"的风险。这笔账一算,大多数团队的选择都是:继续买英伟达。
亚马逊这次的打法,是直接对这笔账下手。"Single configuration change" 的潜台词是:迁移的工程成本从"几个人月"降到了"改一行配置"。当迁移成本趋近于零,客户做决策时剩下的变量就只剩两个:价格和性能。而这两样,恰恰是亚马逊作为云厂商最有底气谈的——Trainium 本来就是为了在 AWS 内部替代英伟达 GPU、压低算力成本而生的。
对比一下之前的挑战者:大家都在卷"我的芯片比 H100 快 x%",但客户听完的反应是"那我的代码怎么办"。亚马逊是第一个把发布会开在"你的代码不用动"上的人。这不是技术路线的差异,是对"护城河到底在哪"这个问题的不同回答——而亚马逊的回答是对的。
开源这步棋:开放软件,封闭硬件
TorchNeuron 开源,是整件事里最精明的一步,但也需要冷静地看。
先说精明的一面。AI 基础设施软件的采纳逻辑是:没人会把生产管线押宝在一个黑盒上。开源意味着客户可以自己看、自己改、自己修 bug,出了问题不用等亚马逊的 support ticket。更重要的是,开源把"试用门槛"降到了零——一个工程师周末花两小时就能验证"我的模型能不能跑",这种低摩擦的试用,是任何销售团队都买不来的获客渠道。CUDA 当年也是这么起来的:先让学生和研究员免费用,生态自然就长出来了。
再说需要冷静的一面:软件开源了,硬件没开源。Trainium 芯片只能跑在 AWS 云上,你不可能买一块 Trainium 插到自己的服务器里。所以这是一个"开放软件 + 封闭硬件"的组合:迁移成本这堵墙拆了,但你在墙的另一边看到的是 AWS 的围墙。锁定没有消失,只是从"软件生态层"移到了"云厂商层"。对客户来说,这依然是一笔好交易(如果价格真的更便宜),但别把它理解成"去中心化"或"开放计算"——它是一次精心计算的、云厂商之间的客户争夺战。
还有一个值得追问的数字:Brace 说的 "steep cost savings"(大幅成本节约),具体是多少?报道里没有给数字。这是官方口径里常见的留白——"大幅"是一个形容词,不是 benchmark。在亚马逊公布具体的性价比数据(比如每美元的训练吞吐)之前,把这句话当作方向性信号,而不是采购依据。
对 vibe 开发者的意义:算力成本终于可能松动了
如果你是独立开发者或一人团队,这件事和你的关系比看起来更直接。
第一,推理和微调的成本可能下降。Trainium 的定位一直是"更便宜的 AI 算力"。如果 TorchNeuron 真的让迁移变成改配置,AWS 上的 Trainium 实例就成了一个随时可切的更便宜选项。对跑长期推理服务、做模型微调的一人团队来说,算力是按小时烧钱的,30% 的成本差直接就是利润差。当然,前提是"一行配置"在你的模型上真的成立——建议先用非关键 workload 试跑,别直接把生产流量切过去。
第二,"CUDA 形状"的代码正在贬值。过去,"会写 CUDA 优化"是 ML 工程师的护城河技能之一。如果 PyTorch 代码可以在不同后端之间无摩擦迁移,硬件特定的优化知识的价值会下降,而"模型本身"和"数据管线"的价值会上升。对 vibe 开发者这是好事:你不需要成为 CUDA 专家,也能吃到算力竞争的红利。
第三,关注"without modification"的边界。这是我最想提醒的一句。"无需改写"是发布话术,工程现实通常是:主流算子覆盖得很好,长尾的自定义算子、特殊的分布式训练配置,可能还是要动手。Brace 说的 30 多家早期客户覆盖的是机器人、世界模型、语音 AI——这些都是相对标准的 workload。你的 workload 越特殊,越要自己验证。开源在这里反而是好事:你可以自己去看代码,看到底支持了什么、没支持什么,而不是信发布会。
发布会之后看什么:三个验证点
新闻看到这里,接下来值得盯的不是发布会本身,而是三个可验证的信号:
- 开源仓库的真实热度。软件发布后,去看它的开源仓库:star 数、issue 的响应速度、外部贡献者多不多。一个"为了发布而开源"的项目和"真心做生态"的项目,在仓库活跃度上是藏不住的。如果三个月后仓库里只有亚马逊员工在提交,那就说明"开源"更多是营销话术。
- 第三方实测。等独立团队(比如 SemiAnalysis 这类机构,或者 Hugging Face 社区)拿标准模型在 Trainium 上跑出实测数据:同样的模型,迁移到底改了几行?吞吐和成本对比 NVIDIA 实例差多少?官方的 "steep cost savings" 只有在第三方数据里才能变成数字。
- AWS 定价页面的变化。最诚实的信号永远是价格。如果 AWS 随后下调 Trainium 实例的价格,或者推出更激进的预留实例折扣,那就说明亚马逊是真想靠价格抢份额——而价格战,是所有"拆墙"故事里对开发者最有利的结局。
这三个信号都不需要你信任何人的话,它们自己会说话。VibeFix 会继续跟进。
划界:一句提,微软 Maia 300 是另一件事
为免混淆,提一句划界:本月早些时候我们报道过微软的 Maia 300(自研 AI 芯片),那是另一家厂商、另一个产品、另一次发布,和这次亚马逊 TorchNeuron 开源没有直接关联。两件事放在一起看,倒是能读出一个共同趋势:云厂商正在从"买英伟达"转向"自己造 + 抢生态",而抢生态的手段,正从拼硬件参数变成拼开发者体验。
冷静清单:发布会没说的话
最后,把需要打折扣的部分列出来,免得这篇写成亚马逊的通稿:
- "一行配置"是最好情况。真实世界的迁移总有长尾:自定义算子、混合精度策略、分布式训练的拓扑假设。TorchNeuron 覆盖得越好,这个数字越接近真实;但在你自己的模型上验证之前,把它当作"迁移成本大幅降低",而不是"迁移成本为零"。
- 30 多家早期客户是官方挑选的数字。早期客户计划(early access)的参与者,本来就是被筛选过的、workload 适配度高的客户。等全面开放后,长尾客户的体验才是试金石。
- 成本节约没有给数字。"Steep" 是形容词。在看到第三方实测的性价比数据之前,采购决策先别做。
- 硬件锁定还在。软件开源不等于你可以把 Trainium 搬出 AWS。这是一次云厂商之间的竞争,不是开放计算的胜利——但这不妨碍它对你有利:竞争越激烈,你的算力账单越便宜。
一句话总结:亚马逊这次没有发布一款"更快的芯片",而是发布了一次"更便宜的迁移"。CUDA 的护城河是生态,拆生态的办法不是造更快的芯片,而是让开发者的代码一行不改就能走。TorchNeuron 开源,是云厂商第一次真正对开发者体验下手来拆这堵墙。对 vibe 开发者来说,checklist 只有三条:去看开源代码确认你的算子在不在支持列表;用非关键 workload 先试跑;然后等着看英伟达和 AWS 的下一轮出价——神仙打架,用户得利。
评论 (0)
原始来源
相关文章
IBM 在 Hugging Face 官方博客开源 Granite Switch 4.1:冻结基座加 aLoRA 适配器热插拔,聊天、通用决策、安全审查、语音转写四个能力装进同一个模型、同一个端点,显存约等于基座一人,KV cache 全链路复用。对本地 agent 开发者:一个模型顶四个场景,判断从一段 prompt 升级成了一个零件。
vibe 项目最常见的开源姿势是裸奔式 push:没许可证、没 CONTRIBUTING、issue 区三个月没人理。本文给一条从私有仓库到健康开源项目的完整跑道:许可证选型决策表、开源前代码体检(含可运行的密钥扫描脚本)、社区文件四件套写法、发布日 SOP、首月治理纪律,以及开源前 15 项验收检查。
Fragment 完成 1200 万美元 A 轮融资,Firstmark 领投:为 vertical AI 公司提供账单、支付与会计的“金融基础设施”,强制财务正确性——agent 幻觉与无效交易“不可能”发生。agent 经济真正的瓶颈从来不是“它会不会花钱”,而是“它算错账谁负责”。