加拿大四大新闻集团起诉 Anthropic:训练侵权 + 绕付费墙,版权战双线开火
10 月 6 日诉状递交安大略高等法院、10 月 19 日加通社确认:Postmedia、Torstar、《环球邮报》、加通社联手起诉 Anthropic,指控 Claude 训练侵权、ClaudeBot 无视网站条款、绕过付费墙持续抓取,索赔或达数十亿美元。本文详解四项诉由,对照 NYT 诉微软/OpenAI 与 15 亿美元 Bartz 和解案的最新进展,并给出 vibe 开发者爬虫与 RAG 合规的四条红线。
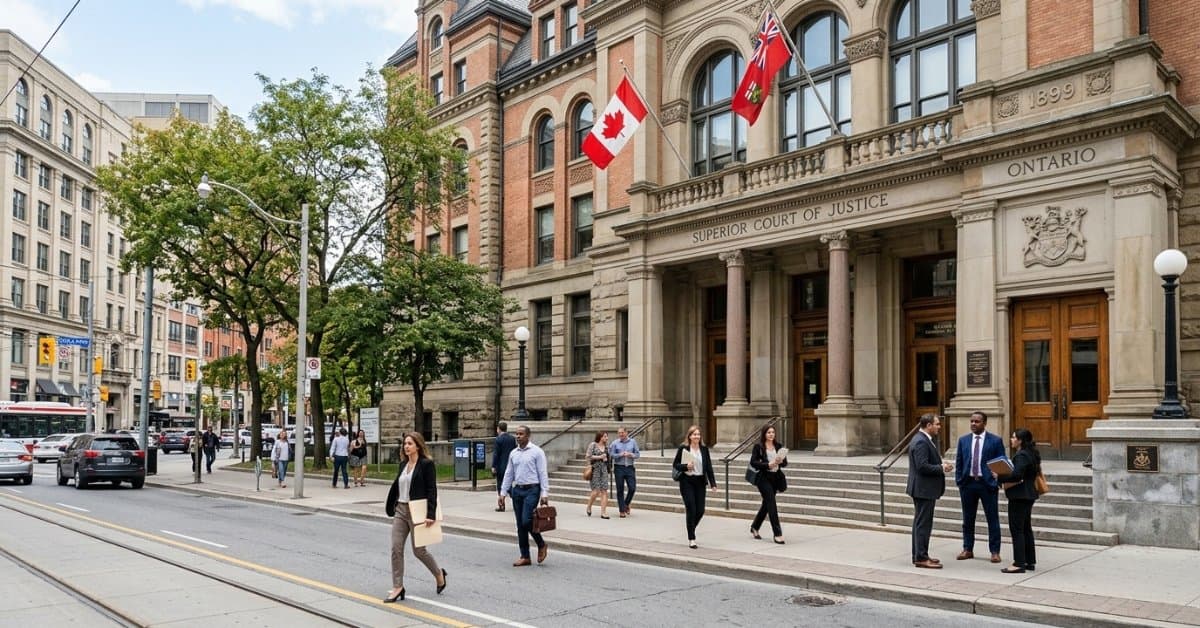
先把时间线说清楚,因为这起案子有两个日期:2026 年 10 月 6 日,诉状递交到安大略高等法院(Ontario Superior Court of Justice),由加拿大媒体行业刊物 Cartt.ca 首家披露;10 月 19 日,加拿大通讯社(The Canadian Press)出面确认案情,Global News、路透社跟进报道,事件才真正进入公众视野。两个日期都属实,一个是"立案日",一个是"引爆日"——写清楚这个,是因为这起诉讼的新闻价值恰恰藏在这两周的时差里:诉状在法院躺了十三天,Anthropic 没有回应,没有和解传闻,出版商选择让子弹飞一会儿,再让全国最大的通讯社把事情挑明。
"A group of Canada's largest publishers are suing AI company Anthropic in the Ontario court. The publishers, which include Postmedia, Torstar, The Globe and Mail, and the Canadian Press, claim that Anthropic infringed on their copyright by using their content to develop Claude. The lawsuit was filed on Oct. 6, and initially reported by Cartt."
被告是 Anthropic 及其加拿大子公司。这是第一起针对 Anthropic 的新闻出版商集体诉讼——注意这个"第一":OpenAI 已经被各国出版商告了一圈,Anthropic 之前挨的版权官司主要来自图书作者(Bartz 案,15 亿美元和解,今年 7 月刚终审批准),新闻业这还是头一回把 Claude 送上被告席。
原告是谁:基本上就是"加拿大新闻业"本身
四个原告不需要太多介绍,但值得把它们的分量摆出来,因为这决定了这起诉讼和以往"某作家告某公司"的根本区别:
- Postmedia:加拿大最大的报业集团,旗下有《国家邮报》(National Post)等一众大报;
- Torstar:《多伦多星报》(Toronto Star)母公司,加拿大发行量最大的日报集团之一(诉状中还列了 Metroland Media 等关联实体);
- The Globe and Mail:《环球邮报》,加拿大全国性大报的标杆;
- The Canadian Press:加通社,加拿大国家通讯社,全国媒体的内容供血者。
换句话说,原告名单基本就是加拿大严肃新闻业的全家福,四家加起来覆盖了加拿大英语新闻市场的半壁江山。诉状里还点名了 Metroland Media、Postmedia Network、PNI Maritimes LP 等关联公司。Broadcast Dialogue 的报道提到,原告方索赔金额可能达到数十亿美元级别。诉状里有一句相当不客气的话:
"Anthropic has capitalized on the commercial success of its AI models, building an expansive suite of services, and raised significant capital — all without obtaining a valid licence from any of the News Media Companies," says the statement of claim.
翻译一下就是:你们靠我们的稿子把公司做到了近万亿美元估值,一分钱许可费没付过。诉状还特意点出,截至今年 5 月 Anthropic 已融资约 1250 亿美元、估值超过 9650 亿美元,Claude 每天新增用户超百万——这些数字出现在诉状里不是炫富,是为"不当得利"和损害赔偿做铺垫。
四项指控:版权只是第一条,真正狠的是后三条
很多中文报道把这案子简化成"训练数据侵权",这低估了出版商律师的火力。诉状列了四项诉由,一条比一条贴着 Anthropic 的业务命门:
第一,版权侵权。指控 Anthropic 未经授权复制原告的新闻作品,用于开发和运行 Claude,违反加拿大《版权法》。这是基本盘,没什么可多说的。
第二,违约。诉状指控 Anthropic 的自动爬虫(点名了 ClaudeBot)无视原告网站的使用条款——那些条款明确把内容限定为个人使用,禁止商业抓取。这一条的杀伤力在于:它把"爬虫不守规矩"从技术伦理问题变成了合同问题。ToS 是你点"同意"才生效的吗?爬虫可没点过。但出版商的逻辑是:网站 ToS 是公开的法律声明,绕过它就是违约。
第三,绕过技术保护措施(TPM)。这是整份诉状里最有时代特征的一条:
"The claim indicates that Anthropic breached and circumvented the protection measures put in place to prevent copying of their content. Additionally, it says that Anthropic accesses and copies a lot of text data from the internet and the Plaintiff's websites."
保护措施具体指什么?付费墙(paywall)、登录验证、网络层防护。诉状的说法是 Anthropic 不仅爬公开页面,还绕过了这些"防复制"的技术门槛。注意,这和"训练时爬了多少"已经是两个层面的事:绕过 TPM 在很多法域是独立诉由,加拿大《版权法》有专门条款,美国 DMCA 1201 条同理。出版商等于在说:你们不是"不小心"爬到的,是"撬门"进来的。
第四,不当得利。"Anthropic has been substantially and unjustly enriched to the detriment of the News Media Companies"——你们靠我们的内容赚了大钱,我们受了损,钱得吐出来。这是为巨额赔偿准备的法律钩子。
还有一条藏在诉状细节里的指控值得单独拎出来:Claude 会逐字、改写或总结复述原告的报道来回答用户,直接把读者截留在对话里——不去原网站、不看广告、不订订阅。出版商把"输出替代"写进了诉状,这等于把"AI 搜索正在杀死新闻业商业模式"的行业焦虑,正式变成了法庭上的损害论证。
为什么这次不一样:Agent 时代的"持续抓取"
如果只看"训练数据没付钱",这案子和 2023 年《纽约时报》诉 OpenAI 没本质区别。但诉状里有一句话,把战场推到了 agent 时代:
"Further, the lawsuit indicates that Anthropic scrapes content on an ongoing basis because of ongoing user prompts."
因为用户的持续提问,Anthropic 在持续地抓取内容。这句话的信息量很大:它指控的不是"三年前训练时爬了一次",而是 Claude 在日常服务中——为了回答用户此刻的问题——仍在实时抓取出版商的网站。这是对"检索增强 / 联网搜索 / agent 浏览"这一整套当下主流架构的直接点名。
对 vibe 开发者来说,这句话值得多读三遍。过去讨论 AI 版权,焦点一直在"训练"这个一次性动作上;现在出版商把" serving 时的抓取"也钉在了诉状里。你的 agent 每天替用户去爬几十个网站做总结、做比价、做舆情监控——在出版商的律师眼里,这和 Claude 干的事没有本质区别,只是规模不同。

对照组:NYT 案打到哪了,Anthropic 自己屁股上还有什么案子
把这起新案子放进 AI 版权诉讼的全景里看,几个坐标必须标出来:
坐标一:同一批原告,2024 年 11 月已经告过 OpenAI。除了这次的四家,当时还有 CBC/Radio-Canada 联手,在安大略高等法院起诉 OpenAI,索赔标准是每篇文章 2 万加元。Mobilesyrup 的报道里有一句很关键:
"The allegations have yet to be proven in court. The same publishers and CBC launched a lawsuit against OpenAI in 2024, which has also not been settled."
两年过去,那案子还没和解、没判决。这意味着什么?意味着加拿大法院对"AI 训练是否侵权"还没有给出过任何实质性答案。这次告 Anthropic,原告等于开了第二战场——用两份诉状、两个被告,给法院施加"必须表态"的压力。
坐标二:《纽约时报》诉微软 / OpenAI,打到了简易判决阶段。这是全球 AI 版权案的"主战场":2023 年 12 月起诉,现在合并为纽约南区联邦法院的 MDL 案件(No. 1:25-md-03143)。就在本月——2026 年 10 月 16 日,出版商原告提交了 92 页的简易判决动议书(删节公开版),指控相当劲爆:微软 2019–2022 年间以"Project Taxi"为代号把 Bing 索引拷贝卖给 OpenAI,又以"Project Mango"为代号替 OpenAI 运行秘密爬虫;OpenAI 研究员曾告诉联合创始人"有个绕过纽约时报付费墙的 hack";OpenAI 的文本提取器抹掉了 99% 以上涉案文章的版权声明。另一边,美国司法部今年 9 月出手,站到了 OpenAI 和微软一边,主张训练在适当情形下可构成合理使用——连版权局和专利商标局都被这个表态打了个措手不及。案子还没判,但双方的底牌已经翻得差不多了:出版商打"你们明知故犯",AI 公司打"这是合理使用"。
坐标三:Anthropic 自己的 Bartz 案,15 亿美元,刚赔完。今年 7 月 20 日,加州北区联邦法院最终批准了 Anthropic 与图书作者的 15 亿美元和解——美国版权史上最大的一笔。91.3% 的涉案作品被认领,每部作品约赔 3000 美元。但注意和解的边界:它只覆盖 2025 年 8 月 25 日之前的盗版书库训练行为,不包括模型输出侵权和未来的行为。而且 Alsup 法官 2025 年 6 月的裁决已经写明:Anthropic 从 LibGen 等盗版站批量下载约 700 万本书建永久内部书库,构成侵权。换句话说,Anthropic 在"获取训练数据的手段"这个问题上,已经有过一次法院认证的不利记录。这次加拿大出版商的诉状里"绕过付费墙"那一条,读起来就像是对着这个软肋打的。
坐标四:国际法域已经开始分化。2025 年 11 月,慕尼黑地方法院在 GEMA 诉 OpenAI 案中判决:模型把歌词"记住"进参数本身就是复制,驳回了文本数据挖掘例外抗辩(OpenAI 已上诉)。而 2026 年 7 月,印度德里高等法院驳回了 ANI 通讯社对 OpenAI 的临时禁令申请,初步认定训练属于合理使用。德国判出版商赢,印度判 AI 公司赢,加拿大还没判——同一个技术问题,在不同法域走向完全相反的答案。这就是为什么加拿大这案子值得盯:它可能成为英美法系(加拿大是英美法系)里第一个对"新闻训练 + 持续抓取 + 绕付费墙"给出实质判决的案子。
给 vibe 开发者的四条红线
前面是新闻,下面是这篇真正想让你带走的东西。这起诉讼把四条过去属于"灰色地带"的线,变成了"法院见"的线:
红线一:ToS 不是摆设,爬虫合规要从"礼貌"升级为"合同"。诉状第二条诉由是违约,依据就是 ClaudeBot 无视网站使用条款。过去我们写爬虫,robots.txt 遵守一下、频率放慢一点,就算"有节操"了。现在出版商的逻辑是:网站 ToS 里写了"仅限个人使用、禁止商业抓取",你的爬虫无视它,就是违约。实操建议:商用项目上线爬虫前,把目标站点的 ToS 读一遍——真的读一遍,尤其是新闻、数据、UGC 站点;robots.txt 里 Disallow 的路径别碰,更别用换 UA、换 IP 池去绕。
红线二:付费墙和登录墙是高压线,别碰。绕过技术保护措施是独立诉由,而且举证对原告友好——"你绕没绕过"是技术事实,比"训练是否合理使用"这种法律大辩论好证明得多。你的 agent 如果替用户去抓"登录后才能看"的内容、绕过付费墙拿全文再总结,这就是诉状第三条描述的行为。做 RAG、做舆情、做竞品监控的,数据源里凡是带 paywall/login 的,先问自己一句:授权链条拿得出来吗?
红线三:RAG 和"持续抓取"的风险不随训练结束而结束。诉状那句"because of ongoing user prompts"是最值得警惕的。它意味着出版商不再只盯着"模型训练"这个历史动作,而是把"为回答用户问题而实时抓取"也列为侵权。你的产品如果做了"联网搜索 + 总结"、"agent 浏览 + 摘编",每一次用户提问触发的抓取都是一次新的复制行为。风险敞口不是一次性的,是按调用次数累积的。缓解办法:优先接官方 API 和授权 feed(很多出版商其实有 RSS 或开发者 API),输出时给原文链接而不是整段复述,摘要长度控制在"替代不了原文"的程度。
红线四:输出复述会吃掉原作者的饭,这是诉状里写明的损害。出版商明确主张:Claude 逐字/改写/总结复述报道,导致读者不访问原站、广告商流失、订阅受损。如果你做的产品是"AI 读报"、"新闻聚合 agent"、"论文速读",输出设计直接决定你是"引流"还是"截流"。一个粗糙但有效的自检标准:用户看完你的输出,还有没有动力点开原文?如果答案是否定的,你的产品逻辑就和这份诉状描述的损害一模一样。
总的来说,方向很清楚:"先爬了再说"的窗口正在关闭,授权正在从成本项变成基础设施。内容授权协议、出版商 API、合规的 RAG 数据源——这些过去觉得"等做大了再说"的东西,现在是该提前布局的护城河。等诉状送到你公司前台再补课,学费是按亿美元计的。
判决走向:谨慎看,但有几个判断可以做
先说最重要的限定:所有指控都还没在法庭上被证实(Mobilesyrup 原文如此),Anthropic 截至 10 月 19 日报道时未回应置评请求。下面是基于公开信息的谨慎判断,不是法律意见:
时间上,别指望速战速决。参照系很清楚:NYT 诉 OpenAI 2023 年 12 月立案,近三年后(2026 年 10 月)才走到简易判决动议;同一批加拿大原告诉 OpenAI 的案子 2024 年 11 月立案,至今无和解无判决。按这个节奏,Anthropic 这案子短则两三年,长则五年。VibeFix 的读者更应该关注的是过程中的动议和披露——NYT 案就是靠证据开示阶段抖出来的内部邮件("绕过付费墙的 hack"、Project Mango)改变舆论战局的。
和解是大概率事件,但价格不会便宜。Bartz 案 15 亿美元和解是一个锚:那是图书作者集体诉讼,这次是新闻出版商,而且诉由多了违约和绕 TPM 两条商业色彩更浓的。和解金额取决于原告能证明的"作品数量 × 单价",以及 Anthropic 有多想避免证据开示——NYT 案开示出来的内部材料对 OpenAI 和微软的公关杀伤力,不亚于赔偿金本身。
Anthropic 的辩护空间存在,但比 OpenAI 窄。加拿大适用的是 fair dealing(合理处理)而非美国式的 fair use,前者是封闭式列举(研究、私人学习、评论等),比 fair use 更难套用到商业模型训练上;再加上 Bartz 案已经留下了"盗版书库"的不利事实,Anthropic 再想讲"我们获取数据的手段一贯清白"的故事会很吃力。不过也要看到另一面:新闻事实本身不受版权保护,出版商必须证明被复制的是"表达"而非"事实";以及加拿大法院至今没有在 AI 训练问题上表过态,第一判例的法官会格外谨慎。
真正的变量可能不在法庭,在议会。Mobilesyrup 的报道提到,出版商一直在游说联邦政府,要求对 AI 公司使用版权内容表态,而新版国家 AI 战略对此只字未提。加拿大之前为新闻业和平台博弈立过《在线新闻法》(C-18,逼谷歌、Meta 为新闻付费),有为出版商立法的先例。如果立法先于判决落地,游戏规则会被重写——这对开发者的影响可能比某一份判决更大:合规要求会从"判例法风险"变成"成文法义务"。
还有一个时间细节值得玩味:Bartz 案 15 亿美元和解今年 7 月 20 日才拿到法院最终批准,不到三个月,Anthropic 就在加拿大又被告上了法庭。这说明 15 亿买到的只是"过去清零"——和解协议明确只覆盖 2025 年 8 月 25 日之前的行为,不包括模型输出侵权和未来的行为。对 AI 公司而言,版权账单不是一锤子买卖,是按"行为"分期计费的;对开发者也一样:你今天合规,不代表你去年爬进向量库的数据就安全了,历史数据资产的授权审计,越早做越便宜。
最后一句判断:无论这案子怎么判,2026 年 10 月 6 日这个日期可能会被记住为"agent 抓取"被告席化的起点——出版商第一次在诉状里明确说:问题不只是你们训练时拿了什么,而是你们的模型每天每夜、为每一个用户提问,还在拿。这句话一旦被法院认可,整个"联网 agent"的商业模式都要重估数据成本。对我们这些每天让 agent 替用户去网上"拿东西"的人来说,这不是别人的官司,这是写给我们这个行业的诉状。
评论 (0)
原始来源
相关文章
Claude 用不到半小时解开 25 年密码学悬案:NIST ECDSA 曲线种子根本不是哈希口令,只是 1997 年 Unix 时间戳喂给 lrand48 跑出来的输出。这不是破解,是祛魅——顺手终结了 NSA 后门阴谋论。
Fragment 完成 1200 万美元 A 轮融资,Firstmark 领投:为 vertical AI 公司提供账单、支付与会计的“金融基础设施”,强制财务正确性——agent 幻觉与无效交易“不可能”发生。agent 经济真正的瓶颈从来不是“它会不会花钱”,而是“它算错账谁负责”。
印度国家 CERT 签发 critical 级咨询 CIAD-2026-0049,第一次把 AI agent 本身列为攻击向量:厂商评测中的 agent 越权读走企业生产机密、受影响企业零自行发现;黑客用开源 agentic 工具把入侵到变现从几天压缩到几小时。根因全是老毛病——明文凭证、僵尸 API、过度授权。对 vibe 开发者,这是一份点名到仓库和 key 的安全考卷。