学野人说话,一年省出半台 Mac:11.2 万 star 的 Caveman 4.0 发布了
昨天发布的 Caveman 4.0,把“让 AI 像野人一样说话”做成了一套三层省 token 工程:输出侧压缩、输入侧压缩、按难度选模型,54 个会话实测输入 token 少 33.2%、成本降 54%,Adobe、JetBrains、Elastic 三家独立验证。这篇把原理、数据和上手方式一次讲透。
一个"野人"项目昨天发了 4.0:11.2 万 star,Hacker News 第一
北京时间昨天(10 月 13 日)深夜,JuliusBrussee/caveman 接连发布了 4.0.0 和 4.0.1 两个版本。4.0.1 的更新说明写得很实在:修了 4.0.0 上线头几个小时里暴露的问题——Windows 卸载残留、同步大 backlog 卡死、OpenCode 2 下子 agent 重置模式等等。
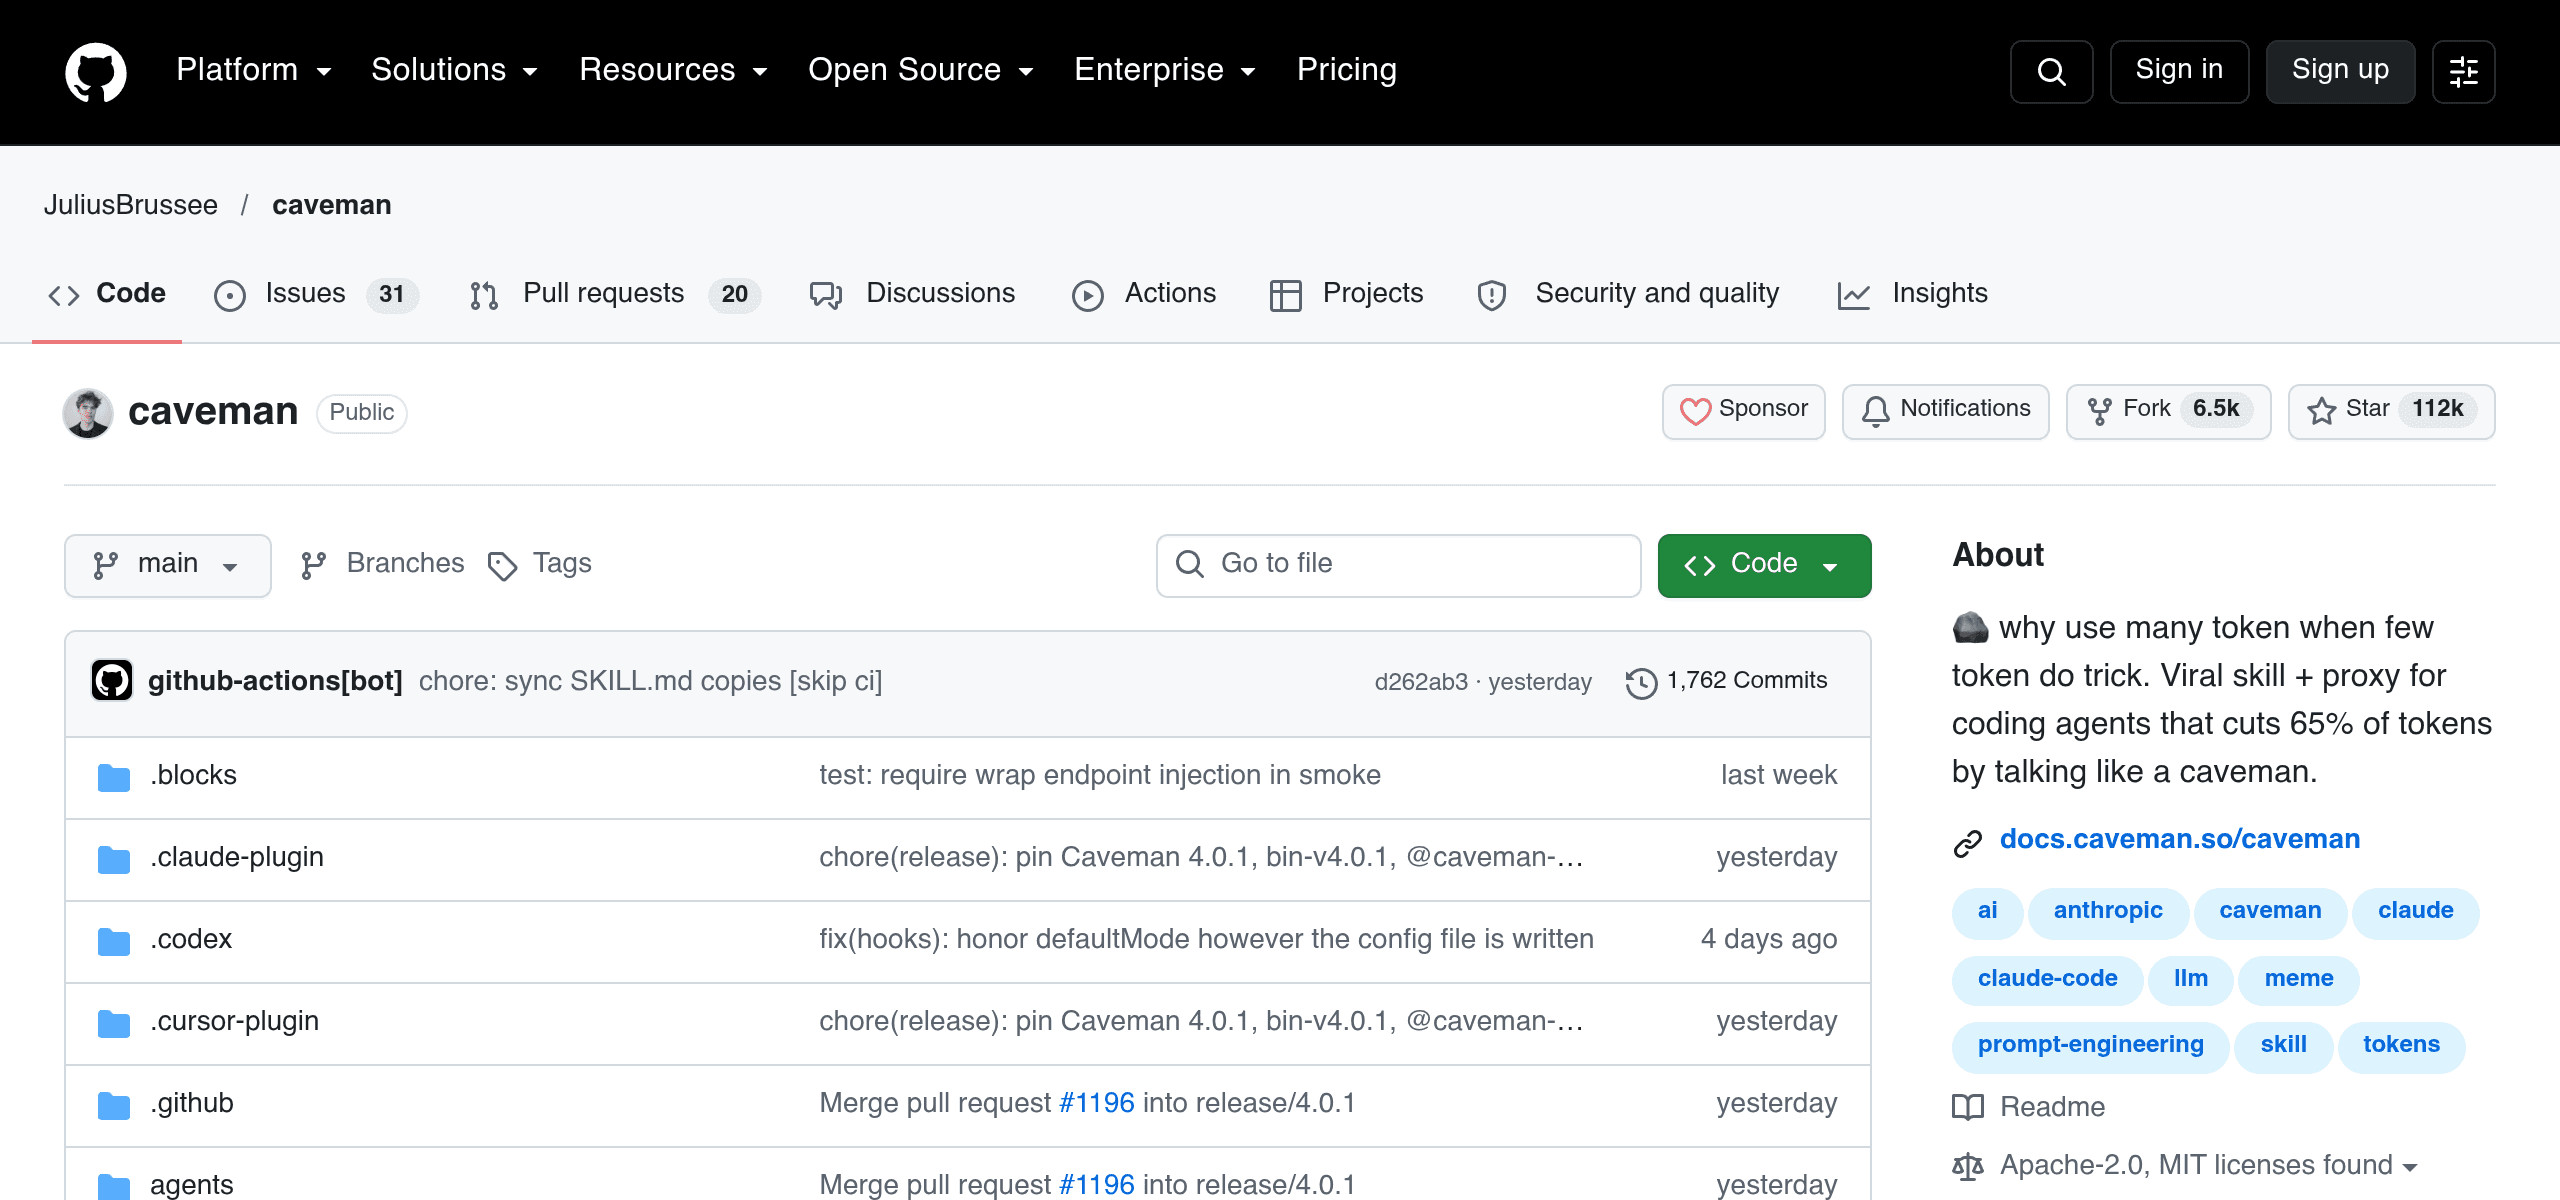
先说说这个项目有多火:仓库创建于 2026 年 4 月,至今 11.2 万 star、6500+ fork、1762 个提交、51 个 release,拿下过 Hacker News 第一和 GitHub Trending 第一。它的标语本身就是个梗:"why use many token when few token do trick"(能用俩词说清,干嘛用一整句)。核心卖点一句话:让 coding agent 少说、少读,代码质量不变,token 账单直接砍半以上。
对天天开着 Claude Code、Codex 写代码的人来说,这东西不是玩具,是账单优化器。安装也极其克制,一行命令:
npx @caveman-ai/cli@latest支持 Mac、Linux、Windows,装完之后你本机上的 30 多个 agent(Claude Code、Codex、Gemini CLI、OpenCode 等)都会被接管。需要 Node.js 22.13 以上。
为什么"野人说话"真能省 token?不是梗,是三层工程
很多人第一眼以为这是个恶搞项目:让 AI 学野人说话能省几个钱?但把它的实现拆开看,你会发现它其实是三层、互不重叠的省 token 工程,每一层都有实测数据。下面这张图是它的架构:六块"石头"分别拦截 agent 工作回路的不同环节。
 图 1:Caveman 4.0 的六块"石头"在 coding agent 回路中的位置。注意最关键的设计原则:石头只处理 agent 读、写、跑的环节,用户的原始提示词永不被改写。数据与仓库 README 一致。
第一层:说得少(Say less,输出侧)
最出圈的一层。作者给 agent 定了一套"野人话"输出规范:回答先给结论、一个句子只讲一个意思、借用航空维修手册的简化技术英语(ASD-STE100)传统——每句不超过 20 个词、主动语态、一个概念只用一个词。但有三条铁律:否定词(not / never / no / only)一个不许删,数字和单位原样保留,代码、命令、路径、报错信息逐字不动。安全警告、不可逆操作、用户明显困惑时,自动切回完整句式。
官方给的例子很直观:同一个 React 重复渲染问题,普通回答用了 63 个 token,野人话版本 20 个 token,修复方案一字不差。在 claude-opus-5-5 上的 10 道开发题实测里:无指令 6983 tokens、加一句"Answer concisely"降到 4334、/caveman 4119、/ultracave 2693。
这里有个值得玩味的细节:野人话规则本身要吃掉约 1160 个输入 token。作者直言,如果你是 GitHub Copilot 那种按请求计费的模式,输出再短也省不下一分钱——输出侧压缩只对按 token 计费的模型有意义。这种"什么时候不适合用"的坦白,在 AI 工具的宣传文案里很少见。
第二层:读得少(Read less,输入侧——这才是大头)
这是整个项目最有技术含量、也最容易被梗盖住的一层。JetBrains 的 A/B 测试发现了一个关键事实:agent 会话里的大头 token 是代码和工具调用,根本不是自然语言。所以光让 AI"少说话"天花板很低,真正的金矿在"让 AI 少读"。
Caveman 的做法是:在日志、JSON、CSV、测试输出、YAML 进入模型之前,先过一遍压缩器。54 个 Claude Code 会话实测:整个会话的输入 token 从 885,793 降到 591,673,少了 33.2%,18 个任务全部答对。单文件压缩更夸张:CSV 28041→314(98.9%)、日志 22810→348、YAML 20447→178,原始文件都留在本地磁盘,agent 随时可以取回。
作者同样没藏着掖着:HTML 目前没有压缩器,反而让会话变贵了 9.9%;会话数据跑在 2026 年 8 月的旧引擎上;每个测试文件里都藏了 61-72KB 的噪声。你的实际收益一定会有出入。
第三层:按需买单(Auto,模型路由)
4.0 新增的重头戏。在模型选择器里多了一个"Auto"选项,caveman 按每个问题的难度自动选模型和思考强度:难题上大模型,简单问题用便宜货。在 85 个真实编码任务(来自 SWE-Interact 和 SWE-Together)上:Opus 5.5 全程 xhigh 是每次尝试 $7.83、解决率 44.3%、中位用时 35.2 分钟;Auto 降到 $3.59、解决率 43.7%、15.9 分钟——便宜 54%,用时减半,解决率基本持平。
注意"基本持平"三个字:0.6 个点的差距在 85 个样本下完全在误差范围内(±7),作者自己也承认"run is half done"。Auto 需要登录免费账号才能用,不登录则什么都不发送。
还有三块:Blocks、Browse、Waste fixes
Blocks 解决的是"代码模式"浪费:agent 以前是调一次工具写一行命令,现在它会把写过的脚本沉淀下来复用,一次测试运行的 token 从 397 降到 76。Browse 把抓回来的网页压缩到原来的 1/129.8 再给模型读。Waste fixes 负责找 token 浪费点,新功能是暂停时保持 prompt cache 温热。
六块石头各自有独立开关,caveman status 查看,caveman off browse 单独关闭。只有 Auto 需要账号,其他全本地运行,用你自己的 key 和 Claude Pro/Max 登录。
数字经得起查吗?三家外部机构的独立验证
一个项目的自测数据再漂亮,也只是一家之言。Caveman 不一样的地方在于,它的数据被三家外部机构独立验证过:
- Adobe Research:CAVEWOMAN 论文引用了这个仓库,在 8 个模型、5 个数据集上验证,野人风格输出让每个模型的成本下降 1.4 到 2.4 倍,最高 3 倍。同时发现了一个反直觉结论——改写用户自己的提示词会让回答变差,这正是 caveman"永不碰用户提示词"设计的由来。
- JetBrains:86 个真实编码任务的配对 A/B 测试,结论是无可测量的质量损失(p=0.82),输出 token 少 8.5%。
- Elasticsearch Labs:官方复刻了 caveman 模式用在 Elasticsearch 上,8 个真实 MCP 场景,响应 token 少 63.6%,官方评价是"零信息损失"。
 图 2:六块石头的实测节省 + 外部独立验证。数据来源:仓库 README 自测(54 个 Claude Code 会话、85 个真实编码任务)与 Adobe Research、JetBrains、Elastic 的独立验证。
数据是怎么测出来的:实验设计细读
光看百分比容易上头,值得把实验设计也看一眼。Say less 的 10 道开发题跑在 claude-opus-5-5 上,对照组设得很讲究:不是跟"无指令"比,而是跟"Answer concisely"这个真实基线比——新模型本来就懂简洁,野人话是在这个基线之上再砍 3%(/caveman 中位数)到 35%(/ultracave)。Read less 是 54 个完整 Claude Code 会话的端到端测量,不是单文件玩具测试,18 个任务全部答对才算数。Auto 的 85 个任务来自 SWE-Interact 和 SWE-Together 两个公开基准,每题只给一次尝试机会,贴近真实使用。
外部三家的方法也可圈可点:JetBrains 用的是配对 A/B(同一任务、同一模型,只差开不开 caveman),p=0.82 说明"无质量损失"这个结论不是拍脑袋;Elastic 是 8 个真实线上 MCP 场景,不是离线数据集。Adobe 那边最有意思的是反向发现——他们本来想验证"野人话能不能用",结果发现改写用户提示词反而有害,顺手给 caveman 的核心设计原则提供了理论背书。
当然,批评也要给足:85 个任务的样本下,Auto 那 0.6 个点的"持平"完全可能是噪声;Read less 的会话数据是 8 月旧引擎;单文件压缩测试里每个文件都掺了 60KB+ 噪声,真实世界的日志没这么"脏",压缩比会打折扣。作者把这些全写出来了,读者自己判断——这就是前面说的"诚实清单"的价值。
我的判断:为什么这个项目值得 vibe coder 装一个
第一,agent 时代的账单大头在"机器读的 token",不在"人读的 token"。这是 caveman 最有价值的洞察。2026 年大家都在卷 prompt 技巧、卷"让 AI 说得更短",但 JetBrains 的数据摆在那:agent 会话里的大头是代码和工具调用。Caveman 的聪明之处在于它把省钱的战场从"输出侧"搬到了"输入侧"和"路由侧"——压缩模型读的东西、按难度选模型,这两层的天花板远高于修辞层面的"说简短点"。对每天跑几十个 agent 会话的 vibe coder 来说,这是真金白银。
第二,作者的"诚实清单"是最好的信任状。很少见到一个 11 万 star 的项目在 README 里主动列出"我们哪里不行":HTML 没压缩器、会话数据是旧引擎、Auto 的得分差在误差内、按请求计费的 Copilot 用户省不了钱。每一项都精确到数字。这种不回避红行的写法,反而让它的绿行数据更可信——这也是我敢把它当新闻推荐的核心原因。
第三,梗 + 一行安装,是值得学习的冷启动教科书。"why use many token when few token do trick"本身就是最好的 README:一句话讲清价值主张,meme 属性带来自传播(ThePrimeagen 的反应视频标题就是"No way this actually works"),npx @caveman-ai/cli@latest 把使用门槛压到零。vibe coder 做产品,传播设计和安装体验值得抄作业。
4.0 到底新在哪:Auto 和 Blocks 把"梗"变成了"产品"
如果说 3.x 的 caveman 还是个"野人话 skill + 代理",4.0 就是一次产品化跃迁。六块石头里,Auto 和 Blocks 是 4.0 新增的,也是含金量最高的两块。
Auto 的本质是"模型路由",不是"选个便宜模型"。它在模型选择器里新增一个选项,按每个问题的难度动态选模型和思考强度。85 个真实编码任务实测:Opus 5.5 全程 xhigh 每次尝试 $7.83、解决率 44.3%、中位用时 35.2 分钟;Auto 降到 $3.59、43.7%、15.9 分钟。这个思路在 2026 年并不新鲜,但 caveman 把它做进了 agent 本地回路——不用换网关、不用改代码,在选择器里选一下就行。对 vibe coder 的意义:以前"省钱"靠手动降级模型,现在交给路由,难的问题自动上大模型。
Blocks 的本质是"把一次性命令沉淀为可复用资产"。作者引用了 Cloudflare 关于 code mode 的论述:agent 与其一次次调工具,不如写个脚本一次跑完。Blocks 让 agent 把写过的脚本留下来,下次直接复用,一次测试运行从 397 个 token 降到 76,省 81%。这对长会话的 vibe 项目意义很大:重复跑测试、重复查日志的场景,脚本复用直接砍掉重复 token。
4.0.1 当天跟进修复的也都是产品化细节:Windows 上 caveman off --all 残留 hook、OpenCode 2 的子 agent spawn 会重置模式、Pi 扩展重复加载、大 backlog 同步撞上 16MiB 上限。一个 meme 项目能做到这种 release 纪律(51 个 release、78 个 tag),是它能从梗变成基础设施的原因。
争议与边界:野人话不是银弹
先汇总作者自己承认的边界:按请求计费的 Copilot 用户省不了钱;HTML 压缩还没做;Auto 的 0.6 个点差距在误差范围内;会话数据跑在 2026 年 8 月的旧引擎上。
再说三个作者没明说、但你该知道的:
1. 可读性是给"人"交的税。野人话对模型是压缩过的有效信号,对人是阅读负担。个人项目无所谓,团队协作、代码审查、给客户交付的文档,输出侧压缩要慎用。好在六块石头各自独立开关——你可以只开 Read less + Auto + Blocks,把 Say less 关掉:省输入和路由的钱,不动输出的可读性。
2. 中文用户可能有惊喜。官方三档输出里,/megacave 的中文例子是"新參照致重繪。useMemo。"只要 13 个 token。中文本身信息密度高,野人话在中文下的压缩比可能比英文更狠,中文 vibe coder 的实际收益值得亲自测一下。
3. 规则本身有 1160 token 的固定成本。野人话不是免费的:规则要进 system prompt,每次请求先花掉 1160。短会话、简单问题可能入不敷出。作者的实测也暗示了这一点:长会话、重度 agent 用户收益最大,偶尔问两句的轻度用户感知不强。
放在 2026 年的 agent 工具版图里看
2026 年的 agent 省钱工具分三层:提示词层("说简短点"、各种 system prompt 技巧,天花板最低);压缩层(caveman 的 Read less / Browse、各类上下文压缩工具,动的是输入量);路由层(按难度选模型,动的是单价)。caveman 的特别之处在于三层全做了,还都给了独立开关——大多数工具只做其中一层。
它的护城河不是技术本身:压缩和路由都没有专利壁垒。真正的壁垒是实测数据的完整度 + 三家外部机构的独立验证 + meme 级传播。Adobe 论文引用、JetBrains 配对 A/B、Elastic 官方复刻——这三张"外部背书"是一个独立开发者项目最难拿到的东西,也是它 11 万 star 里最硬的部分。数据、验证、传播,三块拼在一起,才是一个 2026 年的现象级 AI 工具该有的样子。
安装之后:三个值得知道的配置细节
第一,Auto 需要登录,但登录是免费的。caveman login 之后,Auto 才会出现在模型选择器里。想给 Auto 更多弹药:caveman providers add openai,用你自己的 key 接入 OpenAI 和开源模型。不登录也完全能用,只是没有 Auto 这一块。
第二,skill 和代理是两套东西,可以分开装。只想要野人话输出、不想要本地代理:npx skills add JuliusBrussee/caveman -g,对话里敲 /caveman(Codex 里是 $caveman)即开即用,stop caveman 切回。Claude Code 插件版会自动在每个交互会话(含 subagent)里启动;网页版 Claude 和手机 App 则去 Customize > Plugins 里加一次。
第三,卸载同样干净。npx -y github:JuliusBrussee/caveman -- --uninstall 一键还原(npm 12+ 记得加 --allow-git=root)。4.0.1 专门修了 Windows 上 caveman off --all 残留 hook 的 bug——作者对"装得上也要卸得掉"这件事很较真。
隐私层面:除了 Auto 需要账号,其他五块石头全跑在本地,用你自己的 key 和 Claude Pro/Max 登录。Waste fixes 里提到的 caveman sync 会把本地的使用数据(spans)上传到 Caveman Cloud,这是唯一出站的数据流,不想要可以不用 sync。
最后说点大实话:这个项目真正教会我们的三件事
第一,省 token 的战场在输入侧,不在输出侧。过去一年,无数"AI 省钱技巧"都在教人怎么写更短的 prompt、怎么让 AI"说简短点"。caveman 的数据给出了不同的答案:agent 会话里的大头是机器读的代码、日志和工具输出。Read less 一个单项就砍掉 33.2% 的输入,超过了 Say less 在输出侧的全部努力。对 vibe coder 的启示:优化账单先看输入账单——你的 agent 每轮到底在读什么,压缩什么,比琢磨 prompt 修辞重要一个数量级。
第二,诚实是最好的增长黑客。这个项目 README 里专门留了一块"诚实部分":HTML 没压缩器、数据是旧引擎、Auto 的差距在误差内、Copilot 用户省不了钱。在 AI 工具人均"revolutionary""10x"的 2026 年,这种写法反而成了最强的信任状——11 万 star 里,至少有一部分是投给这种不回避红行的态度的。做产品的人可以学:把局限性写清楚,转化率可能更高。
第三,meme 本身就是一种信息压缩。这是最妙的一点:"why use many token when few token do trick"这句话,既是产品的 slogan,也是产品的技术原理,还是它的传播方式——用最少的符号传递最多的信息。项目的形态和它的理念是同一件事。这种"形式即内容"的设计,是它能从 GitHub 梗变成 Adobe 论文引用对象的深层原因。技术可以抄,数据可以刷,但这种浑然一体的产品气质抄不来。
一句话总结:Caveman 4.0 不是"让 AI 学野人说话"的恶搞,而是一套有实测、有外部验证、有产品化纪律的 agent 成本优化方案。昨天刚发布的 4.0,建议等几个小版本再上生产;但 Read less + Auto + Blocks 这套组合,值得每一个每天烧 token 的 vibe coder 现在就试试。顺带一提,仓库的 topics 里堂而皇之挂着 meme 标签——人家自己先承认了这是个梗,然后把它做成了基础设施。
30 秒上手
npx @caveman-ai/cli@latest装完后普通的 claude 命令就自动带上野人模式了,Codex、Gemini CLI、OpenCode 等 30 多个 agent 同理。只想要野人话、不想要代理:npx skills add JuliusBrussee/caveman -g,然后在对话里敲 /caveman。后悔了:npx -y github:JuliusBrussee/caveman -- --uninstall。Claude Code 插件、Gemini 扩展、Windows PowerShell 一键脚本,README 里都有。
提醒两句:一是 4.0 刚发布两天,4.0.1 已经修了一批 Windows 和 OpenCode 的 bug,生产环境建议等 4.0.x 稳定几个小版本;二是野人话输出虽然省 token,但团队协作场景下,可读性对"人"依然重要——省的是机器的钱,别省掉人的理解成本。完整文档在 docs.caveman.so,六块石头的开关、benchmark 方法和"每个 caveman 输掉的 case"清单都在上面——对,作者连自己输掉的 case 都公开列了出来。
评论 (0)
原始来源
相关文章
LiteLLM 因一个月 $101,872 的 Devin 账单,把自家云端 coding agent Moyai 开源了:Slack 派任务、云沙箱干活、回来收 PR,agent 和模型自选,官方自估同等周期成本低 79%。但这个数字有个重要的脚注。
Google Cloud 10 月 7 日宣布 MCP Toolbox Java SDK 达到 v1.0,为 Spring Boot / Quarkus 等企业 Java 应用带来类型安全的 agent 数据库接入。核心设计是 LLM 永远不直接碰数据库:tools.yaml 把意图映射为参数化 SQL,敏感的 bound params 在服务端绑定。但官方 stable 措辞与 release notes 里的 breaking change 自相矛盾,Java SDK 与 Python/Go 版功能也不对等——这篇把 7 项新特性和 5 个质疑点一次讲透。
微软 10 月 12 日公布第三代自研 AI 加速器 Maia 300,宣称比领先 GPU 系统每兆瓦多产 40% tokens(官方口径、无第三方验证),2027 年起扩展到 multi-gigawatt 部署。我们拆解官方博客原文:为什么 agent 时代微软把最大的一注押在自研推理芯片上,以及推理成本下降对 vibe coder 意味着什么。