微软 Maia 300:40% 每兆瓦 token 增益,为 agent 推理造的“全智能系统”
微软 10 月 12 日公布第三代自研 AI 加速器 Maia 300,宣称比领先 GPU 系统每兆瓦多产 40% tokens(官方口径、无第三方验证),2027 年起扩展到 multi-gigawatt 部署。我们拆解官方博客原文:为什么 agent 时代微软把最大的一注押在自研推理芯片上,以及推理成本下降对 vibe coder 意味着什么。
10 月 12 日,微软云与 AI 执行副总裁 Scott Guthrie 在官方博客上宣布了第三代自研 AI 加速器 Maia 300,同时定下一个大目标:从 2027 年开始,把 Maia 家族扩展到 multi-gigawatt 级别的部署规模,使其成为微软产品与服务的主力推理系统。Satya Nadella 在同一天称之为"我们在自研硅片上最大的赌注"。
这不是一次普通的硬件更新。它出现在 OCP Global Summit 上,出现在微软预计本财年资本开支超过 1750 亿美元的节点上,也出现在一个关键的转折点上:AI 工作负载的重心,已经从训练转向了推理——而 agent 的流行,正在让推理的账单呈指数级膨胀。
这篇文章里,我们把 Guthrie 的官方博客原文逐段拆开,核实了其中的每一个数字和时间线,并把它们放进一个更大的判断里:为什么微软在 agent 时代,把最大的一注押在自研推理芯片上?这对每天和 agent 打交道的 vibe coder,又意味着什么?
先说清楚口径问题,避免后文产生误解。微软宣称 Maia 300 比"领先 GPU 系统"每兆瓦多产出 40% 的 tokens,但没有点名对比的是哪款 GPU,也没有公布测试负载——这是标准的 vendor claim,没有第三方独立验证。后文凡出现这类数字,我都会明确标注"官方口径"。这不是对微软的苛刻,而是阅读任何厂商硬件发布时的基本纪律:自研芯片的成绩单,值得等量产实测再下结论。
这次官宣了什么:事实清单
按官方博客原文梳理,Maia 300 的关键信息如下:
定位:Guthrie 把 Maia 300 描述为一个"完整智能系统"(complete intelligent system),设计目标直指三类新兴负载:长上下文推理、延迟敏感的对话体验、持续多步的 agentic 任务。注意这个措辞——上一代 Maia 200 的叙事还是"为 Copilot 跑生产负载",这一代直接把"agentic 任务"写进了设计目标。这是微软第一次在硅片层面承认:agent 不是软件层的玩具,它是基础设施层必须为之设计的工作负载。
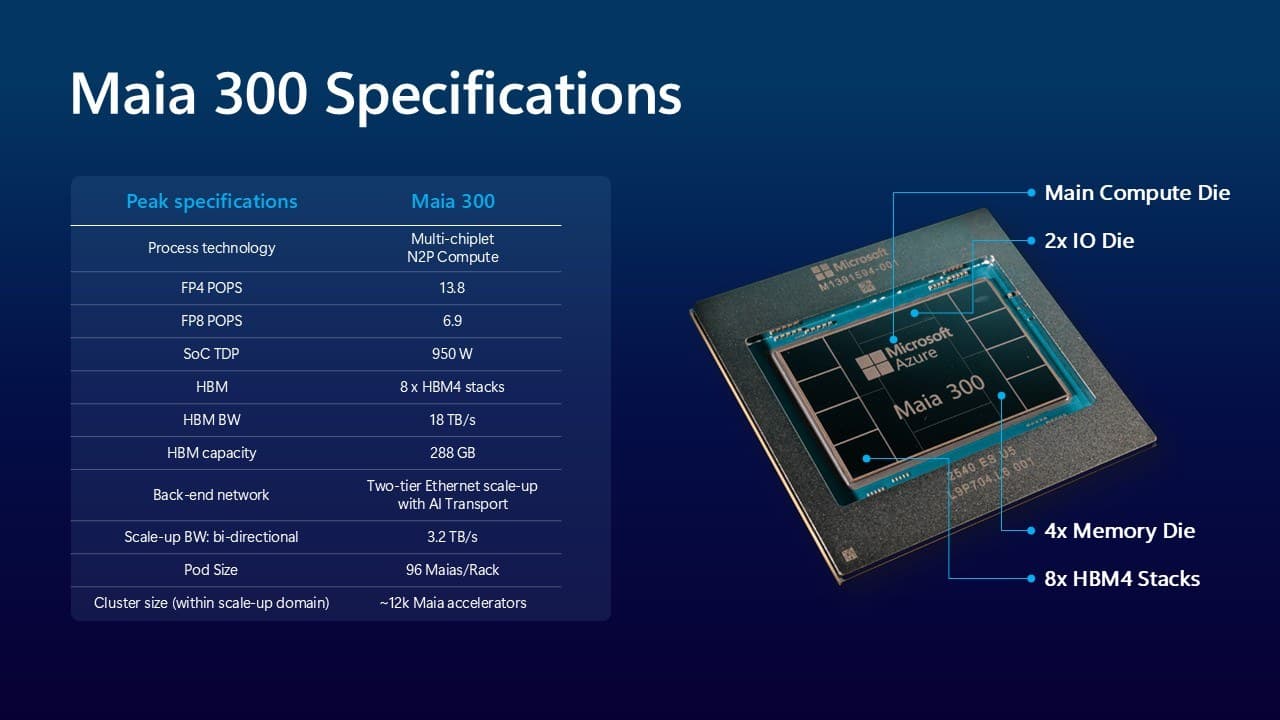
硬件规格:多 chiplet 架构,计算、内存控制、IO 功能分离;计算 chiplet 采用台积电 N2P 工艺;8 层 HBM4 叠层,共 288 GB 显存、峰值 18 TB/s 带宽;950W TDP;支持增强型 MXFP4 低精度格式;片上 SRAM 作为软件可管理的暂存区,减轻 HBM 压力;scale-up 网络走以太网架构的 AI 优化传输协议。微软的设计哲学是"让数据流动更高效,而不是堆原始算力"——推理系统的瓶颈是搬运数据,不是乘法。
整机形态:96 个加速器组成一整机,功耗包络 167 kW,HBM 总容量 27.6 TB,聚合带宽 1.7 PB/s。微软宣称,这一整机的 token 吞吐是 Maia 200 整机的 7 倍(官方口径)。
时间线:Maia 300 将在 2027 年开始量产部署;2027 年起 Maia 家族整体扩展到 multi-gigawatt 规模。更多架构细节,微软说会在 11 月的 Ignite 2026(旧金山)上公布。
Maia 200 的现状:这是博客里容易被忽略但其实更重要的一半——上一代已经在干活了。Maia 200 目前在美国、欧洲、澳洲的数据中心跑生产负载,服务 Microsoft Copilot,并支撑 MAI 团队开发下一代模型;GitHub Copilot 和 Microsoft Foundry 计划在今年年底前接入。微软称,在 Teams、Copilot、Cowork 的内建 AI 功能上,Maia 200 的 tokens/watt 比"领先 GPU 基础设施"高 1.7 倍(官方口径)。
 微软官方博客公布的 Maia 300 规格信息图。图中数字均为微软官方口径:40% tokens/兆瓦宣称未公布对比基线和测试负载,尚无第三方验证。
三代演进:从 Athena 到 agent 推理
把三代放在一起看,微软自研硅片的路线其实非常清晰。我们用代码生成了一张对照图,把三代的关键指标放在一起(数字均来自微软官方公告,标注 * 的为官方口径):
 Azure Maia 三代演进关键指标对照。Maia 100(2023)是"我们也能造芯片"的宣言;Maia 200(2026 年初)是"芯片真的能跑生产负载"的证明;Maia 300 则是"为 agent 时代重做设计目标"的第三步。标注 * 的数字为微软官方口径,尚未经第三方独立验证。
Maia 100(2023 年 11 月,Ignite 2023)是代号 Athena 的成果,台积电 5nm、1050 亿晶体管,当时号称 5nm 上最大的芯片之一。它为 GPT-3.5 Turbo 和 GPT-4 这类大语言模型设计,是微软第一次向世界证明:我们也能造 AI 芯片。但那时候它更像一个战略宣言——"减少对英伟达的依赖",而不是一个真正的产品。
Maia 200(2026 年 1 月公布)是转折点。216 GB HBM3e、7 TB/s 带宽、750W SoC,推理优先设计。关键变化是:它真的进了数据中心、真的跑起了 Copilot 的生产流量。微软第一次有了"自家芯片服务自家产品"的完整闭环,并且拿到了真实负载的 profiling 数据。Guthrie 在博客里明确说,Maia 200 的生产经验"直接塑造了 Maia 300 的设计"——这句话值得细品:自研芯片的价值不只是省钱,更是拿到了一整套真实工作负载的性能画像,下一代才知道该优化哪里。
Maia 300 则是路线图的第三步:设计目标第一次明确写上"持续多步 agentic 任务"。从"能造芯片"到"芯片能跑生产",再到"为 agent 负载重新设计芯片",微软的自研硅片走了三年。这条路线的节奏,和 Google 的 TPU(已经走到第七代)、AWS 的 Trainium(走到第三代)是同构的——云巨头们都在做同一件事,只不过微软起步晚、追得急。
判断一:agent 改变了"算力账本"的结构,推理成了主战场
为什么是现在重注推理芯片?答案在负载结构里。
训练时代,算力的账本是"一次性"的:训一个模型,烧一笔钱,完事。GPU 厂商的叙事围绕峰值算力(FLOPS)展开,谁的卡算得快谁赢。但 agent 时代的账本是"持续性"的:一个 agentic 任务可能跑几十分钟、调用模型几十上百次,长上下文里塞满工具返回结果,KV cache 越堆越大。推理不再是训练结束后的"尾款",它变成了按秒计费的"房租"。微软博客里那句"AI 正在成为每个应用、工作流和业务流程的基础层",翻译成财务语言就是:推理成本是 recurring cost,它会随着 agent 的普及线性——甚至超线性——增长。
这就是为什么 Maia 300 的 headline 指标不是峰值算力,而是 tokens/兆瓦。对云厂商来说,数据中心的硬约束从来不是"买不买得起卡",而是"这个园区能拿到多少电"。当电力成为上限,衡量芯片的标准就从"每块卡多快"变成了"每度电能产出多少有效工作"。微软把 40% tokens/兆瓦(官方口径)放在标题位置,本质上是在向华尔街讲一个故事:我们的 AI 毛利率,有办法通过自研硅片守住。
对这个逻辑,我的判断是:方向是对的,数字先打个问号。推理主导负载结构、电力成为硬约束,这两点是行业共识,英伟达自己都在推"token 经济学"的叙事。但 40% 这个数字,在微软公布基线和测试方法之前,只能当作 marketing 口径。读者记住结论的方向,别记住数字本身。
判断二:电力是新的石油,"推理主权"之争正式开打
"Multi-gigawatt"这个词值得停留一下。GW(吉瓦)是发电厂的单位,不是芯片的单位——一座大型核电站的装机容量大约就是 1 GW 级别。微软说的是:从 2027 年起,单是跑 Maia 芯片,就要吃掉好几座核电站的电。这不是修辞,这是 AI 基础设施正在逼近物理极限的诚实表达。
电力约束解释了整件事的紧迫性。训练可以排队、可以错峰,推理不行——用户提问的时候电必须在那里。当 Copilot、GitHub Copilot、Teams、Foundry 的每一次调用都要过一遍推理集群,"每兆瓦能产出多少 token"就直接决定了微软能服务多少用户、毛利率有多厚。Reuters 的报道里有个细节:微软 2027 年可能部署超过 100 万片 Maia(注意口径是"potentially")。100 万片 × 每片近千瓦,这就是为什么部署单位要用 GW 来数。
再往大看,Maia 300 是云巨头"推理主权"之争的最新一枪。Google 有 TPU,AWS 有 Trainium 和 Inferentia,Meta 有 MTIA,OpenAI 和 Anthropic 也都在搞自研芯片——加上微软的 Maia,五家大厂没有一家愿意把推理的命脉完全押在英伟达身上。英伟达每个季度超过一半的收入来自 hyperscaler,这个结构本身就是不稳定的:买家越大,越想自己造。
有意思的是,微软在这场仗里走了"两条腿":一手是 Maia 这样的自研芯片(摆脱依赖),另一手是和英伟达的合作(10 月 7 日,Nadella 和黄仁勋同台发布了搭载 RTX Spark 芯片的 Surface Laptop Ultra,要把 agent 跑进 Windows 笔记本)。云端用自研芯片降本,端侧和英伟达合作抢入口——这两件事看起来矛盾,其实是同一套逻辑:agent 要无处不在,就必须在云和端两头都把成本打下来。云端降本靠 Maia,端侧降本靠把推理塞进用户自己的设备(电费用户出)。
这也解释了为什么上轮我们聊过的"本地 agent"趋势(比如 Nemotron 的本地部署路线)和 Maia 300 是同一枚硬币的两面:agent 的终局不是"都跑在云上"或"都跑在本地",而是推理成本低到可以在任何地方跑。微软同时在两端下注,恰恰说明它看清了这一点。
对 vibe coder 意味着什么:agent 调用正在变便宜
好了,芯片是微软的事,我们关心的是:这和我每天写代码有什么关系?关系很直接:推理成本下降,是 agent 时代最重要的"降税"。
先算一笔账。vibe coder 的日常开销里,越来越大的一块是"agent token 账单":让 agent 跑一个中等复杂度的任务——读仓库、改代码、跑测试、修 bug 循环几轮——轻松烧掉几十万 token。按今天的 API 定价,这就是几美元一次。听起来不多,但当你一天跑十几次、一个月下来,这笔钱就超过了订阅费本身。很多独立开发者已经开始"数着 token 用 agent",长任务不敢开、长上下文不敢给——这恰恰是 agent 最有价值的用法被价格压制了。
Maia 300 这类推理芯片的意义,就是把这条成本曲线往下压。传导路径有三条:第一,模型 API 降价。Azure Foundry、OpenAI API 的定价,最终锚定的是推理成本。自研芯片把每 token 的边际成本打下来,降价只是时间问题——参考 AWS Trainium 上线后自家模型托管价格的下调历史。第二,订阅制产品的"用量上限"放宽。GitHub Copilot 这类按月订阅的产品,最怕的就是重度用户把算力吃光;推理成本降了,rate limit 和配额就有放宽的空间,"无限量 agent"才从营销话术变成可能。第三,免费层和低价层的体验变好。对学生和独立开发者来说,免费额度能跑的 agent 任务变多,试错成本变低。
更深一层的影响是工作方式。当 agent 调用便宜到不用心疼,你会开始用 agent 做现在觉得"不划算"的事:让它把整个仓库的测试覆盖率补齐、让它对着 profiling 数据做三轮性能优化、让它并行试五个方案再选最好的。今天这些用法受限于价格,明天它们会变成默认工作流。工具的价格决定工具的用法——vibe coding 的形态,会被推理成本重塑。
当然,传导需要时间。Maia 300 要 2027 年才量产,微软的降价也不会明天就到。但方向一旦确定,预期就会先行:模型厂商的定价策略、agent 工具的配额设计,从现在起就会按"推理会越来越便宜"来规划。对 vibe coder 来说,务实的结论是:别再按今天的 token 价格去设计你的长期工作流——那些"太贵了所以手动做"的环节,值得重新评估。
冷静剂:三处需要打折扣的地方
把乐观情绪收一收,有三件事要如实说。
第一,40% 是 vendor claim,不是实测。微软没有公布对比的是哪款"领先 GPU 系统"、跑的什么负载、什么精度。英伟达的 GB300 整机是 72 卡 142 kW,Maia 300 整机是 96 卡 167 kW——卡数、功耗都不一样,"每兆瓦"这个分母本身就值得推敲。在第三方拿到芯片实测之前,40% 只是一个意向声明。同样,7 倍机架吞吐、1.7 倍 tokens/watt,都是同一性质的数字。
第二,规模化部署是另一场硬仗。设计芯片和把芯片铺满全球数据中心是两回事。据 The Information 8 月的报道,Maia 200 当时只在两个美国数据中心运行——从"能跑"到"multi-gigawatt",中间隔着供应链、良率、运维、软件栈适配。微软 2026 年 1 月才公布 Maia 200,10 月就公布 Maia 300,这个迭代速度与其说是"量产节奏",不如说是"路线图宣示"。真正的考验在 2027 年。
第三,对手没有闲着。同一届 OCP 上,英伟达把 Vera Rubin 的机架设计交给了 OCP,AMD 公布了 Helion 开放机架蓝图——开放生态打封闭自研,这是英伟达的老剧本。而且别忘了,Maia 只服务微软自己的 workload,不对外出租(不像 Google Cloud 出租 TPU、AWS 出租 Trainium 实例)。这意味着 Maia 的效率红利只会通过微软的产品价格传导出来,第三方开发者吃不到"租 Maia 算力"这碗饭。
结语:芯片是 agent 时代的"水电煤"
Maia 300 最值得记住的不是 40% 这个数字,而是它标志的一个转折:agent 已经从"应用层的创新"变成了"基础设施层的设计输入"。当芯片的设计目标里第一次写进"持续多步 agentic 任务",说明这个行业达成了新的共识——未来的算力账本,是按 agent 的 token 消耗来记的。
对 vibe coder 来说,这条新闻的 actionable takeaway 只有一句话:推理成本的下行曲线是确定的,agent 会越来越便宜、越来越无处不在。现在就开始按"agent 调用不要钱"去设计你的工作流——等到降价真的到来时,你已经跑在前面了。
后续值得跟进的两个时间点:11 月的 Ignite 2026,微软承诺公布更多 Maia 300 架构细节;10 月 28 日微软财报,资本开支和 AI 业务毛利率的数字会告诉我们,"自研硅片降本"这个故事在财务上走到了哪一步。到时候我们再回来验证今天的判断。
说明:本文所有性能数字(40% tokens/兆瓦、7× 机架吞吐、1.7× tokens/watt)均为微软官方口径,微软未公布对比基线与测试方法,尚无第三方独立验证。Maia 300 预计 2027 年开始量产部署。
评论 (0)
原始来源
- Official Microsoft Blog — Scott Guthrie: Microsoft to expand Azure Maia system to multi-gigawatt deployments (2026-10-12)
- Reuters — Microsoft plans huge deployment of its own AI chips, with an eye on saving costs (2026-10-12)
- Data Center Dynamics — Microsoft unveils Azure Maia 300, says chip will be its primary inference system (2026-10-12)
相关文章
微软在 microsoft/autogen 仓库 README 顶部挂出“维护模式”横幅:6.1 万 star 的明星项目不再接收新功能,转由社区维护,新用户被指路 Microsoft Agent Framework 1.0。本文逐字核实横幅原文,复盘多智能体框架三年演进,并给出现有用户的迁移决策清单。
阿里 Qwen 团队 10 月 12 日官宣 QwenGyre——面向极长时 agent 训练的弹性在线 RL 框架:Elastic Scheduler 让 GPU 在 rollout 与训练间按需流动、运行中任务零中断,Trajectory Processor 把分支执行轨迹收敛为有界训练样本。Qwen 3.8 2.4T 上 48 步训练从 134.55 小时压到 75.42 小时,NL2RepoBench 通过率 52.48%→58.54%。但“已开源”的说法与论文无公开代码的事实不符,如实标注。
Z.ai 发布法律垂直 agent 模型 GLM-Legal,Harvey LAB 全通过率 19.2%,是基座的近 3 倍,单次测试成本仅 0.15 美元。但官方对比图选择性省略了排名更高的 6 个模型——榜首 Muse Spark 1.2 高达 25.42%。本文卸妆看真相:分数怎么考的、代价是什么、对做应用的人意味着什么。