6.1 万 star 的 AutoGen 被微软亲手送进“维护模式”:agent 框架的野蛮生长期结束了
微软在 microsoft/autogen 仓库 README 顶部挂出“维护模式”横幅:6.1 万 star 的明星项目不再接收新功能,转由社区维护,新用户被指路 Microsoft Agent Framework 1.0。本文逐字核实横幅原文,复盘多智能体框架三年演进,并给出现有用户的迁移决策清单。
上周,打开 microsoft/autogen 仓库的人都看到了一行新东西:README 最顶上,多了一个醒目的横幅——"AutoGen Maintenance Mode"。微软亲手把自家 6.1 万 star 的明星项目送进了维护模式。
这不是一次普通的"归档"。横幅措辞干脆利落:新功能和增强不会再有了,项目转由社区维护;新用户请直接去 Microsoft Agent Framework;老用户请跟着官方迁移指南走过去。从 2023 年 8 月那个"让多个 AI agent 像人一样开会讨论"的实验性框架,到今天被亲手盖上"维护中"的印章,AutoGen 只用了三年。
这件事的象征意义,远大于它本身的技术细节。它标志着多智能体框架这个赛道,正式从"野蛮生长"进入了"企业标准化"阶段。而对还在用 AutoGen 跑生产的人来说,这是一次必须认真对待的决策信号。
先把事实摆在桌上
我们在 2026 年 10 月 14 日亲自打开了仓库 README,横幅原文逐字如下:
Maintenance Mode
AutoGen is now in maintenance mode. It will not receive new features or enhancements and is community managed going forward.
New users should start with Microsoft Agent Framework. Existing users are encouraged to migrate using the AutoGen → Microsoft Agent Framework migration guide.
紧接着的一段,说明了接棒者的姿态:"Microsoft Agent Framework (MAF) is the enterprise‑ready successor to AutoGen……production-ready release: stable APIs, and a commitment to long-term support",并强调多 provider 模型支持和经由 A2A、MCP 的跨运行时互操作。README 底部的贡献政策也同步收紧:贡献仅限 bug 修复、安全补丁和文档改进,新功能开发请去 MAF。
关于时间口径,需要透明说明:README 本身没有日期戳。我们能核实的最早公开观察记录来自 aiagentstore.ai 的《Coding Agentic AI News - Week Ending 2026-10-13》,其中写的是 "Observed Oct 7, 2026"。也就是说,这个横幅大概率是在 10 月 7 日前后挂上去的。本文所有"上周"的表述都以此口径为准。
仓库的遗产规模摆在这里:61,393 个 star、9,279 个 fork、3,782 次提交、98 个 release。AutoGen 诞生于 Microsoft Research,是 2023 年"agent 框架爆发元年"的开山作品之一——那个年代,"让两个 agent 互相辩论写代码"的 demo 足以让整个 Hacker News 首页沸腾。
它为什么走到这一步:多智能体框架的三年
要理解 AutoGen 的今天,得把时钟拨回三年前。2023 年下半年,AutoGen 和 LangChain 几乎同时点燃了"多智能体"这个概念。那是个 demo 驱动的年代:框架的核心竞争力是"能跑出让人 wow 的对话式协作",至于状态管理、可观测性、错误恢复——没人关心,因为没人真的把它放进生产。
2024 年是分化的一年。一边,AutoGen 做了 v0.4 的大重写,试图从"对话 demo 框架"转向更严肃的事件驱动架构;另一边,LangGraph 用"状态机 + checkpoint"的朴素路线证明了:生产环境要的不是更聪明的 agent,而是可回放、可中断、可审计的执行模型。同年 11 月,一个意味深长的信号出现了:AutoGen 的原始作者 Chi Wang 和 Qingyun Wu 离开微软,把项目分叉成了 AG2(ag2ai/ag2)。创始人的出走,往往比任何财报都更能说明一个项目的内部优先级。
2025 年是收编的一年。微软推出了 Microsoft Agent Framework 的公开预览,并明确表示 AutoGen 和 Semantic Kernel 都将进入维护模式——VentureBeat 当时的报道引用了微软的说法:两者"不会再有新功能投入,但会继续收到 bug 修复、安全补丁和稳定性更新",且"没有破坏性变更的计划"。方向已经写得很清楚:微软要把所有 agent 框架收编到 MAF 这一条线上。
2026 年 4 月,Microsoft Agent Framework 1.0 正式 GA,由原 AutoGen 和 Semantic Kernel 的核心团队开发,Python 和 .NET 双 SDK,MIT 协议。半年后的今天,README 顶上的横幅完成了交接的最后一环。
我的判断是:AutoGen 不是"失败"了,它是"完成历史使命"了。实验型框架的任务是证明一个方向是对的——"多智能体编排"确实是构建复杂 AI 应用的有效范式,这个命题 AutoGen 已经证完了。但当行业从"证明方向"进入"交付 SLA"阶段,游戏规则就变了:企业要的是 stable API、长期支持承诺、可观测性、合规审计,以及和 Azure Foundry 这类平台的原生集成。这些恰恰是为实验而生的架构最难补的课。与其在一个为 demo 设计的底座上打补丁,不如另起一个为生产设计的框架,把 AutoGen 的 agent 抽象和 Semantic Kernel 的企业特性揉在一起——这就是 MAF 1.0 的配方。
还有一个更底层的趋势:协议层正在收编编排层。A2A(agent 间通信)和 MCP(工具接入)一旦成为事实标准,框架之间的差异化就被压缩到了"执行语义 + 生态"这一层。这时候大厂的最优策略就是收敛——与其维护三四个定位重叠的框架,不如all in 一个,把协议互操作做厚。AutoGen 的维护模式,本质上是这个收敛逻辑的必然结果。
对现有用户意味着什么:先别慌,但要做三道判断题
消息一出,最实际的问题是:我手里的 AutoGen 项目怎么办?先给结论:短期不用慌,长期必须做选择。微软明确承诺了没有破坏性变更的计划,现有代码不会明天就跑不起来。但"能跑"和"能安心跑"是两回事。下面是三道判断题:
第一题:你的项目处在哪个阶段?如果已经上线生产且运行稳定——恭喜,你拥有最长的缓冲期。维护模式不等于停止工作,bug 修复和安全补丁还会继续收,社区也在(AG2 分叉那边,原班作者还在活跃开发)。但如果项目还在开发中,或者还没立项——答案很明确:新项目直接上 MAF,README 自己都这么说了。
第二题:你能承受多大的"生态脱节"风险?这是最容易被低估的一项。框架进入维护模式后,真正的成本不是"没有新功能",而是与整个生态的渐进式脱节:新出的模型能力(比如新的工具调用范式)没人第一时间适配;A2A/MCP 协议演进时,AutoGen 侧的 connector 更新会越来越慢;社区问答的响应速度下降;新入职的工程师简历上写的不再是 AutoGen。这些成本不会在某一天爆发,而是像慢性病一样,每季度让你多付一点。
第三题:迁移的窗口期有多长?微软在 Learn 上放了官方的 AutoGen → MAF 迁移指南,这是目前阻力最小的路径。MAF 的设计本就吸收了 AutoGen 的 agent 抽象,概念映射相对直接。另一条路是 AG2——原始作者维护的社区分叉,Apache-2.0 协议,延续了 AutoGen 的技术路线。两条路的取舍很清晰:要微软官方的长期支持承诺和 Azure 生态集成,选 MAF;要最小改动、延续现有架构习惯,可以评估 AG2。但注意,AG2 是社区项目,它的"长期支持"靠的是社区热情,不是某家大厂的 roadmap——把这一点写进你的风险评估表。
给一个可操作的建议:把"AutoGen 迁移评估"列进下个季度的技术路线图,而不是这周的 on-call 清单。先跑通 MAF 的官方迁移指南做一个 spike(一到两周),量化改动面;同时给现有 AutoGen 服务加上更完备的可观测性——在维护模式下,你自己就是第一道防线。
Microsoft Agent Framework 1.0 到底是什么
既然微软把所有人都往 MAF 指,就值得认真看看它到底是什么。根据微软 Learn 官方文档的描述,MAF 是"Semantic Kernel 和 AutoGen 的下一代",由同一批工程团队打造:它把 AutoGen 直观的 agent 抽象,和 Semantic Kernel 的企业级特性揉到了一起——基于会话的状态管理、类型安全、执行过滤器、遥测,全部内置。
几个关键设计点值得注意:第一,统一的 Agent 基类。所有 agent 都派生自同一个基类,无论底层用的是哪家模型,接口一致——这对"多 provider 模型支持"不是一句口号,而是架构层面的承诺。第二,图状工作流。开发者对多智能体执行路径有显式控制,支持顺序、并发、群聊、agent 交接等模式,这其实是对 LangGraph 路线的一种回应:生产级编排最终都要落到"执行路径可控"上。第三,原生可观测性。OpenTelemetry 支持、checkpoint、人机回环(human-in-the-loop)都是工作流能力的一部分,而不是事后打补丁。
而且 MAF 并没有在 1.0 之后停下来。最近它又发布了 Declarative Workflows 1.0——把"agent 之间如何协调、状态如何流转、在哪里分支、何时需要人工介入"从应用代码里搬出来,写成仓库里可版本化的 YAML。这透露了微软的野心:MAF 不只想做 SDK,还想做 agent 时代的"编排即代码"标准层。
当然也要泼一盆冷水:1.0 的"production-ready"是微软自己说的。stable API 和长期支持承诺是强信号,但一个框架真正的生产成熟度,要看未来 12 个月真实世界的 issue、CVE 响应速度和社区生态。AutoGen 当年也是顶着光环出道的。保持乐观,但用生产流量投票之前,先做小规模试点。
一张图看懂这次交接
 AutoGen vs Microsoft Agent Framework:定位、维护状态、技术底座与迁移建议对照。核心结论:新项目直接用 MAF,老项目可继续运行但应把迁移评估列入路线图。
结语:收编时代的一个注脚
把 AutoGen 维护模式放进更大的图景里看,会发现微软这一年干的几件事是同一套逻辑:亲手给 AutoGen 挂维护横幅、一手推 MAF 1.0 GA、一手发布自研推理芯片 Maia 300、一手收紧对外部模型(比如 Claude)的开支。这是一套完整的"收编 + 自研"组合拳——把实验期的外部依赖和内部重复建设,收敛到自己可控的栈上。
对 vibe coder 和独立开发者来说,这件事的启示很实在:选框架的时候,看的不只是 star 数和 demo 效果,更要看"谁在为它的明天付账单"。6.1 万 star 也挡不住战略收编——star 是过去投票的结果,维护者名单才是未来的预告。下次再为一个框架心动时,不妨多问一句:它的核心团队还在吗?它的路线图和某家大厂的平台战略是同向还是逆向?
AutoGen 值得一个体面的告别。它证明了多智能体编排这条路走得通,带火了一个赛道,然后把位置让给了为生产而生的后来者。墓志铭上可以写:这里埋着一个完成了使命的实验。
评论 (0)
原始来源
相关文章
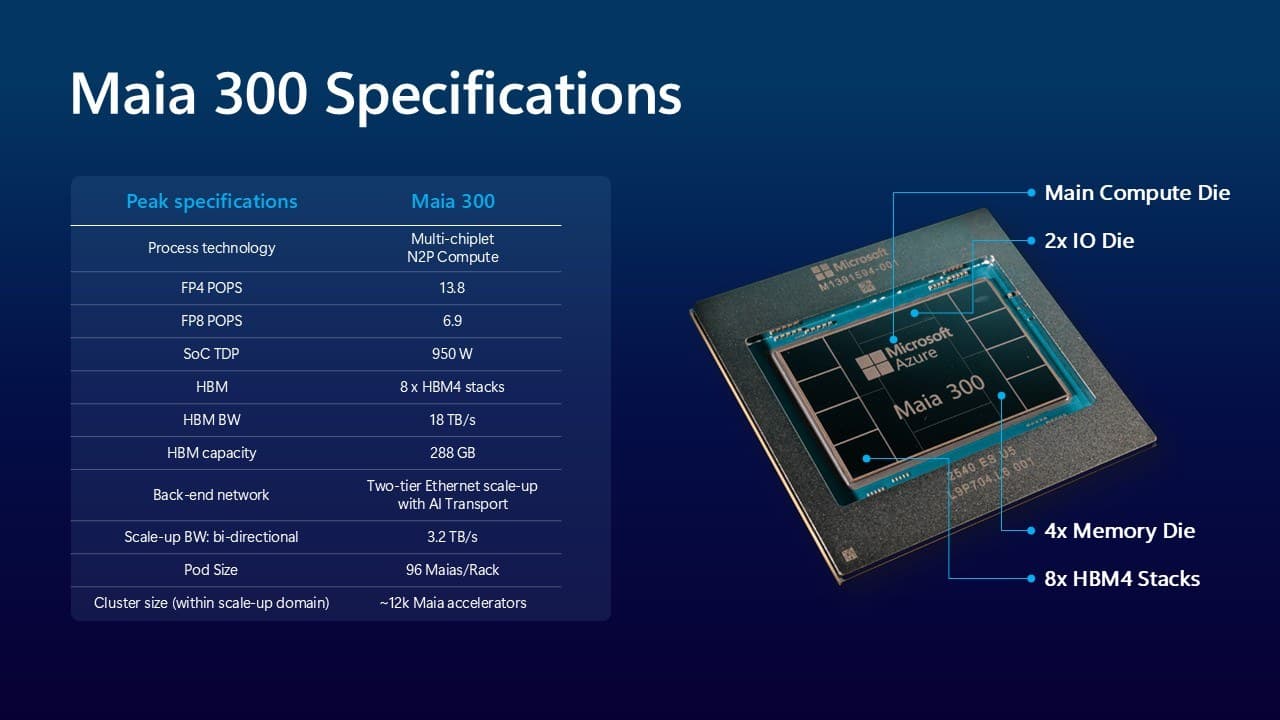
微软 10 月 12 日公布第三代自研 AI 加速器 Maia 300,宣称比领先 GPU 系统每兆瓦多产 40% tokens(官方口径、无第三方验证),2027 年起扩展到 multi-gigawatt 部署。我们拆解官方博客原文:为什么 agent 时代微软把最大的一注押在自研推理芯片上,以及推理成本下降对 vibe coder 意味着什么。
阿里 Qwen 团队 10 月 12 日官宣 QwenGyre——面向极长时 agent 训练的弹性在线 RL 框架:Elastic Scheduler 让 GPU 在 rollout 与训练间按需流动、运行中任务零中断,Trajectory Processor 把分支执行轨迹收敛为有界训练样本。Qwen 3.8 2.4T 上 48 步训练从 134.55 小时压到 75.42 小时,NL2RepoBench 通过率 52.48%→58.54%。但“已开源”的说法与论文无公开代码的事实不符,如实标注。
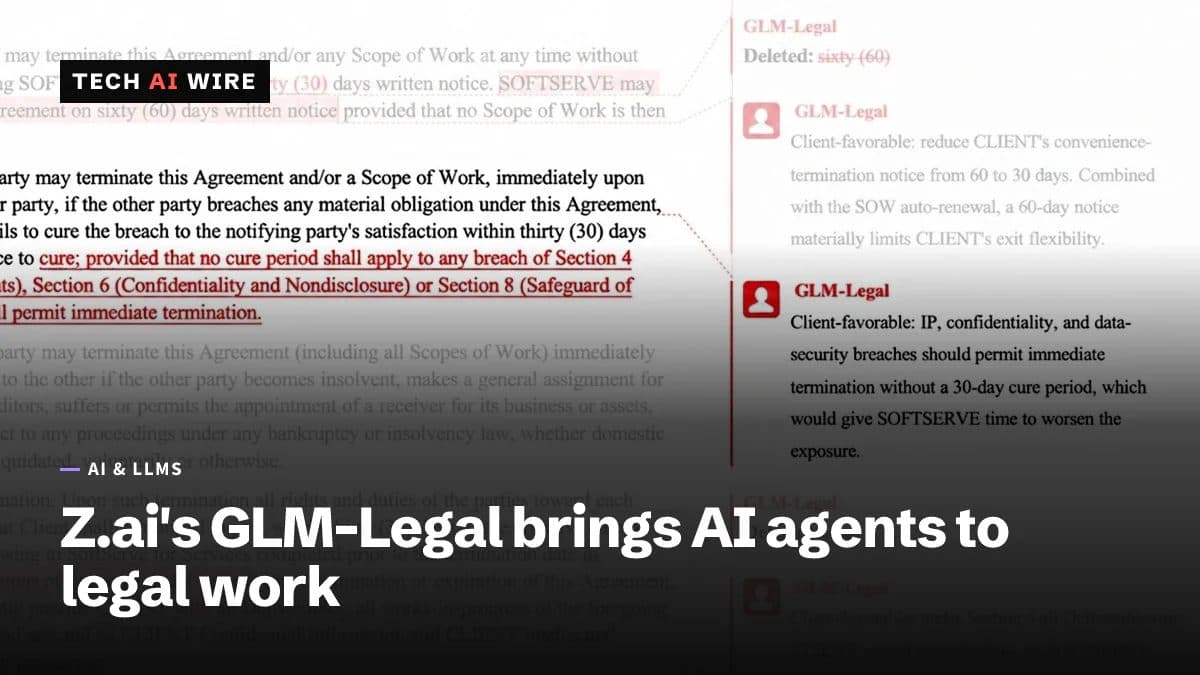
Z.ai 发布法律垂直 agent 模型 GLM-Legal,Harvey LAB 全通过率 19.2%,是基座的近 3 倍,单次测试成本仅 0.15 美元。但官方对比图选择性省略了排名更高的 6 个模型——榜首 Muse Spark 1.2 高达 25.42%。本文卸妆看真相:分数怎么考的、代价是什么、对做应用的人意味着什么。