阿里 QwenGyre:让 GPU 跟着长任务走,极长时 agent 训练提速 1.85 倍
阿里 Qwen 团队 10 月 12 日官宣 QwenGyre——面向极长时 agent 训练的弹性在线 RL 框架:Elastic Scheduler 让 GPU 在 rollout 与训练间按需流动、运行中任务零中断,Trajectory Processor 把分支执行轨迹收敛为有界训练样本。Qwen 3.8 2.4T 上 48 步训练从 134.55 小时压到 75.42 小时,NL2RepoBench 通过率 52.48%→58.54%。但“已开源”的说法与论文无公开代码的事实不符,如实标注。
如果说 2025 年是"agent 模型"的大年,2026 年下半年正在变成"训练 agent 的基础设施"的大年。10 月 12 日,阿里 Qwen 团队在官方 X 账号上官宣了 QwenGyre——一个面向极长时(XLong-horizon)agent 训练的弹性在线强化学习框架。它的目标很具体:让一次跑几个小时、烧掉近 100 万 token 的 agent rollout,训练起来不再是"等最慢的那个"。
这条新闻值得单独写一篇,不只是因为数字漂亮(Qwen 3.8 2.4T 上 48 步训练从 134.55 小时压到 75.42 小时,端到端最高 1.85 倍加速),更因为它和前天我们发的 Anthropic Scion 遥相呼应:agent 质量的前沿,正在从模型本身转向模型周围的 harness 和训练循环。一边是 Anthropic 给 RL 训练造源码级可控的 harness,一边是阿里让 GPU 跟着长任务弹性走——两家顶级团队在同一周把"训练基础设施"摆上台面,这不是巧合,这是 agent 军备竞赛进入下半场的信号。
XLong 到底难在哪:一次 rollout 跑几小时
先把问题的规模说清楚,因为 QwenGyre 的一切设计都是被这个规模逼出来的。论文把"XLong-horizon"定义为:单次 agent 执行跨越数小时、数百次模型-环境交互、单次 rollout 消耗近 100 万 token。典型的例子是"根据一份规格说明从零生成整个代码仓库"(比如 NL2Repo-Bench 这类任务)。
在这种尺度下,传统的在线 RL 训练管线会同时撞上两堵墙:
- 执行方差巨大,GPU 大量闲置。在 122B 的 Qwen 3.6 上,单次 rollout 平均 1.93 小时、单次查询 2.96 小时;到了 2.4 万亿参数的 Qwen 3.8 2.4T,有完整时长记录的查询里 61.1% 完整执行超过 4 小时。最慢的任务没跑完,训练就只能干等。
- 分支执行产生海量冗余轨迹。现代 agent harness(比如 Claude Code)会压缩上下文、派生子 agent、失败重试——一次执行不再是一条直线,而是一棵分支树。把每条路径都展开成训练样本,共享前缀会被重复计算无数遍,训练成本直接爆炸。
而业界已有的两种标准解法,各有一个解不开的死结。Colocate 方案让整池 GPU 在"跑 rollout"和"做训练"之间整体切换:训练永远被最慢的那个 rollout 卡住。Async 方案把 GPU 固定分成两池:一边闲着另一边却借不到算力。论文的措辞很直白:Colocate 下训练要等最慢的执行,Async 下固定分池让两边都互相借不到闲置容量。
换句话说,问题不在于 GPU 不够,而在于分配方式是静态的——而长时任务的执行时长方差,恰恰是静态分配最处理不好的东西。
弹性调度器:让硬件跟着任务走
QwenGyre 的第一个核心设计 Elastic Scheduler,思路可以一句话概括:GPU 不再预先固定分工,而是跟着未完成的工作量实时流动。
具体做法是:把 GPU 集群切成若干个"cell"(单元),每个 cell 共享同一份训练布局,可以独立地承担 rollout 执行或承载一个完整的训练副本。其中一个 core cell 持有权威的权重和优化器状态,其他 satellite cell(卫星单元)随后加入训练。调度器持续跟踪一个"rollout 水位线"——排队中和运行中的执行任务量;当剩余的 cell 仍然能服务全部存活任务时,就把空出来的 cell 切换去做训练。
最关键的工程细节是:切换过程中,运行中的 agent 任务零中断。模型调用通过一个 proxy 重新路由到仍在执行 rollout 的引擎上,harness 本体完全感知不到;KV 缓存块经由 RDMA 迁移,避免前缀重算。卫星单元则通过 Mooncake 的 Transfer Engine 从 core cell 拉取权威权重,加入正在进行的数据并行训练批次——不需要推倒重来。配合 streaming training(各 cell 按数据就绪认领 micro-step),整个集群的组进度保持同步。
切换有多快?论文给出的实测数字:rollout→训练平均 8.5 秒,反向 3.5 秒。放在动辄数小时的 rollout 面前,这个开销基本可以忽略——这正是弹性调度在 XLong 场景下成立的前提:如果任务只跑几分钟,8.5 秒的切换税就肉疼了;任务跑几小时,这笔税约等于零。
下图是 QwenGyre 两大设计的架构示意(自制,数字均以论文为准):
 QwenGyre 两大核心设计:左侧 Elastic Scheduler 让 GPU cell 在 rollout 执行(SGLang)与训练(Megatron)之间按需流动,切换仅需数秒;右侧 Trajectory Processor 把分支执行轨迹收敛为有界训练样本。图源:根据论文自制。
轨迹处理器:把一棵树,压成有界的训练样本
第二个核心设计 Trajectory Processor,解决的是另一堵墙:分支爆炸。
它的前提很有现实感:不改写 agent 的黑盒 harness。论文的全部实验都跑在未经修改的 Claude Code 2.1.220 上——训练框架不去碰 agent 的"驾驶舱",而是在外面加一个 proxy。这个 proxy 用 token-in/token-out(TITO)的方式,精确记录每一次模型调用的 token ID 和行为 log-prob。所有调用按"共享前缀"存成轨迹树:重复的前缀只存一次,从根上掐断冗余。
然后是四条处理规则,每一条都在回答"怎么从一棵树里挑出值得训练的东西":
- 部分评分(partial scoring):超时的执行不直接判零分,而是按它保留下来的工作区照样评分;评估器本身失败的样本直接排除,绝不记成零奖励。这很关键——长时任务里"差一点就做完"和"完全没做"之间,隔着巨大的训练信号差异。
- 有界采样(bounded sampling):每次执行最多保留 5 条轨迹,按"主轨迹 > 主轨迹摘要 > 子 agent > 子 agent 摘要"排序取舍。论文的实验表明,5 条上限就能达到不设上限的训练效果,同时把 forward-backward 时间砍掉 25.2%。
- 去重:共享的目标只计一次,且只训练策略模型自己生成的 token——harness 塞进来的模板、工具返回的文本不参与梯度。
- 公平加权:loss 在每次执行内部取平均,分支多的执行不会因为样本多就权重膨胀。
训练算法用的是适配过的 GSPO,每组 16 个 rollout。这些细节单独看都不性感,但合在一起回答了一个很实在的问题:当一次 agent 执行产生的是"一棵树"而不是"一条线"时,RL 训练的数据管线应该长什么样?QwenGyre 给出的答案是:树照样长,但进训练的永远是有界、去重、公平加权的样本。
数字:2.4T 上 48 步,134.55 小时 → 75.42 小时
来看论文的实测结果。所有对比都在同等 GPU 预算、匹配 staleness 的条件下进行,harness 统一为 Claude Code 2.1.220:
- NL2RepoBench(Qwen 3.6 122B,48 步):相对 Async 加速 1.42x–1.53x,相对 Colocate 1.36x–1.47x。
- DeepSWE(Qwen 3.6 122B,24 步):相对 Async 1.569x–1.572x,相对 Colocate 1.610x–1.824x。
- TerminalBench(Qwen 3.6 122B,24 步):相对 Async 1.383x–1.430x,相对 Colocate 1.809x–1.849x——1.85x 的最高加速出现在这里。
- NL2RepoBench(Qwen 3.8 2.4T,48 步):相对 Async 1.78x,相对 Colocate 1.21x。绝对时间:QwenGyre 75.42 小时,Colocate 91.47 小时,Async 134.55 小时。
注意 2.4T 那一行:相对 Colocate 只有 1.21x,是全表最低的。论文没有藏着掖着——MarkTechPost 的解读是,在 2.4T 上大量查询跑到了接近超时的时长,执行方差本身压缩了弹性调度的腾挪空间。这是个诚实的注脚:弹性调度的收益上限,取决于任务时长方差的结构,而不是无上限的。
质量侧同样有数字:Qwen 3.8 2.4T 在 NL2RepoBench 上的通过率从 52.48% 涨到 58.54%,48 步拿到 +6.0 个百分点的绝对提升。也就是说,加速没有以掉分为代价——"at matched scores"(分数对齐)是论文所有加速比的前提。
规模侧:122B 的实验用了 24–32 个节点,2.4T 的实验用了 192 个节点(4 个 cell,每 cell 48 节点)。训练用 Megatron,rollout 推理用 SGLang。GPU 具体型号论文没有披露——这也是目前唯一缺失的硬件信息。
横向对比:agent RL 框架已经多线作战
QwenGyre 不是在真空中发布的。把它和市面上另外三个主流 agentic RL 框架放在一起,看点很多:
- veRL(字节 Seed + 社区,Apache-2.0):设备映射灵活,HybridEngine 做重分片,开源。
- AReaL(清华 IIIS + 蚂蚁集团,Apache-2.0):完全异步路线,支持黑盒 harness(base_url 替换),开源。
- Agent Lightning(微软,MIT):黑盒 harness 近零代码改动,开源。
- QwenGyre(阿里 Token Hub + 中科大 + 清华):弹性 cell 中途切换 + proxy 黑盒,许可证与代码公开情况均未披露。
几个判断:第一,四家里三家开源,只有 QwenGyre 没给代码——这是它目前最大的短板,也是社区验证其数字的唯一障碍。第二,名单里中国力量占了三席(字节、阿里、蚂蚁+清华),agent 训练框架这个赛道,中国团队已经是事实上的主力玩家。第三,各家的加速比都来自自家实验设置,横向数字不可直接对比——但"弹性/异步"这个大方向是共识:没人再相信静态分配能喂饱长时 agent 训练。
如实标注:关于"开源"的口径差异
这条新闻有一个必须如实交代的口径差异:有媒体(StartupFortune)标题写"open sources QwenGyre",但论文页面没有附任何公开代码链接,MarkTechPost 也明确指出论文未链接公开代码发布。所以准确的说法是:阿里发布了 QwenGyre 框架与论文,代码是否公开目前不明。我们不会跟着标题写"已开源"。
另外两个口径说明:新闻事件日按 Qwen 官方 X 账号官宣的 10 月 12 日为准(论文本体 9 月 27 日上架 arXiv,编号 arXiv:2609.33848);X 原帖因域名限制未能直接打开,官宣文案与日期经多家 10 月 12/13 日报道交叉核实一致。以及一个顺带的信息点:论文实验在 Qwen 3.8 2.4T(A95B 激活)上完成——这从侧面印证了 Qwen 3.8 系列的存在。
为什么这事跟 vibe coder 有关
最后说点"这跟我有什么关系"。QwenGyre 这类框架不会直接出现在你的工具栏里,但它决定了你每天用的 coding agent 能不能啃下"一次跑几小时"的长任务。今天的 Claude Code、Codex 们已经能处理几十分钟的任务;下一代 agent 要做到"周五下班前丢一个需求,周一早上收一个仓库",瓶颈不在模型智商,而在训练这种长时行为本身的成本——而这正是 QwenGyre 在压的东西。
更直接的启示是方法论层面的:当你在自己的项目里用 agent 跑长任务、做大重构时,记住论文揭示的两个真相——长尾任务会吃掉你所有的并行预算(最慢的那个决定了整体),以及分支轨迹里大部分 token 都是重复的(前缀去重永远是第一性原理)。QwenGyre 是用 192 个节点解决这个问题的,但它的诊断,对只有一台电脑的你同样成立。
agent 的军备竞赛,前半场比的是"模型有多聪明",下半场比的是"训练有多便宜、harness 有多可控"。QwenGyre 和 Scion 在同一周出现,说明下半场已经开哨了。
评论 (0)
原始来源
相关文章
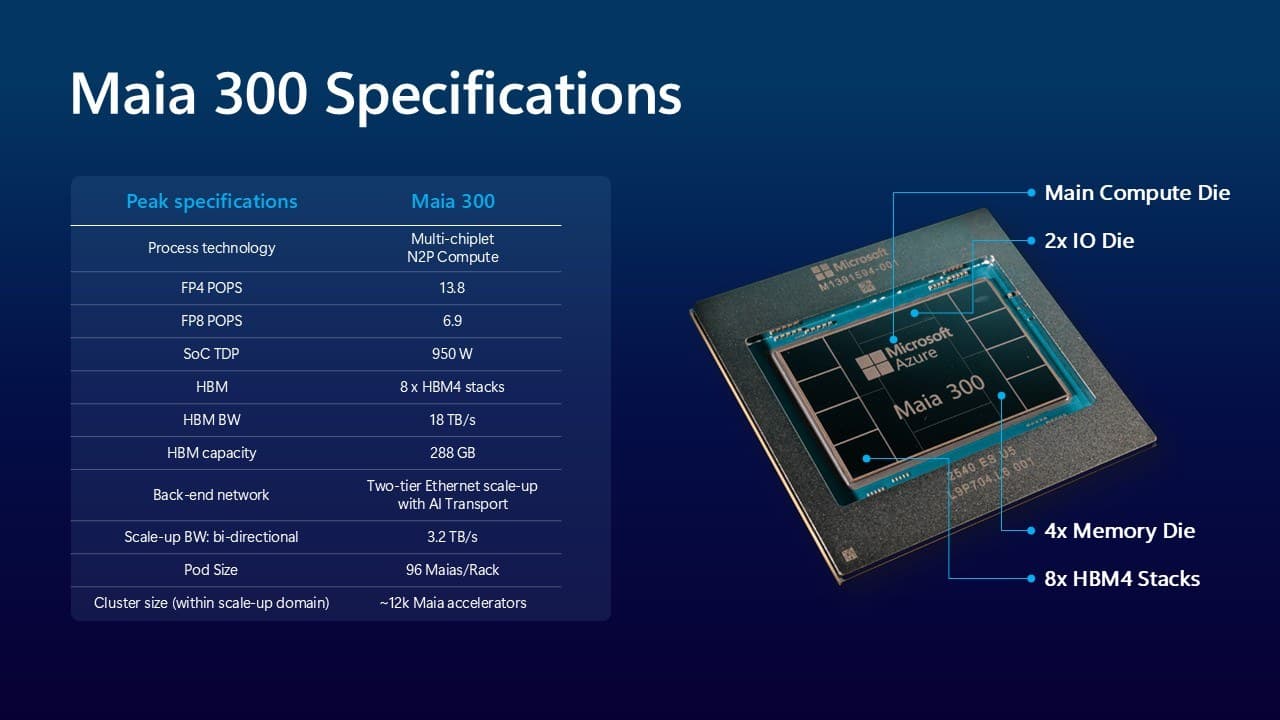
微软 10 月 12 日公布第三代自研 AI 加速器 Maia 300,宣称比领先 GPU 系统每兆瓦多产 40% tokens(官方口径、无第三方验证),2027 年起扩展到 multi-gigawatt 部署。我们拆解官方博客原文:为什么 agent 时代微软把最大的一注押在自研推理芯片上,以及推理成本下降对 vibe coder 意味着什么。
微软在 microsoft/autogen 仓库 README 顶部挂出“维护模式”横幅:6.1 万 star 的明星项目不再接收新功能,转由社区维护,新用户被指路 Microsoft Agent Framework 1.0。本文逐字核实横幅原文,复盘多智能体框架三年演进,并给出现有用户的迁移决策清单。
Z.ai 发布法律垂直 agent 模型 GLM-Legal,Harvey LAB 全通过率 19.2%,是基座的近 3 倍,单次测试成本仅 0.15 美元。但官方对比图选择性省略了排名更高的 6 个模型——榜首 Muse Spark 1.2 高达 25.42%。本文卸妆看真相:分数怎么考的、代价是什么、对做应用的人意味着什么。