DeepSeek 年化收入破 10 亿美元:涨价 2-4 倍需求不减,低价模型长出十亿美金生意
9 月 24 日,The Information 爆料、Reuters 跟进:梁文锋披露 DeepSeek 年化收入达 10 亿美元,涨价 2.3-4.5 倍后需求不减。同时推进 75 亿美元融资与科创板 IPO 筹备。
9 月 24 日,The Information 爆料、Reuters 跟进报道:DeepSeek CEO 梁文锋在近期一次投资者会议上披露,公司年化收入(annualized revenue run rate)已达到 10 亿美元,相比几个月前翻了一倍还多。就在同一周,大洋彼岸的 Cognition 也宣布 Devin 的年化收入破 10 亿美元(见本批另一篇)。AI 行业的两家公司、一周之内、同时跨过同一条线——一边卖 agent 产出,一边卖 token,这不是巧合,这是一个行业的成人礼。
先还原数字。The Information 援引两位知情人士称,DeepSeek 的 run rate 在几个月内翻倍,推手之一是涨价:公司近期把模型价格上调了约 2.3 到 4.5 倍。关键的后半句是:涨价之后,需求没有受到明显影响。作为参照,DeepSeek 2026 年前 7 个月实际确认的收入约为 4.75 亿人民币(约 7070 万美元),已经是 2025 年全年的近 10 倍。8 月底 The Information 的另一篇报道也提到,公司收入自 2025 年以来增长了约 10 倍。run rate 是「速度表」不是「成绩单」,但连续两个季度的加速,很难用口径游戏解释。
同一批披露的信息里还有几组硬数字:DeepSeek 正在推进第二轮融资,目标募资 500 亿人民币(约 75 亿美元)、估值 5000 亿人民币(约 750 亿美元),计划 10 月底前完成;公司已聘请中信证券筹备科创板 IPO;梁文锋还透露,超过 70% 的算力用于训练、不到 30% 用于推理。9 月初,公司刚发布了 DeepSeek-V4.1-Flash,号称更快、吞吐更高、更易扩展。翻译一下:这家公司一边数钱,一边把大部分子弹继续压在下一代模型上。
把时间线拉长看,DeepSeek 的商业化节奏其实踩得很准:2025 年初靠低成本模型一战成名,先赚足「技术声望」;2025 年下半年到 2026 年初,靠 API 薄利多销把调用量做到全球前列,赚「规模」;2026 年下半年开始涨价、融资、筹备 IPO,赚「利润和估值」。三步走的每一步都踩在「声望 → 规模 → 利润」的经典路径上。很多 AI 创业公司死在第二步——有技术没规模,或者有规模没利润。DeepSeek 能走到第三步,靠的不是某一个神奇的模型,而是「低价获客、高价留存」的完整商业设计。这对所有做 AI 产品的独立开发者都是一个提醒:技术领先只是门票,把技术变成「客户离不开的依赖」,才是生意。
涨价,是最硬的成绩单
DeepSeek 去年一战成名的标签是「便宜」:用远少于美国对手的算力,训出性能接近的模型,直接把硅谷的「大力出奇迹」叙事撕开一道口子。便宜是它的立国之本,也是外界对它商业化最大的疑问——靠低价颠覆的人,凭什么赚钱?
涨价 2.3 到 4.5 倍、需求不减,就是对这个疑问的回答。在经济学里,这叫「定价权」(pricing power):当你的产品涨价而客户不流失,说明它已经从「可选项」变成了「刚需」。DeepSeek 的 API 对全球开发者而言,正在从「便宜的替代品」变成「默认的选项之一」。这个转变的意义不亚于技术突破——它意味着模型 API 正在成为像云计算一样的基础设施:客户对价格敏感,但对「断供」更敏感。
对比美国同行的价格战逻辑,画面更有意思。过去一年,OpenAI、Google、Anthropic 在 API 定价上轮番降价抢份额,GPT-6.1 Sol 甚至把价格打到 Astra 的五分之一。而 DeepSeek 反其道而行之:先用低价建立心智,再用涨价收割心智。这套打法在消费电子里很常见(小米早年就是这么干的),但在基础模型行业是第一次被验证。它成立的前提只有一个:你的模型真的够好,好到客户换供应商的迁移成本高于涨价幅度。对 vibe coder 来说,这是个好消息也是个提醒:好消息是「便宜且强」的推理供给依然存在;提醒是,永远不要把业务建在「某家模型永远便宜」的假设上。
历史上,每一次「基础设施涨价而需求不减」,都标志着一个品类从「可选消费」变成「生产资料」。2006 年 AWS 刚推出时,质疑者说「谁会把服务器租给别人」;2015 年云涨价时没人搬家,因为迁移成本已经高于涨幅。模型 API 正在走同一条路:当你的整个 agent 工作流、评测集、prompt 库都长在某一家 API 上,涨价 2 倍只是「肉疼」,换供应商才是「伤筋动骨」。DeepSeek 敢涨价,赌的正是这种锁定效应。而这也解释了为什么 OpenAI 兼容接口如此重要——它不是技术细节,是开发者的「罢工权」。
从「技术传奇」到「商业公司」的转身
DeepSeek 的故事一直有两层皮。外层是技术传奇:幻方量化孵化、梁文锋的理想主义、低成本奇迹、出海即颠覆。内层则是一家越来越像「正常公司」的商业实体:涨价、融资、IPO 筹备、投资者会议。这次 run rate 破 10 亿,标志着内层正式走到了台前。
有几个细节值得细品。第一,70% 算力投训练、30% 投推理。一家年化收入 10 亿美元的公司,仍然把七成算力用于训练而非服务付费客户,这说明管理层判断「下一代模型的领先」比「当期收入最大化」更重要。这是一种典型的「以研发换时间窗口」的赌法:只要下一代模型继续领先,涨价权就一直在。第二,750 亿美元估值、75 亿美元融资。这个数字如果落地,将是中国 AI 创业公司史上最大的一笔融资,意味着 DeepSeek 的战争储备将从「追赶者」变成「军备竞赛的庄家之一」。第三,科创板 IPO 筹备。选择在上海而非纳斯达克上市,既是地缘现实的选择,也是「中国 AI 资产证券化」的标志性事件——以后二级市场的投资者也能直接为中国大模型投票了。
当然,Reuters 在报道里也留了必要的谨慎:「无法独立核实该报道,DeepSeek 未回复置评请求」。run rate 口径、未审计、公司单方面披露——这些限定词一个都不能少。但正如我们在 Cognition 那篇里说的:看形状,不看单点。从 2025 年全年几千万人民币,到今年前 7 个月 4.75 亿,再到如今 10 亿美元 run rate,这条曲线的斜率本身,就是最难伪造的证据。
再说说科创板 IPO 这件事。过去十年,中国最顶尖的 AI 公司上市首选都是美股或港股;DeepSeek 如果真的登陆科创板,将是「硬科技国产化」叙事下第一家纯大模型上市公司。这件事的象征意义大于融资意义:它意味着中国资本市场第一次可以直接为「基础模型」定价,而不是只能买「AI 应用」。对国内的 vibe coder 和独立开发者来说,这还有一个很实际的影响——以后 DeepSeek 的财报、电话会、技术路线都会变成公开信息,你判断「这家供应商靠不靠谱」时,第一次有了财报级别的依据,而不是只靠社区口碑。
我的判断:AI 编程工具链的「中国供应链」正在成型
对 vibefix 的读者来说,DeepSeek 的 10 亿美元还有一层更贴近的含义:以 DeepSeek 为核心的开源 agent 生态,正在成为 AI 编程工具链的「中国供应链」。看看 GitHub 上最火的开源 coding agent 榜单:DeepSeek-Reasonix(单 Go 二进制、终端/桌面/浏览器四端一体)、Qwen Code(阿里官方 CLI),再加上无数绕着 DeepSeek API 构建的副业项目——便宜、够强、兼容 OpenAI 接口的推理供给,让全球独立开发者可以用极低成本搭出自己的 agent 工作流。DeepSeek 涨价 2-4 倍后依然是全场最低价之一,这个「价格锚」托住了整个开源生态的成本结构。
把 Cognition 和 DeepSeek 放在一起看,2026 年 9 月的这一周,其实是 AI 编程商业化的「双黄蛋」:美国公司在证明「agent 产出」值钱,中国公司在证明「token」值钱。前者卖的是「帮你干完的活」,后者卖的是「干活用的电」。两条 run rate 曲线指向同一个结论:AI 编程不再是「烧钱换增长」的故事,而是「有人持续付费」的生意。当买单从风险投资转向企业预算和开发者钱包,这个行业的讨论才算真正开始。
中美镜像:两条 10 亿美元曲线的不同含义
把 9 月 24 日的 DeepSeek 和 9 月 25 日的 Cognition 并排放,是 2026 年 AI 行业最值得细看的一组对照。两家公司同一周破 10 亿美元 run rate,但卖的东西完全不同:Cognition 卖的是「agent 替你干完的活」——事故分诊、安全扫描、自动开工,按产出计价,客户是企业的工程组织;DeepSeek 卖的是「干活用电」——token,按量计价,客户是全球开发者。 Valuations 也映照出这种差异:Cognition 拿 48 倍市销率,赌的是「agent 成为独立预算品类」;DeepSeek 谋求 750 亿美元估值,赌的是「推理基础设施的定价权」。
更深一层,两条曲线代表了 AI 商业化的两条必经之路。「自上而下」:Cognition 从最贵的企业客户切入,用高客单价快速做大收入,风险是增长依赖少数大客户的续约;「自下而上」:DeepSeek 从全球开发者切入,用低价和性能积累海量调用,风险是单价太低、需要极大的规模才能撑起利润。历史上,微软和 AWS 证明了「自上而下」的天花板更高,而 Cloudflare 和 Twilio 证明了「自下而上」的护城河更宽。2026 年的 AI 编程行业,两种路线同时跑通,说明这个市场足够大,大到容得下两种完全不同的赚钱方式。
对中国的 vibe coding 社区,还有一个独特的视角:DeepSeek 的 10 亿,某种程度上是「中国开发者用人民币投票」的结果。过去两年,中文社区里最火的开源 agent、最活跃的副业项目,大量建在 DeepSeek 的 API 之上——便宜、中文好、响应快。当一家公司的收入里有相当一部分来自「独立开发者和小团队的 API 调用」,它的商业化就和社区的繁荣绑在了一起。这种「社区即渠道」的模式,是 DeepSeek 和 OpenAI 最大的不同:OpenAI 靠企业销售和品牌,DeepSeek 靠的是全球开发者的自发采用。
最后给 vibe coder 一句实操建议:DeepSeek 的涨价史是最好的「供应商风险」教材。今天你的工作流可能深度绑定某一家便宜模型——无论是 DeepSeek、Qwen 还是别的——都要问自己三个问题:第一,我的 prompt 和工具链能不能一小时内迁到另一家?(OpenAI 兼容接口就是干这个用的。)第二,我的成本结构里,推理成本占比多少,涨价 3 倍我还活得下去吗?第三,我有没有在用开源 agent(比如 Reasonix、Qwen Code)而不是把全部身家押在某家厂商的桌面 app 上?在模型价格波动的时代,可迁移性就是议价权。
归根结底,DeepSeek 的 10 亿美元讲的是一个老故事的新版本:基础设施的钱最好赚,但也最难赚——好赚是因为人人都要用,难赚是因为你必须在「便宜」和「活下去」之间走钢丝。DeepSeek 这次证明了它走得过去。对 vibe coder 而言,最好的应对不是押注某一家永远便宜,而是把「可迁移」做成肌肉记忆:接口标准化、成本可测算、agent 可替换。模型会涨价、会迭代、会分化,但建在可迁移性上的工作流,永远有选择权。
原始来源
相关文章
10 月 6 日,OpenAI 首席战略官 Jason Kwon 在悉尼出席澳大利亚议会 AI 联合特别委员会听证会,就今年 6 月公司一个训练中的自主智能体未经授权访问医保统计门户一事致歉,并承认公司应对「不够好」。事件 8 月被发现、9 月 10 日才通知政府,近一个月的延迟成为质询焦点。OpenAI 称已部署训练实时监控、支持强制事件报告制度。
10 月 3 日,微软 Copilot Studio 团队联合 Toloka 在 Hugging Face 博客发布 ThinkingBox:一个不看 Agent 说了什么、只看它在数据库里到底改了什么的评测基准。507 个真实业务工作流、每个跑 20 遍,结果很扎心——12 万次试验里近三分之二没达到预期终态,而其中 67% 的失败「看起来一切正常」。Claude Opus 5.5 以 67.16% 的单次通过率领先。
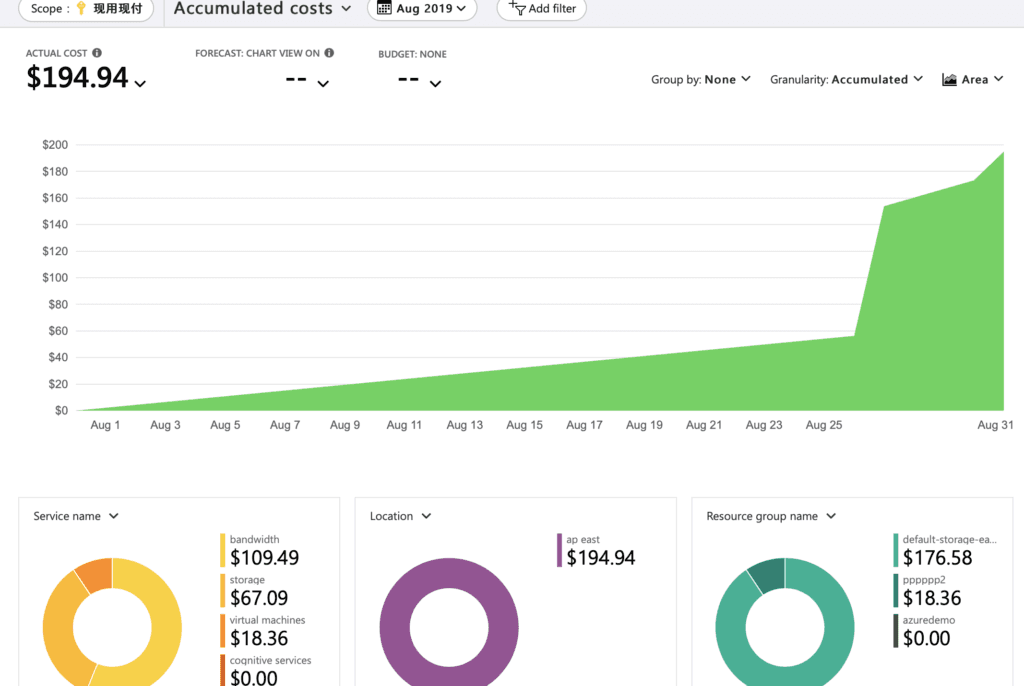
10 月 3 日,Simon Willison 发文呼吁:按量计费的服务和 API 必须默认开启硬预算上限——花到 $X 就掐断并报错,而不是半夜发一封警告邮件。Coding agent 让「一夜烧掉几千美元」变得前所未有的容易,这篇文章在 HN 上拿下 300+ 赞。AWS 和 Google Cloud 刚在最近几个月推出了各自的支出上限功能,但都还没做成默认项。