DeepSeek 开源 DeepInfer:生产级推理框架,Nvidia 与昇腾双芯片首发
DeepSeek 在 10 月 20 日开源了支撑其生产服务的推理框架 DeepInfer(Apache-2.0),首发支持 NVIDIA SM100 与华为 Ascend 950——距离它 2025 年 4 月亲口说“不开源完整引擎”仅 18 个月。本文逐条拆解开源了什么、没开源什么,以及为什么推理成本就是 agent 成本。
2026 年 10 月 20 日,DeepSeek 在官方 X 账号上连发四帖,宣布开源 DeepInfer——支撑其大规模生产服务的推理框架。README 的第一句话就把调子定死了:
"DeepInfer is the high-performance inference framework that powers DeepSeek's large-scale production services. This open-source release provides offline inference with the core features needed for serving at scale."
("DeepInfer 是支撑 DeepSeek 大规模生产服务的高性能推理框架。本次开源版本提供离线推理,以及大规模服务所需的核心功能。")
仓库 deepseek-ai/DeepInfer 以 Apache-2.0 许可证发布,任何人都可以拿去用、改、商用。消息一出,HN 首页直接冲到第一(356 points,侦察员 10-20 当天数据)。DeepSeek 官方帖的原话是:
"🚀 Introducing DeepInfer, our in-house inference framework, now fully open source! Powering DeepSeek-V4.1-Flash at scale with high throughput and low latency. We're sharing our production stack to help the community lower compute costs, reduce energy use, and make AI more affordable."
("介绍 DeepInfer——我们的自研推理框架,现已完全开源!以高吞吐、低延迟大规模驱动 DeepSeek-V4.1-Flash。我们分享生产级技术栈,帮助社区降低算力成本、减少能耗,让 AI 更便宜。")
但真正让这件事值得写一篇的,不是"又开源了一个框架",而是反转:18 个月前,DeepSeek 亲口说过——完整引擎,不开源。而这次,它把 README 的第一句话就写成了"powers DeepSeek's large-scale production services"(支撑 DeepSeek 大规模生产服务)——这不是"我们做了一个还不错的框架",这是"我们把印钞机的图纸公开了"。图纸和印钞机之间还差着三样东西(后面细说),但图纸本身的含金量,已经足够让 infra 圈连夜 clone 了。
18 个月前的"不",和今天的"开源"
2025 年 4 月,DeepSeek 发布过一份说明文档,标题就叫《The Path to Open-Sourcing the DeepSeek Inference Engine》("DeepSeek 推理引擎开源之路")。文档里写得很坦白:团队考虑过发布完整推理引擎,但最终决定不这么做。理由有三条:代码是一个重度定制的早期 vLLM 分支;和内部集群工具"紧耦合"(tightly coupled),剥离出来要伤筋动骨;小团队实在没有精力维护一个大型开源项目。当时的承诺是:不放完整引擎,但会把设计改进和精选组件以独立库的形式贡献给上游。
18 个月后,完整引擎直接上架 GitHub。仓库创建于 2026-10-16,10 月 20 日官宣时已有 9,740 stars、845 forks(均为当天抓取快照)——这个涨星速度,在 infra 类项目里属于"现象级",对比一下:很多成熟推理框架攒几年才到这个量级。README 的致谢章节还留着当年的诚实:
"DeepInfer was originally built primarily on vLLM, with additional inspiration from SGLang and TensorRT-LLM."
("DeepInfer 最初主要基于 vLLM 构建,另从 SGLang 和 TensorRT-LLM 获得灵感。")
我的判断:这次转向不是"良心发现",是算清楚了账。推理框架开源,动不了 DeepSeek 真正的护城河(服务端的 KV 缓存体系、流量调度、规模效应——后面会讲到哪些恰恰没开源),却能换来三样东西:生态话语权(让全世界的部署都围着 DeepSeek 的模型转)、人才引力(最好的 infra 工程师想玩最硬核的开源项目)、以及地缘层面的筹码——让 Ascend 成为生产级推理的一等公民,这一点下面单独说。以上是分析,不是 DeepSeek 官方说法。

这次开源到底给了什么:功能清单人话版
DeepInfer 目前只支持一个模型:DeepSeek-V4.1-Flash(本站 cycle80 刚发过它的模型发布篇,那是权重发布,这是推理框架,两件事,本文只把它当作"首发支持的唯一模型"一笔带过)。首次运行时会自动从 Hugging Face 下载 10 月 17 日的 checkpoint。功能清单是 DeepSeek 生产环境里真正在用的招数,逐条翻译成人话:
- 自研优化内核:FlashMLA、DeepGEMM、DeepEP、TileKernels、DeepSelect,外加 TileLang 写的定制内核。这是 DeepSeek 推理便宜的底层原因——把矩阵乘法、注意力、MoE 通信这些热路径用手写内核抠到极致。
- 并行策略:Attention 用 DP(数据并行)/ 均衡 CP(上下文并行),MoE 层用 EP(专家并行)+ EPLB(专家负载均衡)。人话:把一个大模型拆到很多卡上跑,还不让某些卡闲着某些卡累死。
- DSpark 推测解码:先用小模型(draft)往前猜几个 token,再用置信度估计决定何时验证。这是"投机采样"那一派的工程实现,解码加速的核心手段之一。
- SWA 有界回放:decoder 做 prefill 时只回放有界的后缀,省掉重复计算。
- 异步调度:CPU 的 batch 调度和设备执行重叠进行,默认开启,号称"零开销批调度"。
- Batch-invariant 推理:不管 batch 里还塞了谁的请求,你的输出结果都一样。对做评测、做回归测试的人来说,这是"可复现性"的刚需。
- 确定性采样:相同输入 token + 相同采样参数 + 固定种子 = 完全相同的输出。Agent 场景下调试"为什么这次结果不一样"时能救命。
- 结构化输出:强制生成结果符合 regex、JSON Schema 或 EBNF 文法。做 agent 工具调用的人都懂:不要"差不多像 JSON",要"一定是 JSON"。
注意两个带"(NVIDIA only)"后缀的功能:batch-invariant 和确定性采样目前只在 NVIDIA 侧实现,Ascend 侧还没跟上。双芯片首发不等于双芯片功能对等,这一点 README 写得很老实。
NVIDIA SM100 和华为 Ascend 950,并排写在同一行
README 的"Supported hardware"章节只有两行:
"Supported hardware:
NVIDIA SM100 GPUs
Huawei Ascend 950 NPUs"
SM100 是 NVIDIA Blackwell 这一代数据中心 GPU 的计算能力代号;Ascend 950 则是华为昇腾系列的高端 NPU。构建要求也分两条线:NVIDIA 侧要 CUDA 13,Ascend 侧要 CANN 9.2,外加 Linux、GCC ≥ 13.0、Python 3.12。
这一行的分量在于:这是第一个把 Ascend 950 当作首发一等公民的生产级推理框架。过去一年,昇腾生态最缺的从来不是纸面算力,而是"能在上面跑生产流量的软件"。DeepSeek 上个月刚发布了核心库的 Ascend 版本,创始人又在公开场合推动"用国产芯片训练最大模型",DeepInfer 是这条线上的第三块拼图。对国内做私有化部署的团队来说,这意味着以后"国产卡跑开源推理栈"有了一个真正在生产环境验证过的选项——而不是 demo 级别的适配。
地缘层面的另一面是:就在 DeepInfer 官宣的前一天,美国方面刚把 DeepSeek 列入联邦民事机构禁用名单,禁令覆盖"基于 DeepSeek 实现开发的第三方产品和服务",但没有点名具体产品,也没说开源代码算不算在内。本站 cycle80 已经发过那篇禁令报道,这里只作背景提一句:一边是联邦禁令,一边是 Apache-2.0 全面开源——"技术开源"和"部署禁令"在同一周里上演,这种张力本身就是 2026 年 AI 地缘的缩影。禁令细节不展开,有兴趣的去看 cycle80 那篇。
多说一句为什么这个时间点耐人寻味:禁令针对的是"部署",开源针对的是"技术扩散"。美国政府可以不让联邦机构用 DeepSeek 的服务,但它拦不住全世界的工程师 git clone 一个 Apache-2.0 的仓库。开源许可证的管辖逻辑和出口管制的管辖逻辑,在这里是两套平行系统。DeepSeek 显然算过这笔账——当你的技术注定会被"去风险化"挡在门外时,把技术变成人人可用的公共品,反而是最强的反制。以上是分析,非官方表态。
没开源的三样东西:真正的护城河
DeepSeek 在 README 里相当坦荡地列出了"一个完整推理服务还需要、但本次不包含"的三样东西:
- KV 缓存系统;
- Prefill / Decode 解耦部署("引擎侧大部分必需功能已经实现");
- 跨数据并行副本的负载均衡(prefill 和 decode 都要)。

我的判断:这三样恰恰是把"一个很快的引擎"变成"一个很便宜的公开 API"的关键。KV 缓存决定长上下文的成本,PD 解耦决定吞吐/延迟的 trade-off 能压到多低,负载均衡决定集群利用率。换句话说,DeepSeek 开源了"做得快"的部分,留下了"卖得便宜"的部分。想复制 DeepSeek 定价的公司,要么自己造这三样轮子,要么回头去借 vLLM / SGLang 的。这不叫"开源了个寂寞"——引擎层的优化内核和调度策略本身就有巨大价值;但确实要清醒:开源的是配方,不是餐厅。
从 2025-04 到 2026-10:中间的 18 个月发生了什么
把时间线拉开看,这次反转不是凭空发生的。2025 年 2 月,DeepSeek 搞过一次"开源周"(Open Source Week),陆续放出了 FlashMLA、DeepEP、DeepGEMM 等一批独立组件——正好兑现了 4 月说明文档里"把精选组件贡献给上游"的承诺。这些组件每一个单拎出来都是硬货:FlashMLA 是 MLA 注意力机制的高效实现,DeepEP 是 MoE 专家并行的通信库,DeepGEMM 是 FP8 通用矩阵乘法库。换句话说,过去一年半,DeepSeek 其实一直在"切香肠式"地开源——先放零件,再放整机。
另一条线是芯片。上个月(2026 年 9 月),DeepSeek 发布了核心库的 Ascend 版本;创始人也在公开场合推动"用国产芯片训练最大规模模型"。DeepInfer 把 Ascend 950 写进首发支持列表,是这条线的自然延续:先有训练侧的适配,再有推理侧的框架,昇腾的软件栈正在被一块一块补齐。
还有一条线是 HN 社区的情绪。DeepInfer 官宣当天冲上 HN 首页第一,356 points——这个数字说明的不只是"DeepSeek 粉丝多",而是 infra 圈对"生产级推理栈开源"的真实饥渴。vLLM、SGLang 这些社区框架很好,但它们是"通用框架";DeepInfer 是"一家把推理成本打到全行业最低的公司,它自己用的那套"。这种"生产验证"的含金量,在 infra 世界里是硬通货。
vLLM、SGLang、TensorRT-LLM 之后的"第四极"?
推理框架这个赛道现在是三足鼎立:vLLM(UC Berkeley 出身,生态最广)、SGLang(伯克利 LMSYS 系,结构化生成和调度见长)、TensorRT-LLM(NVIDIA 亲儿子,Blackwell 新特性跟进最快)。DeepInfer 的 README 致谢里把三家都点了名,姿态放得很低:"最初主要基于 vLLM,从 SGLang 和 TensorRT-LLM 获得灵感"。
但低调归低调,DeepInfer 的差异化是真实存在的。首先,它是为 MoE 而生的:DeepSeek-V4.1-Flash 这类 MoE 模型的推理,瓶颈在专家并行通信(DeepEP)和负载均衡(EPLB),通用框架对这一块的优化远不如 DeepSeek 自己的手写内核。其次,它是为"便宜"而生的:DSpark 推测解码、SWA 有界回放、异步调度,每一项都是冲着"单位 token 成本"去的,而不是冲着"峰值吞吐数字好看"去的。
我的判断:DeepInfer 短期内不会取代 vLLM 的生态位——它现在只支持一个模型、只支持两款芯片,通用性差了两个量级。但它会改变一件事:以后任何推理框架谈"成本优化",都要先回答"DeepInfer 那套你学了没"。它把 DeepSeek 的生产 know-how 变成了公开课教材,vLLM 和 SGLang 的维护者大概率会反向吸收其中的调度思想。最终受益的是所有部署模型的人。
还有一个值得玩味的细节:DeepInfer 的 benchmark 是在 4 张 SM100 上测 prefill、64 张上测 decode——"each within one scale-up domain"(同一高速互联域内)。这个测试配置本身就在传递信息:DeepSeek 的生产部署是按"大 decode 集群 + 小 prefill 集群"来切分的,这正是 PD 解耦(恰恰是没开源的那部分)的典型形态。开源代码里"most required engine functionality is already implemented"(引擎侧大部分必需功能已实现)这句话,等于官方承认:解耦的引擎能力给了,集群编排没给。想抄作业的,先把网络拓扑搞明白。
技术黑话翻译:这几个词到底在说什么
DeepInfer 的功能清单里有几个词,不搞 infra 的人第一眼会晕。这里用人话翻译一遍——因为理解它们,就是理解"你的 agent 为什么这么贵/这么慢"的钥匙。
推测解码(Speculative Decoding / DSpark):大模型生成 token 是一个一个往外吐的,每吐一个都要过一遍几百亿参数,慢就慢在这里。推测解码的思路是:先让一个又小又快的"草稿模型"一口气猜出后面 5 个 token(DEEPINFER_USE_NEXTN_DECODE 默认就是 5),再让大模型一次性验证这 5 个猜得对不对,对的留下、错的回滚。猜对的比例越高,加速越明显。人话:让实习生先写初稿,专家只负责审稿——审稿比从头写快得多。你的 agent 如果一次要生成几千 token 的长回复,推测解码直接决定它的体感延迟。
Batch-invariant(批不变性):推理服务为了省钱,会把很多用户的请求拼成一个 batch 一起算。但拼 batch 会引入浮点运算顺序的变化,导致"同一个请求,单独跑和拼着跑,结果有细微差别"。DeepInfer 保证:不管 batch 里还塞了谁,你的输出 bit 级一致。为什么 vibe coder 要关心?因为你在做 agent 的回归测试时,如果底座推理本身就有抖动,你根本分不清是 prompt 改坏了还是 infra 在抖。可复现性是 eval 的地基,DeepSeek 把它做成开关(DEEPINFER_BATCH_INVARIANT=1),说明他们在生产里吃过这个亏。
MoE 并行(EP + EPLB):MoE 模型有几百个"专家"子网络,每个 token 只激活其中几个。推理时要把专家分到不同卡上(专家并行 EP),麻烦的是:某些专家特别受欢迎,流量全涌过去,那张卡就成了瓶颈。EPLB(专家负载均衡)就是动态把热门专家复制/迁移,让负载摊平。人话:食堂打饭,哪个窗口人多就多开几个窗口。DeepSeek-V4.1-Flash 这类 MoE 模型能卖得便宜,EPLB 是幕后功臣之一。
KV 缓存(没开源的那个):模型生成第 N 个 token 时,前面 N-1 个 token 的注意力计算结果可以存下来复用,这就是 KV 缓存。长对话、长上下文的 agent 场景里,KV 缓存的命中率直接决定成本。DeepSeek 没开源它——也合理,这是"便宜"的最后一公里,也是各家推理服务商真正的看家本领。vLLM 的 PagedAttention 当年就是靠把 KV 缓存管好而封神的,这个领域永远有新故事。
想上手?先看这份清单
如果你被说动了想亲手跑一下,README 给的门槛很实在,先对照:
- 系统:Linux(没提 macOS/Windows,别挣扎);
- 工具链:GCC ≥ 13.0、Python 3.12;
- 加速器二选一:NVIDIA 侧 CUDA 13,Ascend 侧 CANN 9.2,构建前用
DEEPINFER_ACCELERATOR环境变量二选一(nvidia或ascend); - 构建:
./build.sh从源码编译; - 跑起来:
python examples/offline_inference.py,首次运行自动从 Hugging Face 拉 DeepSeek-V4.1-Flash 的 10-17 checkpoint(也可以用DEEPINFER_HF_MODEL_DIR指向本地权重)。
给 vibe coder 的三条实操建议:第一,先跑 deterministic 模式(DEEPINFER_BATCH_INVARIANT=1 + 固定 seq_seed),把"可复现"作为 baseline,再开性能优化——调优一个不可复现的系统是灾难;第二,先玩结构化输出(so_args 传 JSON Schema),这是 agent 场景里投入产出比最高的功能,半小时就能验证价值;第三,别急着上生产,记住没开源的三件套——KV 缓存、PD 解耦、负载均衡,真要做服务化,得自己补课或者等社区生态跟上。
另外提一句:仓库里还有 eval/ 目录和中文 Q&A 文档(据二手报道,Q&A 里有 DeepSeek 自己的生产数据,比如单集群日均 token 量级的描述)。这些材料值得精读——看一个顶级团队怎么做 eval,比看 benchmark 数字本身更有营养。但注意:凡是没亲开验证的数字,本文一律不引用,有兴趣的自己去仓库里翻。
对 vibe coder 的实在意义:推理成本就是 agent 成本
这篇不写给 infra 工程师,写给每天调 agent 的人。为什么一个推理框架的开源值得 vibe coder 花十分钟读完?
第一,推理成本 = agent 成本。你的 agent 每多跑一轮工具调用、每多一次自我反思,烧的都是推理侧的 token 和延迟。理解推理栈里"投机解码""batch 调度""KV 缓存"这些概念,不是为了让你去写 CUDA,而是为了让你在选模型、设 temperature、做私有化部署、谈 API 折扣时,知道钱到底花在哪一层。
第二,确定性和可复现性是 agent 工程的前置知识。DeepInfer 把 batch-invariant 和确定性采样做成一等功能,说明 DeepSeek 自己在生产里被"同样的请求跑出不一样的结果"折磨过。你在本地 eval agent 时遇到的 flaky 测试,根子常常在采样层,而不是 prompt 写得不好。
第三,Apache-2.0 意味着可以直接商用。如果你在给客户做私有化部署,或者你的 SaaS 想把推理成本打下来,DeepInfer 是一个可以合法拿去改、拿去卖的选择——只要你的卡是 SM100(Blackwell)或 Ascend 950。上手门槛是 Linux + Python 3.12 + 从源码构建(./build.sh),README 里连 benchmark 复现脚本(run_sweep.sh)都给了。官方 benchmark 是在 4 卡上测 prefill、64 卡上测 decode(同一 scale-up 域内),这个量级普通人复现不了,看个趋势就好——厂商自测数据,照例打折看。
最后说一句大实话:DeepInfer 今天只支持 DeepSeek-V4.1-Flash 一个模型。你要是想拿它跑别的开源模型,目前还不行。但方向很清楚——当"最便宜的推理栈"开源了,"最便宜的 API 价格"迟早会被人用它打下来。做 agent 应用的人,成本曲线向下走永远是好消息。
回头看这 18 个月:2025 年 4 月说"不",是因为代码和内部工具缠得太紧、团队太小;2026 年 10 月说"开源",是因为零件已经放了一年半、Ascend 的线已经铺好、生态位值得一争。DeepSeek 的算盘打得很精——开源的是"快",留下的是"便宜";给出去的是"配方",攥在手里的是"餐厅"。但这不妨碍 DeepInfer 成为今年含金量最高的 infra 开源之一:当全世界都在谈论模型越来越聪明时,DeepSeek 把"让聪明变便宜"的那套东西,直接交到了所有人手上。对于每天为 agent 账单皱眉的 vibe coder 来说,这比又发一个新模型实在得多。
FAQ:你可能想问的五个问题
Q1:DeepInfer 和 vLLM 是什么关系?会取代 vLLM 吗?
A:README 原文写得明白——"最初主要基于 vLLM"。它是 vLLM 的重度定制分支,不是重写。短期内取代不了:vLLM 支持几十种模型、各种硬件,DeepInfer 只支持一个模型、两款芯片。但长期看,DeepInfer 的调度思想会被 vLLM/SGLang 反向吸收。生态竞争的赢家通常是"通用性",不是"单项冠军"。
Q2:我没有 SM100,也没有 Ascend 950,能用吗?
A:目前不能。README 的硬件列表就两行,没有消费级显卡、没有 AMD、没有老款 A100/H100。这是"生产框架"不是"玩具",目标用户就是有机房的人。个人开发者现阶段更适合读它的代码和文档学思想,而不是真去部署。
Q3:Apache-2.0 协议,我拿去商用、改完闭源卖钱,可以吗?
A:可以。Apache-2.0 允许商用、修改、分发,包括闭源商用,只需要保留版权声明和许可证文本。但注意:许可证解决的是"代码"问题,不解决"模型权重"和"合规"问题——V4.1-Flash 权重的许可另看模型发布条款,在美国联邦政府场景下还有 DHS 禁令的合规问题(见下)。
Q4:以后会支持更多模型吗?
A:官方没说。本文不猜测。值得观察的信号是:仓库的 deepinfer/ 目录结构、doc/ 文档后续是否出现多模型抽象。如果 DeepSeek 想把 DeepInfer 做成生态入口,扩模型支持是必经之路;如果只想服务自家模型,那它就是个"参考实现"。两种剧本都合理,看后续 commit。
Q5:DHS 禁令和这次开源冲突吗?美国公司能用 DeepInfer 吗?
A:先说事实:DHS 禁令(本站 cycle80 已报道)针对的是联邦民事机构的部署,覆盖"基于 DeepSeek 实现开发的第三方产品和服务",但没有点名具体产品,也没明确"开源代码"算不算在内。Apache-2.0 本身不限制任何人使用。所以"能不能用"取决于"你是谁、卖给谁":普通公司自用,许可证层面没问题;想卖给美国政府,先找律师。本文不是法律建议,只陈述公开信息。
透明度注记
- 仓库 star 数(9,740)、fork 数(845)、HN 首页排名与 points(#1 / 356),均为 2026-10-20 当天抓取/侦察快照,会随时间变化。
- DeepSeek 官方 X 四连帖:X 平台需登录,本人未能亲开页面,官宣引文转引自 madrobot.blog 2026-10-20 的报道;该博客同时交叉验证了 2025-04 说明文档的存在与内容。
- 2025-04《The Path to Open-Sourcing the DeepSeek Inference Engine》说明文档:本人未亲开原文,其存在与核心内容("考虑过但决定不发布完整引擎,改为向上游贡献组件")由 dig.watch 2025-04-16 报道与 madrobot.blog 2026-10-20 报道交叉确认。
- 文中"转向动机""护城河"等段落为作者基于公开信息的分析判断,已用"我的判断"标出,非 DeepSeek 官方表态。
- 性能 benchmark 图表为 DeepSeek 官方自测(README 原图),未见第三方独立复现,引用时请注意。
评论 (0)
原始来源
相关文章
针对 DeepSeek 的 DHS 排除令 7 月 24 日就已签署,直到 10 月 20 日才公开披露;其“连坐”条款覆盖关联公司与基于 DeepSeek 实现构建的第三方产品。开源权重撞上联邦采购:模型血缘从此成为合规审查项。
Tenstorrent 以 62 亿美元估值完成 15 亿美元 E 轮,为开放权重 AI 推理造芯片——并拒绝 50 亿美元收购选择独立。加上同月发布的微软 Maia 300 与亚马逊 TorchNeuron,挑战 Nvidia 的三条路线已经摆上台面。
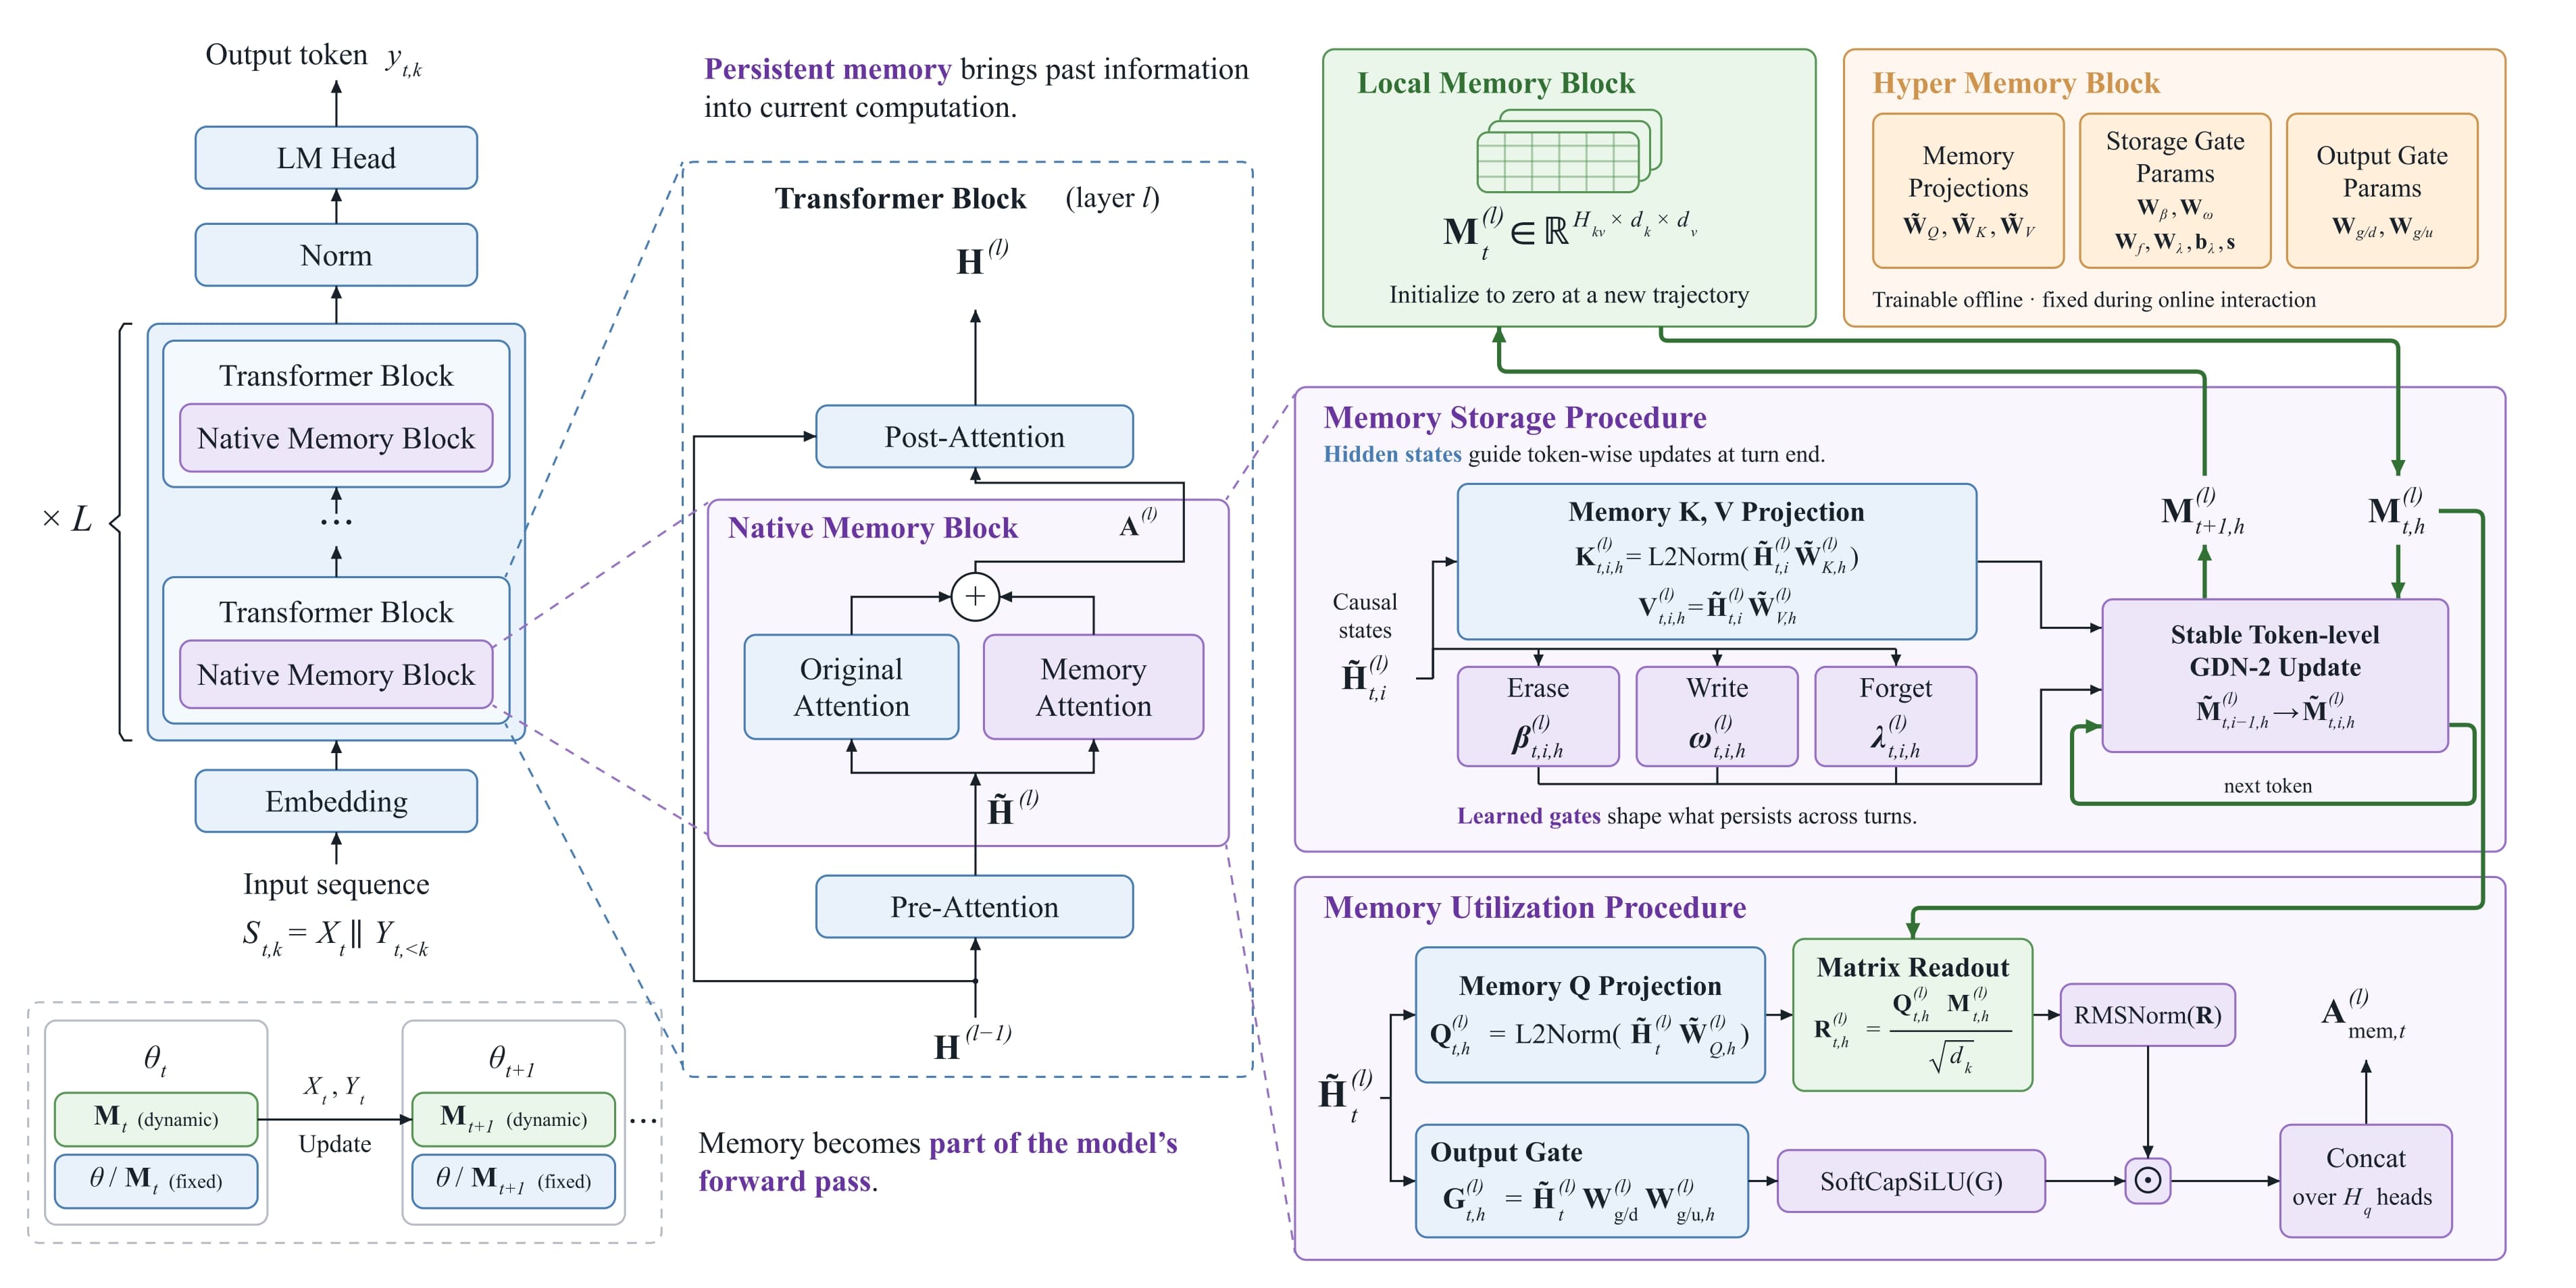
中国团队记忆张量发布并开源记忆原生大模型 MemT-1.0:把可持续存在、可更新的内部记忆做进前向传播,GDN-2 逐 token 更新、MoS 混合存储扩容,Nano(36B)与 Flash(288B)两款。团队亲口承认细节检索上外挂文本方案仍领先;许可证为 PolyForm 非商业——可免费玩,不可商用。