记忆张量开源 MemT1.0:把记忆做进前向传播的记忆原生大模型
中国团队记忆张量发布并开源记忆原生大模型 MemT-1.0:把可持续存在、可更新的内部记忆做进前向传播,GDN-2 逐 token 更新、MoS 混合存储扩容,Nano(36B)与 Flash(288B)两款。团队亲口承认细节检索上外挂文本方案仍领先;许可证为 PolyForm 非商业——可免费玩,不可商用。
10 月 20 日,中国团队记忆张量(MemTensor)正式发布并开源了 MemT-1.0:一个"记忆原生"的记忆基础模型系列。官方仓库的自我介绍只有一句话,但信息量极大:"MemT-1.0 is a new generation of memory foundation models that makes persistent, dynamically evolving memory an intrinsic part of model computation."(MemT-1.0 是新一代记忆基础模型,它让持久、可动态演化的记忆成为模型计算的内在组成部分。)
翻译成人话:以前的模型是"金鱼脑"——每次对话从零开始,所谓的记忆全靠外挂(把聊天记录塞进上下文、或者 RAG 检索)。MemT-1.0 把记忆做进了前向传播本身:模型在生成每一个 token 的同时,读写一套固定体积的内部记忆状态。这不是给模型配了个笔记本,而是把"会记住"写进了模型的骨子里。
这篇文章的证据口径先说清楚,因为这事关你怎么读每一个数字:架构、参数、训练数据、许可证来自官方 GitHub 仓库 README 与技术报告(arXiv:2610.26825,10 月 19 日提交)的一手亲读;SWE-bench 的 66.07%→69.73%、256K 下 3.99 倍加速等数字,是团队官方发布口径经澎湃、环球网、上观、网易智能等多家媒体同日转述——多家数字完全一致,但技术报告全文的对应表格我尚未独立核验,正文会逐处标注。
架构:记忆注意力与主干注意力并行跑
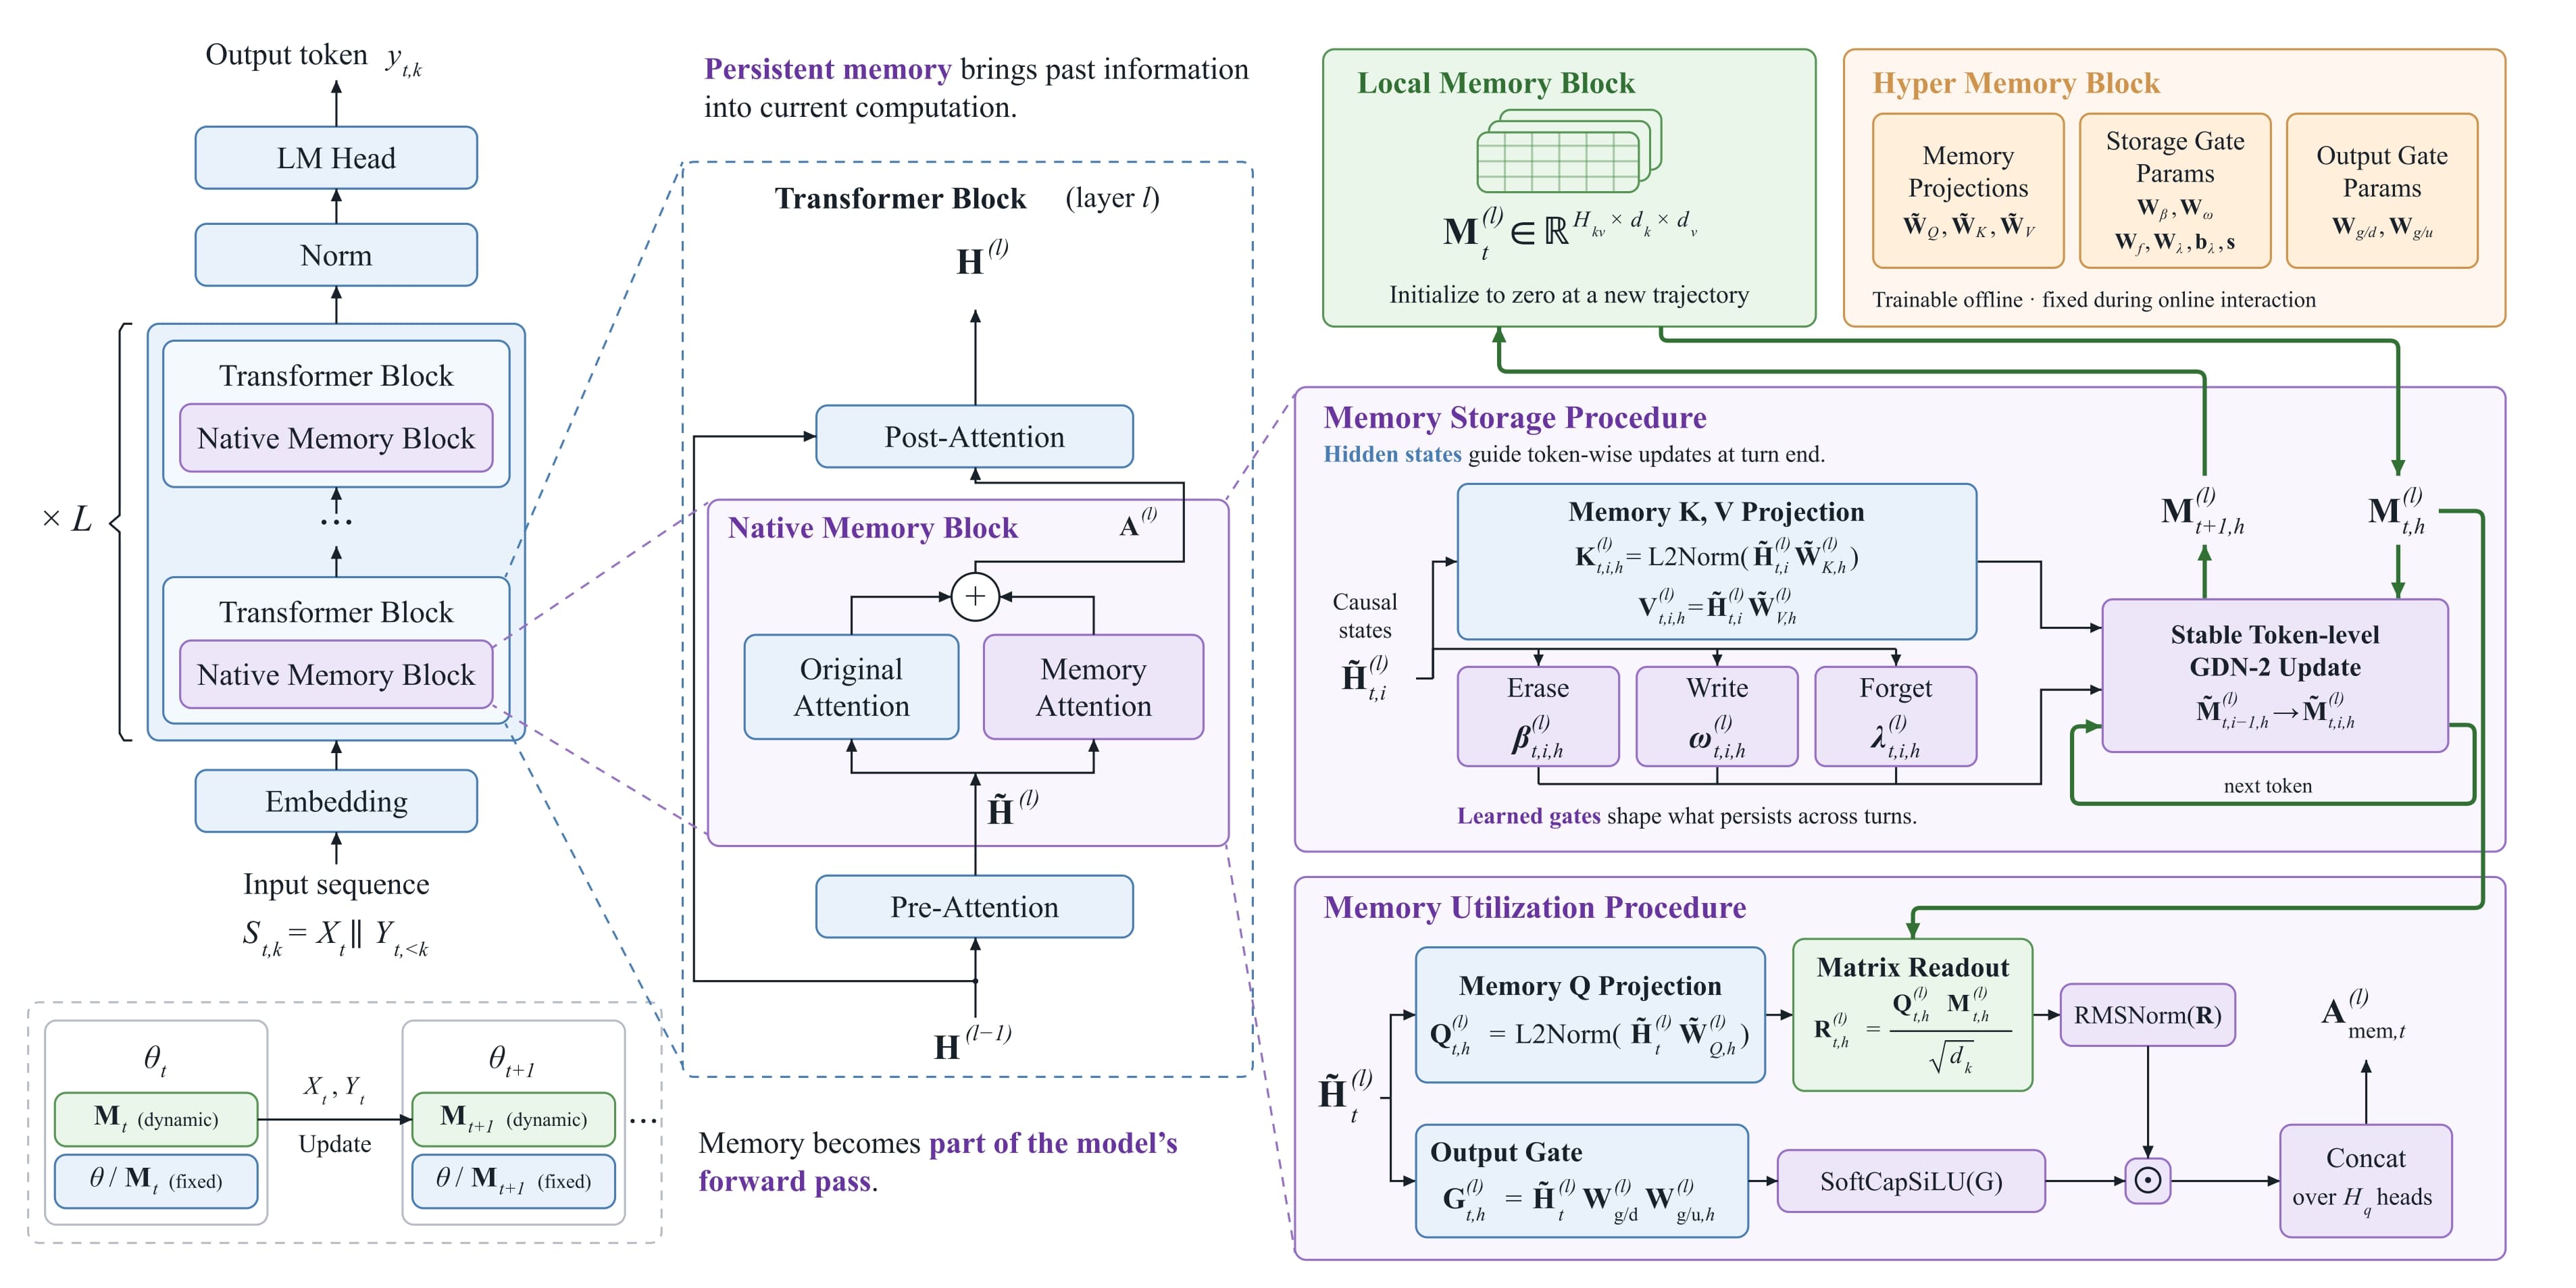
MemT-1.0 的核心是一个 Native Memory Block(原生记忆块),它与主干网络的注意力机制并行运行。生成时,记忆注意力从当前记忆状态中读取、归一化、门控,把读出的结果加到主干注意力的输出上;每轮对话结束(或每个片段结束),用 GDN-2(Gated DeltaNet-2) 做 token 级别的稳定记忆更新——擦除、写入、遗忘三件套,把新信息融进已有记忆。
记忆块内部又分两层:Local Memory Block 维护一个动态的多通道记忆矩阵,随交互步骤演化;Hyper Memory Block 则装着可训练的记忆查询/键/值投影和擦除、写入、遗忘、输出门控。容量扩展靠 Mixture-of-Storage(MoS,混合存储):把记忆模块扩展成多个"记忆专家"做稠密路由——基座 MoE 管计算,MoS 管"记在哪、怎么记"。
训练分两阶段,总共 340 亿 token:先继续预训练让模型学会"用过去预测未来",再做后训练请"学霸"教师模型给记忆提取打分、用误差倒逼改进。用官方的话说,取舍能力(什么该留、什么该忘)不是天生的,是 340 亿 token 硬练出来的。
这次开源了两款:MemT-1.0-Nano(底座 Qwen3.6-35B-A3B,总参数 36B、激活 3B、可训练记忆参数 4.51 亿、动态记忆状态 1000 万)和 MemT-1.0-Flash(底座 DeepSeek-V4-Flash,总参数 288B、激活 17B、可训练记忆参数 36.1 亿、动态记忆状态 3.36 亿)。注意这个选型:Nano 拿 Qwen 系底座、Flash 拿 DeepSeek 系底座——国产底座 + 国产记忆架构,技术栈的"中国含量"是拉满的。
评测:先看官方怎么说,再看官方没说什么
先看一手确认的部分。官方 README 写明:在 11 项记忆基准上,Flash 和 Nano 在"被评估的参数化记忆方法"中分列第一、第二。这个限定词很重要,官方自己紧接着补了一句大实话:"Strong textual-memory systems remain ahead overall, particularly on long histories that require detailed evidence retrieval."(强大的文本记忆系统总体上仍然领先,尤其是在需要细节证据检索的长历史任务上。)——团队亲口承认:拼细节检索,外挂文本方案目前还是更强。这种"报喜也报忧"的写法,在官方 README 里并不多见,值得一个好评。
技术报告摘要一手确认的效率数字:在 128K 历史长度下,MemT-1.0-Nano 相对完整上下文 KV 缓存实现约 1.86 倍端到端推理加速,持久化存储缩减约 66 倍。这是"固定体积记忆状态"带来的结构性优势:历史再长,记忆状态就那么大,不用像 KV 缓存那样随上下文线性膨胀。

以下数字为团队官方发布口径、经多家媒体同日转述*(多家报道数字完全一致,但技术报告全文表格尚未独立核验):11 项记忆基准 Flash 平均 50.6、Nano 平均 47.0;SWE-bench Verified 500 项任务上,Nano 平均成功率从 66.07% 提升到 69.73%*,三次全部成功的任务比例从 54.00% 提高到 62.80%;SWE-bench Multilingual 从 60.00% 提升到 63.56%*;256K 历史下端到端加速约 3.99 倍*,查询首字延迟 104–112 毫秒(完整上下文方案在 256K 下约 445 毫秒);256K 历史下每条会话的记忆状态约 40 MiB,相对传统方案的 5.06 GiB 缩减约 130 倍*。
读这组数字要抓住两个关键限定。第一,SWE-bench 的提升来自"经验引导的智能体编程"(Experience-Guided Agentic Coding)框架:由执行框架在关键断点触发经验写入,检索到的 procedural experience(过程性经验)存进原生记忆,在执行中通过记忆注意力调用——不把经验文本塞进任务上下文。也就是说,涨的这 3.66 个点,涨的是"会复用历史解题经验"的部分,而不是模型本身变聪明了。第二,66.07%→69.73% 的基线和实验组用的是同一套执行框架,变量控制得还算干净;但"三次全对比例 54%→62.8%"这个指标说明,记忆带来的更大价值可能是稳定性——重复跑不翻车,对真实工程场景比单次高分更实在。
为什么"记忆原生"可能是个大方向
先说判断:记忆是 coding agent 的头号痛点,而"参数化记忆 vs 外挂检索"的路线之争,可能是 2026 年下半场最重要的架构辩论之一。
vibe coder 每天都在被记忆问题折磨:开一个新会话,agent 就把你项目的约定全忘了;上下文窗口塞满历史,token 账单爆炸,还把真正重要的信息淹没在闲聊里。现在的解法全是外挂式的——RAG 检索、memory bank、把历史摘要再喂回去。这些方案有个共同天花板:记忆和推理是两套系统,检索到的东西还得再翻译一遍给模型"看",中间每一步都在丢信息、烧 token。
MemT-1.0 赌的是另一条路:让记忆成为前向传播的一部分,检索和推理在同一个计算图里完成。技术报告里有个很硬核的"闭卷"测试*(经媒体转述技术报告内容):用户先给展览原定时间、后改到周日、中间还随口提了个没被采纳的周一备选,然后东拉西扯 500 多轮、攒下约 6.6 万 token 的聊天记录。传统外挂检索面对这种"多版本、长跨度"的信息极易翻车,但 MemT-1.0 在完全脱离原始文本的情况下,准确报出了原定与改期时间,还明确指出场地、票价、联系人没变——把"周日定论"和"周一备选"分得清清楚楚。另一个细节:16K token 历史里被问到从没提供过的生日,模型老实回答不知道,没有瞎编。知之为知之——这恰恰是"记忆"和"幻觉"之间那条最关键的线。
当然,官方自己也承认文本记忆系统在细节检索上仍然更强。所以更准确的定位是:MemT-1.0 不是 RAG 的替代品,而是"高频、结构化、可演化"的经验记忆层。什么该进参数化记忆(你的编码习惯、项目的隐性约定、反复出现的解题套路),什么该走外挂检索(精确的 API 文档、某次报错的完整堆栈)——这个分层,恰恰是 vibe coder 接下来要亲手实践的架构课。
许可证:先泼一盆必要的冷水
中文媒体通稿里写的都是"发布并开源",但官方 README 的许可证章节值得逐字读。仓库软件用的是 PolyForm Noncommercial License 1.0.0——商业用途不被允许,商用需要单独联系作者谈授权;技术报告用的是 CC BY-NC-SA 4.0。也就是说,这是"源代码可见、免费可玩、但不可商用"的开源,不是 OSI 定义下的开源软件。
这个提醒不是挑刺,而是直接决定你能拿它干什么:个人学习、跑 demo、做实验——随便玩;但想把它集成进你收费的产品里,先谈商用授权。另外,模型权重、数据集、benchmark 资产"Unless explicitly stated otherwise…not covered by the licenses above",对应条款随各发布物另行说明——权重下回来先看 HF 页面上的 license 卡,别默认跟代码同协议。
还有一个小注脚:仓库声明里联系邮箱是 lizy@memtensor.cn,技术报告 74 位作者署名 MemTensor Team,带头的是李志宇——正是此前 MemOS 项目的负责人。从 MemOS(记忆操作系统,解决"记忆如何调度")到 MemT-1.0(记忆原生模型,解决"记忆如何内化"),这条产品线是一脉相承的:先做外挂的记忆 OS,再把记忆做进模型权重里。理解了这条线,就不会把 MemT-1.0 和 MemOS 搞混——一个是框架,一个是模型;一个管调度,一个管内化。(也顺带划清:北大南洋理工那篇 Mem-T 论文和 yanweiyue/Mem-T 仓库是另一个团队的记忆智能体项目,跟记忆张量无关,别被名字绕进去。)
能怎么玩:Nano 是 36B,是真的可以上手摸的
对 vibe coder 最友好的消息是 Nano 只有 36B 总参数、激活 3B——这是今天单机/小集群能够得着的体量。官方给了基于 SGLang 的推理栈:inference 目录装 server 端,memt_sglang 客户端连上去就能开"带记忆的对话";save_state() 可以把记忆状态存成快照,下次 state= 恢复——记忆第一次变成了可以存盘、可以版本管理的文件,而不是锁在某个 SaaS 账号里的黑盒。
值得试的三个实验:第一,跑那个"500 轮展览改期"的闭卷测试的简化版,亲手验证"固定体积记忆"到底会不会丢细节;第二,对比同一任务下"开记忆"和"关记忆"(enable_memory=False 就是标准聊天模式)的输出差异,看看经验复用真实发生在哪类任务上;第三,测一下长历史下的首字延迟——104 毫秒这个数字如果复现得出来,对"常驻后台的个人 agent"这类产品形态是实质性利好。
但也要管理预期:186 个 star(发稿时)、2 个 commit 的仓库,生态刚起步;Flash 的 288B 需要正经的集群;所有漂亮数字里带星号的那些,都等技术报告全文和第三方复现。现在最好的姿势是:把 Nano 当学习标本,把"记忆原生"当架构课来上——至于它会不会成为下一代 agent 的标准底座,让子弹飞一会儿。
结尾的判断
MemT-1.0 真正重要的不是某一个 benchmark 分数,而是它把一个争论从口水变成了可下载的权重:记忆到底该是外挂,还是该是模型本身的一部分?官方用 340 亿 token 的训练、66 倍的存储缩减、SWE-bench 上 3.66 个点的提升*,给"原生派"交了一份阶段性答卷——同时亲口承认,在细节检索上外挂派依然领先。这种"带着边界感的激进",比满篇的 SOTA 更可信。
对 vibe coder 来说,短期可抄的作业有三件:理解"参数化记忆 vs 外挂检索"的分层(什么该记进权重、什么该走检索);关注 save_state 这种"记忆可存盘"的工程范式——它可能改变个人 agent 的数据形态;以及记住 PolyForm Noncommercial 这条线,玩可以,商用先谈授权。长期的问题留给时间:当记忆真的成了前向传播的一部分,"调 agent"这件事,会不会从"写更好的 prompt"变成"养更好的记忆"?
透明度说明:架构、模型参数、训练数据、许可证、128K 下 1.86×/66× 来自官方 GitHub 仓库 README 与技术报告 arXiv:2610.26825 摘要的一手亲读(仓库创建于 2026-10-19,窗口内);带 * 的数字(SWE-bench 66.07%→69.73%、Multilingual 60.00%→63.56%、256K 下 3.99×、40 MiB/5.06 GiB、500 轮闭卷测试细节)为团队官方发布口径经多家媒体(澎湃/环球网/上观/网易智能)同日转述,多家数字一致,但技术报告全文对应表格尚未独立核验;Hugging Face 权重合集为媒体转引的官方链接(huggingface.co/collections/MemTensor/memt-1),仓库 README 含官方 Hugging Face 徽章链路。
评论 (0)
原始来源
相关文章
Google Research 开源递归智能体脚手架框架 Harness²:模型权重全程冻结,通过任务级 Propose–Probe–Compose 与脚手架级经验沉淀两层递归自我优化。8 个可编辑组件是 vibe coder 可直接抄的作业;官方报告三项基准最高提升 11.5 个点(团队自测*),本地 demo 无需模型凭证即可跑。
doubleAI 完成2亿美元 A 轮(Lightspeed 与 Bessemer 共同领投,NVIDIA、Dell 跟投),发布首个代码执行模型 Maxwell:不写源码、直接改写运行时二进制,且每次改写都有形式化验证背书。coding agent 为程序员打工,CEM 为机器打工。
DeepSeek 在 10 月 20 日开源了支撑其生产服务的推理框架 DeepInfer(Apache-2.0),首发支持 NVIDIA SM100 与华为 Ascend 950——距离它 2025 年 4 月亲口说“不开源完整引擎”仅 18 个月。本文逐条拆解开源了什么、没开源什么,以及为什么推理成本就是 agent 成本。