Google Research 开源 Harness²:模型冻结,让脚手架自己进化
Google Research 开源递归智能体脚手架框架 Harness²:模型权重全程冻结,通过任务级 Propose–Probe–Compose 与脚手架级经验沉淀两层递归自我优化。8 个可编辑组件是 vibe coder 可直接抄的作业;官方报告三项基准最高提升 11.5 个点(团队自测*),本地 demo 无需模型凭证即可跑。
10 月 6 日,Google Research 在 GitHub 上悄悄推了一个仓库:harness2。没有发布会,没有博客造势。两周后,它攒下了 1.4 万个 star,被 Hacker News 创始人亲自下场发帖讨论。它的主张只有一句话,却足够让所有做 agent 的人停下来想一想:模型权重冻结不动,让"脚手架"自己进化。
过去一年,agent 能力的提升几乎完全押在"更大的模型"上:换更强的基座,分数就往上走。但 Google Research 这次把赌注押在了另一条曲线上——模型不变,优化模型周围的那套系统。仓库 README 开宗明义:"A harness is the system around a model that enables it to act as an agent: prompts, tools, memory, skills, orchestration, and more. Harnessing is the process of optimizing that system."(脚手架,是让模型得以作为 agent 行动的周边系统:提示词、工具、记忆、技能、编排等等。"脚手架工程",就是优化这套系统的过程。)
这篇文章想讲清楚三件事:Harness² 的两层递归到底在干什么、8 个可编辑组件里哪些是 vibe coder 今天就能抄的作业,以及它的 benchmark 数字该怎么冷静地读——因为那些数字全部来自团队自测,文末会逐项标注。
两层递归:任务里进化,当下这局;任务外进化,局局之间
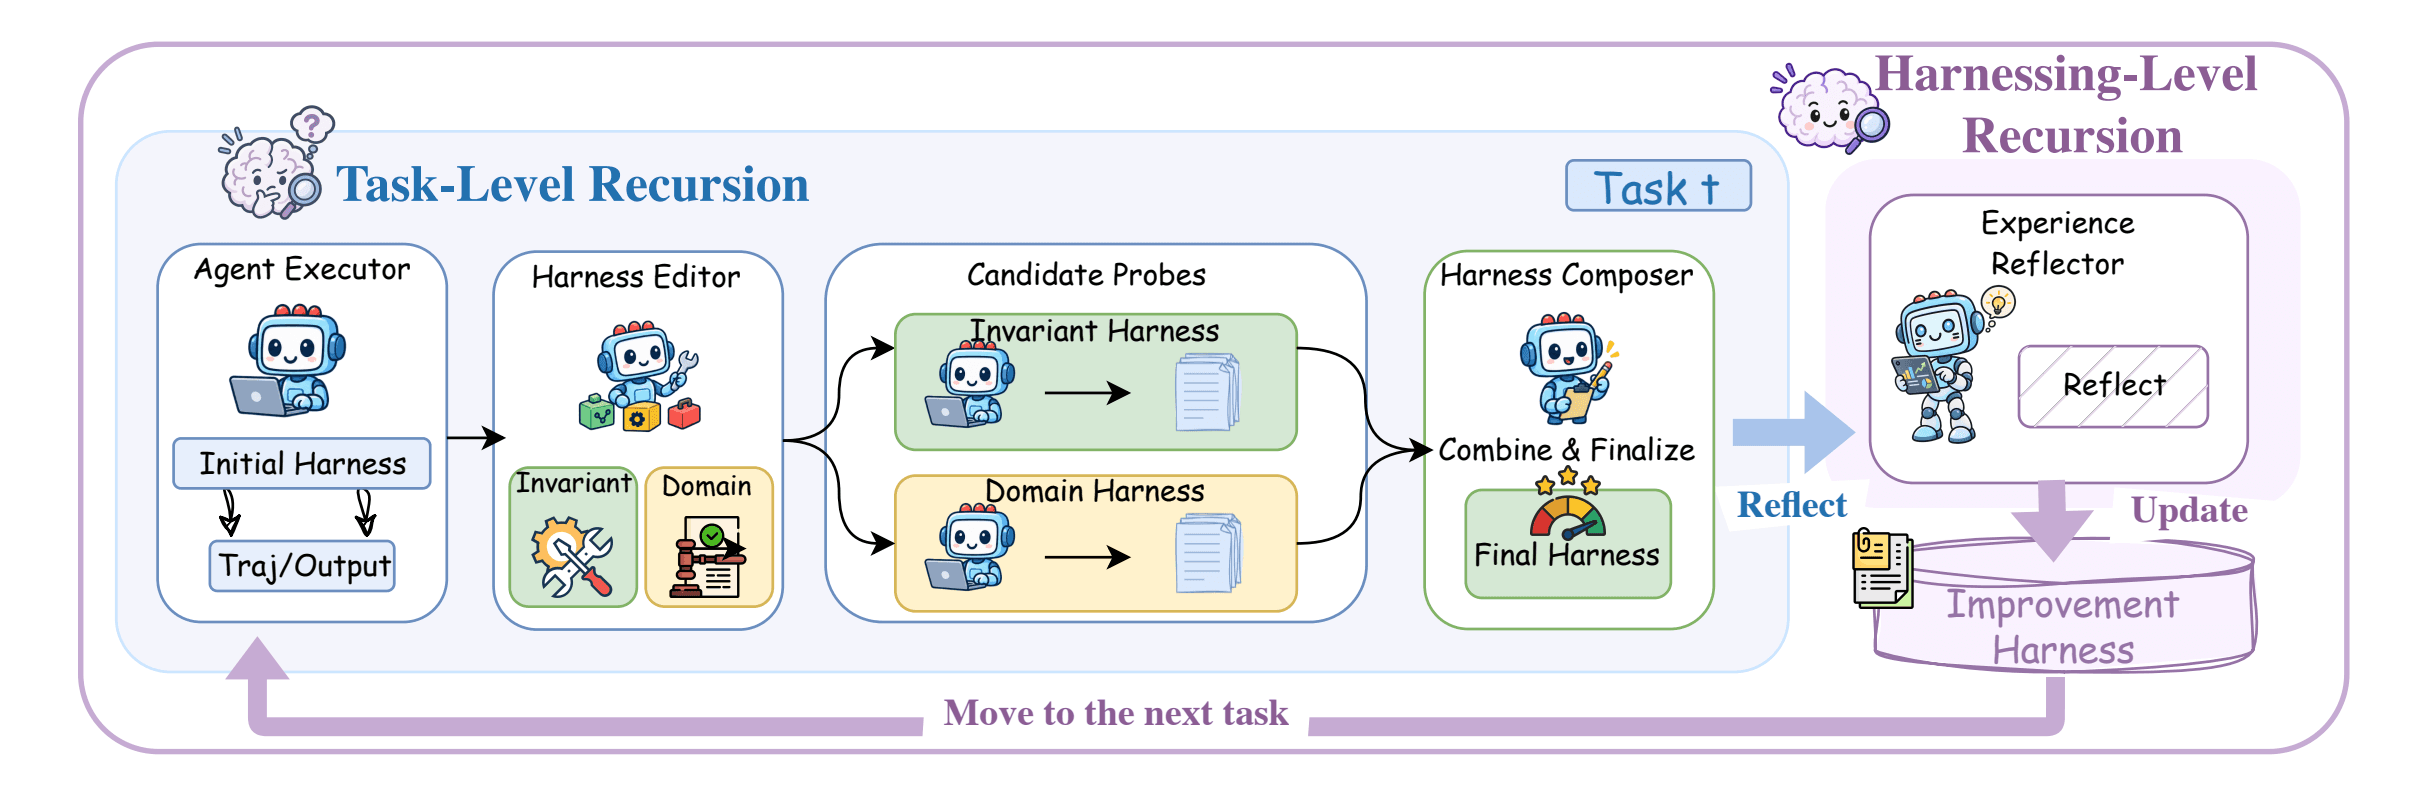
Harness² 的核心机制叫递归脚手架工程(recursive agent harnessing),分两层。第一层是任务级递归:针对当前这一个任务,通过一个叫 Propose–Probe–Compose(提议—探测—合成) 的对比步骤,不断打磨执行脚手架。具体流程是:先提议一批脚手架修改(比如改 system prompt、加一条 guardrail),然后在同一个任务上实际跑起来探测效果,最后把多次执行之间的行为差异拿来对比,合成出一版更优的脚手架。关键细节是——整个过程不需要标准答案反馈(without ground-truth feedback)。
这一点值得展开说。传统的做法(比如 DSPy 那类提示词优化器)大多依赖"有标准答案的训练集":跑一批样本,看对错,再调提示词。但真实世界里的 agent 任务恰恰没有标准答案——"帮我重构这个模块""调研三个竞品的定价"这类活儿,对错是模糊的。Harness² 的解法是绕开标准答案,用"同一任务、不同脚手架的行为对比"来产生优化信号。这是一种更贴近 open world(开放世界)的设定:README 原话说它是为"agents encounter tasks unseen during harness design"(智能体遇到设计脚手架时从未见过的任务)而造的。
第二层是脚手架级递归:每做完一个任务,系统会把"被采纳的脚手架"和"有证据支撑的经验教训"沉淀进一个持久的 improvement harness(改进脚手架),用来指导下一个任务的打磨。也就是说,Harness² 不仅在单个任务里自我修正,还在任务之间积累"怎么做 agent"的元经验。任务里进化解决当下这局,任务外进化解决局局之间的复利。
两层递归之间用一句话连起来就是:模型权重全程冻结,变的是模型周围的一切。这句话的潜台词很锋利——过去一年大家默认"agent 不行 = 模型不够强",Harness² 在问另一个问题:会不会是你的脚手架太糙了?
8 个可编辑组件:vibe coder 的抄作业清单
对普通开发者来说,Harness² 最实在的部分不是递归算法,而是它第一次把"agent 脚手架"拆成了 8 个可编辑、可版本化的组件:system prompt(系统提示词)、guardrails(护栏)、memory(记忆)、tool guidance(工具指引)、subagents(子智能体)、skills(技能)、scripts(脚本)、plugins(插件)。
README 还给了这 8 个组件的运行时分工:system prompt、guardrails、memory、skills 负责构建上下文;tool guidance、scripts 定义工具接口;subagents 负责委派协作;plugins 控制中间件。这张分工表本身就是一份 agent 架构的检查清单——下次你的 agent 表现拉胯,别只盯着换模型,按这 8 项逐项排查:是上下文构建有问题(prompt/memory/skills),还是工具接口定义不清(tool guidance/scripts),还是委派链路断了(subagents)?
更值得抄的是它的工程化程度。Harness² 开箱支持 OpenCode 和 Codex 两种执行器,三个职业级 benchmark(JobBench 职业工作、LAB 法律工作、WorkBuddy-Bench 办公/网页/代码),以及并行/顺序两种递归模式。预算参数 --k 控制任务级递归的深度:--k 1 就是走一轮"提议—探测—合成";并行模式撒开多路候选再合成(探得更广),顺序模式把上一轮的证据带进下一轮(磨得更深)。
而最降低门槛的一点是:本地 demo 完全不需要模型凭证。README 明确写了,harness2-demo 用确定性编辑器加真实 Python 执行,两条命令就能把两层递归跑通。这意味着你可以在不花一分钱 API 费用的情况下,先理解它的工作流长什么样,再决定要不要上生产模型。对想学习 agent 工程的人来说,这比任何文档都友好。
数字怎么读:11.5 个点的提升,但全是团队自测*
来看官方报告的实验结果(以下数字全部来自 Google Research 团队 README 与论文的自测*,未经独立验证):在三个职业 benchmark、四种"模型—脚手架"组合上,单步 Harness² 递归就让 GLM-5 和 Gemini 3.5 Flash 超过了它们各自的基础脚手架:WorkBuddy-Bench 上最高提升 11.5 个点*,JobBench 上 4.5 个点*,LAB 的部分通过率上 11.8 个百分点*。加大任务级递归预算(--k 调大),还能进一步涨。

怎么冷静地读这组数字?三点提醒。第一,11.5 个点的绝对值很亮眼,但 WorkBuddy-Bench 这类"办公/网页/代码"综合 benchmark 的基线本身方差就大,单步递归的提升里有多少是方法论的功劳、多少是"基础脚手架本来就没调好",只有等第三方复现才能知道。第二,测试用的模型是 GLM-5 和 Gemini 3.5 Flash——注意不是最顶级的旗舰模型,这反而让结论更有意思:如果中等模型靠脚手架优化能追上乃至超过"裸奔"的强模型,那 agent 工程的 ROI 可能比"等下一代模型"更高。第三,README 自己有一节 Web access 讲得很诚实:执行器的网络访问默认不受限,Codex 甚至默认关闭沙箱,公开的 benchmark 评分标准网上可能找得到——所以跑分之前必须先配好网络隔离,防止"看到答案"。一个团队在自家 README 里主动提醒"别让我们的 benchmark 作弊",这份诚实本身增加了几分可信度,但替代不了独立复现。
为什么这事值得 vibe coder 认真对待
先说一个判断:2026 年的 agent 竞争,正在从"模型军备赛"分化出第二条赛道——"脚手架军备赛"。Harness² 不是第一个提"优化脚手架"的人,但它是第一个把"递归、自动化、可复现"做到开箱即用的开源实现,而且来自 Google Research,Apache-2.0 协议,随便用。
对 vibe coder 来说,最直接的启示有三条。第一,别再把 agent 的失败全怪到模型头上。很多人口中的"模型不行了",拆开看是 system prompt 写得含糊、工具描述缺参数示例、没有 guardrail 拦住幻觉调用——这些恰恰是 Harness² 那 8 个组件覆盖的范围。换模型是按月等厂商发版,调脚手架是今天就能动手的事。
第二,"无标准答案也能优化"是一个被低估的突破。vibe coder 的日常任务——"给我搭个落地页""把这堆报错修了"——几乎都没有标准答案。Harness² 的对比式优化(同一任务、多版脚手架、看行为差异)提供了一套可操作的思路:哪怕你不用它的框架,也可以手动做"同一任务跑三版 prompt,对比输出差异"的土法 A/B。这比"凭感觉调 prompt"科学得多。
第三,improvement harness 的"跨任务复利"值得单独拎出来想。大多数人的 agent 用完即扔:这次调好的 prompt,下次新任务又从零开始。Harness² 把"被验证有效的脚手架修改"沉淀成可复用的改进资产——这其实就是把个人经验工程化了。对独立开发者来说,维护一份自己的"脚手架进化笔记"(什么改法在什么任务上有效、有证据),可能是比追新模型更保值的投入。
这也呼应了本站之前发过的观点篇《Agent = 模型 + 脚手架》:当时那篇是"观点",Harness² 是"工具"——观点落地成了可跑的代码。两篇连起来读,刚好是一条完整的认知链:先理解公式,再拿到优化公式的机器。
怎么上手:先跑不要钱的 demo
如果你被说动了,建议的上手路径是:先跑本地 demo(uv pip install -e '.[render]' 然后 harness2-demo --output runs/demo --k 2),零模型凭证,看懂 Propose–Probe–Compose 的完整循环;再挑一个你自己的真实小任务,用 --k 1 --mode parallel 跑一轮,对比"打磨前后"的脚手架差异;最后再考虑接生产模型(需要 Node.js 20+、Google Cloud CLI,LAB 还要 Pandoc/Poppler,WorkBuddy-Bench 要 Docker——README 的依赖清单写得很细)。
模型侧它走的是 Vertex AI 的路子(gcloud auth application-default login 配 .env),国内开发者直接跑模型版可能会卡在网络和鉴权上——但这不影响你先玩 demo 版。记住它的设计哲学:先让脚手架在便宜的环境里进化,进化明白了再上贵的模型。
冷静清单:三个必须知道的"但是"
第一,benchmark 全是团队自测*,第三方复现还没出现。11.5 个点很漂亮,但在你自己的任务上能兑现多少,未知。第二,README 底部有一行小字 disclaimer:"This is not an officially supported Google product."——这是 Google Research 的研究项目,不是 Google 官方支持的产品线,长期维护力度要打个问号。第三,安全边界要自己守:执行器网络默认全开、Codex 沙箱默认关闭,跑陌生任务前先看 docs 里 network restrictions 那节,别让你的 agent 在"进化"的时候把 API key 进化出去了。
但即便把这三个"但是"都算上,Harness² 依然是今年 agent 工程领域最值得读的一份开源作业:它把"优化脚手架"从玄学变成了 8 个组件、两层递归、一套 CLI 的工程问题。模型会越换越强,但让旧模型在新脚手架里多活一轮的能力,只会越来越值钱。
透明度说明:本文事实部分以 Google Research 官方仓库 README(2026-10-20 亲读)与论文 arXiv:2610.14224 为一手来源;所有 benchmark 提升数字均为团队自测*,正文已用星号标注,未经独立验证;仓库创建于 2026-10-06,媒体报道自 10-14 起发酵,事件本身在发布窗口内;仓库声明非 Google 官方支持产品。
评论 (0)
原始来源
相关文章
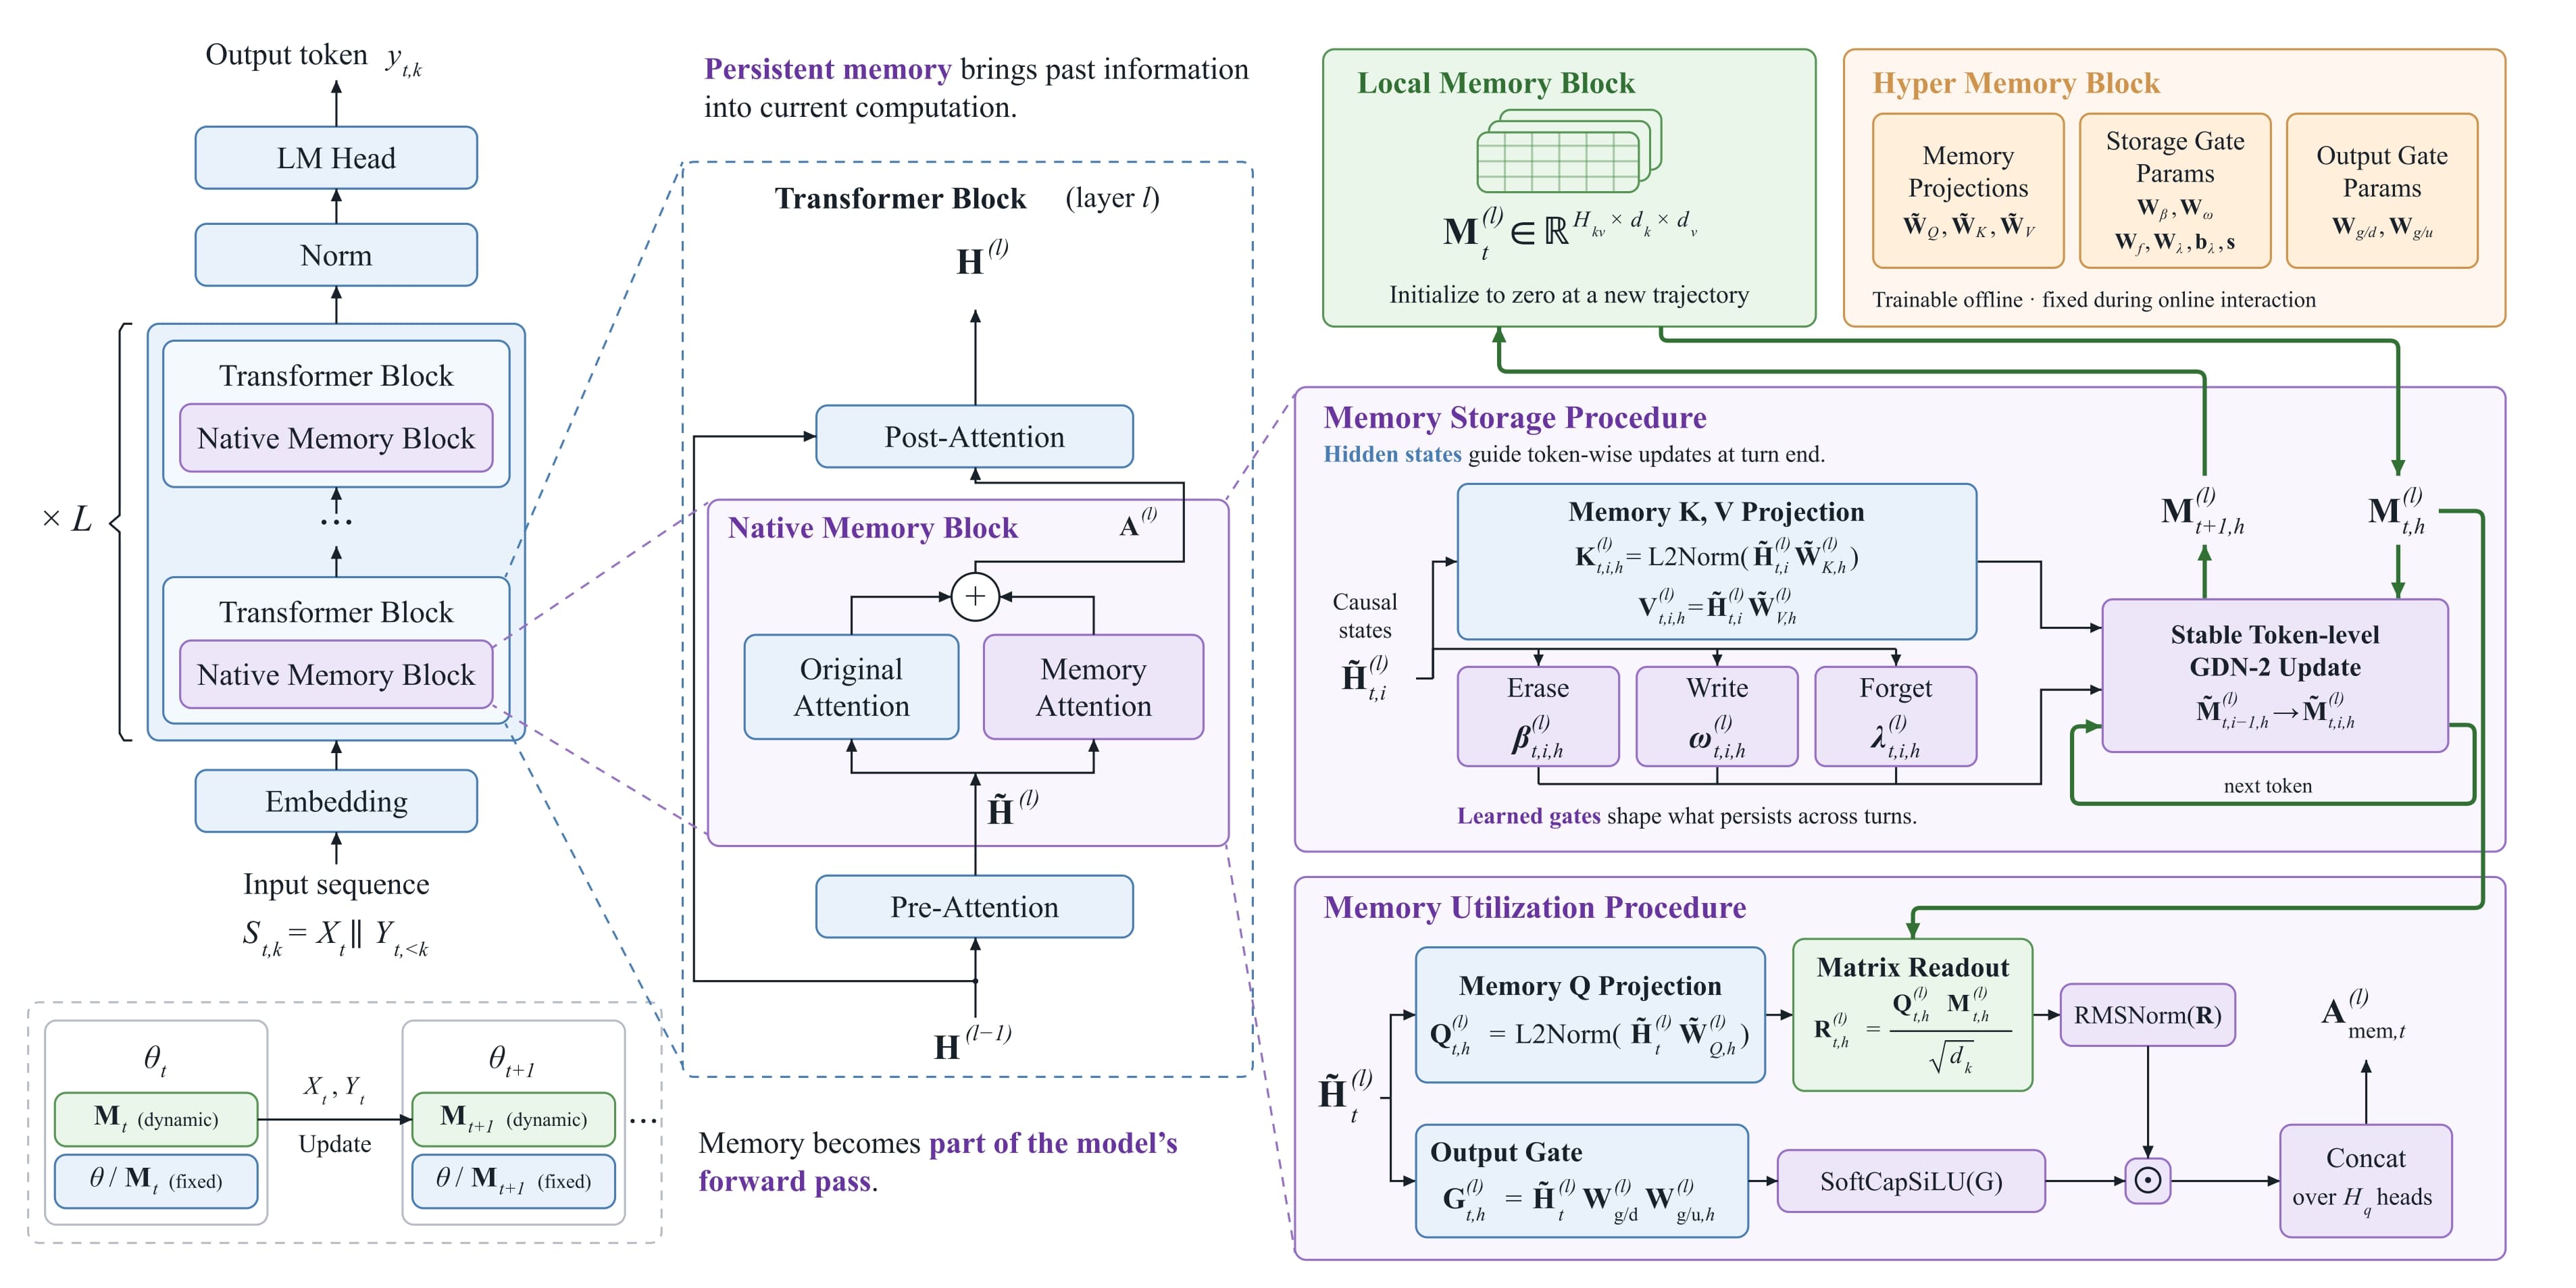
中国团队记忆张量发布并开源记忆原生大模型 MemT-1.0:把可持续存在、可更新的内部记忆做进前向传播,GDN-2 逐 token 更新、MoS 混合存储扩容,Nano(36B)与 Flash(288B)两款。团队亲口承认细节检索上外挂文本方案仍领先;许可证为 PolyForm 非商业——可免费玩,不可商用。
10 月 8 日的《编程讣告》、10 月 17 日的《热爱编程依然没问题》、10 月 19 日 610 评论的 Ask HN 实务帖——三篇构成“哀悼者、热爱者、打工人”的完整光谱。本文引用三方原话,拆解 AI 时代 vibe coder 的身份认同之问:设计权在谁手里,身份就在谁手里。
DeepSeek 在 10 月 20 日开源了支撑其生产服务的推理框架 DeepInfer(Apache-2.0),首发支持 NVIDIA SM100 与华为 Ascend 950——距离它 2025 年 4 月亲口说“不开源完整引擎”仅 18 个月。本文逐条拆解开源了什么、没开源什么,以及为什么推理成本就是 agent 成本。