把 AI 算力推到用户端:vibe 项目的本地/边缘推理实战
最便宜的 GPU 是用户的 GPU。这篇指南讲一人团队如何把合适的推理任务推到浏览器与端侧:WebGPU、transformers.js、WebLLM、llama.cpp、Ollama、Apple MLX 五条路线对照;1B–8B 量化模型的任务对照表;端侧先行、云端兜底的降级链与可直接套用的回退代码;把"数据不出设备"包装成营销卖点;首次加载体积、内存、发热的三条体验红线;以及两周跑完一个端侧功能试点的落地 SOP。云端只做兜底。
核心观点:最便宜的 GPU 是用户的 GPU
一人团队做 AI 产品,最先被烧穿的不是算力配额,而是钱包。云端推理按 token 计费,你的用户越活跃、留存越好,你的账单涨得越快——这是一种"成功惩罚"(success penalty):产品跑得好,毛利率反而被 API 账单吃掉。
但换个角度想:你的用户手里本来就有一块 GPU。手机、笔记本、平板,2026 年主流设备基本都带 WebGPU 支持的图形芯片,浏览器里就能跑 1B–8B 量化的模型。把合适的推理任务推到用户端去做,推理的边际成本直接归零——第 1 万个用户和第 100 万个用户的推理成本是一样的:零。而"数据不出设备"这句话,还能堂堂正正写进落地页,变成你的营销卖点。
这篇指南讲的就是这条架构路线:端侧先行,云端兜底。它和站内的《模型路由实战》是两种降本思路:路由是在"云端多个模型之间"做选择题(加法),这篇讲的是"不上云"的架构路线(另一极)。算账方法论请看《token 成本账》那篇指南,它教你如何把 token 花出去的每一分钱算清楚;这篇是执行层的架构方案——看完你可以直接动手改代码。
一、先算成本账:云端 token vs 端侧零边际成本
先把《token 成本账》的方法论拿过来用一遍。算账不需要精确到小数点后两位,关键是算出"量级"和"拐点"。
云端推理的成本结构
假设你做了一个写作助手,用户每天平均发起 20 次 AI 请求,每次请求平均消耗 1500 个输入 token + 800 个输出 token(这是典型的"带点上下文"的中等请求)。以某主流云 API 的公开价为例(以下数字为示意,价格随时间变动,请以官网为准):输入约 $0.15 / 百万 token,输出约 $0.6 / 百万 token。
- 单个用户每天的 token 量:20 × (1500 + 800) = 46,000 token
- 单个用户每天的成本:46000 / 1e6 × $0.15 + 46000 / 1e6 中输出占比… 粗算每天约 $0.02
- 1 万日活用户,一个月:$0.02 × 30 × 10000 ≈ $6000 / 月
- 10 万日活:$60000 / 月,而且随增长线性放大
这还没算峰值预留、重试、系统提示词膨胀。最要命的是:这笔钱和你收入的增长曲线是绑定的——用户越喜欢用,你亏得越快(如果还没找到变现点)。
端侧推理的成本结构
把上面同样的 20 次请求搬到端侧:模型文件存在 CDN 上(几 GB 的一次性分发成本,摊到每个用户身上是几分钱),推理发生在用户的 GPU 上,电费和发热都是用户出的。你的边际成本:约等于零。
有一个一次性投入:模型下载的流量费。假设模型文件 2GB,CDN 流量 $0.08/GB,用户首次加载消耗 $0.16——这是一次性的。对比云端:单个用户 8 天的云端推理费就超过这个数。之后用户用得越多,你赚得越多,边际成本曲线是平的。
拐点公式很简单:当"用户月均云端推理费 × 预期留存月数" > "模型分发的一次性成本" 时,端侧就开始替你赚钱。对高频、低单价的 AI 功能(分类、改写、摘要、审核),这个拐点通常在几周内就到了。
当然,端侧不是万能药——它有它的代价:首次加载体积、内存占用、设备发热、低端机型的兼容性。这些在第七节"体验红线"里会逐一给出上限和优化手段。
二、任务分流:什么适合端侧,什么必须上云端
端侧架构的第一步不是选模型,而是分流:把你的 AI 功能清单逐项过一遍,按"能不能忍受小模型"和"数据敏不敏感"两个维度分类。
适合端侧的任务(小模型够用,且收益明显)
- 文本分类 / 打标签:情感分析、工单分流、内容标签推荐。1B 级模型做分类已经足够准,且请求量通常最大——这是降本效果最明显的入口。
- Embedding / 语义检索:本地文档库的向量化、站内搜索。embedding 模型本身就小(几百 MB),端侧跑毫无压力,还天然支持离线。
- 内容审核:评论区、UGC 审核。敏感数据不出设备,用户反而更放心;且审核是高频刚需,云端账单大户。
- 小参数生成:标题改写、摘要、语法修正、回复建议、翻译短句。这类任务对"文采"要求不高,对延迟要求高——端侧零网络延迟反而是优势。
- 结构化抽取:从文本里抽字段、转 JSON、填表单。配合 JSON schema 约束输出,小模型做得很稳。
必须上云端的任务(别硬上端侧)
- 长上下文推理:几万 token 的文档问答、代码库级分析。端侧内存装不下 KV cache,硬上只会卡死。
- 复杂推理 / Agent 多步任务:需要强推理能力、多轮工具调用的场景,小模型幻觉率高,返工成本超过省下的 token 钱。
- 多模态重任务:高分辨率图像理解、视频分析(轻量图像问答可以端侧做,见模型表)。
- 需要最新知识 / 联网:端侧模型知识有截止日期,实时信息必须走云端。
- 合规强约束场景:金融、医疗的某些环节要求可审计、可复现的云端链路,端侧只能做辅助。
分流的实操方法是:列出你产品里所有 AI 调用点,给每个打上"端侧候选 / 云端保留 / 待验证"三档标签。先挑一个高频、低风险的端侧候选做试点(第八节 SOP 会讲),不要一上来就重构全站。
三、技术栈选型:五条路线对照
2026 年端侧推理的技术栈已经收敛到几条成熟路线,选型主要看你的交付形态(网页 / 桌面 / 移动)和团队技术栈。
| 方案 | 运行位置 | 适合谁 | 优势 | 注意 |
|---|---|---|---|---|
| transformers.js | 浏览器(WebGPU/WASM) | Web 应用 | Hugging Face 生态,pipeline API 一行调用,任务覆盖广(文本/图像/音频/embedding) | 大模型加载偏慢,需处理模型缓存与版本管理 |
| WebLLM | 浏览器(WebGPU) | Web 应用,需对话生成 | OpenAI 兼容 API,专为 LLM 对话优化,流式输出体验好 | 强依赖 WebGPU,低端设备需降级方案 |
| llama.cpp | 桌面 / 服务器 / 边缘盒子 | Electron/Tauri 桌面应用、自建边缘节点 | GGUF 生态最成熟,CPU/GPU 通吃,量化选项最多 | 需要自己打包分发,前端需经 server 或 binding 调用 |
| Ollama | 用户本地服务 | 开发者工具、桌面端重度用户 | 一行命令拉起模型,API 简单,适合" power user"场景 | 要求用户本机装服务,不适合普通消费者产品 |
| Apple MLX | macOS / iOS(Apple Silicon) | 苹果生态应用 | 统一内存架构下大模型跑得顺,原生 Swift/Python 支持 | 只覆盖苹果设备,需为其他平台准备第二套方案 |
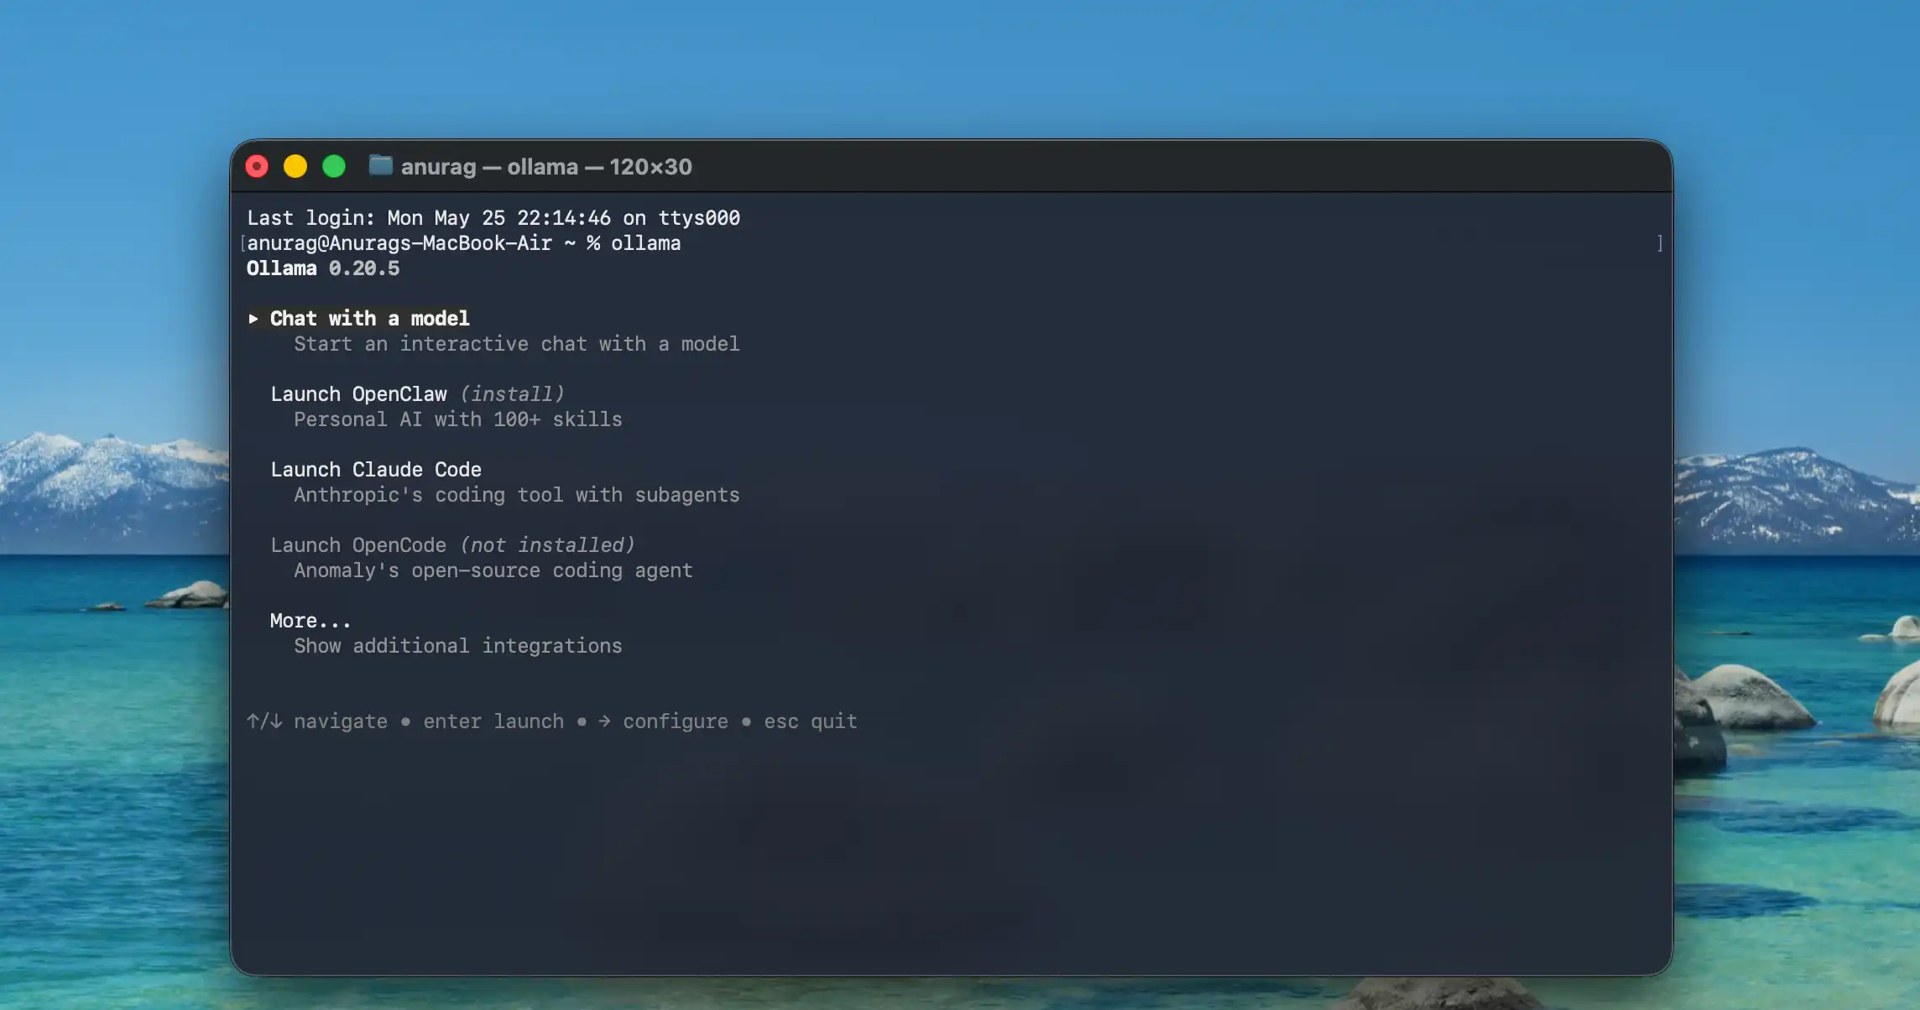
给 vibe 项目的选型建议:Web 产品优先 transformers.js 或 WebLLM——零安装、打开即用,分发成本最低;桌面应用(Electron/Tauri)用 llama.cpp 打包 GGUF;如果你的用户基本是 Mac 开发者,Ollama 是最省事的"本地后端"。另外值得知道:Chrome 从 138 起内置了 Prompt API(基于设备端 Gemini Nano),无下载、免费快速,但仅限 Chrome 且模型不可换——可以作为"有则用之"的渐进增强,别当成唯一依赖。
浏览器兼容性是必须面对的现实:截至 2026 年初,主流浏览器均已默认启用 WebGPU,但仍有约两到三成用户因设备或浏览器版本用不上。任何端侧方案都必须带云端降级链(第五节),否则你就是在主动放弃一部分付费用户。
四、模型选型:1B–8B 量化模型的任务对照表
以下为截至 2026 年 10 月社区中活跃、可用作端侧推理的开源小模型选项。模型迭代快,选型时请以 Hugging Face 上的实际量化版本和社区反馈为准;这里给的是"任务—体量"的映射逻辑,这套逻辑不过期。
| 体量档 | 代表模型(示例) | 4-bit 下大致体积 | 适合的任务 |
|---|---|---|---|
| <1B(轻量) | SmolLM2 系列、TinyLlama 类 | 几百 MB | 分类、embedding、关键词抽取、简单改写;手机端首选 |
| 1B–3B(甜点区) | Llama 3.2 1B/3B、Qwen2.5/Qwen3 系列小参数版、Gemma 3 1B/4B | 约 1–2.5GB | 摘要、翻译、审核、结构化抽取、短文本生成;浏览器端主力 |
| 3B–8B(能力区) | Phi-4-mini、Qwen2.5 7B、Mistral 7B 级、Gemma 4B(含视觉版) | 约 2.5–5GB | 开放问答、RAG 增强生成、轻量图像问答、代码补全片段;桌面端/高端手机 |
选型三原则:
- 先定任务,再定体量:分类任务别上 7B,浪费用户内存和下载流量;开放生成别用 0.5B,质量返工更贵。
- 量化优先 4-bit(Q4_K_M 这类):体积减半的同时质量损失通常可接受,是端侧的默认档;8-bit 只在质量敏感且设备吃得消时用。
- 看许可证:商用前确认模型许可证(Apache 2.0 / MIT 最省心;部分厂商许可证有额外条款)。许可证问题在发布前不解决,上线后就是定时炸弹。
一个反直觉的经验:端侧模型不怕"笨",怕"不稳"。输出格式漂移(JSON 时好时坏)比文采差更致命。对策是约束解码:用 JSON schema / 正则约束输出结构(transformers.js v4 已内置结构化输出支持),把"格式正确率"作为端侧模型的首要验收指标,而不是跑分。
五、混合架构:端侧先行、云端兜底的降级链
端侧架构的精髓不在"全端侧",而在降级链:端侧是默认路径,云端是兜底。设计目标是——用户感知不到切换,账单只为真正必要的请求买单。
降级链的四层
- L0 端侧推理:WebGPU 可用 + 模型已缓存 → 本地跑,零成本、零延迟、零数据外发。
- L1 端侧轻量回退:WebGPU 不可用但 WASM 可用 → 用更小的模型或 WASM 后端跑,慢一点但仍在端侧。
- L2 云端小模型:端侧彻底不可用 → 调云端便宜的小模型 API,保证功能可用。
- L3 云端旗舰模型:任务复杂度超标或用户显式要求高质量 → 走旗舰模型,可按次计费或限免额度。
每一层都要有明确的触发条件和可观测性:记录每次请求走了哪一层,L2/L3 的占比就是你的"云端逃逸率"——这个指标越低,你的毛利越高。把它打进监控大盘,和 API 账单放在一起看。
失败回退代码模式
下面是一个可直接套用的降级链骨架(transformers.js + 云端 API 兜底,TypeScript):
import { pipeline } from '@huggingface/transformers';

type Tier = 'local-gpu' | 'local-wasm' | 'cloud-small' | 'cloud-flagship';

class HybridInference {
  private classifier: any = null;
  private tierStats = new Map<Tier, number>();

  // L0/L1: 端侧初始化,失败则标记不可用
  async initLocal() {
    try {
      this.classifier = await pipeline(
        'text-classification',
        'Xenova/distilbert-base-uncased-finetuned-sst-2-english',
        { device: 'webgpu' } // WebGPU 不可用时 transformers.js 可回退 wasm
      );
      return true;
    } catch {
      this.classifier = null;
      return false;
    }
  }

  private track(tier: Tier) {
    this.tierStats.set(tier, (this.tierStats.get(tier) ?? 0) + 1);
  }

  // 统一入口:调用方只调这一个方法
  async classify(text: string): Promise<{ label: string; tier: Tier }> {
    // L0/L1: 端侧优先
    if (this.classifier) {
      try {
        const out = await this.classifier(text);
        this.track(this.classifier.device === 'webgpu' ? 'local-gpu' : 'local-wasm');
        return { label: out[0].label, tier: 'local-gpu' };
      } catch { /* 掉到云端 */ }
    }
    // L2: 云端小模型兜底
    try {
      const r = await fetch('/api/classify', {
        method: 'POST',
        headers: { 'Content-Type': 'application/json' },
        body: JSON.stringify({ text, model: 'small' }),
      });
      if (!r.ok) throw new Error('cloud-small failed');
      this.track('cloud-small');
      return { ...(await r.json()), tier: 'cloud-small' };
    } catch {
      // L3: 最后手段——旗舰模型(可限流/计费)
      const r = await fetch('/api/classify', {
        method: 'POST',
        headers: { 'Content-Type': 'application/json' },
        body: JSON.stringify({ text, model: 'flagship' }),
      });
      this.track('cloud-flagship');
      return { ...(await r.json()), tier: 'cloud-flagship' };
    }
  }

  getStats() { return Object.fromEntries(this.tierStats); }
}
几个关键设计点:调用方只依赖 classify() 这一个入口,降级对业务代码透明;每一层失败都向下一层滑落,不抛错给用户(除非 L3 也挂了,那时再展示友好的错误页);getStats() 输出的分层统计直接对接你的成本监控——云端逃逸率 = (L2+L3) / 总请求,把它做到 5% 以下,你的推理账单就只剩零头。
WebLLM 的版本思路相同,只是把 pipeline 换成 CreateMLCEngine 的 OpenAI 兼容接口,降级链骨架可以复用。记住一条铁律:降级链要在代码里写死,而不是文档里写死——上线三个月后没人记得文档,但代码里的 try/catch 会一直工作。
六、隐私卖点包装:把"数据不出设备"写进落地页
端侧推理省下的不只是钱。"数据不出设备"是 2026 年最好用的差异化卖点之一,尤其对律师、医生、记者、财务这些对数据敏感的职业用户——他们不是不想要 AI,是不敢把客户资料贴进一个远端输入框。
话术模板(可直接改):
- 主标题:"你的文档,从不离开你的设备。" / "Private by architecture, not by promise."(靠架构保障隐私,而不是靠承诺。)
- 副标题:"AI 在你的浏览器里本地运行——我们没有服务器能看到你的内容,因为我们根本没建那台服务器。"
- 信任状三件套:① 架构图:画出"浏览器 → 本地模型 → 结果",旁边"云端"那条线画个叉;② 可验证:开源你的降级链代码,或在页面放一个"断网测试"按钮——拔掉网线功能照样用,比一万字隐私政策有说服力;③ 对比表:你(端侧默认)vs 竞品(数据上传云端)。
- 定价页呼应:"因为我们不为你的每次点击付 token 钱,所以免费版也可以大方一点。"——把成本结构变成定价优势,免费额度给得比竞品多,转化率自然上去。
注意分寸:别宣称"绝对隐私""军用级加密"这类无法举证的话。准确的说法是"推理在设备端完成,内容默认不上传"——并且你的降级链触发云端时,要在 UI 里明确告知用户(比如一个小小的"云端增强"标识)。隐私卖点一旦被发现名不副实,反噬比没有卖点更严重。
七、体验红线:体积、内存、发热的三条上限
端侧架构最大的风险不在模型质量,而在用户体验。定三条硬上限,超了就优化,优化不动就降级:
红线 1:首次加载体积
- 上限:首屏功能相关的模型 ≤ 500MB,完整功能 ≤ 2GB。超过这个数,移动端用户会在下载进度条前流失。
- 优化手段:按功能懒加载(先下分类模型,生成模型等用户第一次点"生成"再下);用 IndexedDB 做持久缓存,二次访问零下载;CDN 分片 + 断点续传;给用户看真实的下载进度条和"下载后可离线使用"的提示——把等待变成价值感知。
红线 2:内存占用
- 上限:浏览器标签页总内存增量 ≤ 1.5GB(桌面),≤ 800MB(移动)。超了浏览器会杀标签页,用户看到的就是"闪退"。
- 优化手段:一次只驻留一个模型,用完
dispose()释放;长上下文场景主动截断历史;KV cache 是隐形杀手——上下文越长内存涨得越快,给输入长度设硬上限。
红线 3:发热与耗电
- 上限:连续推理不超过 2 分钟满载;手机端单次生成超过 30 秒就要给进度反馈。
- 优化手段:批量小任务合并推理;限制最大生成 token 数(大部分端侧任务 200 token 内足够);提供"省电模式"开关(切更小模型);iOS/Android 上优先用系统级推理 API(如果有),它们对功耗优化最好。
验收方法:找三台真实设备——一台近两年的旗舰机、一台三四年前的中端机、一台低端机——跑完整流程并记录加载时间、内存峰值、生成速度。以中端机的体验为发布标准,旗舰机只是上限参考。模拟器的数据不算数。
八、落地 SOP:从一个端侧功能试点开始
别搞"端侧化改造"这种大词。最小可行步骤如下,两周内可以跑完第一轮:
- 盘点(半天):列出所有 AI 调用点,按第二节的方法打标,选出 1 个"高频 + 低风险 + 小模型够用"的试点(通常是分类、审核或改写)。
- 选栈(1 天):Web 产品直接上 transformers.js,按第三节对照表定;桌面产品用 llama.cpp。不要同时试两条栈。
- 原型(3 天):在页面角落做一个"实验功能"入口,跑通"加载模型 → 推理 → 展示结果"最小闭环,记录三台设备的体验数据(第七节)。
- 降级链(2 天):按第五节的代码骨架接上云端兜底,上线分层统计。先在 10% 流量上灰度,盯一周云端逃逸率。
- 验收(看数据):端侧成功率 > 95%、云端逃逸率 < 10%、用户投诉无增长 → 全量。任一不达标就回炉:换更小的模型、修加载体验、或承认这个任务不适合端侧。
- 复制(滚动):试点跑顺后,把同一套"分流 → 选型 → 降级链"流程复制到下一个候选任务。每个任务独立灰度,别批量上线。
最后说一句观点:端侧推理不是"省钱技巧",它是一人团队的结构性优势。大公司有 GPU 集群,你没有——但你有几十万用户的设备。把算力推到用户端,你的产品就从"按 token 烧钱"的模式,切换到了"用户越多、边际成本越低"的模式。这在 AI 应用的历史上,是第一次让独立开发者在成本结构上反超大公司的机会。别只把它当降本,当护城河来建。
评论 (0)
相关文章
对一人团队,原生 App 不是起点,而是一种增长税——只在被验证的需求面前才值得交。本指南论证 AI 时代为何 Web-first 几乎永远正确,列出 5 个必须做原生的例外,并给出场景×团队×阶段三维打分矩阵、2026 年 PWA 能力对照表、迁原生的 4 个数据触发信号、3 条迁移路径、双端维护的每周时间税对比,以及 10 个问题 30 分钟出结论的一页纸决策模板。
合作获客是独立开发者 ROI 最高的增长杠杆:一次谈成的集成合作,带来的精准用户可能顶你写三个月博客。本指南详解合作获客四形态、50 词邀约邮件模板、UTM 归因最小实现、联盟费率与防作弊、合作协议 5 条必备,以及每月 2 小时维护 SOP。
代码写得飞起,看到'聊聊吗'就手心出汗?独立开发者的销售不是话术表演,而是结构化地帮用户做决定:发现、诊断、演示、异议处理、成交五个可重复的动作,附可直接抄的电话脚本、跟进节奏表与轻量 CRM 看板定义,内向者照样能卖。