Genie 4 来了:谷歌的世界模型第一次有了声音,还请了 Gemini 在循环里当导演
谷歌 DeepMind 10 月 27 日发布 Genie 4:首个原生生成音频的实时世界模型——世界里的人能开口对话,天气、机位、人物都能用一句话中途改写;Gemini 3.8 Flash 在生成循环里当导演,逐帧核查目标。本文详解四大升级、Apollo 机器人实验、官方局限与三层应用畅想。
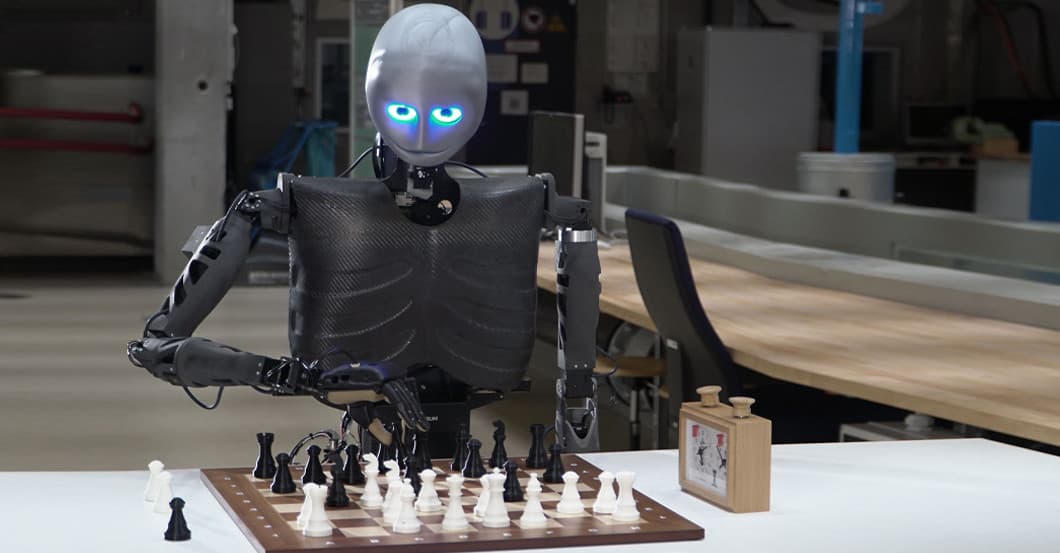
10 月 27 日,谷歌 DeepMind 发布新一代世界模型 Genie 4。皮查伊在 X 上称它是「我们最真实、最具互动性的世界模型」。这句话的重点不在画质——过去一年,写实对生成模型已经不算新闻。Genie 4 真正往前走的一步是:它生成的世界第一次有了声音,世界里的人第一次能开口对话,而在生成过程的正中央,谷歌塞进了另一个模型当「导演」:Gemini 3.8 Flash 全程盯着每一帧,拆解目标、核查进度、随时改计划。
Genie 4 目前以研究预览形式向受信任的测试者开放,接下来会进入 Project Genie 面向 Google AI Ultra 订阅用户,并通过 Gemini API 与 Google AI Studio 向早期合作伙伴开放,官方已放出候补名单。下面把这一代到底升级了什么、官方没吹的部分是什么、以及这些能力可能先落到哪些场景里,一次说清。

先说清:世界模型不是「更长的视频生成」
世界模型和视频生成模型的区别,不在时长,在于「能不能进去」。视频生成给你一段拍好的片段,世界模型则逐帧实时合成一个可以进入、可以导航、可以干预的环境:你往前走,它才把前面的世界算出来;你推门、转身、改变天气,它要即时给出符合因果的回应。Genie 系列从 2024 年走到今天,一直在补这条链上的短板:Genie 3 解决了基本的实时交互与画面一致性,Genie 4 则同时补上了三块——声音、人物、以及让多步事件不散架的推理。
DeepMind 在博客里把定位说得很直白:理解并模拟世界,是通往 AGI 的关键一环;安全、无限可变的仿真环境,既能训练机器人和智能体,也能打开全新的交互体验。换句话说,谷歌做 Genie 不是为了做一个玩具 demo,而是在给自家的机器人与 agent 业务修一条「先在想象里练兵」的路。这一点在后面的机器人实验里看得最清楚。
简单回顾这条产品线的爬坡:2024 年的 Genie 1 从无标注视频里学出可交互的 2D 世界,证明「看视频能学会一个世界的玩法」;同年末的 Genie 2 能从一张图生成可探索的 3D 环境;2025 年 8 月的 Genie 3 把实时交互、720p 画面和数分钟量级的连贯性装进研究预览,并通过 Project Genie 第一次摸到消费者。Genie 4 的增量不在分辨率,而在维度:声音是一个新维度,会说话的人是另一个新维度,而 Gemini 在环推理,是给所有维度兜底的第三个维度。这也是为什么这一代值得单独报道——它补的不是像素,是「世界感」的组成件。
升级一:世界可以中途改——实时文本塑形
Genie 3 已经支持在模拟中途改变条件,Genie 4 把这件事变成了自然语言的日常操作。模拟运行过程中,你可以直接用文本提示改天气、挪机位、往场景里加一个人或一件物体;Gemini 会结合当前场景上下文理解你的指令,而不是粗暴地把新元素贴上去。在你两次输入之间,Gemini 还会持续监视并引导场景,让世界在没有指令时也保持连贯推进。
这听起来像游戏里的作弊控制台,本质却不同:传统引擎改天气是调参数,Genie 4 改天气是重新「想象」整个世界在新条件下的样子——光线、地面积水、人物反应都要跟着变,而且不能穿帮。对创作者来说,这是把「生成」和「导演」合并成了一个动作:你不是在渲染一段视频,你是在现场调度一个世界。
升级二:物理更真,「人」更像人
DeepMind 说,Genie 4 在物理真实感上立了新标准:空气动力学、碰撞等真实物理场景的模拟更可信。但官方自己点名「最戏剧性的跃升」不在物理,在人。Genie 4 里的人物动作更自然,对环境的反应更有机,而且可以在实时交互中被引导——你让她转身、走过去、拿起东西,动作的连贯性不再像上一代那样机械。
为什么「人」这么重要?因为世界模型此前最大的破绽就是人:脸会漂、手会糊、动作像提线木偶。一个连人走路都模拟不像的世界,做训练场不够格,做叙事载体也出戏。Genie 4 把人物推到及格线之上,等于同时解锁了两类应用:需要「人」在场的仿真训练(服务、医疗、应急),和以人物互动为核心的叙事体验。
升级三:第一次,世界自己会发声
Genie 4 是 DeepMind 第一个原生生成音频的实时世界模型——不是给画面后期配音,而是在生成世界的同时把声音一起算出来。每个世界都自带它所在环境的声音:树间的风声、海滩的浪声。官方演示里的所有伴音,都由 Genie 4 直接生成。
真正的分水岭是人声。Genie 4 引入了交互式对话:世界里的人物能彼此交谈,能回应你的输入和世界中发生的事件,而且是实时的、随情境变化的。把这一条和上一条拼起来看:一个能走动、能对环境做出反应、还能开口说话的人物,已经不是「NPC 素材」,而是「角色」的雏形。游戏、影视、教育里大量靠对话推进的场景,从此有了被生成的可能。
升级四:Gemini 进了生成循环——一个在环导演
这一代在架构上最值得记住的变化,是 Genie 不再单打独斗。Genie 4 构建在 Gemini 家族的能力之上:Gemini Omni 负责把模拟锚定在真实世界的外观与行为上,其他 Gemini 模型提供维持连贯性所需的推理。具体到运行中,Gemini 3.8 Flash 扮演「循环内导引 agent」的角色:Genie 逐帧生成世界的同时,它持续观察画面,把用户目标拆成一串步骤,再逐帧复核每一步是否成功;世界发生变化或用户中途干预时,它当场调整计划。
DeepMind 把这条路命名为「混合世界模型」:用代码与语言模型的结构化推理管骨架——事件结构、叙事时间线、因果链条;用像素级模拟管血肉——世界长什么样、听起来如何、如何即时响应。一个管「讲得通」,一个管「看得真」。这不只是 Genie 一家的事,它实际上给整个世界模型赛道提供了一个可复制的架构范式:生成模型负责渲染,推理模型负责不让世界说谎。
一个值得盯住的实验:让机器人先在想象里把活干一遍
发布博客里藏了一个信号很强的实验:DeepMind 把前沿推理模型 Gemini 4 Argon 与 Genie 4 接到了一起,配合 Gemini Robotics 做机器人任务模拟。流程是:Argon 把用户交代的任务拆成步骤,以文本字幕的形式实时穿插进 Genie 4 的渲染过程;因为 Genie 4 能被 Gemini 以文本实时操控,模拟可以随着任务推进不断调整。官方演示中,两者协作模拟了 Apptronik 的 Apollo 人形机器人下跳棋的全过程,任务被拆成实时步骤执行。
这一步的想象空间在于成本结构。真实机器人训练最贵的是试错:摔坏的硬件、危险的场景、采不到的长尾数据。如果一个足够可信的世界模型能让机器人在「想象」里先把任务跑通、把失败跑够,真机训练的效率会被彻底改写。Genie 4 离「足够可信」还有距离(见下文局限),但谷歌把 Argon、Genie、Gemini Robotics 三条线在同一次发布里并排摆出来,方向已经写在脸上了。
谁能用、怎么用
时间表先说清:Genie 4 现在是研究预览,只对受信任测试者开放;「即将」面向 Google AI Ultra 订阅用户在 Project Genie 上线,并向 Gemini API 与 Google AI Studio 的早期合作伙伴开放,普通用户可以先登记候补。安全侧,官方称 Genie 4 带与谷歌其他模型一致的严格护栏,上线前经过内部严格安全评估;所有由 Genie 4 生成的视频与音频都会嵌入 SynthID 数字水印,可被识别为 AI 生成内容。
据 TechCrunch 报道,Genie 4 能维持连贯场景的时长约为上一代的两倍、达到约两分钟。需要提醒的是:时长数字来自媒体报道,DeepMind 官方博客并未给出明确的规格表,「两分钟」也应理解为理想条件下的量级,而非每次生成的保证。
同样值得记一笔的是官方这次没有公布的东西:没有分辨率与帧率指标,没有 API 定价,没有 Project Genie 上线的确切日期,也没有说明 AI Ultra 之外的用户何时能用上。这不是疏漏,更像是刻意的节奏控制——先用受信任测试者把安全与体验磨一轮,再谈规模和价格。对观望中的开发者,含义很实际:现在能做的只有登记候补、盯住 Gemini API 的早期访问名单,真正的动手窗口还没开。
把话说回来:官方自己列的局限
难得的是,DeepMind 在发布博客里专门留了一节讲局限,而且说得具体:Genie 4 只能在较短的会话内保持环境连贯,模拟运行越久、复杂提示编辑越多、在场景中移动越广,视觉细节和物体恒存性就越容易漂移;复杂物理交互、实时音频的准确性、可读文字的渲染、空间精度和长期一致性,都是进行中的研究课题。
这份坦诚应该成为阅读所有演示视频的滤镜:你看到的每一支官方录屏,都是短会话、精选条件下的上限表现。世界模型今天的真实水位是「分钟级的、可干预的梦」,离「小时级的、可信赖的仿真」还隔着物体恒存与长期一致性两座山。这也是为什么它先落在「草稿」和「预演」类场景,而不是直接进生产管线。
竞争格局:世界模型正在变成巨头的军备竞赛
Genie 4 发布的同一时期,赛道正在快速整合。据 TechCrunch 梳理:Runway 几个月前发布了第二代世界模型 GWM Worlds 2,同样支持可玩的交互与音频生成;李飞飞的 World Labs 正被 AMD 收购;亚马逊洽购 Decart 的谈判仍在进行;电动汽车公司 Rivian 则收购了 Third Dimension,把仿真能力收进自家自动驾驶测试体系。
这组交易说明一件事:世界模型的买家已经不只是内容行业。车企要它合成自动驾驶的长尾场景,芯片公司要它卡位下一代算力负载,云厂商要它做 agent 的训练场。谷歌的优势在于全栈自有:Genie 负责世界,Gemini 负责推理,Gemini Robotics 负责落地,还有 TPU 算力和 AI Ultra 的分发渠道。短板也同样明显:研究预览的开放节奏,比 Runway 这类创业公司的产品化速度慢半拍。
畅想:这些能力会先落到哪里
以下按落地距离分三层。前两层有官方测试者案例打底,第三层是基于能力边界的推演,不是任何一家的路线图承诺。
近期(测试者已经在用):影视与广告的「草稿模式」预演——导演走进实时模拟的场景里连拍多个镜头,当场改机位、光线、台词和动作,把找感觉的成本从实拍降到提示词;游戏与交互体验的概念设计——从一句想法到可探索的原型只要几秒钟,先用自然语言验美术风格与交互机制,再决定要不要写第一行引擎代码;新闻与历史场景的沉浸化——照片记者正在测试把一张 2D 历史照片变成可进入的动态环境,以及模拟山洪、野火等短期环境事件的演变过程;企业的「零到一」场景生成——需要快速搭一个从未存在过的场景做推演时,不再等建模外包。
中期(能力到位就能接):机器人与自动驾驶的仿真训练场——把真实世界里采不到、不敢采的长尾与危险场景批量合成出来,先在世界模型里练够再上真机,Argon 加 Genie 的机器人实验就是这条路的原型;agent 的无限训练环境——给智能体生成无限可变、带因果的环境做强化学习与评测,解决 agent 训练缺场景、缺对手的老大难;教育与职业培训——历史现场、手术流程、工厂应急处置,都可以变成可进入、可重演、能对话的模拟课;电商与空间设计预览——把一张户型图或一张商品图变成可以走进去的世界,先体验再决策。
远期(范式级推演):可玩的世界生成成为一种新媒介——当连贯时长从分钟走向小时、「混合世界模型」把叙事骨架接入生成引擎,游戏可能不再是被开发出来的,而是被「导演」出来的:玩家一边玩一边改世界,角色能真正对话和记忆;个人化的交互叙事——每个人拥有一个为自己生成的、可长期生活的世界,NPC 有持续的人格与记忆,这会重写娱乐与陪伴产品的形态;世界模型成为 agent 的「内在沙盘」——未来的智能体在行动前先在自己的世界模型里预演后果,这正是谷歌把推理与模拟合流的深层意图:让机器在想象中犯错,而不是在现实中。
对独立开发者,这意味着什么:世界模型正在变成一种新的「运行时」。过去做交互体验,流程是建模、写逻辑、调引擎;当世界可以被提示词直接生成和修改,流程会变成先导演、后工程——先用世界模型把体验的骨架玩出来,验证好玩与否,再决定哪些部分值得用传统引擎重做。对 vibe coding 的创作者来说,这是又一个「先做出来再说」的放大器:原型的上限从静态页面和点击 demo,抬高到了可进入的世界。等 Gemini API 的早期访问扩大,第一批把 Genie 类能力嵌进自己产品的工作室,大概率出现在游戏原型、虚拟展厅和培训模拟这三个离钱最近的场景。
结尾:真正的信号,不是画质
回头看 Genie 4 的四项升级——能改、像人、会发声、有导演——没有一项是单纯的画质军备。谷歌在做的事情,是把世界模型从「生成一段逼真视频」推向「生成一个可进入、可干预、有声音、有因果、还能被另一个模型管理的环境」。前者是内容工具,后者是基础设施。
对开发者来说,值得盯的不是今天的演示有多惊艳,而是两个时间点:Gemini API 与 AI Studio 的早期访问何时扩大,以及 Project Genie 面向 AI Ultra 上线后的真实留存。世界模型的上半场比谁的世界更真,下半场比谁的世界先被用起来。Genie 4 抢到了一个不错的身位,但离终局还远——毕竟,它自己也承认,它做的梦还只有几分钟长。
评论 (0)
原始来源
相关文章
Arda 结束隐身:累计融资 2.32 亿美元、A 轮估值 15 亿美元,要用 AI agent 把 CAD 图纸变成装配顺序与作业指导。亮点真实,但目前只有 Anduril 一家标杆客户背书,机器人路线图仍是未来时。
2026 年 10 月 23 日,Chroma 签署最终协议加入 Replit,共建“自驱公司的上下文层”。开源 ChromaDB 继续,但 Chroma Cloud 将在 60 天内关停:11 月 22 日停写、12 月 22 日停读;价格与交割日期未披露。
2026 年 10 月 26 日,Anthropic 公开提交 S-1:拟发行 A 类普通股、代码 ANT,但股份数量与价格区间均未确定、注册声明尚未生效。真正值得读的不是 807 亿美元净亏损,而是 6.93 亿美元经营亏损、11900 家企业客户与创始人保留 50.1% 投票权的治理结构。