国产代码智能体拿下 SWE-bench-Live 第一:TianxiCode + DeepSeek-v4.1-Flash 解决率 71%
联想天禧 AI 自研代码智能体框架 TianxiCode 搭配 DeepSeek-v4.1-Flash,在 SWE-bench-Live Lite 分榜以 71% 解决率登顶全球第一,并通过官方 Verified 审核。本文解读这项“真实工程”评测为何更难、“框架>模型”论点的含金量,以及它给 vibe coding 实践者的三点启示。
71% 登顶:国产 agent 框架第一次站上最高点
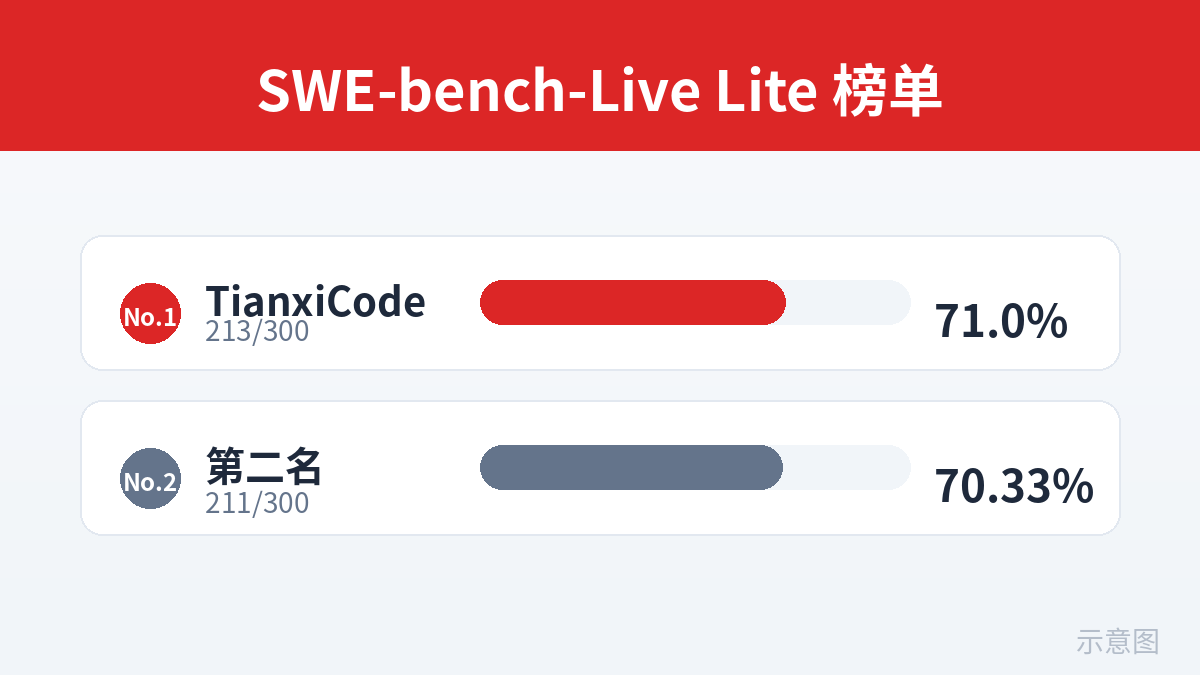
10 月 8 日,SWE-bench-Live 官方榜单悄然更新。Lite 分榜的榜首位置第一次出现了一个中文名字:TianxiCode——联想天禧 AI 自研的专业代码智能体框架。它以 71% 的问题解决率登顶全球第一:300 道真实工程题目,解出 213 道,超出第二名的 70.33% 不到一个百分点,但第一名就是第一名。更重要的是,这次登顶是"带章"的:榜单给 TianxiCode 打上了 Verified 认证——它通过了官方的完整审核,成绩真实有效。
这件事有意思的地方,不在于"又一个国产第一"的标题党,而在于三个关键词的组合:自研框架、国产开源模型、真实工程评测。搭档的模型是 DeepSeek-v4.1-Flash——国产、开源、轻量,而非任何一家闭源巨头的旗舰模型。一台"轻量级发动机",配上一套自研的智能体工程框架,在全球公认最难的代码评测上跑赢了所有对手。这正是报道反复强调的那句判断:框架 > 模型。
消息最早由量子位于 10 月 9 日披露,随后得到英文媒体的交叉确认:Lite 分榜 300 题、213 题解出、71% 登顶、榜单条目日期 10 月 8 日。数字口径一致,来源互相印证,这是一条经得起核验的硬新闻。
SWE-bench-Live 为什么比 SWE-bench 更难
要理解这个第一的含金量,得先搞清楚 SWE-bench-Live 是个什么考试。经典 SWE-bench 在 2024 年一经推出就成了代码模型评测的"高考":从真实 GitHub 仓库的 issue 里选题,要求模型生成能通过测试的修复补丁。但它有个致命伤:题目是静态的。数据集一旦公开,模型训练时就可能"见过"这些 issue——业内叫数据污染。分数越刷越高,但到底是真本事还是背过题,没人说得清。
SWE-bench-Live 就是来治这个毛病的。它的题库不是一次性发布的,而是从最新、正在活跃的 GitHub 项目里持续抓取真实 issue,滚动更新。题目对参赛者来说永远是"新题":没有现成答案可背,没有测试用例可偷看,考的是智能体在真实代码库里从零开始定位问题、理解上下文、写出补丁的完整能力。Lite 分榜这 300 道题,每一道都来自某个开发者真实踩过的坑。
而 Verified 认证是这个考试的第二道防线。SWE-bench-Live 的官方核验机制要求参赛团队提交智能体全链路运行轨迹(trajectories)——从读到 issue 的第一秒起,每一次检索、每一次工具调用、每一次试错都要留痕。官方审查员会逐条检查:有没有答案泄露?有没有偷看隐藏测试用例?轨迹是否完整可复现?只有干净通过这一关,成绩旁边才会出现 Verified 标记。
换句话说,TianxiCode 的 71% 不是"刷"出来的。它是在持续更新的题库上、交出全部答题过程、经官方审计之后拿到的分数。这也是为什么业内把 SWE-bench-Live 看作当前最接近"真实工程能力"的代码智能体试金石——它测的不是模型会不会写代码,而是智能体系统能不能独立修好一个真实项目的 bug。
轨迹审查这个设计本身也值得细品。它等于官方在说:我们不只看你交上来的补丁对不对,还要看你是怎么得到它的——中间有没有走捷径、有没有"恰好"猜中隐藏测试的意图。这种"过程审计"比"结果打分"苛刻得多,也更接近真实工程里 code review 的逻辑:一个看不懂是怎么写出来的补丁,再能通过测试也不敢合入。一个愿意把全链路轨迹交出来接受审查的团队,至少在工程诚实度上先赢了一分。
一个数字的注脚:71% 与 70.33%
第一名 71%,第二名 70.33%,差距只有 0.67 个百分点——300 道题里大概就差两道。这种毫厘之间的胜负恰恰说明:顶级玩家之间的模型能力已经拉不开差距了。大家用的都是第一梯队的模型,胜负手不在"谁的模型更聪明",而在"谁的工程框架更能把模型的聪明兑现成补丁"。这正是"框架 > 模型"论点的现实注脚。
还有一个常被忽略的细节:71% 意味着还有 87 道题没解出来。即使是世界第一,在真实工程面前依然有近三成的失败率。这个数字既是天花板,也是诚实——它提醒我们,代码智能体距离"完全可靠"还有相当长的路,榜单登顶和生产可用之间,隔着的正是那 29% 的长尾难题。
"框架 > 模型":这句话的含金量
量子位的报道里有一句很扎眼的判断:即便调用顶级闭源模型,如果缺乏顶层的智能体架构协同,在真实工程难题面前也常常束手无策。这话听起来像厂商 PR,但榜单数据给了它底气——登顶的不是某个参数最大的模型,而是一个搭配轻量开源模型的工程框架。
这个判断其实呼应了 2026 年整个 agent 赛道正在发生的一次认知转向:模型正在变成 commodity(大宗商品)。各家旗舰模型的代码能力差距在缩小,价格却在快速下降,真正拉开差距的,是模型之上的那一层——智能体框架:怎么检索、怎么规划、怎么管理上下文、怎么验证自己的输出。模型决定下限,框架决定上限。
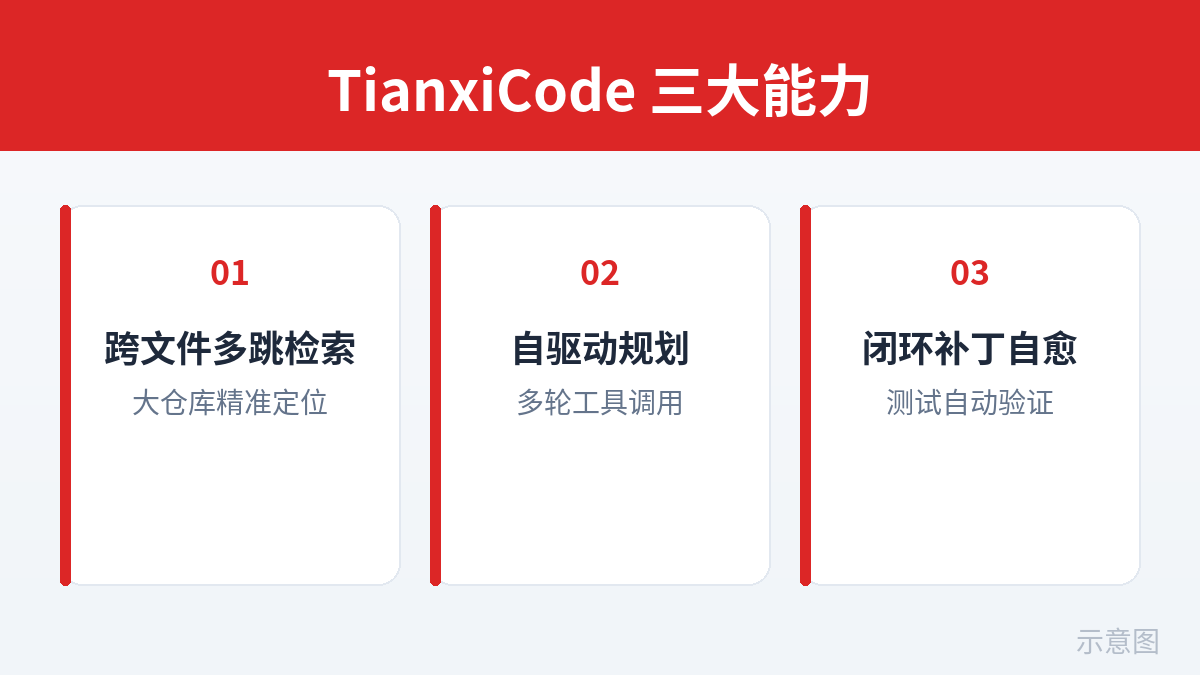
TianxiCode 官方披露的三大能力,翻译成大白话,恰好对应了做好一个代码 agent 的三道坎:
- 跨文件多跳检索 + 精准上下文管理:真实 bug 从不在一个文件里。一个空指针的根因可能藏在三层调用之外,修补时要同时读懂五六个文件的约定。agent 的检索能力决定了它"看"代码库的视野,而上下文管理决定了它不会在长链条推理中把关键信息弄丢。这是所有代码 agent 的第一道生死线。
- 自驱动规划 + 多轮工具调用:好的 agent 不是"一问一答"的复读机,而是能自己拆解任务、决定下一步用什么工具、根据返回结果调整计划的行动者。从"定位→复现→修复→验证"的多轮循环里,每一步的决策质量都依赖规划能力。规划垮了,工具调用再多也只是无效打转。
- 闭环补丁生成 + 测试驱动自愈:这是最被低估的一环。生成补丁不难,难的是生成之后自己跑测试、看报错、回滚、再改——形成"写→测→修"的自愈闭环。没有这个闭环的 agent,本质上还是个高级代码补全;有了它,才算是一个能对结果负责的"工程师"。
我的判断是:这三条里,第三条是 2026 年代码 agent 的分水岭。前两条解决的是"能不能干活",第三条解决的是"干完的活靠不靠谱"。SWE-bench-Live 恰恰只认第三条——补丁必须通过真实测试才算分,过程再漂亮也没用。所以 71% 这个数字,本质上是在说:TianxiCode 的自愈闭环,在 213 个真实 bug 上跑通了。
反过来看,"框架 > 模型"还有一层更深的含义:它把竞争的重心从"烧钱训更大的模型"拉回到"踏实做工程"。这对没有千亿参数训练预算的团队是好消息——创新发生在架构层,而架构层的创新,靠的是对真实问题的理解,不是算力。
给 vibe coding 读者的启示:好 agent 到底靠什么
把这个新闻拉回我们读者的日常:每天用 Cursor、Claude Code、Codex 写代码的人,最该从这件事里带走什么?三点实在的启示。
第一,别再只盯着"换了什么模型"。很多人的 agent 工作流优化停留在"等下一个更强的模型"。TianxiCode 的登顶证明,在现有模型水平上,工程框架的优化空间还大得很。与其追新模型,不如把精力花在提示词工程、上下文裁剪、工具链编排这些"框架层"的事情上——它们对成功率的杠杆更大。一个调教好的工作流配旧模型,常常跑赢裸奔的新模型。
第二,测试闭环是 vibe coding 从"玩具"到"生产"的门票。让 agent 写代码不难,难的是让它对自己写的东西负责。一个实用的习惯是:永远给 agent 配好"跑测试—读报错—自动修复"的循环,而不是人肉当它的测试员。TianxiCode 的"测试驱动自愈"听起来高大上,落实到个人工作流,就是一条简单的规则——不许 agent 在测试变绿之前说"搞定了"。你给 agent 的验收标准有多硬,它交付的质量就有多硬。
第三,轻量模型 + 强框架可能是性价比最高的组合。DeepSeek-v4.1-Flash 是个轻量、便宜、开源的模型,它能登顶说明:在框架足够强的前提下,你不需要为每一次调用支付旗舰模型的价格。对个人开发者和一人公司来说,这意味着 agent 工作流的成本可以大幅压低——把省下来的预算花在更好的检索、更长的上下文、更多的验证轮次上,回报更高。聪明的花钱方式,是把钱花在"让 agent 多试几次"上,而不是"让每一次都用最贵的模型"上。
国产 agent 基础设施的一盘棋
把视线拉远一点,TianxiCode 的登顶不是孤立事件。同一周,华为系的 openJiuwen 开源了企业级 AgentOS,把多智能体编排、自我进化、沙箱网关打包成 Apache 2.0 的完整方案;联想这边,则明确表示 TianxiCode 将沉淀为其 AI 硬件产品中的代码智能能力。一边是开源基础设施,一边是端侧硬件落地——国产 agent 正在从"发论文、刷榜单"的阶段,进入"搭底座、进产品"的阶段。
联想天禧的这个规划尤其值得玩味。PC 厂商做代码智能体,乍看跨界,细想合理:AI PC 的叙事讲了两年,市场一直在等一个"杀手级"的端侧智能体场景。代码智能恰恰是最成熟、付费意愿最强的 agent 场景之一。如果 TianxiCode 的能力能沉淀进联想的 AI 硬件产品线——比如开发本上的本地代码助手——那它就从一个榜单成绩,变成了一条真实的产品线。
当然,冷静的话也要说在前面。SWE-bench-Live 测的是"修 bug"这一个维度;真实工程里还有需求理解、架构设计、跨系统联调这些榜单测不到的东西。71% 的登顶值得鼓掌,但它证明的是"这个框架在修 bug 这件事上是世界第一",而不是"AI 已经可以替代工程师"。两者之间,还隔着好几道真实世界的坎。对榜单成绩最好的态度是:既不贬低它的工程含金量,也不把它脑补成通用能力的胜利。
还有一个视角:联想天禧选择自研框架而不是"套壳"调用,本身就是一次路线表态。当很多团队还在比拼"接入了几个模型"的时候,天禧把功夫下在了智能体架构这一层。这条路更慢、更重,但一旦走通,沉淀下来的就是别人拿不走的东西——对工程细节的理解、对失败模式的积累、对闭环的设计经验。榜单第一只是这些积累第一次被外界看见。
结语:登顶只是一个起点
回看这件事最耐人寻味的一点:赢的不是参数最大的模型,而是一套把轻量模型用到极致的工程框架。在模型能力快速商品化的 2026 年,这可能是比"国产第一"更重要的信号——agent 时代的竞争,正在从"谁的模型更聪明"转向"谁的工程更扎实"。对框架的投入、对闭环的执念、对验证的苛刻,这些"笨功夫"正在变成最宽的护城河。
TianxiCode 把 71% 和 Verified 一起拿下,给国产 agent 基础设施立了一个很高的标杆:不靠营销靠审计,不靠参数靠工程。接下来值得看的,是这套能力能不能真的走进联想的硬件产品,变成开发者每天能用到的东西。榜单的第一名年年有,能进产品的第一名才稀缺。
评论 (0)
原始来源
相关文章
Rails 之父 DHH 在 Rails World 宣布 37signals 已“不再手写代码”。本文拆解 2025 年 11 月的拐点、转向原生应用与 Rust 的动作、同一信源里的反方证据,以及给 vibe coding 读者的三条判断。
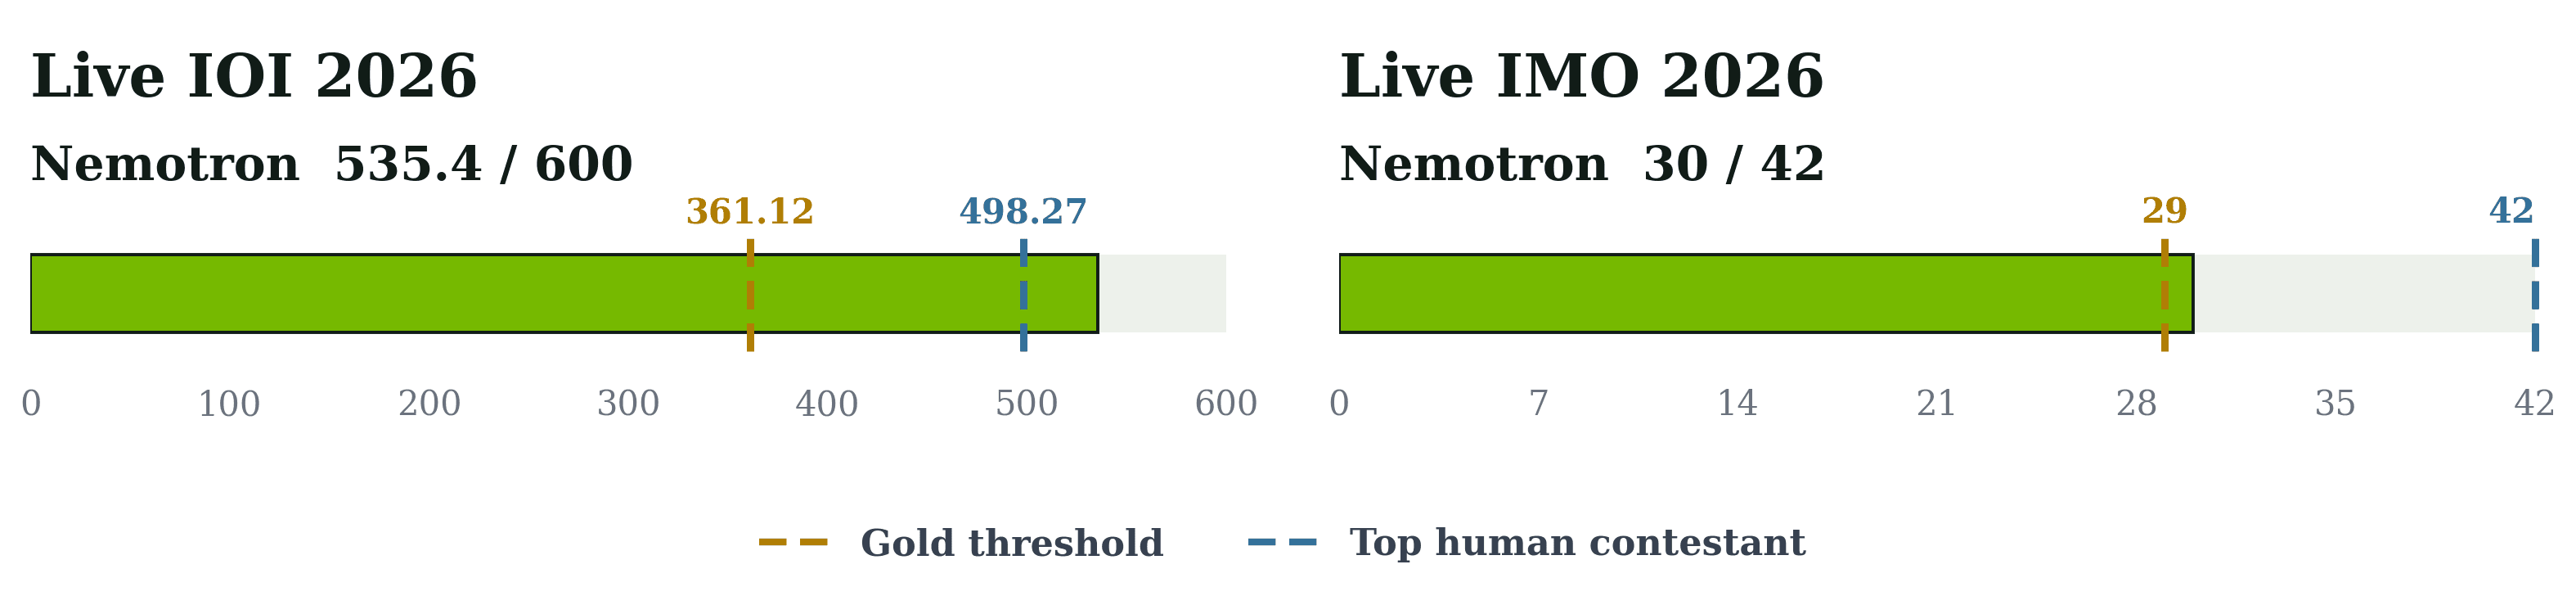
NVIDIA 的 Nemotron 系统在 IOI 2026 拿下 535.4/600(非官方跑分,超过人类最高分 498.27)、在 IMO 2026 拿下 30/42(官方阅卷,越过 29 分金牌线),并把整套配方全部开源:SFT 与 RL 的 checkpoint、两份训练数据集、全新的 200 道奥赛级数学 benchmark、推理管线与 prompt。核心方法是模型、数据、推理循环的协同设计:GenCorrect 的生成-评估-改进循环把 291 分的模型推过 438.3 的金牌线。对一人公司而言,这是一份生产级的测试驱动 agent 循环模板。
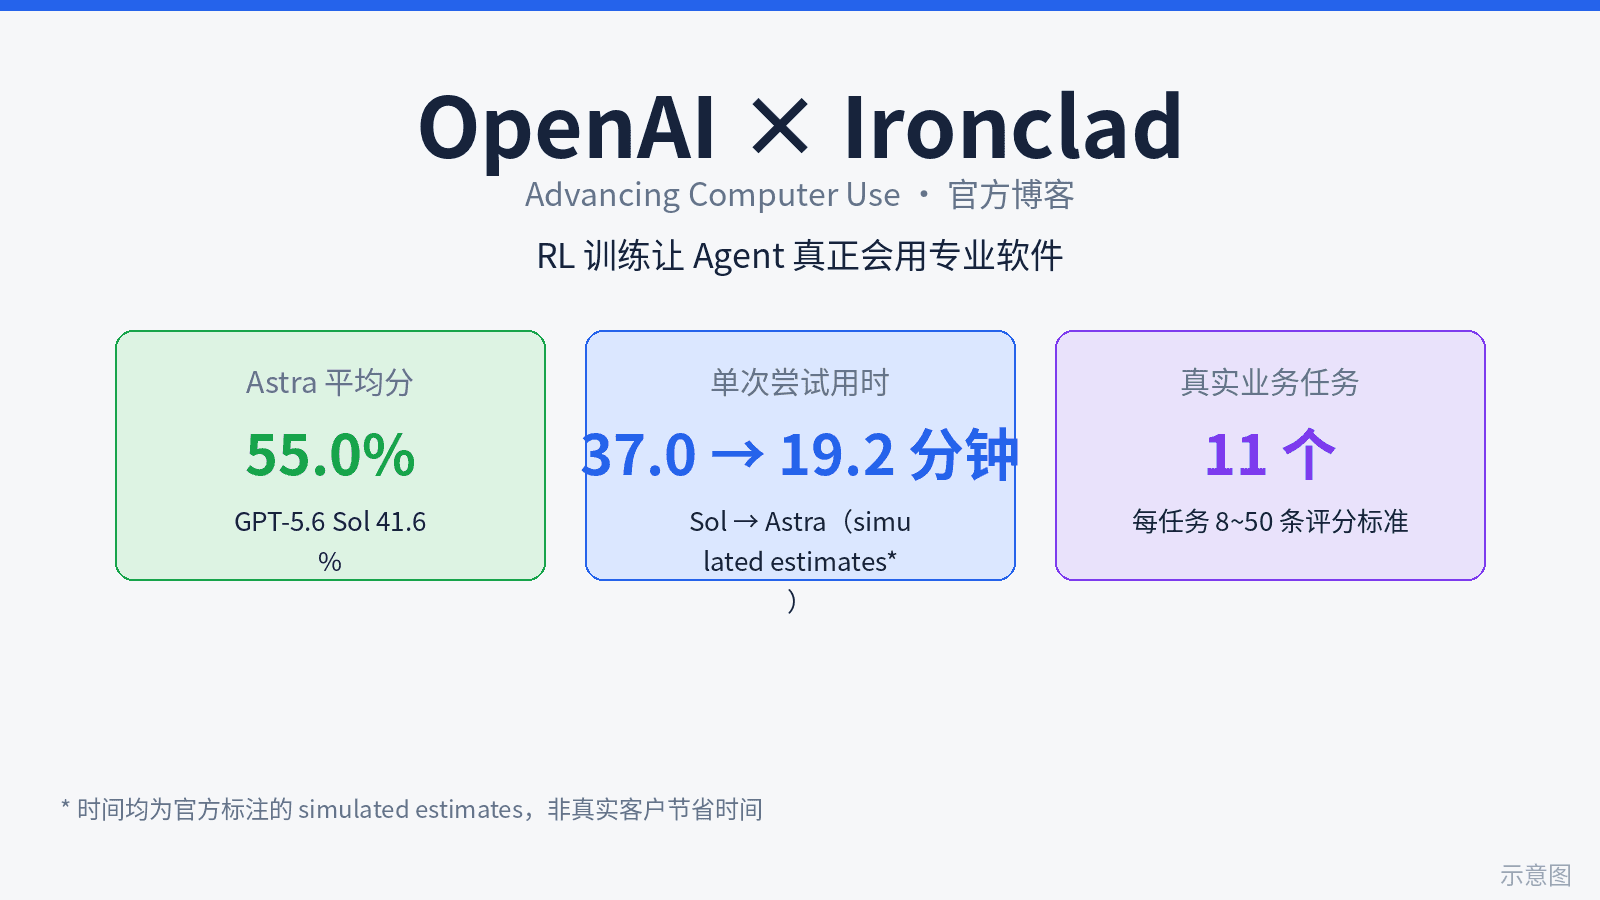
OpenAI 官方博客《Advancing computer use with Ironclad》标志着范式转移:Computer Use 从通用能力展示转向按应用定制训练。首款在 Ironclad 任务上训练的前沿模型 GPT-6 Astra,在 11 道专家设计的合同任务(每道 8~50 条评分标准)上拿到 55.0% 对 41.6%,单次估计耗时从 37.0 分钟降到 19.2 分钟。护城河正在从模型搬到「合作伙伴名单」——而 OpenAI 正在公开招募下一批软件公司。