OpenAI 给 Agent 找了个「陪练」:Ironclad 合同流变成 11 道训练题,Astra 得分超 Sol 三成
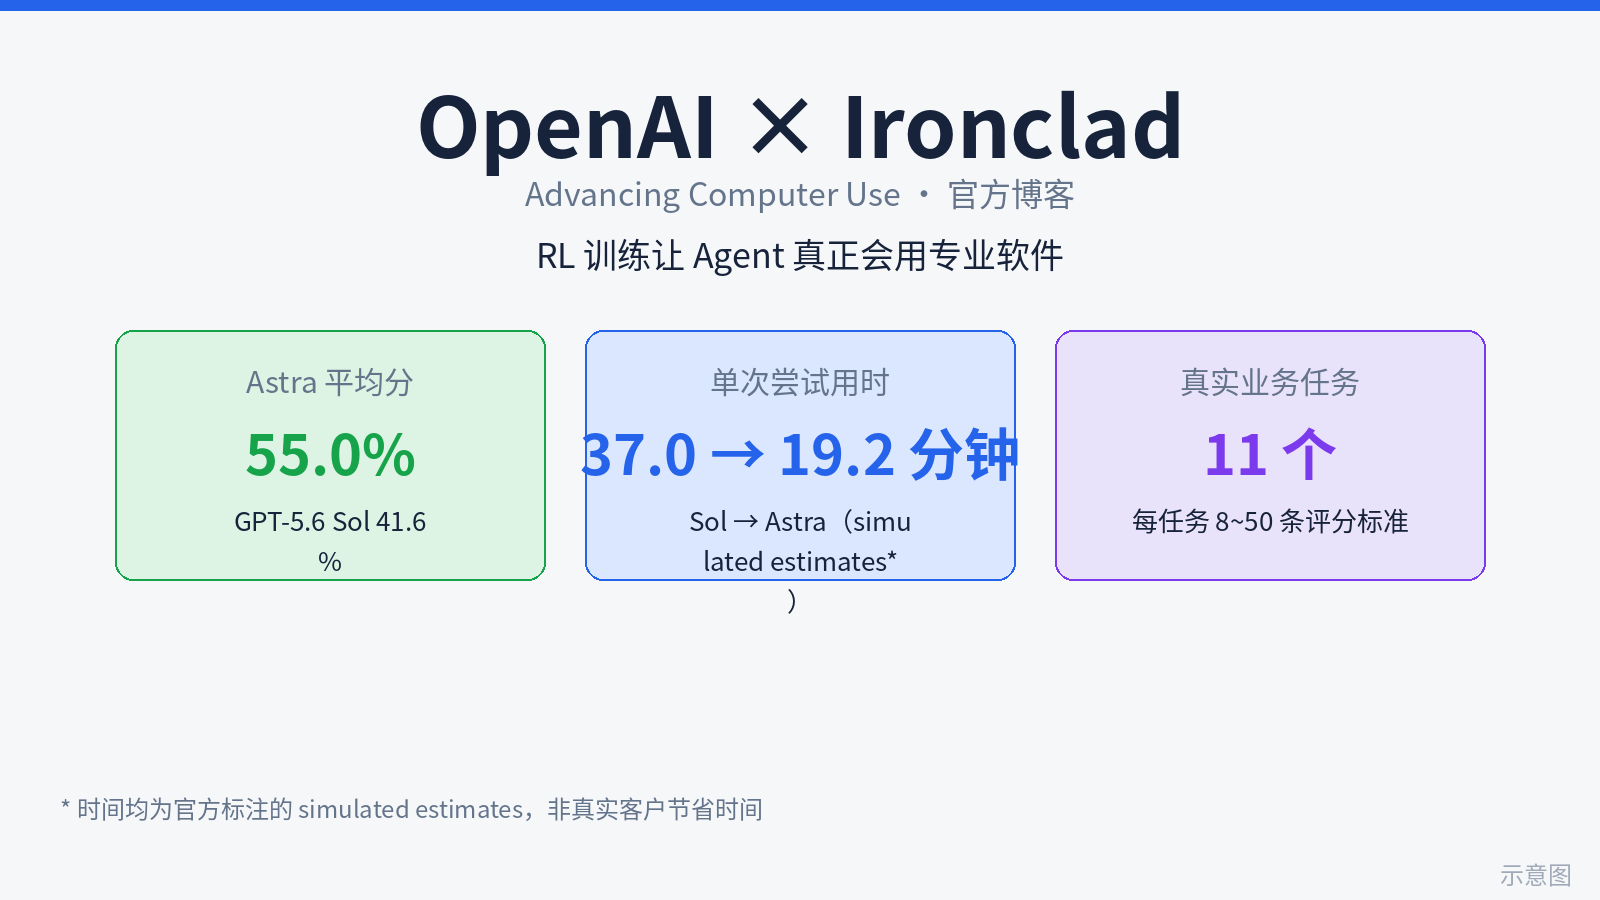
OpenAI 官方博客《Advancing computer use with Ironclad》标志着范式转移:Computer Use 从通用能力展示转向按应用定制训练。首款在 Ironclad 任务上训练的前沿模型 GPT-6 Astra,在 11 道专家设计的合同任务(每道 8~50 条评分标准)上拿到 55.0% 对 41.6%,单次估计耗时从 37.0 分钟降到 19.2 分钟。护城河正在从模型搬到「合作伙伴名单」——而 OpenAI 正在公开招募下一批软件公司。
陪练时代来了:OpenAI 给 Agent 找的第一份"真工作"是合同
先说结论:OpenAI 的 Computer Use(计算机使用)能力,正式从"通用能力展示"转向"按应用定制训练"。10 月 6 日(日期口径见文末),OpenAI 官方博客发布《Advancing computer use with Ironclad》,开篇第一句就把调子定死了:"Our first partner is Ironclad, a leader in AI contracting." 第一位合作伙伴,是做合同管理软件的 Ironclad。而 GPT-6 Astra,是"our first frontier model trained on Ironclad tasks"——第一款在 Ironclad 真实任务上训练过的前沿模型。
这件事为什么值得一篇深度稿?因为它标志着 agent 训练范式的一个转折点:以后可能不再是"一个通用模型学会用所有软件",而是"每个专业软件都值得一份专属训练"。OpenAI 把话挑明了:正在邀请 "a small number of software companies to work directly with our research and engineering teams"——一小批软件公司,直接跟 OpenAI 的研究和工程团队合作。注意,这不是 API 对接合作,是训练合作。
11 道训练题,每道 8 到 50 条评分标准
训练到底长什么样?OpenAI 的配方写得很具体:"Ironclad employees and people who use Ironclad at OpenAI helped our researchers identify 11 tasks across legal, commercial, and procurement work." Ironclad 自己的员工,加上在 OpenAI 内部日常使用 Ironclad 的人,一起从法务、商务、采购三条业务线里挑出了 11 个任务:搭一份保密协议(NDA)流程、建一个采购审批流、按对方选择的管辖区更新一条可复用的法律条款——全是法务和采购每天真实会干的活。
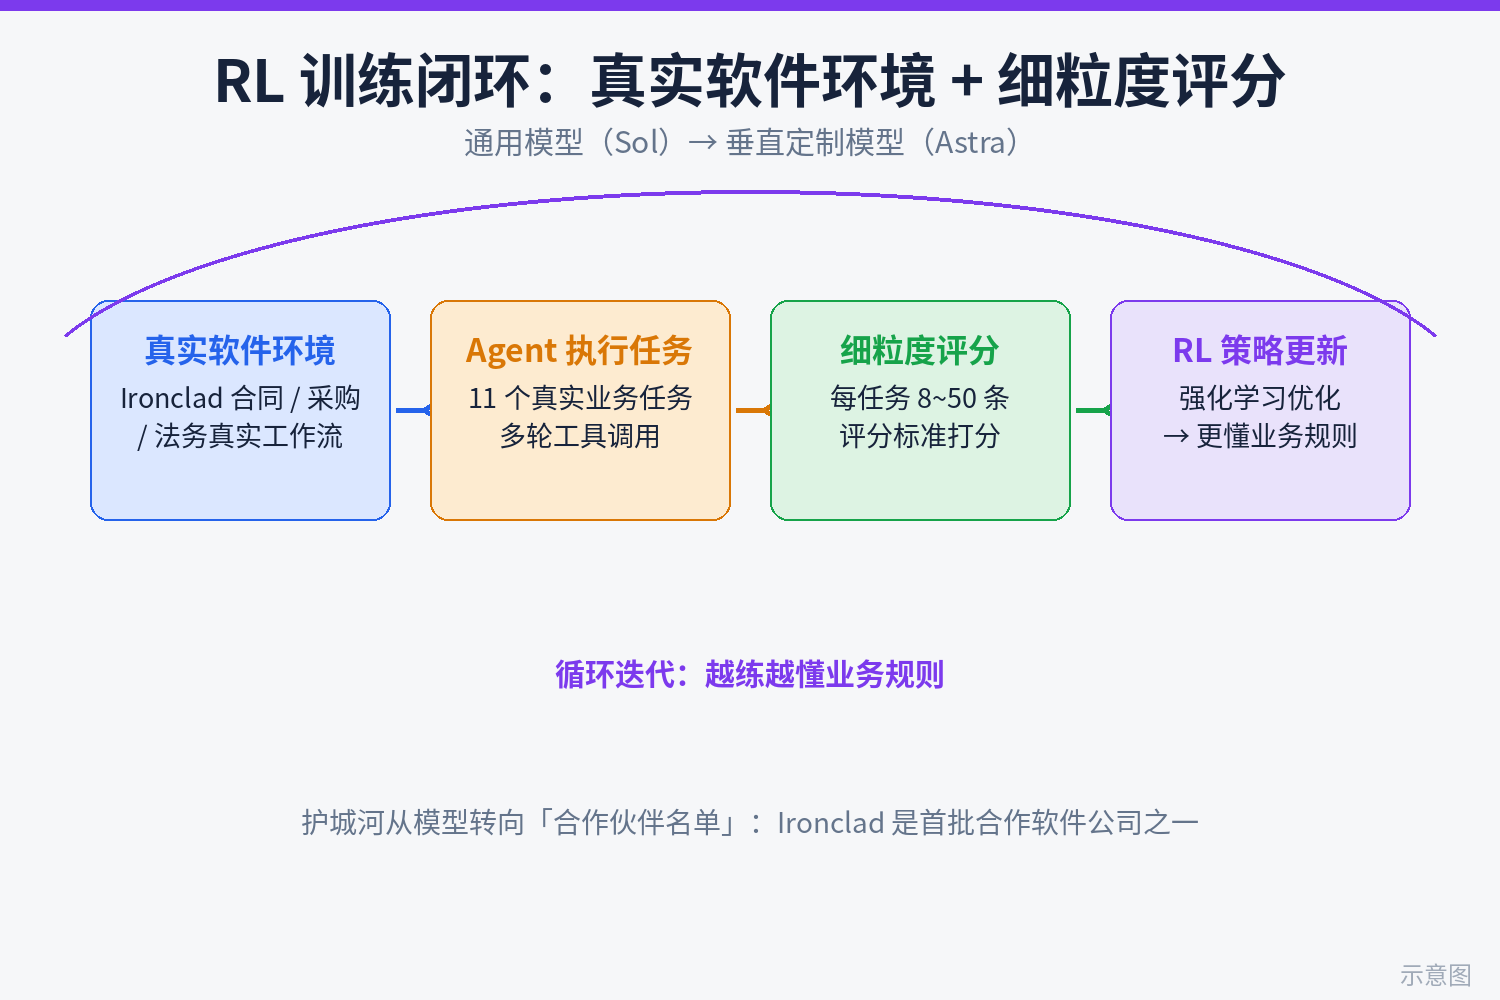
关键不在 11 这个数字,而在评分密度:"We evaluated each task against 8 to 50 criteria"——每个任务有 8 到 50 条评分标准,视复杂度而定。这就是 RL(强化学习)训练里最贵的那部分:reward 信号不是"做完了吗"这种二值判断,而是一份由领域专家手写的细粒度 rubric(评分细则)。管辖区写对了吗?审批链节点齐了吗?NDA 的生效日期逻辑对吗?8 到 50 条,每条都是一次判分,模型每走一步都在被这套尺子量。
这是我的判断:这篇博客真正的标题不该是"OpenAI 找了个合作伙伴",而是"RL 训练的原材料第一次被摆上台面"。过去一年,agent 圈把 RL 挂在嘴边,但公开谈的几乎都是算法和算力;真正决定能力上限的东西——真实软件环境、专家设计的任务、细粒度评分标准——一直藏在各家实验室里。这次 OpenAI 把配方公开了:11 个任务、8~50 条标准、领域专家出题。以后再讨论"为什么我的 agent 在专业软件上总翻车",先对照这三样,看看自己缺了哪样。
数字:55.0% 对 41.6%,19.2 分钟对 37.0 分钟
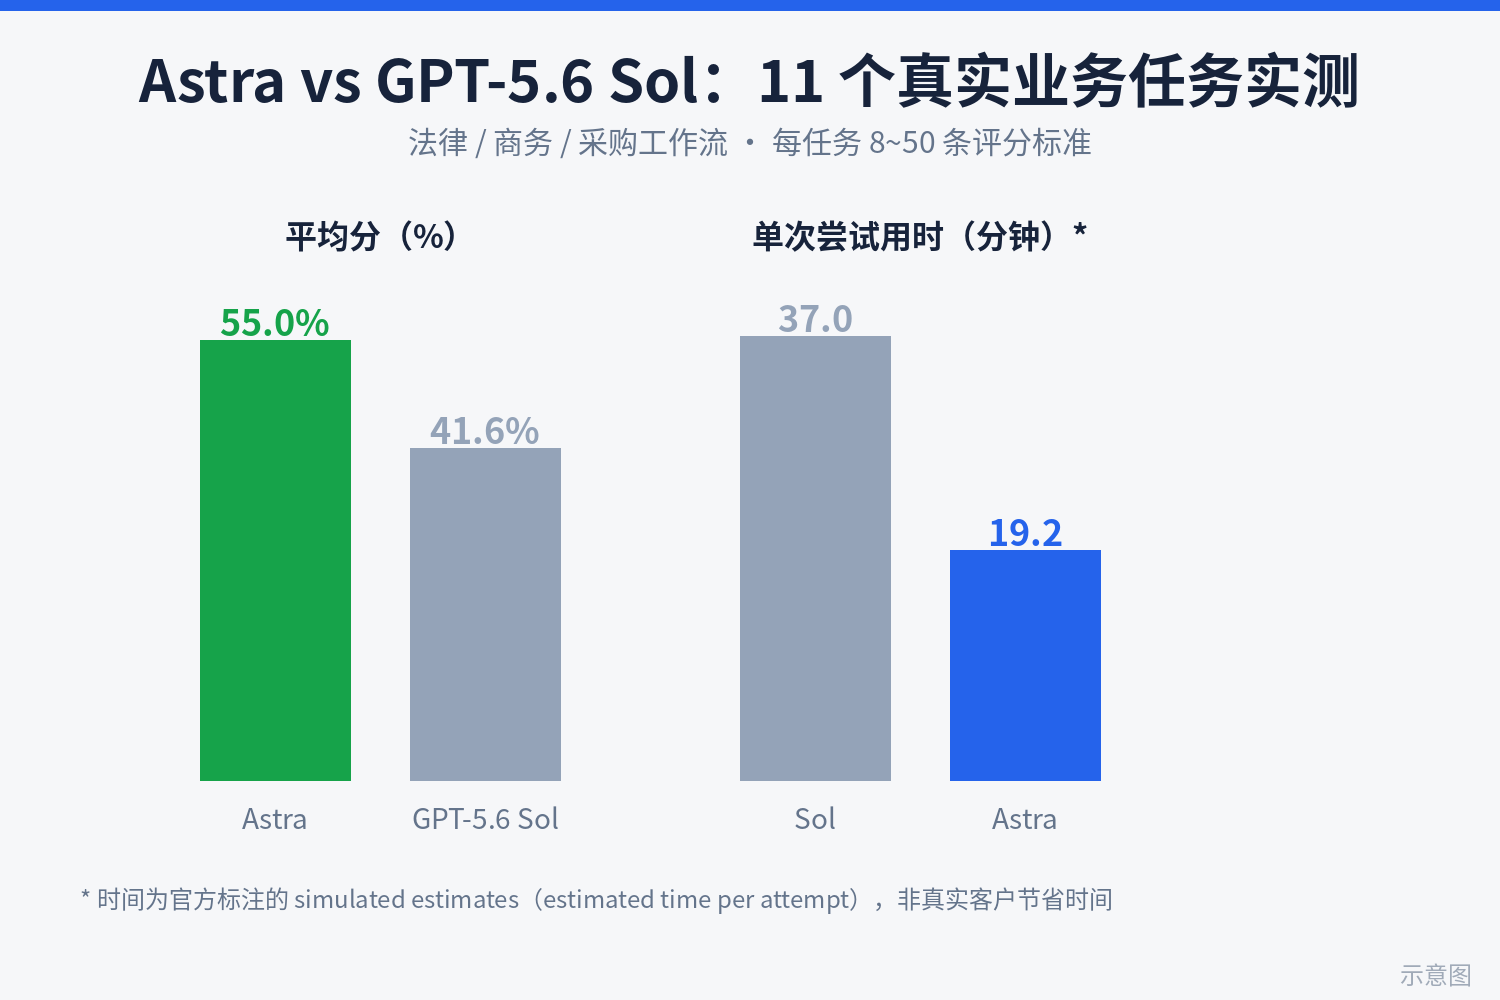
成绩单原文是这么写的:"Astra's average score was 55.0%, compared with 41.6% for GPT‑5.6 Sol, while estimated average time per attempt fell from 37.0 minutes for Sol to 19.2 minutes for Astra." 平均分从 41.6% 涨到 55.0%,OpenAI 自己算的是 32% higher;单次尝试的估计耗时从 37.0 分钟降到 19.2 分钟,48% lower。对比口径也交代了:Astra 开 Max 推理档、Sol 开 High 推理档,各取各自表现最好的设置。
算一笔直白的账:分数涨了三分之一,时间砍了一半。又好又快,而且是同时发生的——这在 agent 评测里不常见。通常"更快"意味着"更草率",分数和速度是跷跷板;这里两头都赢,说明提升不是靠"少想几步",而是靠"真的更会干这活"。这正是定制训练和通用模型最本质的区别:通用模型是在"推理",定制模型是在"熟练"。熟练工干活,又快又好,天经地义。
还有一个容易被一扫而过的数字:"An internal model used in the development of Astra achieved an even stronger 63.7% on these tasks"——开发过程中用过的一个内部模型,在这 11 道题上拿到了 63.7%。官方没细说这是什么模型,但信号很清楚:这套 rubric 还有 headroom(上升空间),55% 不是天花板。我的判断是,63.7% 这个数字是写给下一批合作伙伴看的:瞧,路还长,蛋糕还大,赶紧上车。
诚实注脚,官方原话必须先摆出来:所有时间数字都是 "estimated time per attempt"——模拟估算,不是真实客户省下来的时间。二级来源也都专门强调了这一点:时间是基于假设的模型处理与生成速度算出来的模拟值。所以看 48% 的时候,脑子里要自动换算成"实验室条件下的相对提速",而不是"法务部明年能砍一半人头"。数字是真的,但口径是模拟的——这篇稿子后面所有的"快",都带着这个限定词。
55% 和 41.6% 之间,差的不是"会不会用软件"
55.0% 对 41.6%,只差 13.4 个百分点。看起来不大?换个角度想:这 13.4 个点,买的是"懂业务规则"。Sol 不是不会点 Ironclad 的按钮——Computer Use 的通用能力早就教会了模型"看屏幕、点按钮、填表单"。Sol 丢的分,丢在"管辖区选错了""审批链少了一个节点""条款版本用旧了"这种地方。翻译一下:操作都会,业务不懂。
这恰恰是过去一年企业 agent 落地最痛的地方。Demo 里 agent 把 CRM、ERP 点得飞起,一上线就翻车:不是点错了按钮,而是违反了业务规则——给客户发了不该发的折扣、把审批跳过了关键节点、合同里留了合规窟窿。"会操作软件"和"会干这份工作"之间,隔着一整套隐性业务规则,而这套规则写在老员工脑子里、写在公司 wiki 里,从来没写进过训练数据。Ironclad 这 11 道题做的,就是把这套隐性规则显性化:8 到 50 条评分标准,本质上是一份"这份工作到底怎么做才算对"的操作手册。
所以我的判断是:以后评价一个企业 agent,别先看它"支持多少软件",先问"它在每个软件上做过多少道带评分标准的题"。前者是 marketing 数字,后者才是能力数字。OpenAI 这次等于公开了一种新的能力货币:任务数 × 评分标准密度。Ironclad 是 11 ×(8~50),下一个合作伙伴会是多少?这个乘积,会成为各家 agent 厂商心照不宣的军备竞赛指标。
护城河搬家了:从模型到"合作伙伴名单"
把视角拉高一层。这篇博客最耐人寻味的不是数字,而是这句:"We're inviting a small number of software companies to work directly with our research and engineering teams." 翻译一下:OpenAI 在公开招募下一批"陪练"。名额有限(small number),合作深度是"直接跟研究和工程团队一起工作"。
想想这意味着什么。过去 agent 的护城河在模型:谁的模型更聪明,谁赢。现在 OpenAI 把护城河往下挪了一层,挪到了"谁手里有真实软件环境 + 专家任务 + 评分标准"。模型可以追,算力可以买,但"Ironclad 的法务专家愿意坐下来给你出 11 道题、写几百条评分标准"——这种合作资源是排他的、慢的、不可复制的。今天是 Ironclad,明天可能是 Salesforce、ServiceNow、Workday……名单每长一个名字,就有一类专业工作的 agent 能力被"定制"走一块。
这对做垂直 SaaS 的读者是个直接信号:窗口期现在是开着的,而且是"small number"限量版。如果你的软件有一套复杂的专业 workflow(法务、财税、医疗、工程),而你还没有 agent 战略——OpenAI 正在找的就是你。反过来想:如果你的竞争对手先上了这份名单,agent 版本的"某某软件熟练工"就先长在对面家里了。这种合作一旦开始,数据飞轮(任务→评分→训练→更好的 agent→更多用户行为)是向合作方倾斜的,先上车和后上车吃的不是同一个红利。
再补一个呼应:本站之前写过的 Decisions API 那篇,讲的是"判断模型"解决"选什么";这次 Ironclad 合作,解决的是"怎么干"。判断层 + 执行层,OpenAI 在 agent 基础设施的两层同时落子:Decisions API 把"做决定"变成标准件,Ironclad 合作把"干专业活"变成可训练、可评分、可复制的流程。两篇连起来看,OpenAI 的 agent 路线图已经很清楚了:通用底座 + 按应用定制 + 按环节标准件。
给开发者的信号:别再只卷 prompt 了
说点今晚就能动手的东西。如果你正在给某个专业软件做 agent(自己的 SaaS,或者客户的内部系统),这篇博客给了一套可以直接抄的作业:
- 先找"出题人",再调模型。Ironclad 模式的第一步不是"换更大的模型",而是"找最懂这份工作的人写 11 道题"。你团队里最资深的那位业务专家,比任何 prompt 工程师都值钱。让他把"这份工作做对的标准"一条条写下来——那就是你的 rubric,就是你的 reward 信号。
- 评分标准要细到"业务规则"级别,别停在"操作完成"级别。8 到 50 条这个密度是参考线:只评"表单提交成功了吗"是 1 条,评"管辖区、审批链、条款版本、生效日期逻辑"才是 30 条。agent 在专业软件上翻车,翻的永远是后者。
- 时间指标也要进评测。OpenAI 同时报了分数和 "estimated time per attempt",模拟口径也坚持要报。企业 agent 的 ROI 叙事里,"又快又好"是两个独立维度——只报准确率,业务方是无感的。
- 想清楚你要不要当"陪练"。如果你是垂直 SaaS 厂商,OpenAI 的招募是双向选择:你出环境、出专家、出任务,换回来的是"你的软件"在最强模型上的原生熟练度。这笔账值得算一算,窗口期不会一直开着。
质疑同样要说在前面
掌声放一放,质疑有四条,每条都硬。
第一,出题的人和判分用的是同一套题。FourWeekMBA 的点评一针见血:Astra 是 "trained on Ironclad tasks",考的也是"11 research tasks chosen with the same partner"——训练和测试同源。32% 的提升里,有多少是"真学会了合同工作",有多少是"把这 11 道题背熟了"?官方没有做跨软件、跨合同类型的泛化测试。在看到"Ironclad 上训出来的模型,去用别家的合同软件也好使"之前,这个数字先打个折听。
第二,时间口径是模拟的,前面已经说过,这里不再赘述,但必须再钉一遍:48% lower 是 "estimated",不是客户实测。任何把这个数字直接写进 ROI 测算 PPT 的人,都是在拿实验室数据当生产数据。
第三,55% 的绝对值仍然不高。11 道题,专家手把手出题、几百条标准喂进去,前沿模型也才 55%。合同是高风险场景:一条管辖区写错,可能就是一场官司。55% 意味着"几乎每两道题就错一道"——这个水平离"无人值守"还差得远,离"有人监督下提效"倒是近了。看绝对值,别只看相对提升。
第四,"small number"本身就是个问题。OpenAI 的名单是有限的、先到先得的。这意味着 agent 的"专业能力"正在变成一种分配制资源:谁先合作,谁的软件先被"定制熟练"。小厂商、开源软件、长尾行业的软件,可能根本排不上这趟车。护城河从模型转向合作伙伴名单的同时,能力的分配也从"技术问题"变成了"关系问题"——这对生态不一定是好事。
但这四条都不动摇我的核心判断:范式是真的,数字是打折的。Computer Use 的下半场不是"更通用的模型",而是"更专用的训练";agent 做专业软件,从此不再是 prompt 工程的活,而是"真实环境 + 专家任务 + 细粒度评分"三件套的活。Ironclad 是第一块多米诺骨牌,名单上的下一个名字,才是真正值得盯的。
本文一手来源:OpenAI 官方博客《Advancing computer use with Ironclad》。日期口径透明说明:官方博客页正文无可见日期戳;mediarelease.co、fourweekmba、bytewatchr、subagentic 四家独立二级来源及 OpenAI 官方 LinkedIn 帖一致标注为 2026-10-06,本篇采用该日期。二级核实:FourWeekMBA、Subagentic。
原始来源
相关文章
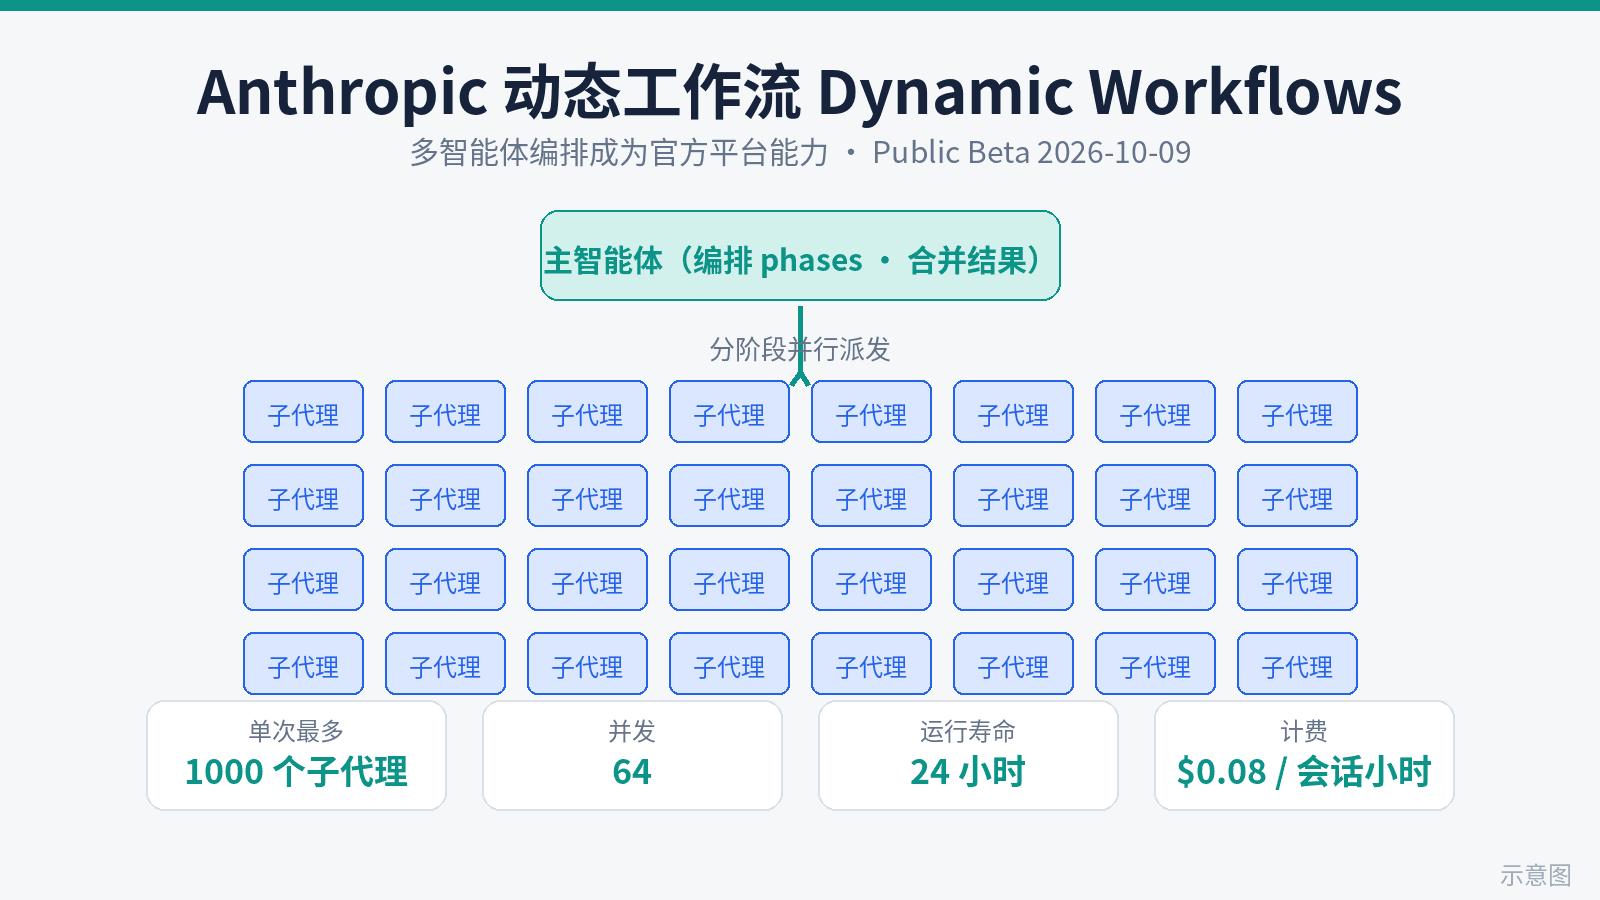
10 月 9 日,Anthropic 把 Claude Managed Agents 的动态工作流推进 public beta:agent 自己写编排程序,分阶段跑很多 agent 再合并结果——单次 run 最多起 1000 个 agent、64 个并发、默认 24 小时寿命、单 session 最多 10 个 run 并行。这次发布自带火药味:一位 OpenAI 资深工程师刚公开称 agent swarm 是“浪费 token”,Anthropic 随即贴出对照实测——11.6 万行代码埋 70 个 bug,单个 agent 三次找出 14/15/27,workflow 三次每次找出 66。计费是各模型正常 token 费率外加 $0.08/会话小时。本文深挖成本模型与适用场景:仓库级审计、迁移、批量文档评审是 workflow 的形状;实时交互和小任务还是单 agent 的形状。
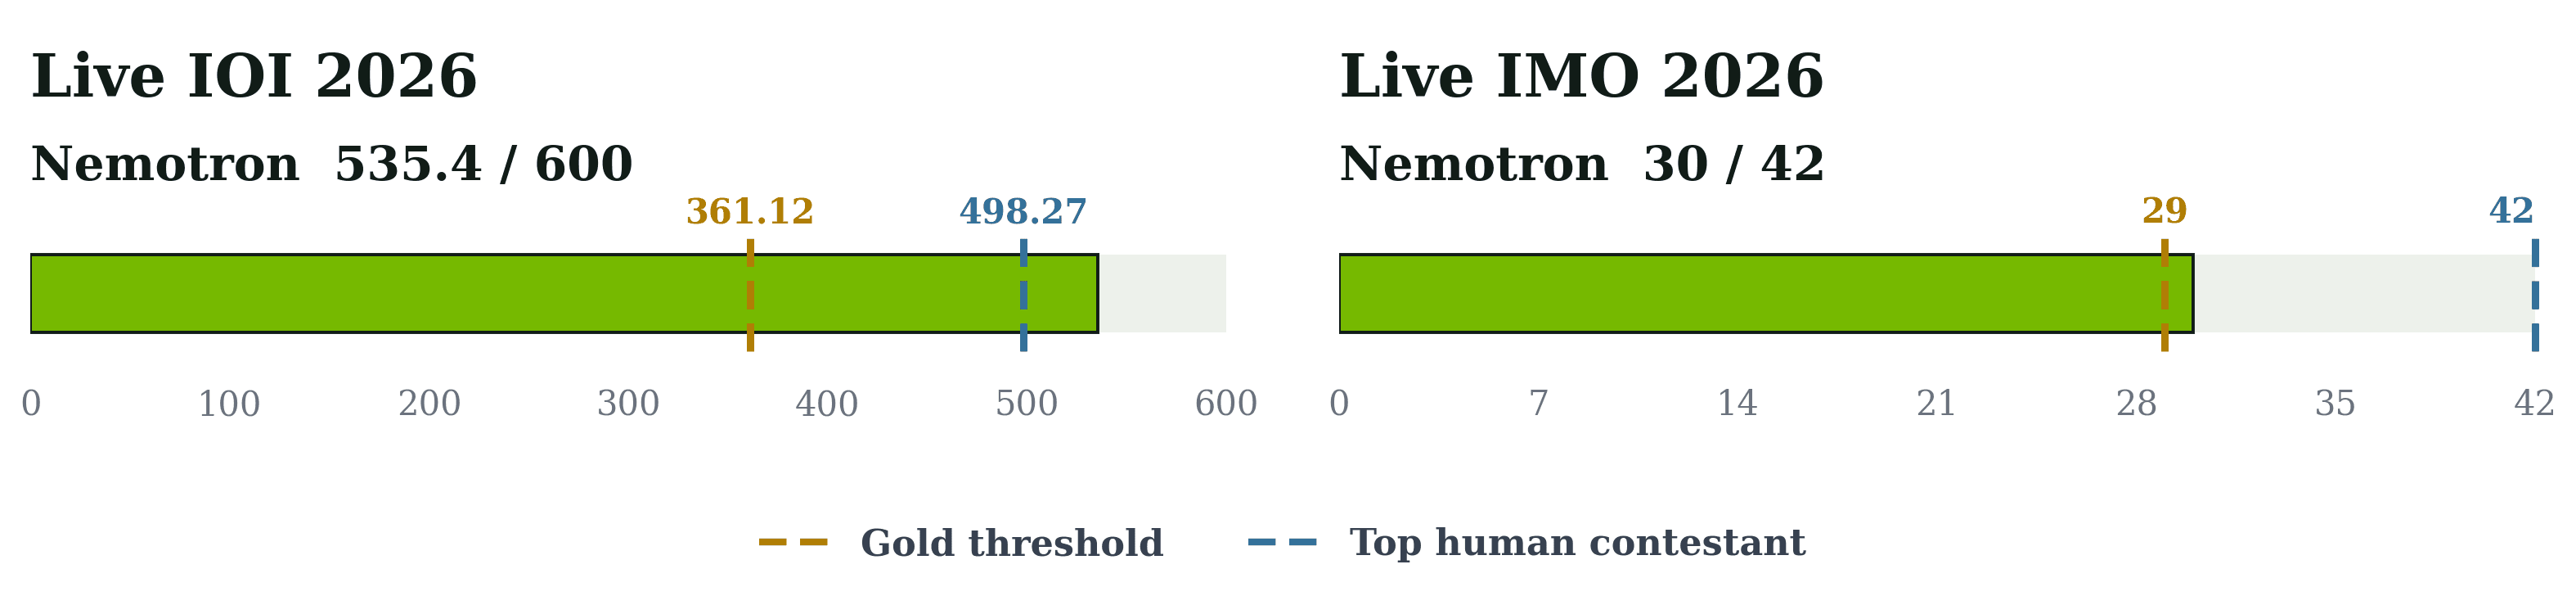
NVIDIA 的 Nemotron 系统在 IOI 2026 拿下 535.4/600(非官方跑分,超过人类最高分 498.27)、在 IMO 2026 拿下 30/42(官方阅卷,越过 29 分金牌线),并把整套配方全部开源:SFT 与 RL 的 checkpoint、两份训练数据集、全新的 200 道奥赛级数学 benchmark、推理管线与 prompt。核心方法是模型、数据、推理循环的协同设计:GenCorrect 的生成-评估-改进循环把 291 分的模型推过 438.3 的金牌线。对一人公司而言,这是一份生产级的测试驱动 agent 循环模板。
蝴蝶效应完成超 5 亿美元融资,博裕、IDG 领投,腾讯、红杉中国、真格加持,目标估值约 40 亿美元。从 Meta 20 亿美元收购告吹到恢复独立一个月,Manus 2.0 与个人智能体 Cue 同步发布,国产通用 Agent 上演绝地反弹。