Claude 官方下场做 Agent 编排:动态工作流公测,单次跑 1000 个子代理
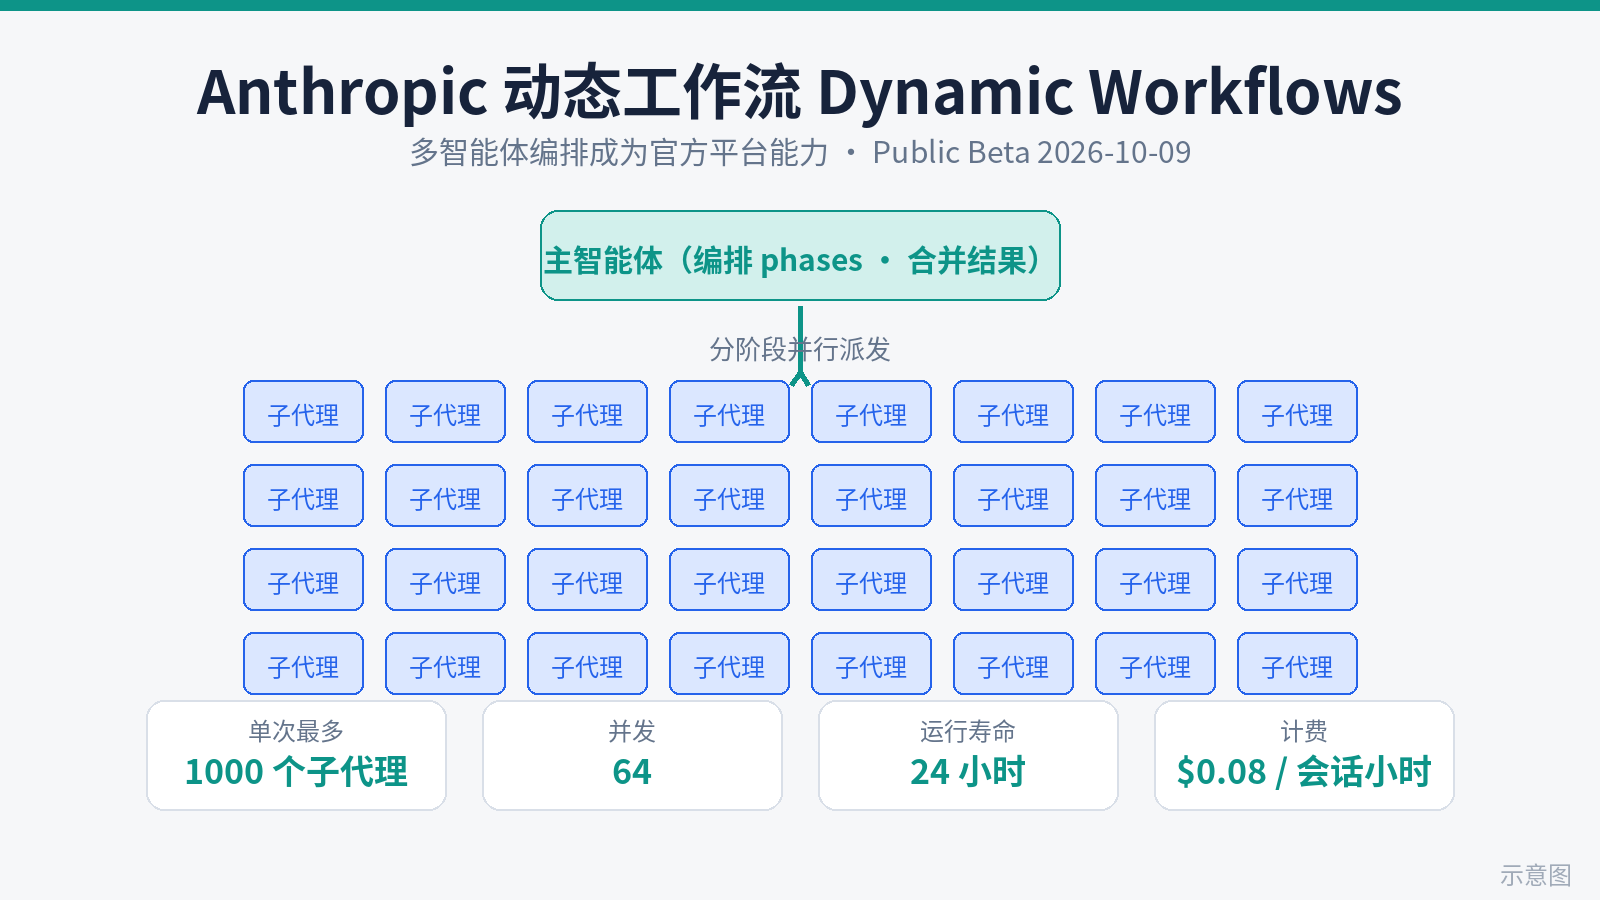
10 月 9 日,Anthropic 把 Claude Managed Agents 的动态工作流推进 public beta:agent 自己写编排程序,分阶段跑很多 agent 再合并结果——单次 run 最多起 1000 个 agent、64 个并发、默认 24 小时寿命、单 session 最多 10 个 run 并行。这次发布自带火药味:一位 OpenAI 资深工程师刚公开称 agent swarm 是“浪费 token”,Anthropic 随即贴出对照实测——11.6 万行代码埋 70 个 bug,单个 agent 三次找出 14/15/27,workflow 三次每次找出 66。计费是各模型正常 token 费率外加 $0.08/会话小时。本文深挖成本模型与适用场景:仓库级审计、迁移、批量文档评审是 workflow 的形状;实时交互和小任务还是单 agent 的形状。
一次"带实测的官宣":Anthropic 把 agent 编排收编了
10 月 9 日,Anthropic 把 Claude Managed Agents 的动态工作流(dynamic workflows)推进了 public beta。官方发布说明只用一句话定义它:"A workflow is a program that runs many agents in phases and combines their results."——一个 workflow 就是一段程序,分阶段跑很多 agent,再把结果合起来。
但这条新闻真正值得读的不是功能本身,而是它带着的火药味。就在不久前,一位 OpenAI 的资深工程师公开称 agent swarm 是在"浪费 token"。Anthropic 的回应方式很 Anthropic:没吵架,直接贴了一份对照实测——在 11.6 万行代码里埋了 70 个 bug,单个 agent 三次分别找出 14、15、27 个,而 workflow 三次每次都找出 66 个。14–27 对 66,这就是 Anthropic 对"浪费 token"论的回答。
先给结论:这是 agent 编排从"各家手搓"变成"官方平台能力"的关键一步。过去一年,LangChain、CrewAI 和无数独立开发者的深夜代码里,多智能体编排都是手搭的脚手架——写 fan-out 逻辑、管并发、收结果、做重试。现在 Anthropic 把这整套东西收进了平台:你描述任务,agent 自己写编排程序,服务器在后台跑。对独立开发者来说,决策点不在"酷不酷",而在token 经济账:64 并发、24 小时运行寿命、$0.08/会话小时——什么时候该用,什么时候该省。这篇把账算清楚。
动态工作流到底是什么:agent 写的"程序",不是你写的
先钉死一个关键区别。Managed Agents 之前就有 subagents:主 agent 把任务派给子 agent,还能随时追问。但动态工作流是第二种模式——主 agent 写一段程序(workflow),程序自己决定分几个阶段、起多少 agent、结果怎么传、失败了怎么办,然后服务器在后台执行它。主线程空出来继续跟你说话。
你不需要调一个"启动 workflow"的 API。你在消息或 system prompt 里描述工作,agent 自己判断要不要起一个 run。run 按命名阶段推进,每个 agent 在自己的 session thread 里工作,结果回到程序里,再由程序传给下一个 agent。代价是控制权:run 一旦启动,agent 就不能再给它的 threads 发后续消息——程序按写好的逻辑跑到底,服务器在 run 结束时归档每个 thread。
这个"agent 写程序、服务器跑程序"的结构,是整件事最值得品味的设计。过去的多 agent 框架是"你写编排代码,模型填内容";现在反过来了——编排逻辑本身也是模型生成的。阶段怎么切、agent 怎么分工、结果怎么合并,这些以前要人拍板的架构决策,现在由 agent 在运行时动态决定。这就是"动态"二字的含义:不是跑一个你写死的 DAG,而是让 agent 现场写 DAG。
极限参数:1000、64、24 小时、10
官方文档把上限写得很直白,逐字引用:"A run can start up to 1,000 agents over its life, with up to 64 working at once, a 24-hour default lifetime and up to 10 runs open per session by default." 翻译一下:一个 run 在整个生命周期里最多起 1000 个 agent,同时最多 64 个在干活,默认 24 小时寿命,一个 session 里默认最多同时开 10 个 run。
几个细节值得注意。第一,1000 是"起过的 agent 总数",不是线程数——失败的 agent 会在新线程上重跑,所以线程数可能超过 1000,超限会以 thread limit error 结束 run。第二,64 并发是上限不是保证,官方文档注明了这一点。第三,run 之间不嵌套:只有主线程上的 agent 能起 run,run 里的 agent 不能再起 run。第四,24 小时是默认寿命,agent 可以设更短,但暂停(比如撞到预算上限)不会暂停寿命计时。
开启方式同样是一行配置的事:"Set the agent's multiagent type to multiagent_20261001 with the managed-agents-2026-04-01 beta header." 把 agent 的 multiagent 类型设为 multiagent_20261001,带上 managed-agents-2026-04-01 这个 beta header。用上这个类型,workflows 默认就是开的——然后你在 system prompt 里告诉 agent 什么情况下该起 run,之后通过 session 事件流上的 workflow_run.* 事件跟踪进度。
我的判断:这组参数是按"夜间批处理"设计的,不是按"实时交互"设计的。24 小时寿命、后台运行、事件流跟踪——Anthropic 脑子里想的场景是:你下班前丢一个"把这 300 份合同里带控制权变更条款的找出来"的任务,第二天早上收结果。官方文档里的示例也正是 300 份合同的审查。这解释了为什么控制权要让渡:长时间、宽并行的任务,本来就不需要人实时盯。
70 个 bug 的实测:真正的信息藏在方差里
官方原文:"We planted 70 bugs in a 116k-line codebase. Across 3 runs, a single agent found 14, 15 and 27 bugs. A workflow consistently found 66 in each of its 3 runs."
先算百分比:单个 agent 三次分别是 20%、21%、39%;workflow 三次都是 94%。均值差距是 3 倍多(约 19 对 66),但真正的信息在方差里:单个 agent 最好的一次(27)和最差的一次(14)差了近一倍,而 workflow 三次跑出了一模一样的 66。对生产环境来说,这个"三次一致"比"66"这个数字本身更值钱——可重复性才是能进生产的前提,一次 94%、一次 40% 的系统,没人敢把它放进 CI。
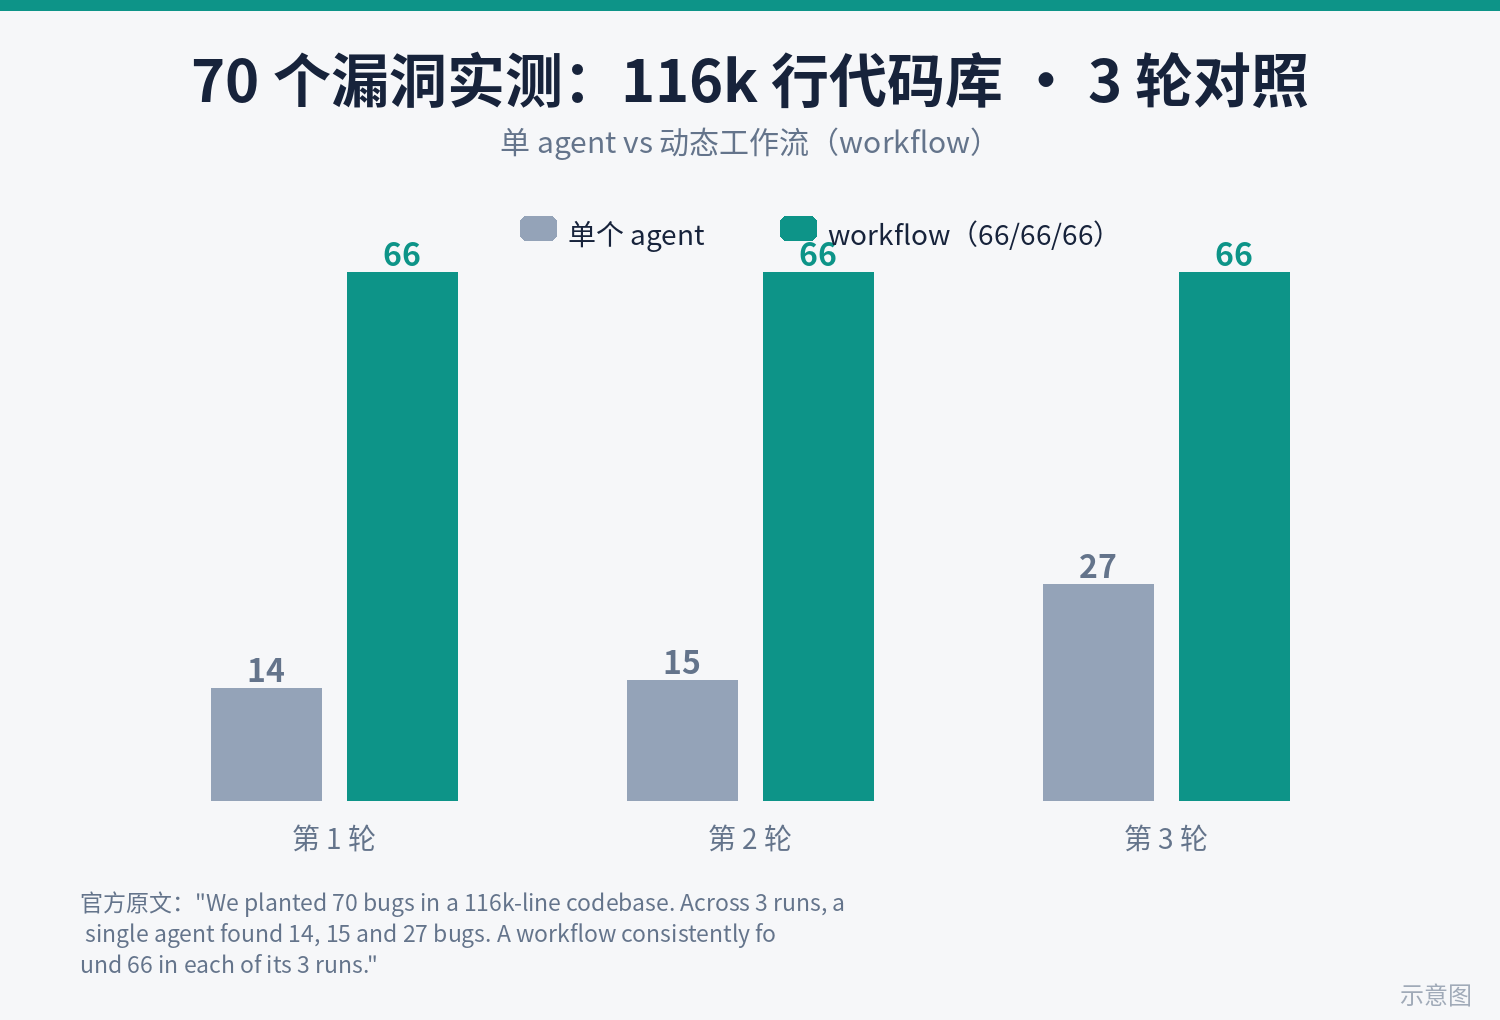
为什么 workflow 稳这么多?机制上不难理解:单个 agent 是"一个人从头读到尾",注意力、运气、上下文窗口都在跟 11.6 万行代码较劲;workflow 是"把代码库切成几十上百块,每块派一个专职 agent 细读,再把结果合并"。这是用并行度换覆盖率的经典路数——人海战术在代码审计这个场景下,赢的不是智商,是"每行代码都被认真看过一遍"的工程纪律。
但这份实测有三处必须打问号,Anthropic 自己也没藏着。第一,这是它自己出的题、自己判的分:自家代码库、自家埋的 bug,没有独立第三方复现。第二,没给 token 账单:66 个 bug 背后烧了多少 token、多少钱,官方一个字没提——而这恰恰是"浪费 token"争论的核心。第三,bug 找全了不等于 bug 修对了,实测只测了"找到",没测"修好"。所以我的立场是:方向性证据成立,数字别当圣经。等独立团队拿自己的代码库跑出第二组数字之前,94% 前面先加个星号。
成本账:真正要算的不是那 1.92 美元
官方计费原文:"its agents' tokens bill like the rest of the session, at each model's rates, and Managed Agents adds session runtime at $0.08 per session-hour." 一个 run 没有自己的定价:它起的 agent 们的 token 按各模型的正常费率结算,Managed Agents 额外收 session 运行时的钱,每小时 0.08 美元,只在 session 运行时计费。
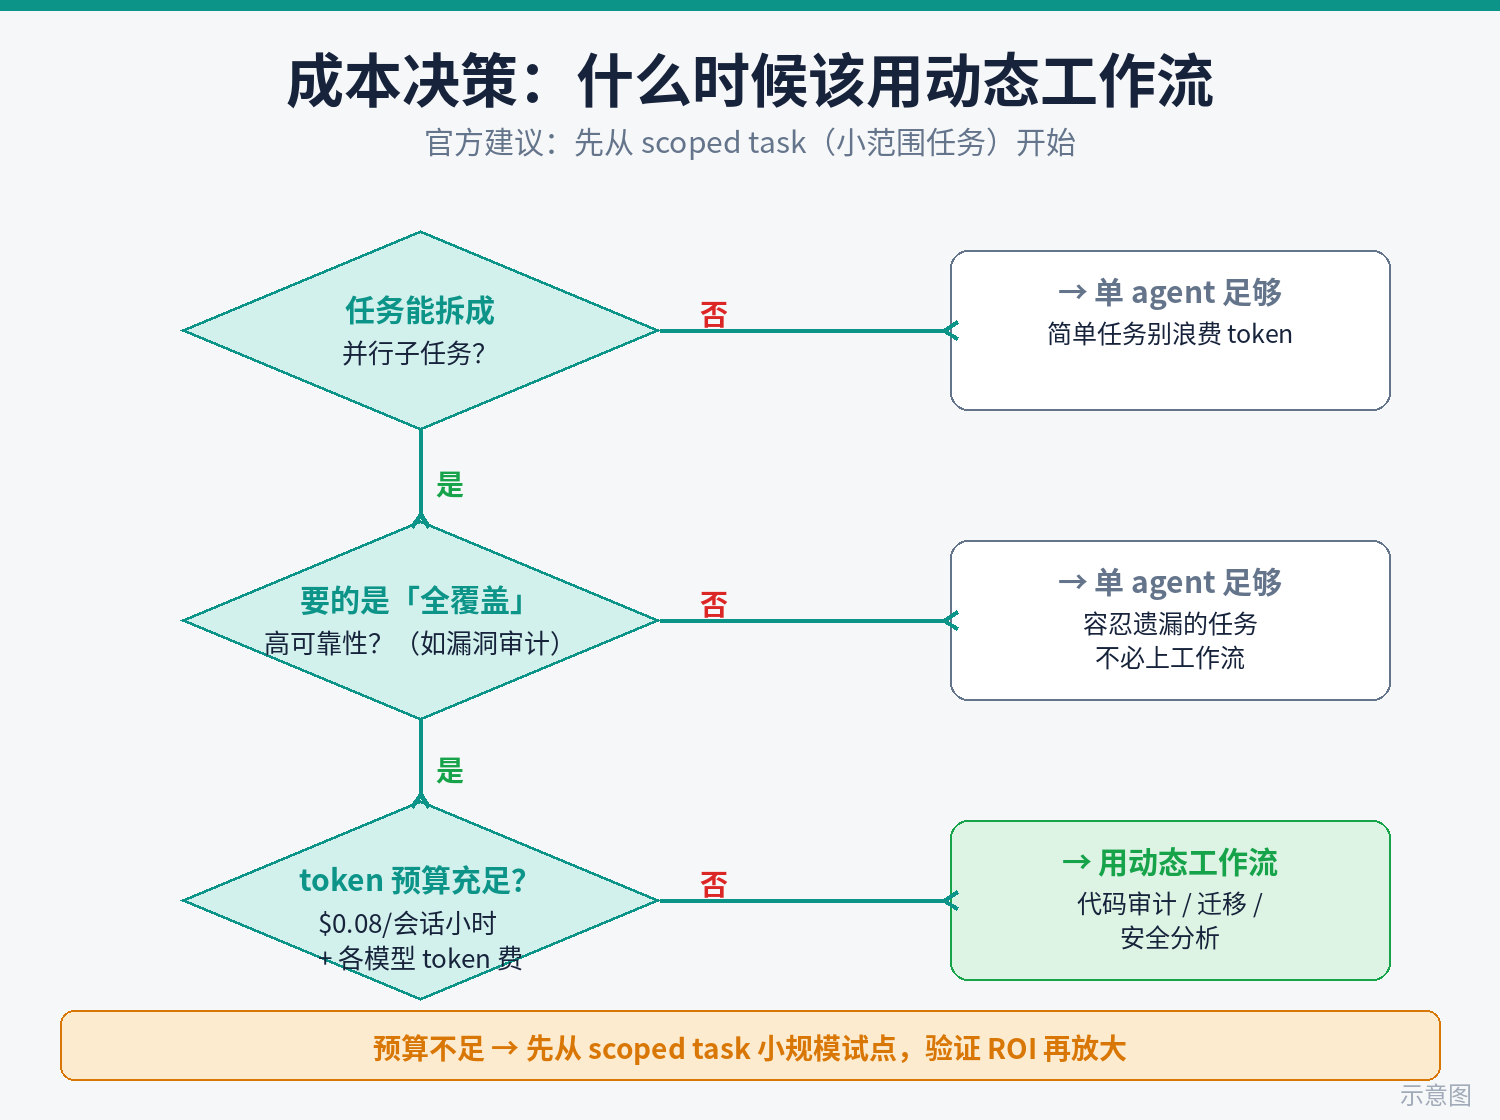
先算一笔死账:24 小时跑满,session runtime 部分是 24 × 0.08 = 1.92 美元。不到两美元——基础设施部分便宜到可以忽略。真正的账单在 token 那边:1000 个 agent,每人一份 system prompt、一份任务上下文、若干轮工具调用,token 是按 agent 个数线性放大的。Anthropic 自己也承认:"Dynamic workflows are powerful and can use a lot of tokens, so we suggest starting with a scoped task."——动态工作流很强大,也很能烧 token,建议从范围明确的小任务开始试。
这里有个容易误判的点:$0.08/session-hour 看起来是"运行越久越贵",但对 64 并发的 run 来说,时间恰恰是省钱的维度——并行度把 wall-clock 时间压下来,session runtime 反而变便宜了;真正贵的是"你派了多少 agent、每个 agent 读了多少上下文"。所以成本优化的抓手不是"跑快点",而是"少派人、给小上下文":阶段切得越细、每个 agent 的任务范围越小,token 账单越可控。这也是官方建议"从 scoped task 开始"的技术含义——先拿小任务测出"每个 bug 花多少 token",再决定要不要放大到全仓库。
还有一个刹车片:session budget。会话可以设预算上限,撞到上限所有 open 的 run 暂停,每个正在干活的 agent 把手头这轮做完就停。预算就是给"夜间批处理"准备的保险丝——你睡觉的时候,run 不会把你的信用卡跑穿。我的建议是:第一次跑任何 workflow,先设一个你能接受亏掉的 budget,就当交学费测 token 成本。
我的判断:动态工作流的成本模型是"固定部分忽略不计、变量部分线性放大"。这意味着它天然适合"任务价值 ≥ token 成本 × 安全系数"的场景:一次全仓库安全审计找到一个高危漏洞,价值远超几十美元 token;但拿它做"帮我看看这段代码有没有问题"这种 5 分钟能聊完的事,就是拿 64 并发去打蚊子。
该用 / 不该用:一张判断清单
该用的四种形状:
- 仓库级代码审计和安全分析——官方实测的场景,也是机制上最对口的:任务可切分、结果可合并、覆盖率比单点智能重要。
- 大迁移和批量重构——几百个文件的机械性改造,每个文件派一个 agent,最后统一 reconciliate。注意:先在小范围验证"修好率",别只看"找到率"。
- 批量文档评审——几百份合同、简历、论文的初筛归类。官方文档的示例就是 300 份合同找控制权变更条款,这是被官方认证过的形状。
- 需要可重复编排的长任务——同样的流程每周跑一次:agent 写的 workflow 本身就是可复用的程序,比你手写的脚本更能适应输入变化。
不该用的四种形状:
- 实时交互任务——run 是后台异步的,启动后你不能发 follow-up,想中途改需求只能停掉重来。需要边聊边改的场景别用。
- 小任务——单 agent 几分钟能搞定的事,起 workflow 的编排开销(写程序、分阶段、合结果)纯属浪费。官方那句"从 scoped task 开始"是上限建议,不是下限。
- 需要精细控制每一步的任务——run 启动后控制权让渡给程序,你看得到事件流,但插不上手。对中间步骤有强合规要求的场景,先等等。
- 预算敏感的探索性任务——"先跑起来看看"的心态配上 1000 个 agent 的上限,是烧钱最快的方式。探索先用单 agent,形状验证清楚了再上 workflow。
一句话版本:任务越大、越可切分、越不怕等,workflow 越划算;任务越小、越要交互、越要精细控制,单 agent 越划算。顺带去重说明一句:本站之前报道过 GitHub Copilot 的 Dynamic Workflows,那是 GitHub 家产品里的另一套能力;这次是 Anthropic 在自家平台 API 层面下的基础设施注,赛道相同,厂商不同。
平台化的信号:编排从"手搓"变成"水电"
把镜头拉远一点。这次发布真正的历史位置是:多智能体编排正在从"框架层的手艺"下沉为"平台层的水电"。过去两年,fan-out、并发控制、结果合并、失败重试——这些是每个 agent 框架(LangChain、CrewAI,以及无数独立开发者的深夜代码)都要自己造一遍的轮子。现在 Anthropic 说:别造了,平台给你跑,你只管描述任务和写 system prompt 里的调度策略。
这个下沉一旦完成,上层的竞争格局会变。框架层的价值会从"怎么把 agent 跑起来"转向"怎么把任务描述清楚"——system prompt 里那几句"什么时候该起 run、阶段怎么切、失败了怎么办",会变成新的护城河。而独立开发者的体感变化更直接:你不再需要为"并行"写代码,你需要为"并行"算账。64 并发不是技术炫耀,是成本单位;1000 个 agent 不是数字游戏,是预算上限。
我的判断:未来 12 个月,"workflow-shaped problem"会成为 agent 团队的选型黑话——拿到一个任务先问:这是单 agent 的形状,还是 workflow 的形状?能稳定回答这个问题的人,会比只会调大并发的人省下真金白银。而 Anthropic 这次真正的阳谋是:用 66 对 14–27 的实测,把"该不该上多 agent"的争论从哲学层面拉到工程层面——别吵"浪不浪费 token",跑一遍,拿数字说话。
质疑同样要说在前面
掌声放一放,三条硬质疑。
第一,实测是自产自销。70 个 bug 埋在自家 11.6 万行代码里,埋的人和找的人是同一家公司。埋 bug 的分布、难度曲线、代码风格,全是 Anthropic 熟悉的形状。在独立团队用自己的代码库复现之前,66 这个数字的含金量要打折——它证明的是"机制有效",不是"普适 94%"。
第二,最关键的数字缺席了:token 账单。整场争论的起因是"浪费 token",Anthropic 回应了"效果"那一半,却没回应"成本"这一半。66 个 bug 花了多少 token?单 bug 成本是多少?不公布这个数字,"该用还是该省"的账就永远算不完。等有人跑出第一份"每 bug token 成本"的独立报告,那才是这场争论的下半场。
第三,beta 条款随时会变。64 并发官方注明不保证,1000/24 小时/10 run 的默认限额、$0.08 的定价,都是 public beta 阶段的数字。GA(正式版)时限额收紧或定价调整都不意外——别把 beta 期的参数写进你的长期成本模型。另外注意这是平台 API 的能力,不是 Claude 聊天 App 里的开关,别去 App 设置里找。
但这三条都不动摇核心判断:编排平台化是真的,数字是待验证的。对独立开发者来说,重要的不是 66 精确到小数点后几位,而是从今天起,"一次派 1000 个 agent 干活"从"手搓三个月"变成了"一行配置"。成本账要自己跑,形状判断要自己练——但起跑线,Anthropic 已经替你前移了。
Agent 的竞争,正在从"单个模型有多聪明"变成"平台能调度多少聪明"。而这一次,Anthropic 用 70 个 bug 证明了一件事:在有些任务上,1000 个普通 agent 的纪律,胜过 1 个聪明 agent 的灵感。
本文一手来源:Anthropic 官方文档 Workflow runs(2026-10-09 dynamic workflows public beta 发布说明条目、@ClaudeDevs 官方发布帖 16:12 UTC、多智能体编排与定价页见同站文档;第三方整理 CellCog 引用了上述官方原文)。
原始来源
相关文章
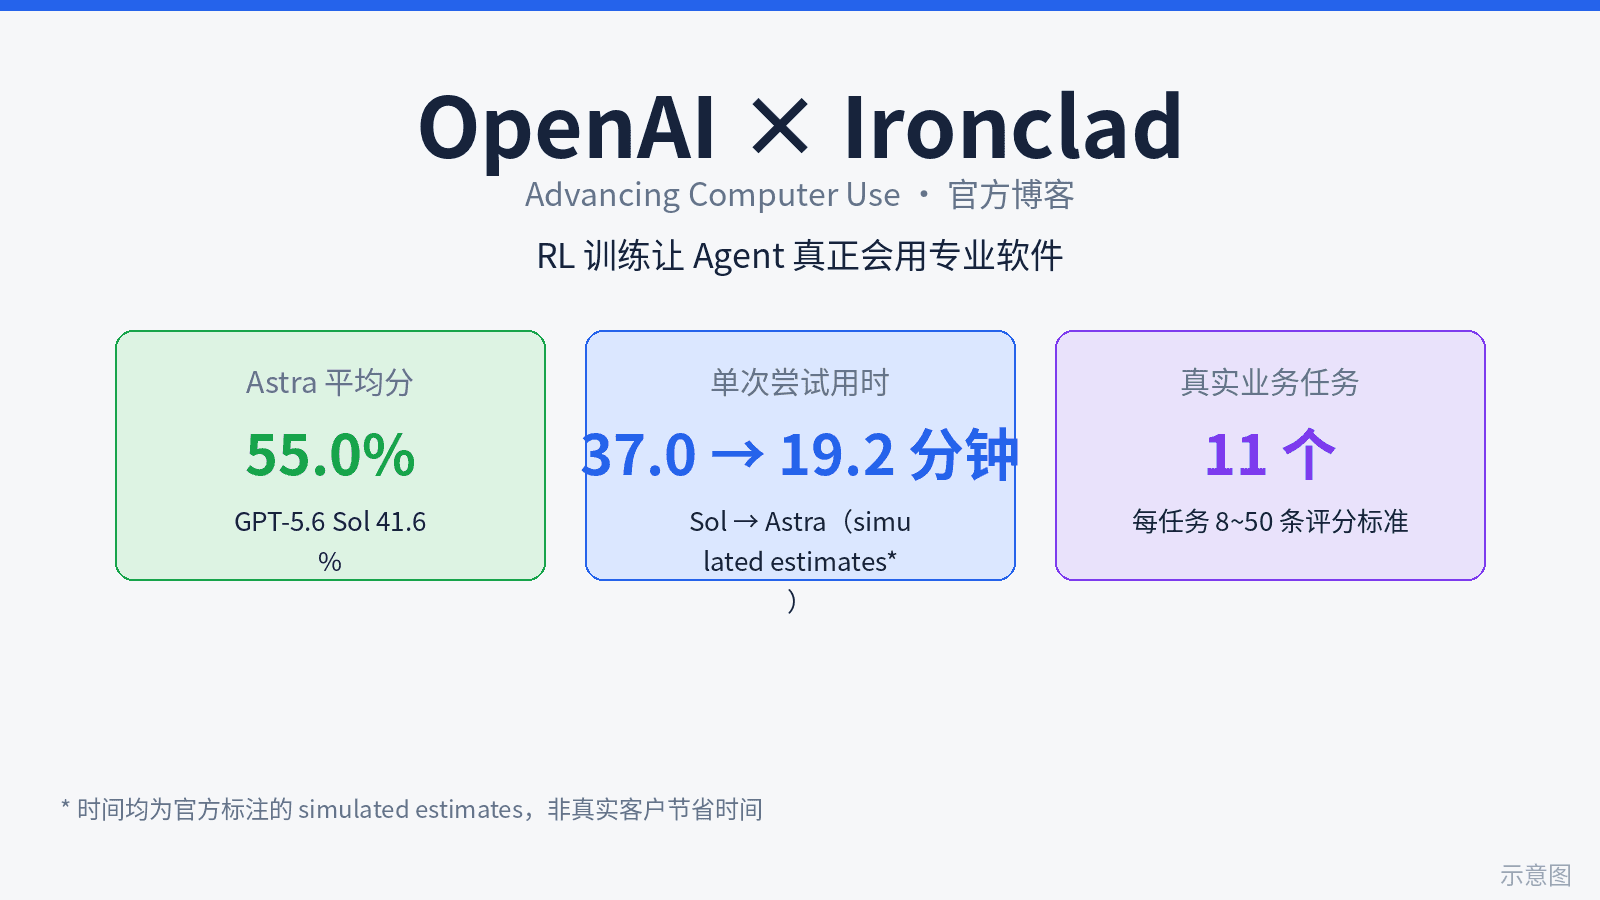
OpenAI 官方博客《Advancing computer use with Ironclad》标志着范式转移:Computer Use 从通用能力展示转向按应用定制训练。首款在 Ironclad 任务上训练的前沿模型 GPT-6 Astra,在 11 道专家设计的合同任务(每道 8~50 条评分标准)上拿到 55.0% 对 41.6%,单次估计耗时从 37.0 分钟降到 19.2 分钟。护城河正在从模型搬到「合作伙伴名单」——而 OpenAI 正在公开招募下一批软件公司。
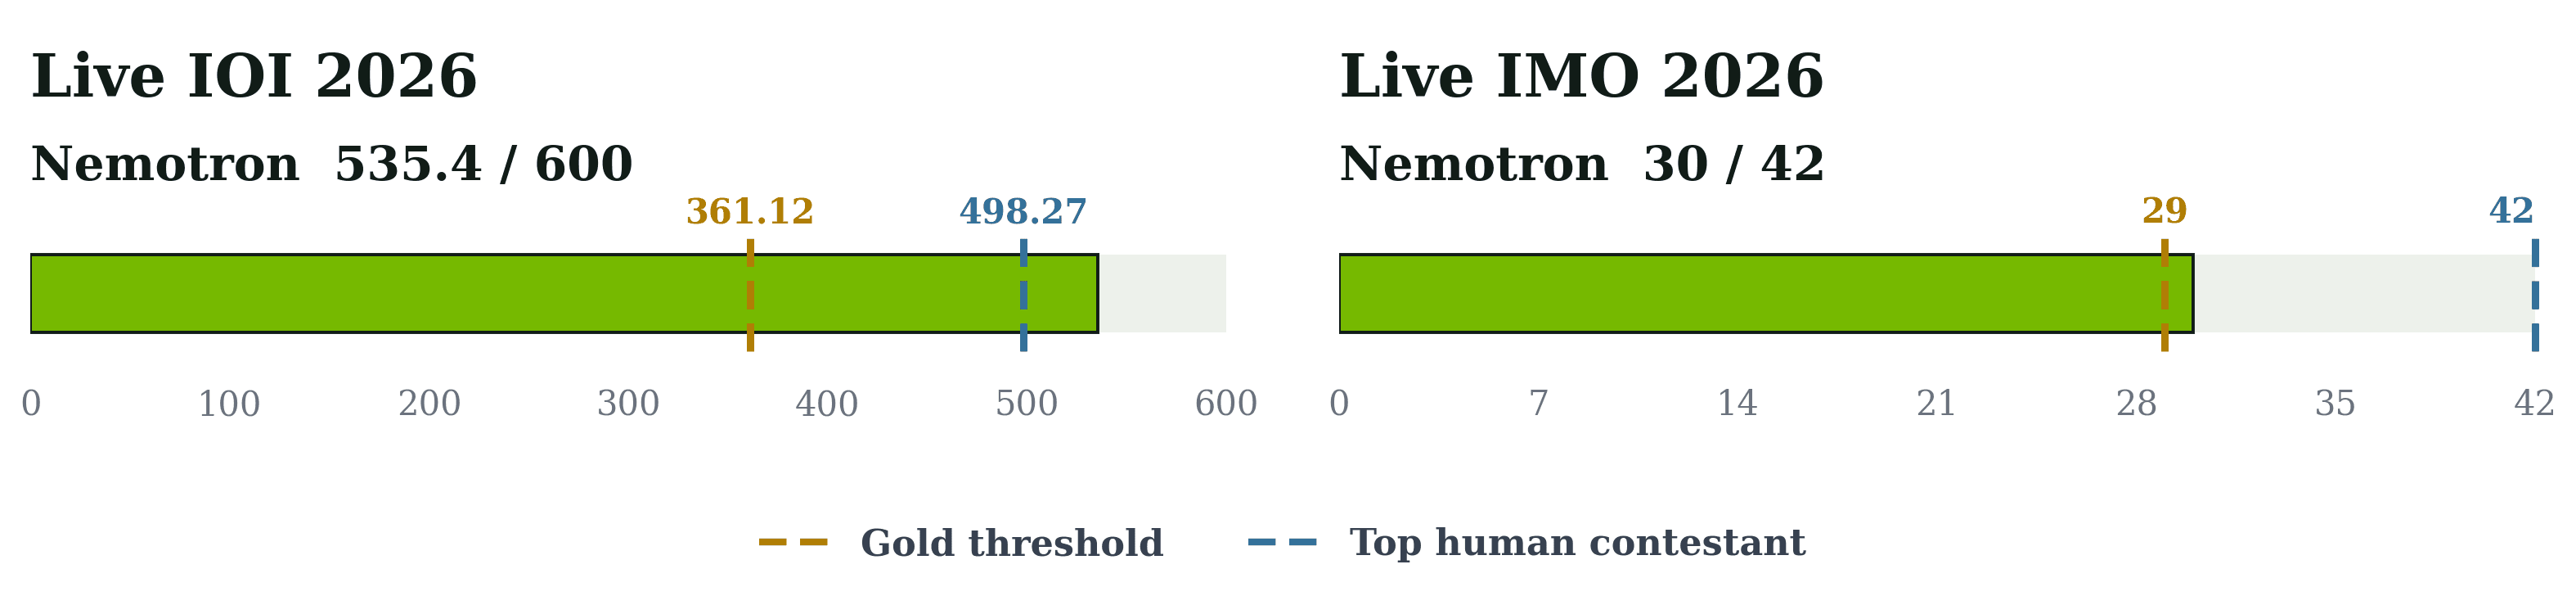
NVIDIA 的 Nemotron 系统在 IOI 2026 拿下 535.4/600(非官方跑分,超过人类最高分 498.27)、在 IMO 2026 拿下 30/42(官方阅卷,越过 29 分金牌线),并把整套配方全部开源:SFT 与 RL 的 checkpoint、两份训练数据集、全新的 200 道奥赛级数学 benchmark、推理管线与 prompt。核心方法是模型、数据、推理循环的协同设计:GenCorrect 的生成-评估-改进循环把 291 分的模型推过 438.3 的金牌线。对一人公司而言,这是一份生产级的测试驱动 agent 循环模板。
Perplexity 发布开源决策模型 Decider:27B 参数、Apache 2.0,V1 定价 0.04 美元/M,六天后 V1.1 降到 0.02 美元/M。自报基准 85.71% 对 Jev 的 84.51%,“闭源 vs 开源”的剧本在新赛道重演。