决策模型价格战开打:Perplexity 开源 27B Decider,六天降价一半
Perplexity 发布开源决策模型 Decider:27B 参数、Apache 2.0,V1 定价 0.04 美元/M,六天后 V1.1 降到 0.02 美元/M。自报基准 85.71% 对 Jev 的 84.51%,“闭源 vs 开源”的剧本在新赛道重演。
六天,价格砍半
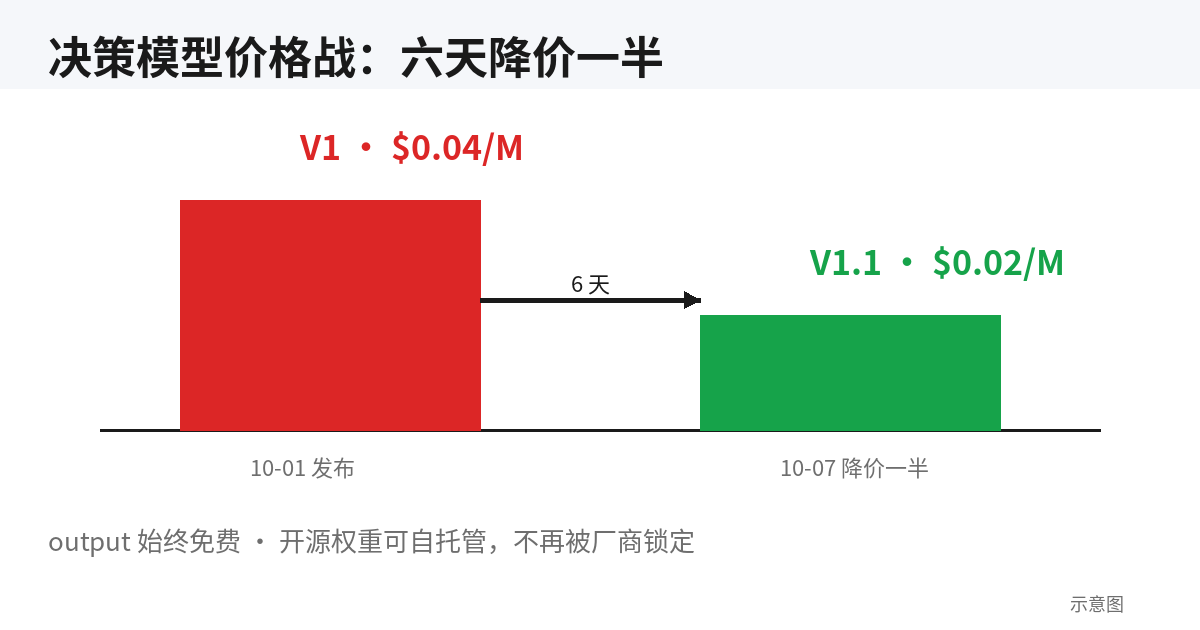
10 月 1 日,Perplexity 发布 Decider V1:27B 参数的决策模型,定价 每百万输入 token 0.04 美元,输出免费。10 月 7 日,V1.1 上线:输入降到 0.02 美元/M,输出依然是 0。六天,价格砍了一半。
放在 AI 圈的价格战史里,这个速度也算炸裂。想当年 GPT-4 降价是以季度为单位磨的,推理模型的价格战打了整整一年。决策模型这个品类诞生才三周(Jev 9 月 15 日发布),第二个玩家进场六天就把价格腰斩——这说明什么?说明在这个新赛道里,成本根本不是护城河,价格只是开场哨。
但 Decider 真正的重磅不是降价,而是四个字:开源权重。Apache 2.0 协议,27B 参数,基于 Qwen3.8-27B 微调而来。这是决策模型赛道第一个开源权重的玩家。Jev 开辟了赛道,OpenAI 跟进做了 Decisions API,而 Perplexity 选择了另一条路:把模型直接交到开发者手里。
Decider 能做什么:三种类型化判断
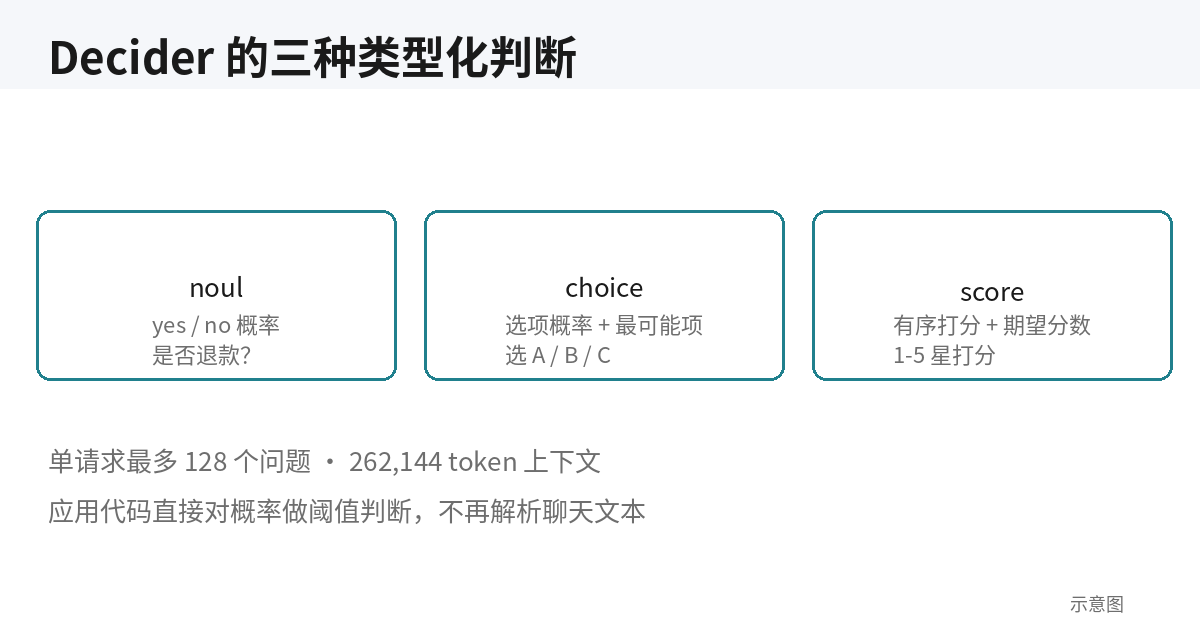
先说清楚 Decider 的产品形态,因为它和 LLM 的 API 完全是两种物种。Decider 不生成文本,它一次请求最多处理 128 个问题,返回三种类型化判断:
- noul:是非判断,返回 yes/no 的概率。比如"这条评论是不是垃圾信息?"——直接给你 0.91。
- choice:多选一,返回每个选项的概率外加最可能的一项。比如意图路由的五个候选项,一次返回五个概率和 top1。
- score:有序打分,对候选项做排序打分。RAG 重排、推荐排序、候选简历筛选,都是这个形态。
上下文窗口是 262,144 token。这个数字很有讲究:它足够把"一整份文档 + 几十个判断问题"一次性塞进去。128 个问题 × 长上下文,意味着你可以把一条流水线上的所有判断环节打包成一次调用——审核、分类、打分,一次搞定。
注意这个设计哲学:它不是"一个更聪明的 chatbot",而是"一条判断流水线"。API 的输入输出都是结构化的,没有 prompt 工程,没有"请只输出 JSON",没有解析失败。Perplexity 等于把过去两年 agent 工程师手搓的胶水层,做成了一个原生 API。
单请求 128 个问题这个上限,实际会改变流水线的写法。以前你做内容审核,可能是"先调一次 LLM 分类,再调一次打分,失败重试",三次调用、三次延迟、三次解析。现在是一次请求里塞 128 个待审条目,一次返回 128 组概率。批处理从"应用层自己攒 batch"下沉到了"API 原生支持",延迟和成本都是线性下降。对于日审千万级内容的平台,这一个设计细节一年能省出一支小团队的预算。
开源意味着什么
Apache 2.0,27B 参数,单卡可跑(量化后)。这意味着三件事:第一,你可以自托管,数据不出内网——金融、医疗、政务这些对数据主权敏感的场景,API 形态的 Jev 进不去,Decider 可以。第二,你可以微调,用自己的业务数据把判断校准到你的分布上——这是闭源 API 永远给不了的。第三,你可以离线跑,边缘设备、内网环境、不稳定的网络,都不再是障碍。
27B 这个参数量选得也很鸡贼:够大到有不错的判断能力,够小到部署成本可控。Perplexity 显然算过账——决策模型不需要 LLM 那种"上知天文"的广度,它只需要"在给定上下文里选得准"。这是个更窄的任务,27B 够了。
自报成绩单:85.71% 对 84.51%
Perplexity 给出的基准成绩:11 个基准、7,210 个样本,Decider 85.71%,Jev 84.51%。单项上,RAGTruth 这一项是 88.80% 对 77.27%,拉开超过 11 个点。
先把丑话说在前面:这是公司自报基准,非独立复测。样本是自己选的,基准是自己挑的,对手的版本和参数配置也是自己定的。这种"自报成绩单"在 AI 圈的可信度,大家都懂——参考价值有,验收价值没有。等第三方复测出来之前,先打个七折看。
但即使打七折,这个数字依然值得琢磨。RAGTruth 是测"幻觉检测"的基准——判断模型最核心的用武之地之一,就是给 RAG 输出做事实核验。88.80% 对 77.27%,如果这个差距是真的,意味着在"判断这段生成内容靠不靠谱"这件事上,开源的 Decider 比 Jev 准得多。而这恰恰是 agent 系统里最高频的判断环节之一:每个 RAG agent 都需要一个"验货员"。
我的判断是:别纠结 85.71 和 84.51 那 1.2 个点的差距,那是噪音级别。真正的信息是:一个开源的 27B 模型,在决策任务上已经摸到了闭源旗舰的水平线。这意味着"判断"这个任务,可能比"生成"更容易被开源追平——输出空间小、评测标准清晰,前面那篇我们说过,好测量的东西就好被追上。
经典剧本,新赛道重演
把时间线摆出来看,熟悉的味道就出来了:
- 9 月 15 日:Jev 发布,定义"决策模型"品类,闭源,8.7 亿美元 A 轮。
- 随后:OpenAI 跟进 Decisions API,巨头认证品类。
- 10 月 1 日:Perplexity 发布 Decider,开源权重,0.04 美元/M。
- 10 月 7 日:Decider V1.1,0.02 美元/M。六天,价格腰斩。
这不就是 LLM 赛道 2023-2024 年的剧本吗?OpenAI 定义品类,Anthropic/Google 跟进,然后 Meta 把 Llama 开源,价格战开打,生态爆发。只不过这一次,整个剧本被压缩到了三周。Jev 是 OpenAI,Decider 是 Llama,而 OpenAI 自己在这次剧本里扮演了"跟进者"的角色——有意思的身份互换。
剧本重演不是巧合,是结构使然。凡是"输出空间小、评测标准清晰"的模型品类,开源追平的速度都极快。LLM 的开放式生成很难评、很难追;决策模型的输出就是概率分布,基准一跑分,高下立判。Perplexity 敢开源,恰恰是因为它算准了:开源不会稀释它的优势,反而会加速生态向它靠拢。
而六天降价一半,说明 Perplexity 根本没打算在"模型能力"上和 Jev 缠斗——它打的是生态战和价格战。0.02 美元/M 的输入价格,输出免费,这个定价已经不是在赚钱,是在买 adoption。当开发者可以免费(自托管)或接近免费(API)拿到一个够用的决策模型,Jev 的 0.042 就显得贵了。价格战一旦开打,就没有回头路。
顺带说一句,这对 Jev 的 75 亿美元估值是个微妙的压力测试。TypeSafe 的 A 轮叙事建立在"判断层是高毛利基础设施"上,而 Perplexity 用六天时间证明了这一层的价格可以迅速打到地板。当然,Jev 也可以降价跟进——但 75 亿估值需要的增长故事,和 0.02 美元/M 的价格战叙事,气质上不太兼容。资本为品类付费之后,接下来要为份额付费,而份额战里,开源玩家从来不好惹。
选型指南:四种方案,什么时候用哪个
这是开发者最关心的部分。现在决策模型有四种解法,我给一个直白的选型框架——先说结论,再说场景:
什么时候用 Jev
当你需要开箱即用的最高精度,而且判断任务的价值密度极高。比如金融风控的终审环节、医疗分诊、大额交易的欺诈判定——一次误判的成本远超 API 费用,0.042 美元/M 的溢价不值一提。另外,如果你的团队没有 ML 部署能力,不想碰 GPU,Jev 的 API 是最省心的。但记住:你付的是"省心税"和"精度溢价",而且被单一厂商锁定。
什么时候用 Decider(API 或自托管)
这是大多数团队的默认选项。高频、中低风险的判断环节:意图路由、内容分类、RAG 重排、推荐打分、A/B 测试的分流判定——调用量越大,Decider 的价格优势越明显,一天几百万次调用的话,一个月能差出几千美元。如果你的数据不能出内网,或者需要针对业务分布微调,直接自托管 27B 权重,这是 Jev 给不了的。离线场景、边缘部署,更是只能选它。
什么时候用 Cloudflare Clef
当你的判断环节长在 Cloudflare 的基础设施上。如果你已经在用 Workers、R2、AI Gateway,Clef 的价值不在模型本身,而在"零运维、全球边缘、按量计费"的一体化。延迟敏感且全球分布的场景(比如实时内容审核),边缘推理的 50 毫秒和中心化的 300 毫秒是两种体验。选 Clef 不是选模型,是选交付方式。
什么时候继续用 LLM 自己判
三种情况:第一,判断需要推理过程——不是"选 A 还是 B",而是"为什么选 A",需要 chain-of-thought 的复杂决策,决策模型目前还给不了;第二,调用频率极低,一天几十次,为这点量引入新依赖不值当;第三,你的判断标准三天两头变,改 prompt 比改模型/微调数据快得多——灵活性本身就是价值。
一句话总结:高频、标准、结构化的判断,迁到决策模型;低频、复杂、善变的判断,留在 LLM。未来一年,每个 agent 团队大概都会同时用上两到三种方案,混合架构是常态。
判断层正在成为 agent 标配,LLM 只负责"写"
把两篇连起来看,图景就很清楚了:Jev 定义了品类,OpenAI 认证了品类,Perplexity 开源了品类、打响了价格战,Cloudflare/AWS 把品类变成水电。三周时间,"决策模型"走完了 LLM 三年走完的路:定义、跟进、开源、降价、基础设施化。
这意味着 agent 的标准架构正在改写。过去是"一个 LLM 干所有事":写也它写,选也它选,又贵又慢。未来是分工:LLM 负责"写"——生成文本、写代码、做总结;决策模型负责"判"——路由、分类、打分、审核、验货。中间用结构化概率通信,而不是用自然语言传话再解析。
我的预测(注明这是判断):12 个月内,主流 agent 框架都会原生支持决策模型作为一等公民——就像今天它们都支持向量数据库一样。"decision model"会成为和"LLM"、"embedding model"并列的第三种模型配置项。而"用 LLM 生成文本再解析做判断"的做法,会像手写 SQL 拼接一样,成为 code review 里会被打回去的坏味道。
对开发者来说,好消息是选择变多了、成本变低了、不再被单一厂商锁定;坏消息是又要学一套新东西——决策模型的评测、校准、阈值调优,和 prompt 工程是两套手艺。比如 choice 返回的概率分布,你得决定 top1 低于 0.6 时是转人工还是降级到 LLM 复核;score 的分数要映射到业务动作,就得在自己的数据上重标定阈值。这些活不浪漫,但决定了你是"用上了决策模型"还是"只是调了个新 API"。
决策模型的价格战开打了,六天降价一半只是开始。等 Cloudflare 和 AWS 的定价出来,这个数字还会继续往下走。对用户来说,这是最好的消息:"选得准"正在变成像"算得快"一样便宜的基础能力。
一手来源:OpenRouter 模型页(V1 2026 年 10 月 1 日发布,V1.1 2026 年 10 月 7 日)与 Perplexity 官方文档(docs.perplexity.ai)。基准数据为 Perplexity 自报,非独立复测。
原始来源
相关文章
TypeSafe 完成 8.7 亿美元 A 轮,投后估值 75 亿美元。旗舰模型 Jev 9 月 15 日才发布——它不输出文本,只输出概率。a16z 领投、Sequoia 与 DCVC 参投,“判断”正在从“生成”中剥离,成为 agent 基础设施的新品类。
智谱旗舰模型 GLM 5.3 在 Amazon Bedrock 上正式 GA:753B 参数 MoE、百万 token 上下文,CyberGym 安全基准拿下 84.5 的领先分数。AWS 甚至用它默认驱动的开源渗透测试 agent Strix 做了一场授权安全测试演示。背后是按调用量分成的 revenue share 模式——中美模型同在一个云货架上售卖,消息传出后智谱港股涨超 7%。
Prime Intellect 让 Prime Agent 编排出 2000+ 个 agent,花两周把自己从 TypeScript 完整重写为 Rust,动用 10000+ 沙箱、烧掉 2000 亿+ token。真正的看点不是 14 倍提速,而是诚实的方法论:不写代码的根 agent、验证与实现分离,以及公开承认“通过脚本化等价测试不等于生产就绪”。