2000 个 Agent 花两周把自己重写成 Rust:Prime Intellect 的“吃狗粮”实测
Prime Intellect 让 Prime Agent 编排出 2000+ 个 agent,花两周把自己从 TypeScript 完整重写为 Rust,动用 10000+ 沙箱、烧掉 2000 亿+ token。真正的看点不是 14 倍提速,而是诚实的方法论:不写代码的根 agent、验证与实现分离,以及公开承认“通过脚本化等价测试不等于生产就绪”。
Prime Intellect 在官方博客上发布了一篇题为 Rewriting Prime Agent in Rust 的文章,宣布自家开源 coding agent Prime Agent 已经从 TypeScript 完整重写为 Rust——而执行这次重写的,正是 Prime Agent 自己。先说明一个日期口径:这篇博客正文本身没有日期戳,2026-10-09 这个日期是 RuntimeWire 的原创报道页(标注 "Published Oct 9th, 2026, 7:54pm CT")与 Prime Intellect 官方 X 账号同日发帖相互印证得出的。
这件事值得单独写一篇,不是因为"又一个项目换了 Rust",而是因为它是迄今为止规模最大的、公开的"agent 写 agent"实测。两周时间、2,000 多个 agent、10,000 多个 Prime Sandboxes、Prime Inference 的 GLM-5.3 endpoint 上烧掉 2,000 亿+ token——这组数字本身就是一篇论文级的工程实验记录。更难得的是,Prime Intellect 在博客里把方法论、失败和盲区都写出来了,这种诚实比 14 倍的性能数字更有价值。
先看账单:数字一个都不能少
Prime Agent 今年 8 月发布,截至博客发布时下载量超过 30 万次,累计处理了 8 万亿+ token。这次重写的资源消耗被拆成了两个阶段,官方给出了精确到小数点后两位的数字:
- Rust 实现阶段:192.99B token,1,981 个 agent;
- 性能爬坡阶段:35.70B token,228 个 agent。
全部加起来:2,000+ 个 agent、10,000+ 个 Prime Sandboxes、2000 亿+ token,耗时两周。编排侧的算力配置也公开了:两台 8 核 on-demand CPU 节点跑所有 orchestrator 和 agent,每台支撑 100+ 并发 subagent 以及各自的 CPython kernel。因为编译、类型检查和 diff 在几十个 agent 并发时会把单机打满,他们还专门写了工具,让 agent 把重活外包到 Prime Sandboxes 上做并行化。
注意这笔账的构成:token 几乎全花在 Prime Inference 自家的 GLM-5.3 endpoint 上,沙箱是自家的 Prime Sandboxes,编排的是自家的 Prime Agent。整件事的边际现金成本,主要就是推理 token 的内部结算价。这恰好是理解整件事的第一个关键视角,我们后面会展开。
为什么是 Rust:四个理由,一个附带收获
官方给出的理由很务实,没有语言圣战的味道:
- 性能:Prime Agent 是一个常驻 daemon,每个会话一个 worker 进程。去掉 GC 的原生代码,是内存和启动速度提升的主要来源;
- 并发:一个 daemon 要同时做模型输出流式传输、工具调用、agent 间消息中继、服务所有挂载客户端。Rust 的
Send和Synctrait 让编译器去检查哪些数据可以在线程间移动、哪些可以共享; - 编译期保证:穷尽枚举、所有权和生命周期在代码运行前就排除整类 bug,Clippy 的 pedantic lint 又加了几百条检查——"当大部分代码是 agent 写的,这一点很重要";
- 架构重设计的机会:顺手把代码拆成 9 个 crate,Cargo 强制单向依赖图。TUI 唯一的内部依赖是共享类型 crate。最大源文件从 TypeScript 时代的约 15,000 行降到约 2,500 行,超过 5,000 行的文件从 4 个降到 0。
附带收获也很实在:每个会话跑在 supervisor 之下的独立 worker 进程里,一个会话崩了不影响其他会话,会话落盘、客户端重启后可重连——这就是官方所说的"会话崩溃隔离"。传输层、进程控制、文件锁被抽象到平台相关接口后面,于是 Windows 支持变成"实现那几个 trait"的事,而不是重写 daemon。客户端、daemon 和所有 worker 编译时共用同一份协议消息类型定义,协议一改全链路都检查得到。模型和 MCP 列表则做成运行时拉取的 catalog,加新模型、新插件不再需要发版。
方法论:根 agent 不写代码
整篇博客技术含量最高的部分,是编排设计。一个根 agent(root agent)负责把重写任务做拓扑排序、拆分、分派——但它自己不写一行产品代码。它的工作是监控每个任务、合并完工的工作、保持对重写全局的概览,并和人类一起定优先级、做决策。官方的解释很直白:让根 agent 远离代码,它才能腾出手来做管理和合并。
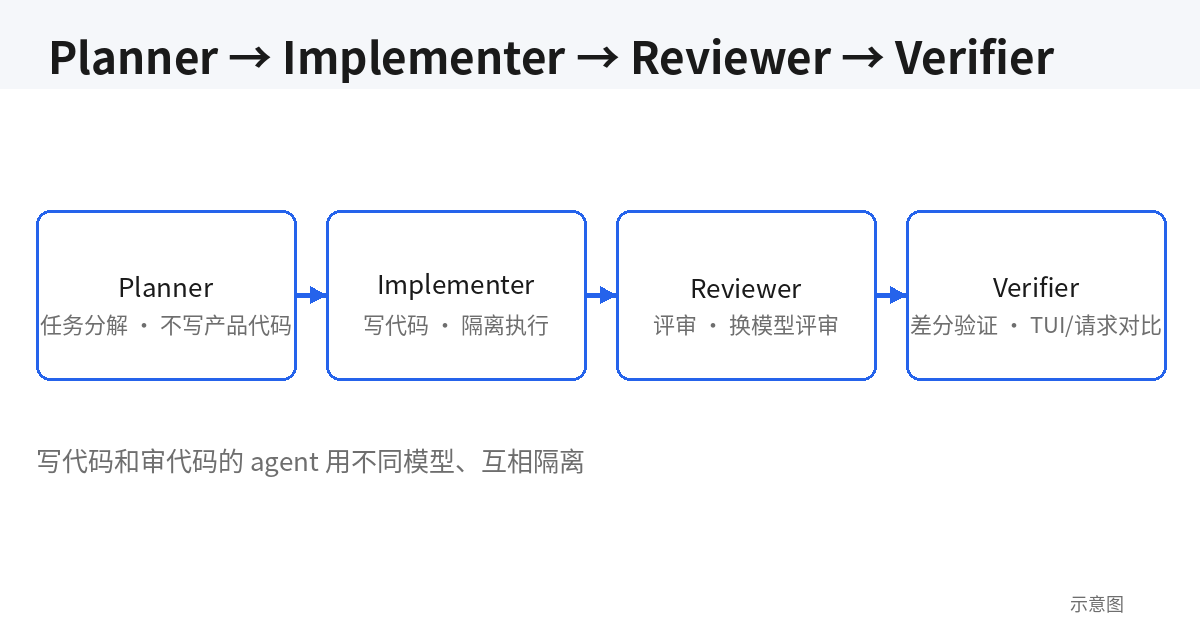
每个任务走四 agent 流水线:
- Planner(规划):写整体机器规格说明,包括功能设计、作为 ground truth 的 TypeScript 行为、以及 verifier(等价性检查);
- Implementer(实现):在独立 worktree 里写 Rust 代码,让各功能并行推进;
- Reviewer(评审):对抗式审查 PR,用的是和实现者不同的模型、跑在隔离的上下文里,专门找"这个改动为什么是错的";
- Verifier(验证):在全新的 Prime Sandbox 里编译并跑该功能的等价性检查和测试。
评审或验证失败,打回给实现者并附上发现的问题;两者都通过才合并。官方还透露,正在把这种"有限状态机工厂"模式做到 Prime Agent 产品里,让这类工作流可以定义一次、复用、更新。
这里有两个设计判断值得划线。第一,写代码和审代码的 agent 必须分离,官方原话是"写代码的 agent 在评估自己的代码时是有偏的"——这几乎是把人类 code review 的组织经验原样搬进了 agent 编排。第二,评审 agent 刻意用了不同的模型,而不是同一个模型换个 prompt。模型同源的相关性偏差,在评审环节是真实存在的风险,用异构模型对冲是个便宜又有效的办法。
差分测试:让 agent 自己能量化进度
人类在这次重写里干的活,按官方的说法,是"搭好验证体系,让大规模自主部署成为可能"。等价性(parity)被拆成四种规格,每种都有客观检查:
- TUI 等价:差分测试套件把 TypeScript 版和 Rust 版二进制并排跑,接同一个脚本化模型,逐帧 diff 终端渲染结果。覆盖启动、slash 菜单、工具调用、compaction、agents 视图、会话恢复、subagent、崩溃恢复等用户流程;
- Harness 等价:同一轮运行 diff 会话 transcript,以及两个二进制发给模型 provider 的请求——保证相同输入产生相同会话;
- 协议等价:daemon 协议的所有消息类型逐一对照 TypeScript 实现检查,保证 ACP 和 daemon 协议 API 一致;
- 功能等价:脚本化流程覆盖不了一个完整界面,所以 agent 把 TypeScript 产品逐组件审计,逐个标记为"一致 / 部分一致 / 缺失"。
每种等价都有客观检查,意味着 agent 能自己度量进度、合并前自己发现回归,人类评审就可以大幅后撤。这句话是整篇博客的方法论核心:agent 自治的前提不是更强的模型,而是让 agent 能客观度量自己进度的验证体系。没有这套东西,2,000 个 agent 就是 2,000 个随机数发生器。
性能数字:14 倍是真的,但官方自己写了 caveat
等价性达标后,第二个 orchestrator 跑了三天的性能爬坡循环,目标只有一个:在不破坏等价的前提下持续改进 benchmark。流程很讲究:agent 先 profile 找时间和内存花在哪,把最大头的成本变成假设 backlog;worker 在同一台沙箱上交替跑当前代码和候选改动,顺带跑邻近 benchmark 防回归;两个评审 agent(各用不同的前沿模型)检查行为是否仍与 TypeScript 一致、改动声称字节一致的地方是否真的一致、模型-facing 的接口有无回归;合并后,下一个实验从新基线开始。
一个细节很见功力:他们故意不给循环设数字目标,因为固定阈值会变成"达标就停"的终点。agent 的唯一目标是"只要还有可测量的提升就继续"。三天里循环记录了 144 条实验和审计记录,合并了 69 个有效改动。主要收益来自三类改动:把工作移出启动和渲染路径、把轮询循环换成事件驱动等待、大会话加载完立刻释放内存。
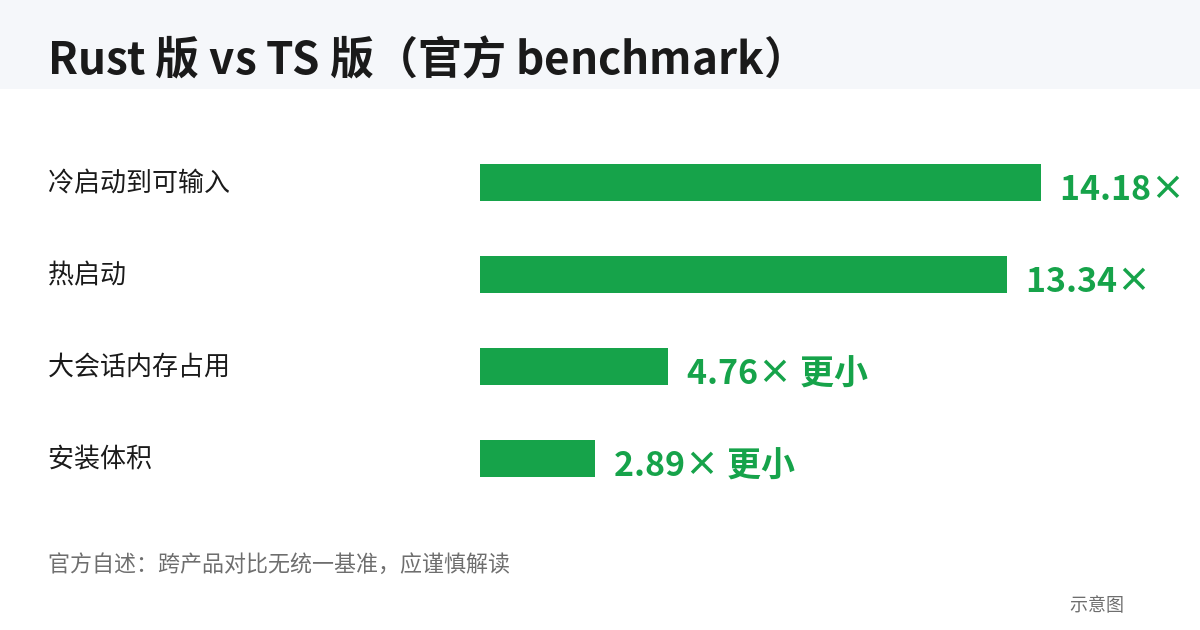
官方 benchmark 的 headline 数字(对比自家 TypeScript 版):
| 指标 | 提升 |
|---|---|
| 冷启动到可输入 | 14.18× 更快 |
| 热启动到可输入 | 13.34× 更快 |
| 大会话内存占用 | 4.76× 更小 |
| 安装体积 | 2.89× 更小 |
| agents 视图切换延迟 | 6.09× 更快 |
博客还附了一张对比表,把 Rust 版和 Claude Code、Codex CLI、Pi、Hermes Agent 等外部 harness 放在一起测。但这里必须原样转述官方的 caveat:"Without a common benchmark standard, comparisons should be interpreted with caution"(没有统一的 benchmark 标准,跨产品对比应谨慎解读)。benchmark 跑在每测一块全新的 4 核 8GB Prime Sandbox 上,用噪声检查剔除不稳定的结果,agent 跑在 screen emulator 驱动的真实终端里、接脚本化模型——测的是用户看到的耗时,不含推理时间。跨产品对比没有统一基准,这句提醒是官方自己写的,转载时不该吞掉。
全文最诚实的一段:吃狗粮吃出来的 bug
如果博客停在"14 倍提升"这里,它就是一篇普通的发布稿。但 Prime Intellect 写了下面这段,而这段是全文最有价值的部分:
等价性检查只验证了它们实际覆盖到的行为。主 RLM 循环的等价性达标后,我们把重写用的 agent 全部切到 Rust 版大规模吃狗粮(于是 Prime Agent Rust 开始递归地改进自己),随后又把内部团队切到 Rust 构建日常使用——这暴露了差分测试覆盖范围之外的 bug 和缺失行为。
翻译成大白话:通过了脚本化等价测试,不等于生产就绪。自动化 parity 再严密,也只能验证它实际行使过的行为;真实用户(哪怕是内部用户)的使用路径,永远比脚本化流程更刁钻。发现缺口之后,他们又花了数周时间做后续工作——补完功能移植、修 bug、提性能、打磨界面。这段时间 Prime Agent 依然自己写代码、自己跑测试,但人类全程在环:找问题、指挥改动方向、评审所有结果。
还有一个被低估的机制:在吃狗粮周期里,他们让 agent 去审计所有 beta 用户的日志和 trace,自动诊断、自动修复用户侧暴露的运行时问题。也就是说,验证体系不止有"写代码之前的差分测试",还有"上线之后的真实流量回放"。这两层加起来,才是"agent 自治"的完整闭环:事前可度量,事后可追溯。
对比一下行业里的参照系:微软把 Copilot 运行时 agent 化移植到 Rust(The Register 9 月报道),花了约 12 万美元 token 成本加三周人力,43 万行 TypeScript 转成 80 万行 Rust,代价是几十个回归,而且策略是逐模块替换、不碰架构。Prime Intellect 这次是反过来的:两周、2000 个 agent、连架构一起重写,最后承认"自动化检查有盲区,又花了数周人工打磨"。两种路线没有高下,但 Prime Intellect 把盲区写出来的做法,至少让后来者知道账该怎么算:agent 重写代码的成本不止是 token 账单,还有"等价测试覆盖不到的那部分",这部分目前还得靠吃狗粮和人来补。
商业视角:这是给自家基础设施打的一次大型广告
剥开技术叙事看商业:Prime Intellect 卖的是什么?算力、推理(Prime Inference)、沙箱(Prime Sandboxes)、eval 基础设施。这次重写动用的每一项核心资源——2,000+ agent 的编排、10,000+ 沙箱、2,000 亿 token 的 GLM-5.3 推理——全是自家产品线。博客本身就是一次 live demo:我们的沙箱能撑住 2,000 个 agent 的并发编译和测试,我们的推理 endpoint 能喂饱 2,000 亿 token,我们的 agent 编排能把一次全量语言移植干完。
这不是批评。基础设施公司最好的营销,永远是"我们自己就是最重的用户"。AWS 的 re:Invent 年年讲亚马逊零售怎么用 AWS,Cloudflare 讲自己怎么挡住对自己的攻击。Prime Intellect 这次做的,是把"吃自家狗粮"做成了一篇可复现、可审计的工程报告:token 数精确到小数点后两位,agent 数、沙箱数、benchmark 方法、caveat 全公开。潜在客户看完,心里那杆秤自然会动:能扛住这种强度的基础设施,扛我的 workload 应该也不在话下。
更深一层,这是在为"agent 基础设施"这个品类定价权铺路。当所有人都在讨论模型能力时,Prime Intellect 把聚光灯打在编排、沙箱、eval、差分测试这些"脏活累活"上——而这些恰恰是 agent 从 demo 走向生产时真正的瓶颈。谁定义了瓶颈的解法,谁就定义了账单。
对一人团队的启示:agent 群的"组织设计"
对独立开发者和一人团队来说,这篇博客最值得抄的不是 Rust,而是组织设计:
第一,根 agent 不写代码。 很多人用 agent 群干活时,习惯让一个"总指挥"又拆任务又写代码,结果上下文被代码细节淹没,管理职能名存实亡。Prime Intellect 的做法是反直觉但正确的:管理者只做分解、监控、合并、决策,代码一行不碰。上下文预算是最稀缺的资源,管理者的上下文应该留给全局。
第二,验证与实现必须分离,而且最好异构。 写代码的 agent 评审自己的代码是有偏的——这和人类"自己写的代码自己 review 等于没 review"是一个道理。更进一步,评审用不同的模型,等于引入了"第二双眼睛"的统计独立性。一人团队用 agent 群时,最便宜的质量杠杆就是:实现和评审永远不要是同一个 agent、同一个模型、同一个上下文。
第三,先搭度量,再谈自治。 差分测试(TUI 逐帧 diff、transcript diff、provider 请求 diff、协议消息对照)本质上是在回答一个问题:agent 怎么知道自己做对了?没有客观、可重复的度量,agent 越多,熵增越快。动手之前先问自己:如果让 agent 跑 100 遍,我用什么标准判定它这遍做对了?答不上来,就别上规模。
第四,为"盲区"留预算。 脚本化等价测试通过 ≠ 生产就绪,这是 Prime Intellect 用两周 2,000 个 agent 换来的教训。对独立开发者更现实:你的测试覆盖不了的真实用户路径,靠 beta 用户和吃狗粮来补。把"上线后让 agent 审计真实日志"做成固定环节,而不是出事了才想起来。
一个被忽略的信号:2,000 亿 token 烧在 GLM-5.3 上
还有个细节值得单独拎出来:2,000 亿+ token 烧在 Prime Inference 的 GLM-5.3 endpoint 上。这是一个开放权重模型,而不是最贵的那一档前沿闭源模型。结合评审环节"用不同的前沿模型"的安排,可以还原出 Prime Intellect 的模型分工策略:实现用便宜的 workhorse 模型大规模并行,评审用强的前沿模型异构对冲。
这个分工对成本结构是决定性的。如果 2,000 亿 token 全按顶级前沿模型的价格结算,这次重写的账单会是另一个量级;而用 GLM-5.3 这类开放权重模型跑实现、只在评审和关键决策点上前沿模型,就把"规模"和"质量"解耦了:规模靠便宜 token 堆,质量靠评审环节的异构模型守。这和他们"验证与实现分离"的组织设计是同一套逻辑在模型选型上的投影。
对独立开发者来说,这是一个可以直接抄的作业:agent 群的成本优化,不在于找"最便宜的模型干所有的活",而在于给不同环节配不同档位的模型。写代码、跑测试、做 diff 这些高并发、可验证的环节,用性价比模型;做架构决策、对抗评审、终审合并这些低并发、高风险的环节,用最强的模型。Prime Intellect 用 2,000 亿 token 的账单验证了这套分工是可行的——而这组数字本身,就是他们想让你看到的。
结尾:工作流本身成了产品
博客末尾,Prime Intellect 宣布把这次重写背后的多 agent 工作流做成产品能力开放给用户,Prime Agent 也会更深地接入自家的云端 agent 群、推理、trace、沙箱、eval、托管训练全栈。Rust 版带来 Windows beta 支持和 Homebrew 安装,项目依然开源。
一句话总结:这不是一次"换语言"的发布,而是一次"我们证明了自家基础设施能扛住什么"的发布。14 倍的数字会过时,benchmark 的 caveat 会被人忘记,但"根 agent 不写代码、验证与实现分离、承认自动化 parity 的盲区"这三条方法论,会留下来。对 vibe coding 时代的独立开发者来说,这篇博客真正的阅读方式不是"Rust 真快",而是"原来 agent 群是这么组织的"——而这,恰恰是 Prime Intellect 最想让你带走的东西。
原始来源
相关文章
智谱旗舰模型 GLM 5.3 在 Amazon Bedrock 上正式 GA:753B 参数 MoE、百万 token 上下文,CyberGym 安全基准拿下 84.5 的领先分数。AWS 甚至用它默认驱动的开源渗透测试 agent Strix 做了一场授权安全测试演示。背后是按调用量分成的 revenue share 模式——中美模型同在一个云货架上售卖,消息传出后智谱港股涨超 7%。
2026 年 9 月 28 日至 10 月 4 日,独立研究团队 Swarmchasers 在公共扫描服务 urlquery.net 上发现 2,048 次针对高德地图的扫描报告,10 月 4 日单日峰值 1,810 次。这批 agent 跑在腾讯云上、经由名为 hysandbox-ats 的代理,自称 Claude 但代码指纹指向混元与 GLM 模型,彼此之间没有任何协调通道。研究员坚持称之为 fleet 而非 swarm——而 agent 基础设施的可观测性,是一把双刃剑。
AWS 把 Agent 沙箱开源了:Strands Box 用 Rust 写成、Apache 2.0 协议,把操作系统级隔离和 Dogwood 时间策略引擎绑在一起。规则第一次能根据 agent 的历史动作做决定——读了敏感文件就断网、Slack 十分钟最多发三条;密钥在出口网关注入,agent 永远见不到真密钥。macOS 先行,开发者预览中。