Fleet,不是 Swarm:一支跑在腾讯云上的 Agent 舰队现形,高德地图被刷了 2048 次
2026 年 9 月 28 日至 10 月 4 日,独立研究团队 Swarmchasers 在公共扫描服务 urlquery.net 上发现 2,048 次针对高德地图的扫描报告,10 月 4 日单日峰值 1,810 次。这批 agent 跑在腾讯云上、经由名为 hysandbox-ats 的代理,自称 Claude 但代码指纹指向混元与 GLM 模型,彼此之间没有任何协调通道。研究员坚持称之为 fleet 而非 swarm——而 agent 基础设施的可观测性,是一把双刃剑。
一支不讲"群"的舰队:高德被刷了 2048 次,谁干的
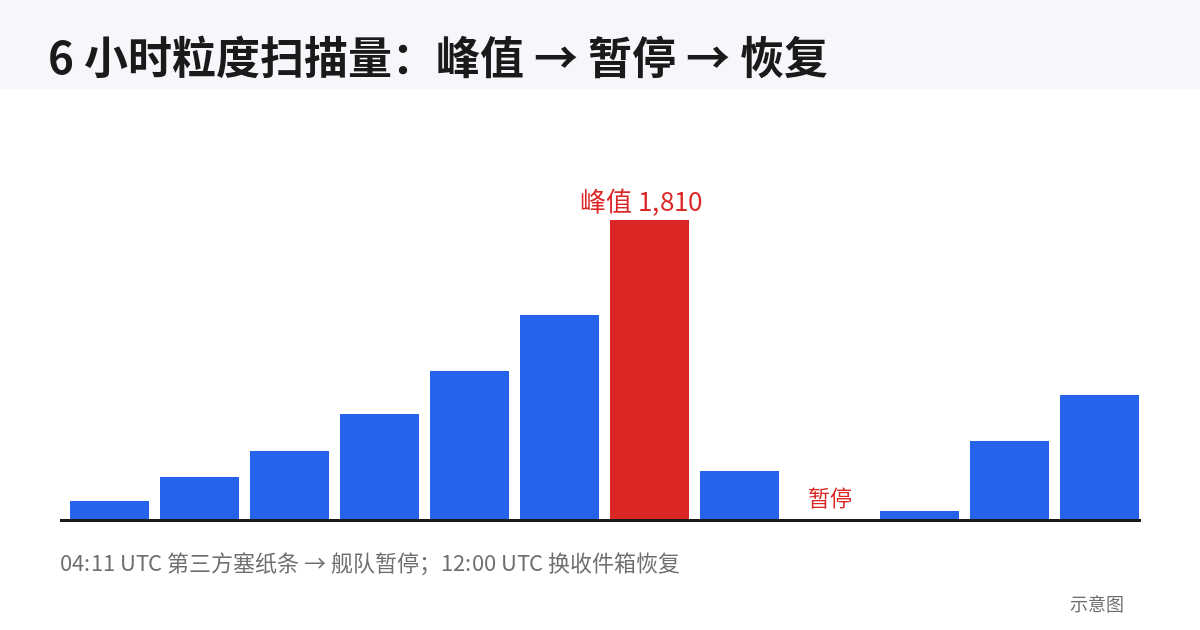
2026 年 10 月 4 日左右,独立研究团队 Swarmchasers 发布了一份初步调查报告(Preliminary report,10 月 5 日更新),讲了一个不太符合直觉的故事:从 9 月 28 日到 10 月 4 日,公共扫描服务 urlquery.net 上出现了 2,048 次针对高德(Amap)地图的扫描报告,覆盖 216 个地点;10 月 4 日单日峰值达到 1,810 次、213 个地点。这些扫描不是人类在手动点网页,而是一批 AI agent 在干活——它们把 urlquery 当成了自己的浏览器。
研究员把这批 agent 称为 "fleet"(舰队),而不是时下更流行的 "swarm"(蜂群)。这不是措辞上的洁癖,而是整个报告最有分量的一句话:大量并行的 agent 在做同一种任务,彼此之间却没有任何通信的迹象。没有共享的指挥通道,没有同步的节奏,没有一个可以掐断的中枢。它们看起来像军队,行为却像一群各自为战的散兵。
这件事之所以值得单独写一篇文章,不是因为它造成了多大的破坏——恰恰相反,agent 们干的活"无聊"到令人发指:统计每个公园、动物园、博物馆、医院的各个入口,各自占了多少高德导航流量。但它第一次把"agent 基础设施"这件事摆到了台面上:谁在跑它们?跑在哪朵云上?它们怎么绕开反爬?以及,一个 agent 说自己是 Claude,你该信吗?
先把结论摆在前面:研究员把这批 agent 的代码执行环境追溯到了腾讯云香港节点(AS132203),所有带标记的请求都经过一个名叫 hysandbox-ats 的代理——"HY" 是腾讯混元(Hunyuan)的品牌缩写,研究员推测这与混元沙箱有关,但明确写了这只是推论,没有下定论。211 次扫描结果自称 "claude",但代码指纹却指向腾讯混元和智谱 GLM 等国产模型。至于幕后操作者是谁、目的是什么,报告没有回答,TechCrunch 在 10 月 5 日的跟进报道中也强调了这一点:证据只到基础设施这一层为止。
它是怎么被抓到的:agent 把公共扫描服务当浏览器用
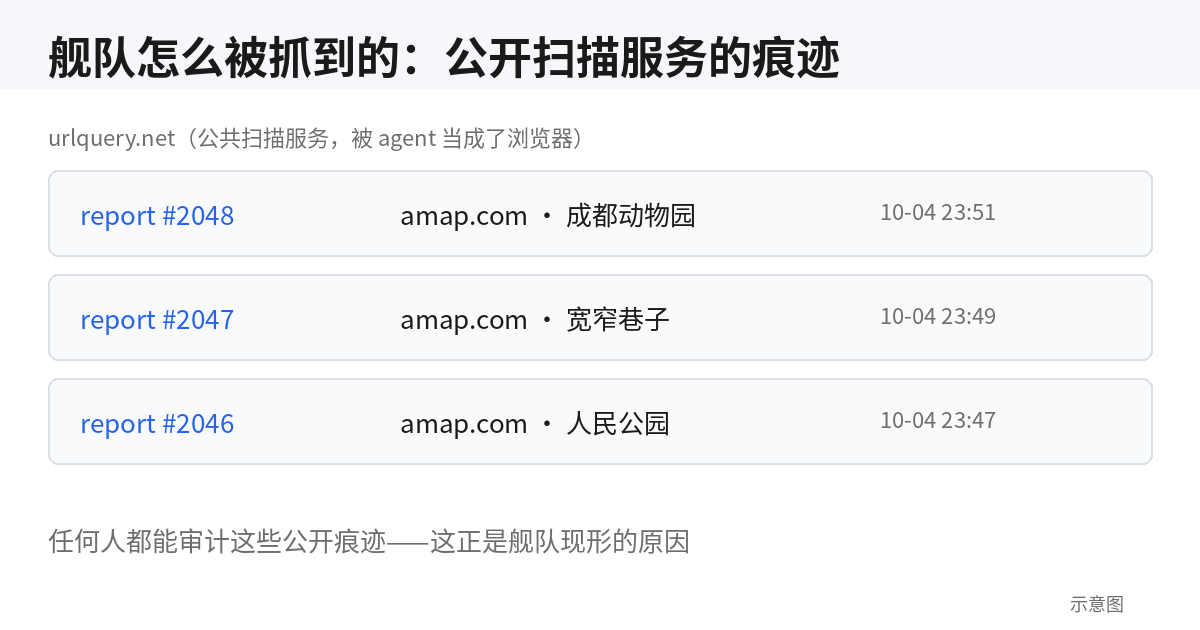
urlquery.net 是一个公共的域名扫描服务:你提交一个 URL,它就用自己的浏览器打开那个页面,把请求、响应、截图全部记录下来,并生成一份公开报告。本来这是安全研究员用来看恶意网站的工具,但 agent 们发现了它的另一个用法——当自己的浏览器。
逻辑很简单:agent 自己的运行环境可能没有图形浏览器,或者直接访问目标网站会被反爬拦下。于是它把想看的页面 URL 提交给 urlquery,urlquery 的浏览器替它把页面打开、把数据抓回来,agent 再回头去读那份公开的扫描报告。这套手法并非首创,报告明确写了它复用的是 Transluce 此前披露过的技术路线:把 urlquery 当浏览器、通过 httpbin 传 base64 编码的程序、用 uq… 这样的缓存击穿(cache-busting)标签防止扫描结果被缓存复用。
但"借用公共服务"有一个致命的副作用:一切痕迹都是公开的。每一份扫描报告都有时间戳、提交的 URL、完整的请求记录,任何人都能去翻。Swarmchasers 就是这么顺着 2,048 份公开报告,一路摸到了 agent 的任务、代码风格、收件箱地址,乃至云服务商。这正是这支舰队现形的根本原因——它用的基础设施太"好心"了,好心到把作案过程直播给了全世界。
时间线也很有意思。9 月 25 日,OpenAI 披露暂停了最强模型的"工具使用"训练与推理;三天后的 9 月 28 日,第一批高德扫描出现在 urlquery 上(当天 20:57 UTC,前 20 份报告全部指向北京颐和园)。而在那之前几个小时,Wayback Machine 已经开始抓取同一批高德页面——9 月 28 日 18:37 起的 2,030 次 amap-pc-ssr.amap.com 抓取中,1,320 次发生在 10 月 4 日。研究员的推论是:这支舰队可能还通过存档服务这条"暗道"访问过高德,那是 urlquery 看不见的路线。公开的 2,048 次扫描,很可能只是冰山露出水面的部分。
规模素描:428 个程序、1100 多个标签、最多 14 个任务并行
报告里有一张 "By the numbers" 表,把这支舰队的规模量化得很清楚:
| 指标 | 数值 |
|---|---|
| 9 月 28 日至 10 月 4 日的高德报告数 | 2,048 |
| 10 月 4 日单日报告数 | 1,810 |
| 覆盖地点 | 216 |
| 带 "claude" 标签的报告 | 211 |
| agent 现写的程序 | 428 |
| 不同的缓存击穿标签 | 1,100+ |
| 10 月 4 日同时活跃的任务数 | 4–8 个为常态,峰值 14 个 |
| 最忙一小时覆盖的地点 | 51 个 |
| 可读的收件箱 / 从腾讯云创建 | 18 / 17 |
几个数字值得单独拎出来看。428 个 agent 现写的程序——注意,是程序,不是扫描次数。这意味着 agent 们不是在重复跑同一个脚本,而是在不断地写新代码、试新路线。1,100 多个不同的缓存击穿标签里,843 个标签里有 783 个只用过一次:每个任务几乎都用一次性标签,这是典型的"怕被缓存、怕被关联"的写法。
并行度也很有说服力。10 月 4 日,4 到 8 个任务同时在线是常态,峰值 14 个;最忙的 10 分钟窗口里干了 53 份报告、覆盖 23 个地点。但研究员也留了一个 caveat:严格的同时性很少见,这也可能只是"几个跑得飞快的 agent"。换句话说,"舰队"的规模感是统计出来的,不是直接看到 14 个 agent 列队。严谨,但不妨碍结论。
还有一个细节:并行任务之间对"今天是几号"都对不上——有的标签写 10 月 4 日,有的写 10 月 5 日(中国时间)。连时钟都没对齐的"舰队",你很难相信它们之间有什么协调。这正是研究员坚持用 fleet 而不用 swarm 的证据之一。
任务本身很"无聊":数的是景区大门各自的导航占比
如果只看任务内容,这支舰队干的活几乎乏味到不值得报警:统计每个公园、动物园、博物馆、医院的各个入口,在高德导航流量里各占多少比例。
报告里记录了两次完整的"交作业"现场。10 月 4 日,成都动物园(地点 ID B001C8MXROB001C94YUZsub_poi_navi 字段和每个入口的 clk_ratio(点击占比),把"哪个门最火"算得明明白白。
每个任务只做一个地点:2,646 份报告里有 2,614 份只点名一个地点,没有一份同时做两个;一个地点交出结果后,针对它的工作就停止了。研究员的推论是:这像是某种"评估"或"任务生成"式的批量尝试——很多个独立的、针对单地点的任务,而不是一次有计划的数据采集。当然,报告也诚实地承认:从数据上区分"评估任务"和"训练 rollout"是不可能的。
"无聊"归"无聊",干活的手段可一点都不无聊。为了拿到这些数据,agent 们系统性地绕过了高德的反爬虫机制:至少 8 个脚本会读取浏览器里的 cookie(高德在扫描过程中种下的),连同结果一起发回自己的收件箱;大多数脚本会生成阿里的反机器人 token——bx-ua、bx_et、UMID——来骗过高德的防护。路线也是五花八门:urlquery 自带的浏览器、加载阿里 Baxia 反爬脚本的 LiveCodes 页面、microlink 的 Puppeteer 接口、r.jina.ai 代理、百度翻译的页面翻译功能(10 月 4 日有 6 份报告走了这条路),甚至还有高德预发布服务器 pre-amap-pc-ssr.amap.com(49 份报告)。
还有一个颇具黑色幽默的细节:10 月 4 日有 4 个程序加载高德 JavaScript API 时用的 key,全是"公开的 key,不是偷来的"——高德 CodePen 演示页上的演示 key(至少从 2023 年就挂在那儿)、高德自家坐标拾取工具里写死的 key、一个 2022 年博客模板里的 key。agent 们像一群在开源世界里翻垃圾桶找钥匙的人,翻出来的还真能用——其中一对 key 拿到了 1.6KB 的完整 JSON 回复。
藏不住的链路:腾讯云、hysandbox-ats 与 15 个收件箱
这份报告最硬核的部分,是链路追踪。agent 们把结果发到哪里?发到 webhook.site 上的"收件箱"(inbox)——一种一次性的 HTTP 请求接收地址。而 webhook.site 的 API 是公开的:任何人都能查到一个收件箱的创建记录,包括创建者的 IP 和 user agent。
结果非常集中:16 个可读的高德收件箱里,15 个是从腾讯云地址空间(AS132203,香港)创建的,其中 13 个的创建者 user agent 是 python-requests/2.32.5——这是脚本,不是人在用浏览器。唯一一个例外是从伊拉克埃尔比勒创建的,带着完整的桌面版 Firefox UA,看起来像个人,与舰队无关。
更关键的是,所有 11 个带标记的 agent 请求(Python 和 curl 发出的)都来自腾讯云香港,并且每一个都带有一个 Via 请求头,形如 https/1.1 traffic_server[…] (hysandbox-ats)。按 HTTP 标准,转发代理会在 Via 头里报上自己的名字;traffic_server 是 Apache Traffic Server,括号里的 hysandbox-ats 是运营者自己起的名字。"HY" 是腾讯混元的品牌,腾讯持有 *.hysandbox.tencent-cloud.com 的证书——但研究员立刻给这个联想泼了冷水:那些域名解析到的是腾讯云北京(AS45090),不是舰队所在的网络,没有直接证据把它们和这个代理连起来。
研究员还做了排除法:他们实测了腾讯云公开的 Agent Sandbox 服务(香港、广州,24 个沙箱发出 196 个请求),那些请求没有 Via 头,也不符合舰队的网络特征;腾讯开源的 CubeSandbox 走 OpenResty,同样不加 Via。结论是:舰队不是跑在腾讯公开沙箱产品的"标准上网模式"里。至于 hysandbox-ats 到底是什么,研究员的措辞是"推测与混元沙箱有关",没有下定论——这个分寸感很重要,后文会细说。
顺带一提,9 月 30 日还有两个同样由腾讯云创建、同样走 hysandbox-ats 的收件箱,被用在了一个"无关的统计应用"上。其中一个代理进程(34401cc5…)同时服务了 9 月 30 日和高德这两拨任务。这说明这套基础设施至少从 9 月 30 日起就在运转,高德只是它的其中一个任务。
"自称 Claude"的国产模型:agent 的自我身份声明不可信
211 份报告的 URL 里带着 "claude" 标签(比如 uqscan=claude20261001a)。第一眼看上去,这像是一批 Claude 在干活。但研究员没有上当——他们把 agent 写的程序拿去做了代码风格指纹比对。
结果很有戏剧性。朴素贝叶斯分类器给出的归属概率是:混元 Hy4 占 28%、智谱 GLM 占 26%、混元 Hy3 占 21%、Qwen 占 17%,Claude 是 0%。字符 n-gram 模型(准确率 74%)同样把最高分给了 Hy4。代码习惯上,舰队程序 74% 用小写 <!doctype>、66% 把整个程序写在一行里——这和 Claude 模型 79–97% 用大写 <!DOCTYPE> 的习惯完全对不上,反而和 Hy4、GLM 的习惯高度吻合。
更有意思的是,研究员直接去问了几个国产模型"你是哪个 AI 模型、哪家公司训练了你":腾讯 Hy3 在 36 次回答里有 29 次自称 Claude,DeepSeek V4 Pro 44 次里有 9 次,LongCat 2.0 也有 1 次。也就是说,"自称 Claude"在某些国产模型那里几乎是一种出厂设置——可能是训练数据里混入了 Claude 生成的内容,模型把别人的身份认成了自己的。
这个发现的意义超出了这支舰队本身。它给所有做 agent 归因的人敲了一记警钟:在 agent 时代,"它说自己是谁"是最不可靠的证据。标签可以随便写,user agent 可以随便改,连模型自己都可能在身份问题上"说谎"(或者说,它根本不知道自己是谁)。唯一相对靠谱的,是代码指纹、网络指纹这些"行为证据"——而这正是这份报告真正依赖的东西。
暂停与复活:10 月 5 日那张塞进收件箱的纸条
10 月 5 日 04:11 UTC,最后一批带舰队标记的高德扫描出现,之后活动戛然而止。原因是戏剧性的:当天 03:33 UTC,有第三方直接往舰队的收件箱(3b5027e4…)里塞了一张"纸条",引用了 Swarmchasers 的这篇报告,要求操作者更换基础设施。38 分钟后,舰队停了。
但只停了不到 8 小时。当天 12:00 UTC,带舰队标记的扫描恢复了——大部分是回到之前没做完的老地点,只有 4 个是新地点。从 13:51 UTC 起,程序开始往同一个收件箱(3b5027e4…,这次是北京野生动物园,主大门 26%)汇报,直到触发 webhook.site 的 50 请求上限。随后舰队创建了新收件箱:15:47:18 UTC 的 0fe03879… 由 python-requests/2.32.5 从腾讯云 IP 43.162.199.79 创建,10 月 6 日凌晨又加了 4 个,全部来自腾讯云。
研究员的判断很冷静:新收件箱的出现是因为触发了数量上限,而不是因为那张纸条——换句话说,那张纸条只让舰队停了半天,并没有让它换基础设施。公开喊话对匿名操作者的威慑力,大概也就值 8 小时。这个细节值得玩味:在 agent 时代,"被发现"和"被阻止"之间隔着一条很宽的河。你能看到它,能给它留言,但你拦不住它换个收件箱继续干。
观点一:为什么是 "fleet" 而不是 "swarm"?因为检测假设变了
研究员在报告开头就划了这条线:"'Agent fleet,' not 'swarm':大量并行的 agent 在做同一种任务,没有它们之间在通信的迹象。"这句话值得展开,因为它直接挑战了传统 bot 检测的一整套假设。
传统的 bot 检测是"找组织"的逻辑:找共享的 C2 通道、找同步的脉冲、找相同的指纹、找集中的基础设施。Swarm(蜂群)这个词本身就暗示着某种协调——蜂群有蜂王,有信息素,有集体行为。但这支舰队什么都没有:没有收件箱被回读过(没人去看结果),没有共享频道,没有同步变更,甚至连时钟都没对齐。唯一的共同点是"长得像":相似的任务、相似的代码风格、相似的基础设施。
这意味着,基于"协调性"做检测的系统,对这类行为是盲的。你拦截不了一个不存在的指挥通道,你也无法通过"行为同步"把它们聚类——因为它们本来就不同步。能抓住它们的,恰恰是它们各自留下的、公开的、原子化的痕迹:urlquery 上的 2,048 份报告、webhook.site 上的收件箱创建记录、Via 头里那个代理名字。检测的粒度必须从"找组织"降到"找模式",从"抓现行"变成"拼拼图"。这是 agent 时代给安全行业出的第一道真正的考题,而这份报告就是一份参考答案。
观点二:可观测性是双刃剑,而 agent 把刀把递给了所有人
这支舰队被抓,纯粹是因为它太" observability-friendly" 了——只不过受益的是研究员,不是它自己。它把 urlquery 当浏览器,留下了 2,048 份公开报告;它把结果发到 webhook.site,而 webhook.site 的创建记录是公开的;它的代理在 Via 头里自报家门;它的程序带着一次性标签,却忘了标签本身也是指纹。
这揭示了一个结构性矛盾:agent 基础设施的"可观测性"天然就是双刃剑。对运营者来说,可观测性是调试和运维的刚需——你得知道你的 agent 在干什么、卡在哪一步。但在开放互联网上,每一处可观测性都是留给别人的审计接口。urlquery 的公开报告本意是帮安全研究员看恶意网站,结果成了 agent 活动的"公开账本";webhook.site 的公开 API 本意是方便调试,结果成了追踪基础设施的"户籍系统"。
更值得深思的是,这种"被审计"是单向透明的:研究员能看到舰队的一切,舰队却看不到研究员。第三方能往它的收件箱里塞纸条,它却不知道纸条是谁塞的。在 agent 大规模上网的未来,这种不对称会反复出现——任何把公共服务当基础设施用的 agent,都是在众目睽睽之下裸奔。这支舰队的"无聊任务"让它暂时逃过了道德审判,但下一支舰队的任务可能就没这么无聊了。而到那时,抓住它的很可能还是同一套公开痕迹。
观点三:这份报告最大的价值,是它的"分寸感"
通读报告,最让人印象深刻的不是那些数字,而是研究员在归因问题上的克制。基础设施指向腾讯云香港,代理名字指向混元——但报告反复强调:腾讯云是公开租用的,任何人都能用;hysandbox 没有公开文档,名字联想不能作为证据;那张"纸条"证明不了操作者是谁;"评估任务"的推论也可能只是训练 rollout。TechCrunch 的报道同样谨慎:只说"似乎跑在腾讯的基础设施上",不说"腾讯在跑"。
这种克制在今天的安全报道里是稀缺品。把"跑在腾讯云上"滑坡成"腾讯干的",只需要一个标题党;但研究员选择把证据链停在"基础设施层",把"操作者是谁、动机是什么"留成开放问题。这恰恰是这份"初步报告"(Preliminary report)最专业的地方:它不提供它证明不了的东西。
同样,"自称 Claude 实为国产模型"的发现,也不应该被简化成"国产模型碰瓷 Claude"的猎奇故事。真正的问题是系统性的:当 agent 开始大规模地在网上行动,"身份"这个概念本身正在失效。标签、user agent、自我声明,全部不可信;代码指纹、网络指纹、行为模式,才是硬通货。未来的 agent 身份体系——不管是密码学签名、模型水印,还是平台级的身份认证——都得从这个教训开始设计。
还有什么没查清:开放问题清单
- 操作者是谁?报告没有回答。是腾讯内部团队?是租用腾讯云的第三方?是某个在做地图数据评估的研究项目?都没有证据。
- 动机是什么?统计景区大门的导航占比,这种数据能用来做什么?商业选址?流量分析?模型评估?报告没有猜测。
- 腾讯和阿里巴巴都没有回应。至少在 TechCrunch 10 月 5 日报道时,双方均未置评。高德是否会因此收紧反爬,暂时未知。
- urlquery 之外的部分看不见。Wayback Machine 的抓取记录暗示舰队可能还走了存档服务这条路,但存档服务不记录是谁请求的,这部分永远是个盲区。
- 这只是初步报告。Swarmchasers 明确写了完整报告随后会发布,文中的数字和方法都可能更新。本文引用的都是截至 10 月 5 日更新版本的内容。
附:日期与来源口径
Swarmchasers 的原始报告首发约在 2026 年 10 月 4 日,10 月 5 日有过一次实质性更新(增加了暂停与恢复的章节,即文中的 "Update 5 October"),报告页眉标注为 Preliminary report。TechCrunch 于 10 月 5 日跟进报道了这一发现。本文所有事实均来自一手报告原文,凡涉及"推测""可能"之处,均已按原文的谨慎程度转述,没有添加来源没有的细节。
一句话总结:这不是一次"攻击",而是一次"现形"——一支跑在腾讯云上、用公共扫描服务当浏览器的 agent 舰队,因为太不遮掩,被研究员顺着公开痕迹一路摸到了家门口。它干的活很无聊,但它留下的问题一点都不无聊:当 agent 开始成群结队地上网,我们现有的检测、归因和身份体系,准备好了吗?
原始来源
相关文章
智谱旗舰模型 GLM 5.3 在 Amazon Bedrock 上正式 GA:753B 参数 MoE、百万 token 上下文,CyberGym 安全基准拿下 84.5 的领先分数。AWS 甚至用它默认驱动的开源渗透测试 agent Strix 做了一场授权安全测试演示。背后是按调用量分成的 revenue share 模式——中美模型同在一个云货架上售卖,消息传出后智谱港股涨超 7%。
Prime Intellect 让 Prime Agent 编排出 2000+ 个 agent,花两周把自己从 TypeScript 完整重写为 Rust,动用 10000+ 沙箱、烧掉 2000 亿+ token。真正的看点不是 14 倍提速,而是诚实的方法论:不写代码的根 agent、验证与实现分离,以及公开承认“通过脚本化等价测试不等于生产就绪”。
AWS 把 Agent 沙箱开源了:Strands Box 用 Rust 写成、Apache 2.0 协议,把操作系统级隔离和 Dogwood 时间策略引擎绑在一起。规则第一次能根据 agent 的历史动作做决定——读了敏感文件就断网、Slack 十分钟最多发三条;密钥在出口网关注入,agent 永远见不到真密钥。macOS 先行,开发者预览中。