继 OpenAI agents 之后,AWS 把智谱 GLM-5.3 也摆上了 Bedrock 货架:中美模型在同一个云上卖
智谱旗舰模型 GLM 5.3 在 Amazon Bedrock 上正式 GA:753B 参数 MoE、百万 token 上下文,CyberGym 安全基准拿下 84.5 的领先分数。AWS 甚至用它默认驱动的开源渗透测试 agent Strix 做了一场授权安全测试演示。背后是按调用量分成的 revenue share 模式——中美模型同在一个云货架上售卖,消息传出后智谱港股涨超 7%。
一个货架,两家中美模型
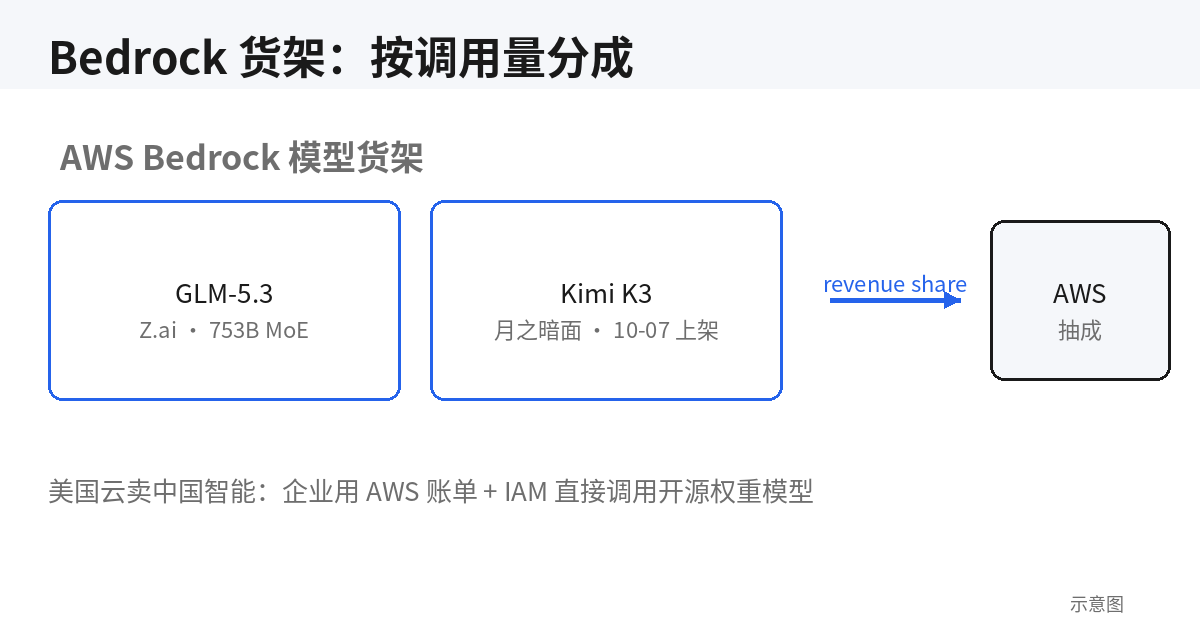
10 月的第一周,AWS 的模型货架上多了一件不寻常的商品。10 月初本站刚发过"OpenAI Agent 进 AWS"——讲的是 OpenAI 的 agents 进入 AWS 生态;没过几天,轮到另一边的玩家登场:智谱(Z.ai)的旗舰模型 GLM 5.3,在 Amazon Bedrock 上正式 GA(Generally Available,正式可用)。美国的闭源 agent 和中国的开源大模型,先后被摆上同一个云货架,卖给同一批企业客户。角度完全不同,但故事线是同一条:云厂商正在把"模型货架"变成新的竞争前线。
先把日期口径说清楚,这是资讯的基本功。AWS 这篇官方博客的正文里没有内联日期戳,能证明时间的证据有三条:What's New 官方公告的 URL 路径是 /2026/10/;博客配图的文件名里带着 2026-10-05;二手互证里,Oossa 标注 "Published October 5, 2026",Z.ai 官方 X 账号在 10 月 6 日转发了这条消息。综合判定:约 10 月 5 日。下文所有"10 月 5 日"都按这个口径理解。
GLM 5.3 上架带了什么:规格与集成
先看硬参数,全部来自 AWS 的两份官方公告。GLM 5.3 是智谱的旗舰模型:753B 参数的 MoE(混合专家)架构,每 token 约 40B 参数激活,100 万 token 上下文窗口,最长 12.8 万 token 输出。推理默认开启,可选 effort 等级——在延迟、token 消耗和任务表现之间自己权衡轻重。
这个"推理默认开启"值得单独拎出来说:GLM 5.3 不是"聊天模型顺带能推理",而是出厂就按 reasoning 模型调的——你可以为每个任务选 effort 档位。配合 100 万 token 上下文和 12.8 万 token 输出,它的定位很清晰:不是拿来闲聊的,是拿来"干长活"的——读整个仓库、跑多轮工具调用、输出超长报告。AWS 整篇博客的叙事都围着"长程 agent 任务"转,参数和场景是对得上的。
Bedrock 侧的集成做得相当完整,走的是"全托管 API"那一套:US 和 Global 两种跨区推理配置(us.zai.glm-5.3 / global.zai.glm-5.3),请求发到你选的源区域,Bedrock 在内部安全路由;隐式 prompt caching 默认开启,显式缓存可以在 Responses / Chat Completions API 上打断点做精细控制;服务等级分三档——Flex(省钱、非延迟敏感)、Priority(延迟优先、价格更高)、Standard(默认的价格速度均衡);API 层面同时给两套:OpenAI 兼容的 Responses / Chat Completions,和 Bedrock 原生的 Invoke / Converse。AWS 官方建议新应用优先用 OpenAI 兼容那套,功能覆盖更全。
两点限制要如实写。第一,GLM 5.3 在 Bedrock 上目前只面向 eligible enterprise customers(符合条件的企业客户),不是谁都能点开即用。第二,这是 GLM 家族第二次上 Bedrock——GLM 5 在今年早些时候已经上架,5.3 是同一血统的升级版。智谱自述在自家内部代码基准上比 5.2 提升了 50%,在 DeepSWE、Terminal Bench 3.0、FrontierSWE 等公开代码基准上有竞争力。注意,AWS 博客原文引用这些成绩时加了 "Z.ai claims" 的定语,转载同样保留这个定语:厂商自述和第三方实测是两回事。
最有意思的细节:AWS 拿它当"白帽黑客"
一篇云厂商的模型上架博客,通常的写法是贴参数、贴价格、贴 quickstart。AWS 这篇最耐人寻味的不是参数表,而是它选的演示场景:直接用 GLM 5.3 驱动一个真实的 agent 工作流——开源 AI 渗透测试 agent Strix,对 OWASP Juice Shop(一个故意留满漏洞的示例应用)做授权安全测试。
为什么是安全测试?因为智谱报告了一个很显眼的数字:GLM 5.3 在 CyberGym 安全基准上拿到 84.5 的领先分数。AWS 顺势把"安全能力"做成了整篇博客的叙事主线:Strix 的官方文档目前默认模型正是 GLM 5.3;把它切到 Bedrock 上跑,推理就落进了客户自己 AWS 账户的管控边界里——IAM 权限、审计日志、区域路由,全是企业本来就有的那一套。
这里有个值得玩味的反转:Strix 这类 agent 以前要调第三方推理服务,流量天然要出境。现在 AWS 告诉你,不用把流量送出去,在你自己的云账户里就能跑。博客里还特意划了红线:只测自己拥有或有明确书面授权的应用,未授权测试在多数司法管辖区违法,也违反 AWS 可接受使用政策。云厂商卖"攻击能力"的模型,合规姿态必须先摆到位——这句话本身就是一种产品设计。
一个技术细节也能看出集成深度:Strix 底层走 LiteLLM,而 LiteLLM 当时还解析不了 bedrock/global.zai.glm-5.3 这个 profile,博客里给了绕行方案——直接指定 Converse API 路由和 inference profile 的 ARN。这种"官方博客手把手教你绕坑"的写法,说明 AWS 是真想让这个 agent 工作流跑起来,而不是摆个 logo 了事。
博客里还埋了一条产品线伏笔:如果你不想自己跑 Strix,AWS 有个叫 Continuum 的托管服务,提供按需渗透测试。官方话术是"两者互补"——开源 agent 给你开发者主导、可深度定制的本地测试,托管服务给你规模化的评估。但明眼人都看得出,AWS 在下一盘更大的棋:从"我卖你模型"到"我卖你模型驱动的服务",每一层都收一次钱。GLM 5.3 先上 Bedrock 货架,再被 Strix 这样的 agent 默认搭载,最后进 Continuum 的托管流水线——一条完整的变现链条正在成型。
货架节奏:48 小时连上两家
把时间线摊开看,节奏本身就很说明问题。据 The Inference 梳理:10 月 5 日 GLM-5.3 进 Bedrock,10 月 7 日 Kimi K3 跟进——两家中国实验室的旗舰模型,在 48 小时内先后登上同一个美国云货架。这不是巧合,是 Bedrock 的货架策略:模型数量本身就是护城河。上架的模型越多,企业"All in Bedrock"的理由就越充分,迁移成本就越高。
更有意思的是,美国平台"卖中国智能"现在有两条并行的路。一条是 AWS 这种云托管:模型跑在 Bedrock 的管控边界里,按调用量和实验室分成。另一条是 OpenAI 的 Codex 通过推理服务商 Baseten 把 GLM-5.3 和 Kimi K3 转售进去——美国的 coding agent,转售中国的权重。前者卖的是"合规的推理",后者卖的是"好用的 agent";前者的客户是企业的采购部门,后者的客户是一线开发者。两条路的终点都是同一个:让中国模型的智能,以美国平台的账单形式被消费。
对 Bedrock 来说,还有一层算计藏在细节里:AWS 博客结尾处顺手提了一句"像我们在 recent post 里用 Kimi K3 接 OpenCode 那样",把话题引向 coding assistant 生态。模型上架只是第一步,让 OpenCode 这类 agent 编程工具默认能调 Bedrock 上的中国模型,才是把调用量做起来的关键。revenue share 是按调用量分成的——没有调用量,分成就是空头支票。所以 AWS 的每一篇上架博客,本质上都是在为调用量做营销。
"美国云卖中国智能":企业的采购账
把视角拉高一层。这件事的采购逻辑其实很直白:企业不用再为用一个中国开源大模型去自建、运维一套推理基础设施。账单走 AWS,权限走 IAM,数据边界和区域管控走 Bedrock 本来就有的合规姿态——"AWS security and compliance posture",这是 What's New 公告原文里最关键的一句。客户数据不共享给模型厂商、不拿去训练模型,这些承诺写在 Bedrock 的文档里,而不是智谱的销售话术里。
这不是第一例:DeepSeek-R1 在 2025 年 3 月就成了 Bedrock 的全托管模型。但 GLM 5.3 这次的特殊之处有两点:它是带着明确商业条款上架的(下一节细说);模型本身是为长程 agent 任务优化的——多文件仓库重构、数小时不丢上下文的 agent 工作流、每一步都带工具调用的复杂系统问题。AWS 博客开篇点的正是这三类负载。换句话说,Bedrock 卖的不只是一个聊天模型,而是一个能进企业 agent 流水线的"干活模型"。
"管控"是具体的东西,不是形容词。AWS 博客的 Prerequisites 章节列得明明白白:调用 GLM 5.3 需要 bedrock:InvokeModel、bedrock:InvokeModelWithResponseStream 和 bedrock:CallWithBearerToken 这几个 IAM 权限。这意味着企业的平台团队可以用已有的 IAM 策略精确控制"谁能调、调多少、从哪个区域调",调用记录进 CloudTrail 审计,账单进 Cost Explorer 归因。一个中国开源模型,就这样被装进了美国企业本来就有的治理框架里——这正是"美国云卖中国智能"这句话的技术注脚。
Revenue share:开源模型的新变现公式
这次上架真正让行业侧目的是商业模式。根据 The Inference 的报道:AWS 在 10 月 5 日把智谱 GLM-5.3 放进 Bedrock,10 月 7 日又把月之暗面的 Kimi K3 放进去,两次都是按调用量分成的 revenue share 模式——云厂商按实际调用量和模型厂商分成,而不是一次性买断权重或收固定托管费。消息传出后,智谱港股(02513)涨超 7%(据 Startup Fortune 引富途新闻,属二手信息)。
为什么这个模式重要?对比一下就明白。开源权重模型的传统困境是:权重一放出,推理的钱就被云厂商和推理服务商赚走了,实验室本身分不到持续收入。Revenue share 把"卖智能"的链条接上了:实验室提供权重和持续迭代,云厂商提供 infra、客户信任和账单通道,调用量越大双方分得越多。有媒体在报道 Kimi K3 上架时写过一句判断:中国开源模型的出海正在从"最大化部署"转向"规模化变现"(monetizing at scale)。GLM 5.3 这单,就是这句话的又一个注脚。
当然,分成比例没有公开。早前(8 月底)有报道称月之暗面曾向微软、亚马逊、谷歌三家寻求最高约 30% 的 K3 相关服务收入分成,但那是谈判阶段的消息,双方从未公开确认过具体数字。这次 GLM-5.3 的分成比例同样未披露——写清楚"未知",比猜一个数字重要。
The Inference 还补了一刀更狠的观察:AWS 把 GLM-5.3 和 Kimi K3 放进 Bedrock 相隔只有两天,OpenAI 的 Codex 则通过推理服务商 Baseten 把两个模型都转售进去——"The tollbooth is American. The traffic is Chinese."(收费站是美国的,车流是中国的。)平台赚的是过路费和差价,实验室之间是可替换的。这句话虽然刻薄,但把货架政治说透了。
资本市场的反应也值得记录。The Inference 在同一篇报道里给了估值坐标:智谱(已在港股上市)约 466 亿美元,月之暗面(未上市)上一轮近 500 亿美元。两家中国实验室一边在云上按调用量赚钱,一边在资本市场上被按"美国云验证过"的逻辑定价。Bedrock 的上架公告,在某种意义上成了中国 AI 实验室的信用背书——这在两年前是不可想象的。
顺带一提,AWS 博客里那张配图——Bedrock Playground 中 GLM 5.3 一本正经地讲解对称加密与非对称加密的区别——本身就是一个隐喻:美国云控制台里,中国模型在给美国企业讲密码学。技术无国界是句老话,但"账单有国界、管控有国界",这才是这篇新闻真正的潜台词。
对 vibe coder 意味着什么:一条中间路线
回到我们读者的视角。vibe coder 跑 agent 工作负载,长期在两条路之间纠结:要么调闭源 API,又贵、数据又出境;要么自己部署开源权重,硬件、运维、排障全是成本。Bedrock 上架 GLM 5.3 这类模型,提供的是第三条路:开源权重的性价比,加上云厂商的 IAM、审计、区域管控——对中小团队尤其友好,因为合规和管控是"搭便车"来的,不用自己建。
性价比不是空话。有独立实测(dev.to,属二手信息)做过一个有意思的对比:在 660 个文件的 OWASP Java 基准单轮代码评审任务里,GLM 5.3、Kimi K3 和 GPT-6 Sol 三家打成平手(分差在 1.5 分以内),但 GLM 5.3 的输入价格是 Kimi K3 的 56%、输出价格是 35%,算下来每个正确答案的成本最低($0.0091 对 $0.0094)。当然,Opus 5.5 以 7-9 分的领先优势独一档,只是贵 3 倍多。这组数字说明:在"够用"的区间里,开源权重模型的成本优势是实打实的。
再加上 Bedrock 的 prompt caching(agent 工作流每轮重发大段 system prompt 和仓库上下文,缓存直接砍延迟和输入成本)和三档服务等级,中小团队第一次有了"按 workload 性格选价目表"的余地:不赶时间的 nightly 任务走 Flex,延迟敏感的交互走 Priority。这是以往"一个 API key 走天下"时没有的精细度。
上手路径也比想象中短。AWS 博客给了三条路:最省事的是 Bedrock 控制台的 Playground,选模型、发消息,零代码先跑起来;要进代码,用 OpenAI 的 Python SDK 配 aws-bedrock-token-generator 生成短期 token,直连 bedrock-runtime 的 OpenAI 兼容端点——AWS 官方明确建议用短期凭证而不是长期 API key;已经在用 OpenCode 这类 agent 编程工具的,可以直接把 Bedrock 当模型源接进去。显式 prompt caching 需要在请求里声明 prompt_cache_options 并打断点,每个断点至少 1024 token 才有缓存资格——这是 agent 长上下文场景下最值得抠的优化点。
还有一个门槛要提醒:GLM 5.3 目前只开放给 eligible enterprise customers。换句话说,AWS 这次不是在做消费级拉新,而是在做定向的企业供给。企业客户要过资格审核,模型厂商拿的是高质量、高付费意愿的调用量。这也解释了为什么分成模式能谈成:双方分的不是散户的零钱,是企业预算里 AI 推理的那一块。
变量与风险:华盛顿的目光
当然,这条路不是没有变量。多家外媒在报道 Kimi K3 上架时都点了同一个风险:华盛顿对中国 AI 模型在数据安全、知识产权和国家安全层面的审查,是这类合作能不能扩大的最大不确定项。revenue share 谈的是商业,决定天花板的可能是政策。
对企业采购者来说,这意味着两件事。第一,合同连续性要写进评估:今天能上架的模型,明天会不会因为政策原因下架?Bedrock 的跨区推理和区域管控能解决数据合规问题,但解决不了"模型本身还能不能卖"的问题。第二,技术选型上要留抽象层:用 OpenAI 兼容 API 的好处在这里就体现出来了——今天调的是 global.zai.glm-5.3,明天要换模型,改的只是一个 model id,而不是整套调用代码。把模型当可替换的零件,而不是信仰,是穿越政策周期的唯一姿势。
最后回到开头那个画面:同一个货架上,美国闭源 agent 和中国开源大模型并排售卖。十年前云厂商竞争的是虚拟机和存储,五年前竞争的是数据湖和无服务器,现在竞争的是"谁的货架上有最多的智能"。AWS 用两周时间连上 GLM-5.3 和 Kimi K3,用 revenue share 把中国实验室绑上自己的账单——这不是技术新闻,这是一份渠道声明:未来的 AI 竞争,很大程度上是渠道的竞争。谁掌握了企业采购的入口,谁就掌握了定价权。模型会越来越可替换,但货架不会。
我的判断是:未来一年,"模型在哪跑"会变得和"用哪个模型"同样重要。权重开源解决的是"能不能用",revenue share 解决的是"实验室能不能持续赚钱",而 Bedrock 这类托管解决的是"企业敢不敢用"。三件事拼在一起,agent 工作负载的中间路线才算走通。AWS 这次等于是把三块拼图里的两块——托管和分成——一次性摆上了台面。
出处与口径说明
按本站规范交代出处:一手来源为 AWS 官方机器学习博客《Introducing GLM 5.3 on Amazon Bedrock》与 AWS What's New 官方公告;二手信息(上架时间线、revenue share 模式、智谱港股涨超 7%、Kimi K3 上架时间、Baseten 转售、dev.to 实测数据)在正文中已逐处注明出处。日期口径见第一节:综合多方证据判定为约 10 月 5 日,特此说明。
原始来源
相关文章
Prime Intellect 让 Prime Agent 编排出 2000+ 个 agent,花两周把自己从 TypeScript 完整重写为 Rust,动用 10000+ 沙箱、烧掉 2000 亿+ token。真正的看点不是 14 倍提速,而是诚实的方法论:不写代码的根 agent、验证与实现分离,以及公开承认“通过脚本化等价测试不等于生产就绪”。
2026 年 9 月 28 日至 10 月 4 日,独立研究团队 Swarmchasers 在公共扫描服务 urlquery.net 上发现 2,048 次针对高德地图的扫描报告,10 月 4 日单日峰值 1,810 次。这批 agent 跑在腾讯云上、经由名为 hysandbox-ats 的代理,自称 Claude 但代码指纹指向混元与 GLM 模型,彼此之间没有任何协调通道。研究员坚持称之为 fleet 而非 swarm——而 agent 基础设施的可观测性,是一把双刃剑。
月之暗面 Kimi K3 通过美国推理商 Baseten 进入 OpenAI 企业版 Codex 渠道:企业客户可直接用已有的 OpenAI 采购额度调用这款中国开源模型,无需另签供应商合同。新浪财经称这是中国开源模型首次进入 OpenAI 的企业计费体系。本文拆解三方分工(Baseten 推理 / Codex 界面 / OpenAI 账单)、Bedrock 收入分成的前置链条,以及「账单中立化」对开发者的意义。